Instances réservées Azure en 2027

Vous avez acheté des instances réservées (RI) Azure, vous vous êtes toujours dit qu’en cas de changement de workload vous pourriez les échanger, et vous découvrez maintenant que ce filet de sécurité va disparaître ? Cet article est fait pour vous. On part de l’annonce Microsoft du 30 juillet 2026 et on déroule ce qui change, ce qui ne bouge pas, les scénarios chiffrés, et le plan d’action à mener avant le 1er février 2027.
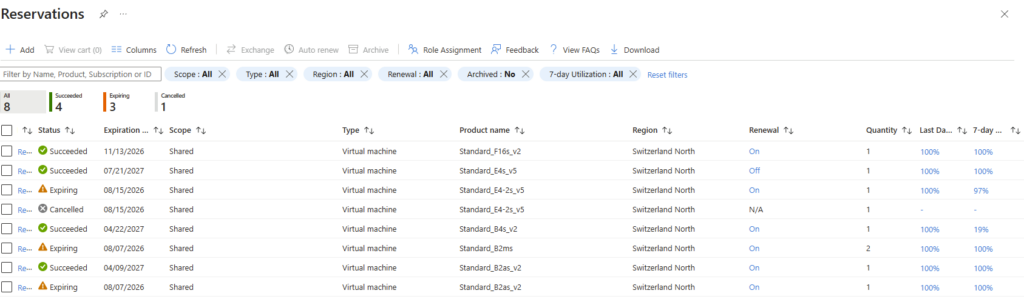
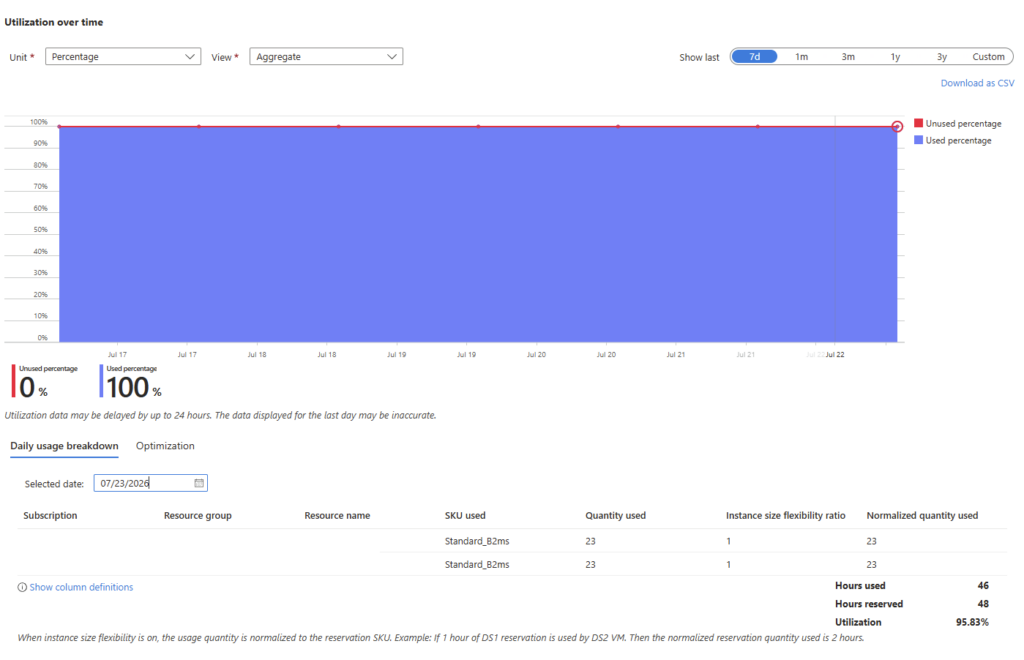
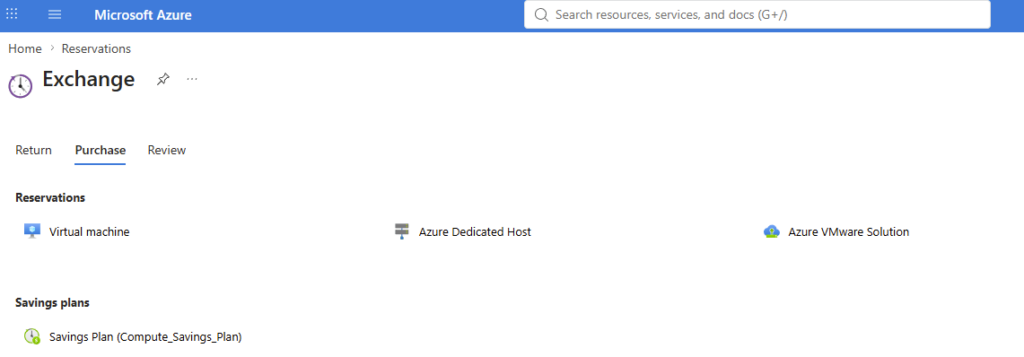
Pour rappel, jusqu’ici l’échange était le joker des réservations Azure : vous aviez surdimensionné une série de VM, vous vous étiez trompé de région, vous aviez migré de Dsv3 vers Dsv5, et hop, un échange remettait le compteur d’engagement à zéro et sans pénalité :
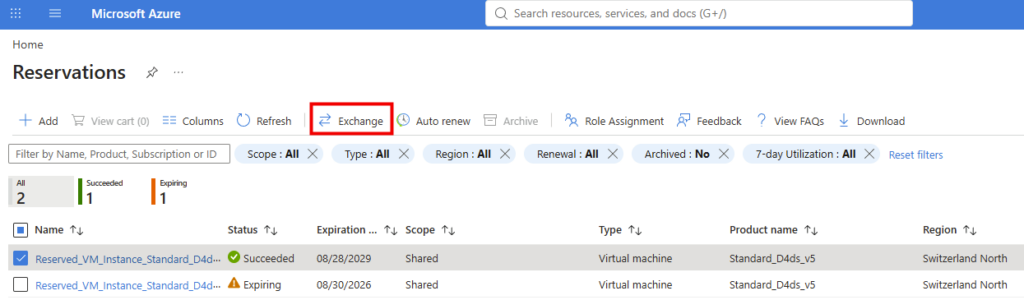
Ce joker se referme bientôt : à partir du 1er février 2027, si un service Azure est couvert par un saving plan, la réservation correspondante n’est plus échangeable.

Pour vous guider plus facilement dans ce changement à venir, voici des liens rapides :

Mais avant de rentrer dans ce sujet bientôt brûlant, et si les réservations d’instance ne sont pas encore votre tasse de thé :

Qu’est ce qu’une instance réservée Azure ?

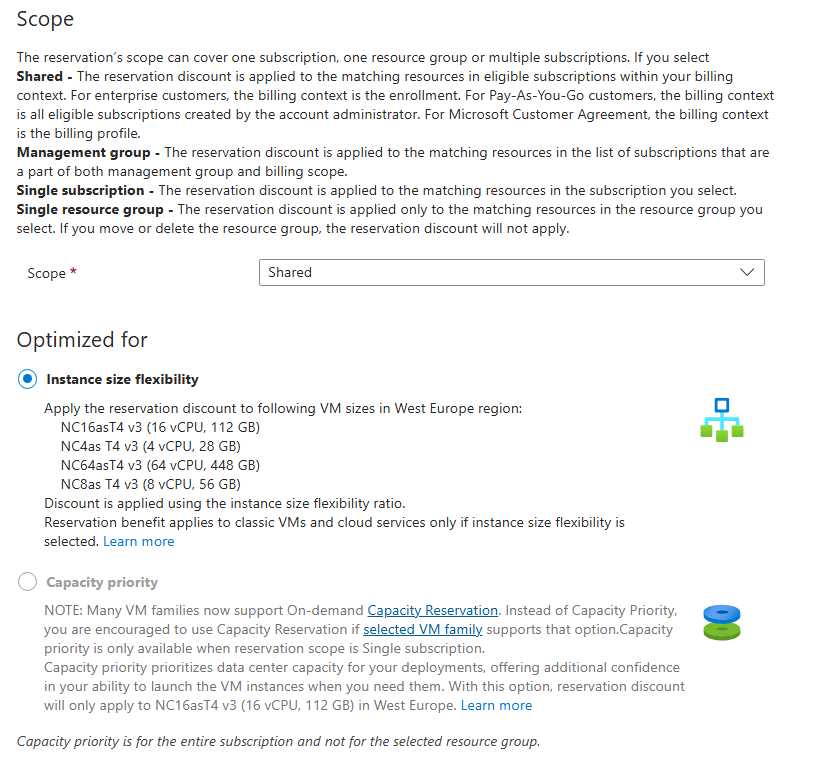
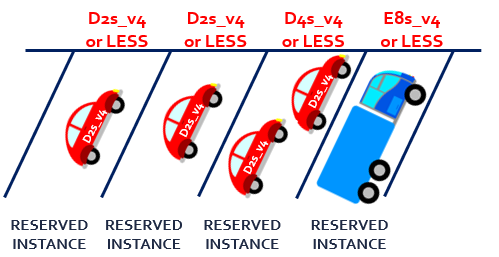
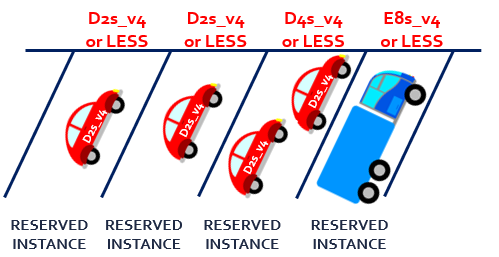
Pour faire simple, les Azure RIs sont comme des places de parking que vous louer pour 1 ou 3 ans, et où les VM (ou d’autres services de compute), peuvent y être affectées, afin d’économiser des frais de stationnement, donc ici des coûts d’infrastructure auprès de Microsoft.
Voici une vidéo qui va vous éclairer sur les RIs :

Et voici une vidéo expliquant cette fois les saving plans :

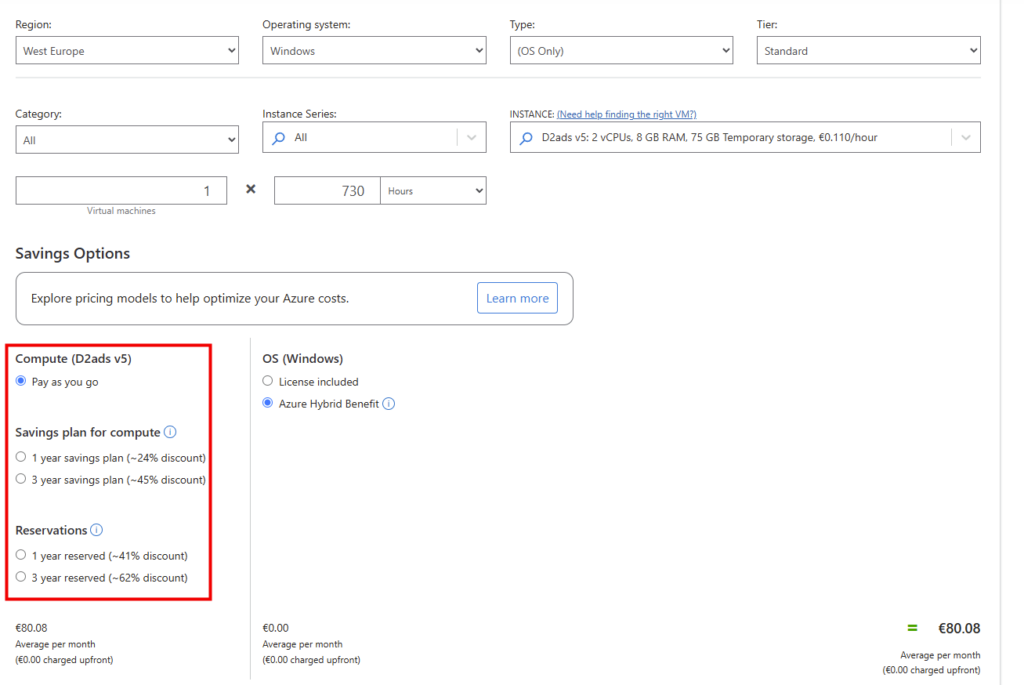
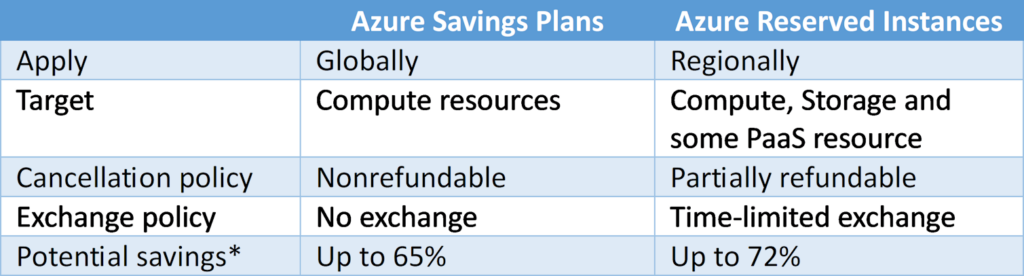
Voici donc comment on peut voir comment faire son choix entre instance réservée et un saving plan :
1. Ce qui change vraiment au 1er février 2027

La règle tient en une phrase, et Microsoft l’écrit noir sur blanc :

Starting February 1, 2027, reservations purchased after this date aren’t eligible for exchange if the corresponding service is supported by savings plans.

Source : Changes to the Azure reservation exchange policy, Microsoft Learn

En clair, à partir du moment où un service dispose d’un savings plan, Microsoft considère que vous avez déjà l’outil de flexibilité qu’il vous faut, et retire donc la flexibilité de la réservation. Deux régimes cohabitent, et tout se joue sur la date d’achat.

Date d’achat de la réservationDroit d’échange
Avant le 1er février 2027Échanges illimités jusqu’au 31 janvier 2027, puis un échange final après cette date
À partir du 1er février 2027Aucun échange possible

Le mot important est final. Une réservation active achetée avant la bascule conserve le droit à un échange, un seul, et la réservation issue de cet échange n’est plus échangeable du tout. Microsoft le confirme dans la FAQ de son annonce : une fois l’échange final consommé, la réservation obtenue ne peut plus être échangée.

La politique est aussi prospective, et c’est un point que beaucoup vont rater : tout produit compute ou base de données qui deviendra éligible aux savings plans après le 1er février 2027 tombera automatiquement sous la même règle, et les réservations déjà achetées pour ce produit basculeront à leur tour sur le régime de l’échange unique.

Deux catégories restent en dehors du périmètre :

  • les réservations de produits ou services dépréciés et proches de la fin de vie ;
  • les réservations de produits non couverts par les savings plans, Azure VMware Solution étant l’exemple cité par Microsoft ;
Attention : si vous opérez dans un cloud souverain ou un environnement où les savings plans ne sont pas disponibles, vous n’êtes pas concerné aujourd’hui. Mais la formulation Microsoft dit bien « don’t currently support », donc le jour où le savings plan y arrive, la règle vous rattrape.

La première exclusion mérite qu’on s’y arrête, parce qu’elle recoupe directement un sujet que j’ai traité récemment. Les séries D, Ds, Dv2, Dsv2, Ls, Av2, Amv2, B, F, Fs, Fsv2, G, Gs et Lsv2 ont toutes une date de retraite annoncée en 2028, et j’ai détaillé ce calendrier dans VM Azure : anticipez les dépréciations. Ces séries entrent a priori dans la catégorie des produits dépréciés et proches de la fin de vie, donc dans l’exclusion.

Attention : Microsoft ne publie aucune liste nominative des produits couverts par cette exclusion. Si une part de votre portefeuille porte sur ces anciennes séries, faites confirmer le point par votre account team plutôt que de le déduire. Et rappelez-vous que pour la plupart d’entre elles, la question ne se pose déjà plus à l’achat : les réservations ne sont plus commercialisées depuis le 1er juillet 2026.

2. Les services concernés

La page Learn se contente de « Azure Virtual Machines, Azure App Service, Azure SQL Database, and similar services », ce qui est un peu court quand on doit auditer un portefeuille d’engagements. L’annonce sur le Tech Community, elle, donne la liste exacte au moment de la publication :

ComputeBases de données
Azure Virtual Machines, y compris les échanges entre stockage non premium et premiumAzure Database for PostgreSQL
Azure Dedicated HostAzure Database for MySQL
Azure App ServiceAzure DocumentDB
Azure Cosmos DB
Azure SQL Database
Azure SQL Managed Instance

Soit trois services compute et six services de bases de données, neuf au total. Notez la mention entre parenthèses sur les VM : l’échange F1 vers F1s, celui qu’on utilisait tranquillement pour passer une réservation vers une taille compatible stockage premium, entre lui aussi dans le périmètre.

Attention : cette liste est celle du 30 juillet 2026. Microsoft précise que d’autres services éligibles aux savings plans viendront s’y ajouter. Ne la figez pas dans votre documentation interne sans date de revue.

À l’inverse, deux familles gardent leur échangeabilité complète parce qu’elles ne sont pas couvertes par les savings plans : Azure VMware Solution et Nutanix on Azure BareMetal, qui restent d’ailleurs des cibles d’échange valides au sein de la famille compute.

3. Ce qui ne change pas

Avant de paniquer, faisons le tri. Beaucoup de choses restent en place, et Microsoft insiste lourdement sur le fait que les réservations ne sont pas en cours de retrait.

  • L’instance size flexibility pour les VM n’est pas touchée. Votre réservation D4s_v5 continue de couvrir deux D2s_v5 sans que vous ayez quoi que ce soit à faire.
  • La politique d’annulation ne bouge pas : le plafond reste à 50 000 USD de commitment annulé sur 12 mois glissants, par billing profile ou par enrollment.
  • Le trade-in vers un savings plan reste possible, sans limite de date, et sa politique est inchangée.
  • L’achat et le renouvellement de réservations restent disponibles pour tous les services concernés.

Sur la question « est-ce que Microsoft tue les réservations ? », la FAQ officielle répond non, et précise que le changement porte uniquement sur l’échangeabilité. Ce qui disparaît, c’est le droit à l’erreur, pas le produit.

4. Pourquoi Microsoft fait ça : ma lecture

Ce n’est pas la première tentative

Avant d’analyser le pourquoi, un rappel qui change la lecture de toute l’annonce : Microsoft a déjà essayé de fermer ce robinet, deux fois, et a reculé les deux fois.

  • Octobre 2022, au moment même du lancement du savings plan : Microsoft annonce la dépréciation de l’échange des réservations compute au 1er janvier 2024. L’argumentaire est déjà mot pour mot celui d’aujourd’hui, le savings plan apportant la flexibilité automatiquement, la politique d’échange des réservations est ajustée en conséquence.
  • Octobre 2023, premier recul : une période de grâce repousse l’échéance à « au moins le 1er juillet 2024 », avec déjà le principe d’un dernier échange conservé pour les réservations achetées avant la fin de cette période.
  • Mai 2024, deuxième recul, et cette fois sans nouvelle date.
  • 30 juillet 2026 : la notification promise arrive, pour le 1er février 2027. Six mois et deux jours de préavis. Microsoft tient son engagement au calendrier près.

Originally with a deadline of 1 July 2024, we have extended this and customers may continue exchanging their compute reservations for different instance series and regions until we notify them again, which will be at least 6 months in advance of the new deadline.

Source : Azure compute reservation exchanges will remain available until further notice (Tech Community, 16 mai 2024)

Cette phrase de 2024 est la clé pour comprendre pourquoi il faut prendre 2027 au sérieux. Le préavis promis vient d’être consommé. Il n’existe plus aucun engagement derrière lequel espérer un troisième report, et parier sur « ils vont encore reculer », c’est parier contre la seule garantie que l’on avait.

Il y a même un précédent dans l’autre sens, et il est récent. La fin des réservations un an sur les anciennes séries de VM était initialement fixée au 15 novembre 2027 : Microsoft l’a avancée au 1er juillet 2026, soit plus d’un an plus tôt que prévu. J’ai documenté cet épisode dans VM Azure : anticipez les dépréciations. Autrement dit, une date annoncée sur les engagements Azure peut aussi bien reculer que se rapprocher, et construire un plan sur l’hypothèse d’un report est le plus mauvais des paris.

Deuxième différence de taille : en 2022, la mesure ne visait que le compute, soit les réservations Azure Reserved Virtual Machine Instances, Azure Dedicated Host et Azure App Service. La version 2027 y ajoute six services de bases de données. Ce n’est pas la même annonce repoussée de trois ans, c’est une version élargie.

Attention : la trace du sursis de 2024 est toujours en ligne. La page Learn consacrée aux échanges et remboursements contient encore la mention d’une période de grâce permettant d’échanger les réservations compute « until further notice », à quelques lignes de l’encadré annonçant le 1er février 2027. Ne vous fiez pas à ce paragraphe résiduel, c’est la nouvelle date qui fait foi.

La justification officielle est l’alignement : Microsoft explique que la mesure aligne la politique d’échange des réservations sur la flexibilité déjà offerte par les savings plans, et donne un cadre de choix clair et prévisible entre les deux mécanismes d’engagement.

Concrètement, ça donne quoi ? Depuis l’arrivée du savings plan, Azure proposait deux produits qui se recouvraient partiellement : une réservation échangeable à volonté offrait à peu près la même souplesse qu’un savings plan, avec en prime une remise plus élevée. Le portefeuille était incohérent. En retirant l’échange, Microsoft rend les deux produits réellement distincts : la réservation devient un engagement ferme sur une configuration précise, avec la remise maximale ; le savings plan devient l’engagement souple, avec une remise plus faible mais applicable partout.

Mon retour terrain : l’échange était devenu, chez pas mal de clients, une béquille de mauvais dimensionnement. On achetait large « parce qu’on pourra toujours échanger », et on ajustait six mois plus tard. Cette pratique s’arrête. La conséquence directe : le travail de sizing et de prévision remonte en amont de l’achat, là où il aurait toujours dû être.

5. Cinq scénarios concrets

Les trois premiers cas sont ceux documentés par Microsoft, les deux suivants sont les questions que l’on me pose systématiquement en atelier FinOps.

Cas n°1 : réservation achetée avant la bascule

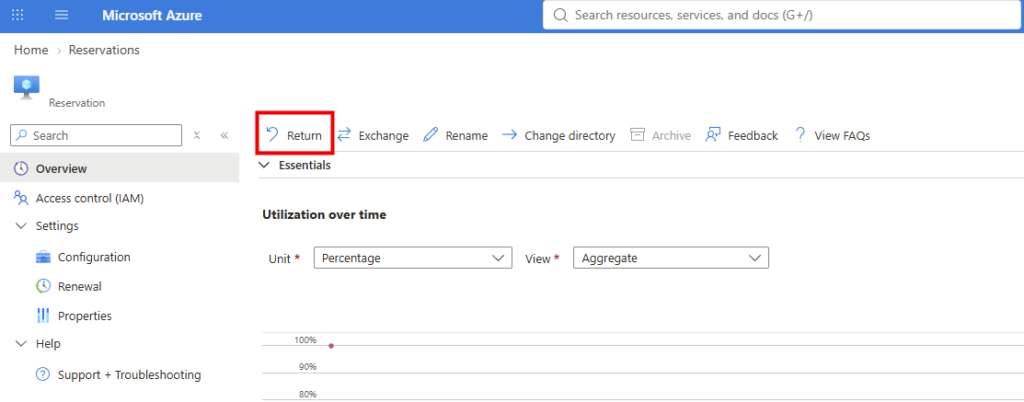
Vous achetez une réservation compute ou base de données d’un an ou trois ans avant le 1er février 2027. Vous pouvez l’échanger autant de fois que vous voulez tant que la date n’est pas passée. Si vous l’échangez après le 1er février 2027, la nouvelle réservation issue de l’échange n’est plus échangeable, parce que l’échange est traité comme une annulation, un remboursement et un nouvel achat, et que ce nouvel achat tombe sous les conditions du 1er février 2027.

Le piège classique est là : beaucoup vont croire qu’ils « gardent le droit d’échange » indéfiniment sur une réservation ancienne. Non. Le mécanisme d’échange fabrique une réservation neuve, et une réservation neuve après la bascule est verrouillée.

Cas n°2 : réservation achetée après la bascule

Vous achetez une réservation d’un an ou trois ans après le 1er février 2027. Vous ne pouvez pas l’échanger. Point. Il vous reste deux sorties : le trade-in vers un savings plan, toujours possible, et le remboursement dans la limite du plafond de 50 000 USD.
Cas n°3 : échange partiel de quantités

C’est le cas le plus intéressant et le moins connu. Vous achetez avant la bascule une réservation avec 10 quantités. Après le 1er février 2027, vous en échangez 2. Les 8 quantités restantes sur la réservation d’origine conservent chacune leur droit à un échange supplémentaire.
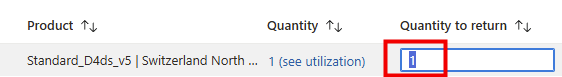
Autrement dit, l’échange final se compte à la quantité, pas à la réservation. C’est une marge de manœuvre réelle si vous savez déjà que votre parc va bouger par vagues : vous pouvez étaler vos ajustements plutôt que de tout jouer d’un coup.

Cas n°4 : l’échange coûte plus cher que prévu

Vous avez une réservation trois ans à 100 USD par mois, vous avez déjà payé 18 mensualités. Votre engagement restant est de 1 800 USD. Pour échanger, la nouvelle réservation doit avoir une valeur totale d’au moins 1 800 USD, que vous payiez au mois ou en une fois. Même logique sur un achat upfront : une réservation d’un an payée 2 400 USD, échangée après six mois, laisse un engagement restant de 1 200 USD, et la nouvelle réservation doit donc valoir 1 200 USD ou plus.

Et le terme repart de zéro. La réservation issue de l’échange démarre un nouveau cycle d’un ou trois ans à compter de la date d’échange. Si vous consommez votre échange final en fin de vie d’une réservation, vous vous rengagez donc pour un cycle complet, sur un actif désormais figé.

Cas n°5 : le trade-in plutôt que l’échange

Vos réservations VM ne collent plus à votre parc, mais vous ne savez pas vers quelle série aller. Plutôt que de brûler votre échange final sur un pari, vous les échangez contre un savings plan compute. Azure annule les réservations, vous rembourse au prorata, annule les échéances futures si vous payiez au mois, et vous engage sur un nouveau commitment horaire d’un an ou trois ans.
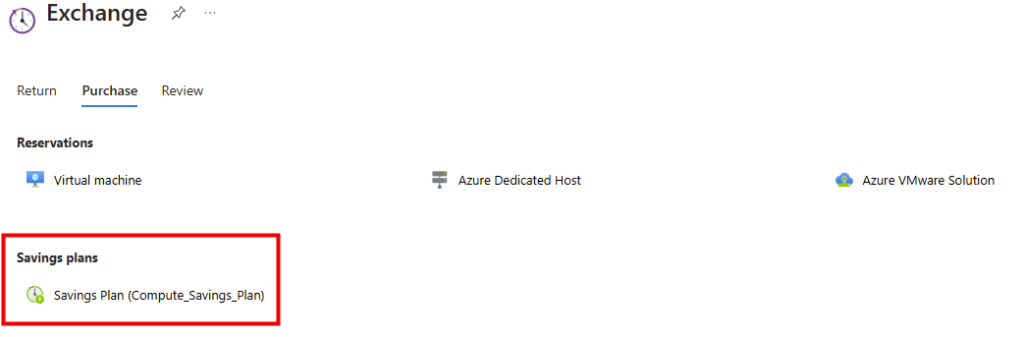
Attention : le trade-in est un aller simple. Vous ne pouvez pas échanger un savings plan contre une réservation, ni contre un autre savings plan. Réfléchissez avant.

6. Réservation ou savings plan : la grille d’arbitrage

Le savings plan, c’est un engagement en dollars par heure sur des services compute ou bases de données éligibles, appliqué automatiquement quelle que soit la région. La réservation, c’est un engagement sur un type d’instance ou une famille d’instances, dans une région donnée.

Microsoft prend l’exemple d’une D2v4 en Japan East pour un an d’un côté, et de 5,00 USD par heure pendant trois ans de l’autre.

CritèreRéservationSavings plan
Nature de l’engagementInstance ou famille d’instances, région fixéeDépense horaire, toutes régions éligibles
Niveau de remiseLe plus élevé quand l’utilisation est pleineRemise significative, mais inférieure
SouplesseInstance size flexibility uniquementApplication automatique sur les services éligibles
ÉchangeUn échange final, puis plus rien après le 1er février 2027Non échangeable par construction
Profil de workloadContinu, stable, sans changement prévuDynamique, évolutif, multi-familles ou multi-régions

Microsoft propose une séquence d’optimisation en cinq temps, et elle vaut le détour parce qu’elle remet l’ordre des opérations à l’endroit :

  1. Right-sizer d’abord, en supprimant les ressources inutilisées ou surdimensionnées. Une remise réduit un tarif, elle ne réduit pas du gaspillage.
  2. Échanger les réservations sous-utilisées vers des configurations mieux adaptées, tant que c’est encore possible.
  3. Basculer en trade-in les réservations sous-utilisées dont l’usage est variable.
  4. Acheter de nouvelles réservations, uniquement sur les workloads stables et bien compris.
  5. Ajouter des savings plans, dimensionnés sur une base de consommation déjà nettoyée.

Les points 2 et 3 ont maintenant une date de péremption. C’est tout l’enjeu des prochains mois.

7. Le trade-in en pratique

Le trade-in est le mécanisme qui survit intégralement au changement de politique, autant savoir s’en servir correctement.

Ce qui est éligible

Les réservations Azure Virtual Machines, Dedicated Hosts et Azure App Service s’échangent contre un savings plan compute, avec un nouvel engagement d’un an ou trois ans. Les réservations de bases de données s’échangent contre un savings plan database, avec un engagement d’un an. En dehors de ces produits, aucune autre réservation ni aucun pre-purchase plan n’est éligible au trade-in. Vous pouvez traiter jusqu’à 100 réservations dans une même opération d’achat de savings plan.

Les droits nécessaires

Il vous faut être owner du Reservation Order concerné, et disposer du rôle Savings plan purchaser ou être owner de la subscription qui portera l’achat. Et voici le piège qui fait échouer la moitié des premières tentatives : les permissions EA Admin write et Billing profile contributor, qui suffisent pour un achat direct de savings plan, ne fonctionnent pas pour un achat réalisé dans le cadre d’un trade-in de réservation.

Calculer le bon commitment horaire

Attention, celui-ci mérite qu’on s’y arrête. Lors d’un trade-in, le commitment horaire proposé par défaut est calculé à partir de la valeur monétaire restante des réservations retournées. Ce montant n’est pas forcément suffisant pour couvrir les VM que les réservations couvraient. Vous risquez donc de sortir de l’opération avec une couverture en baisse sans vous en rendre compte.

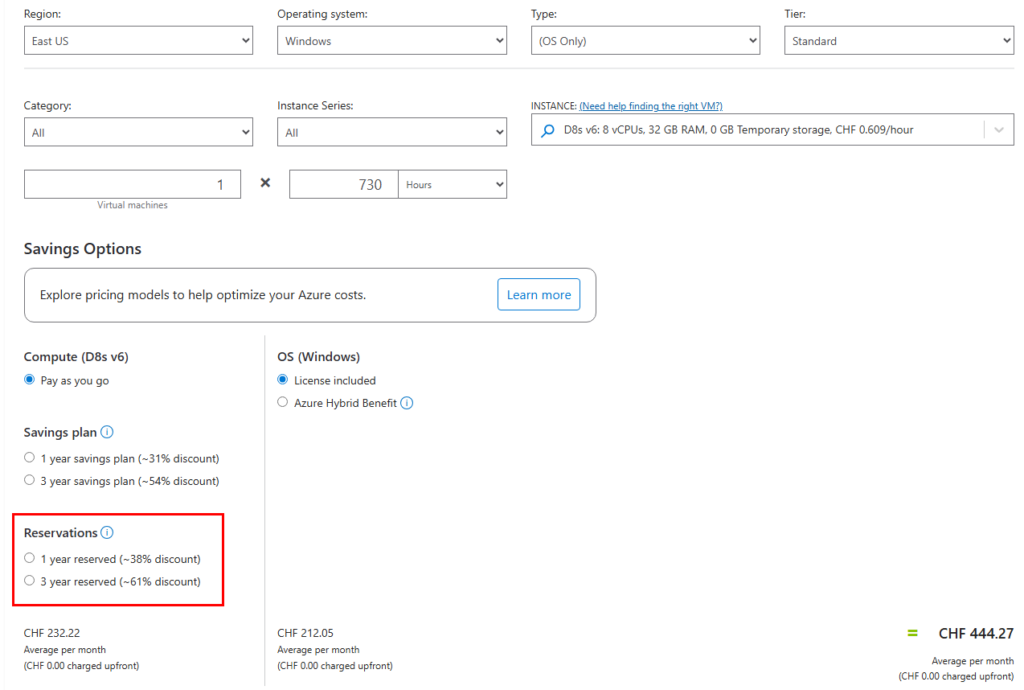
La méthode Microsoft pour calculer le vrai commitment, produit par produit, en partant de la calculatrice de prix Azure et d’un affichage upfront :

  1. Récupérer le coût upfront annuel du produit concerné pour le terme de savings plan visé.
  2. Diviser ce coût par 8 760 pour un savings plan d’un an, ou par 26 280 pour un savings plan de trois ans.
  3. Multiplier le résultat par le nombre d’instances que vous retournez.
  4. Répéter pour chaque produit du trade-in, puis additionner : c’est votre commitment horaire.
Attention : ce calcul suppose une utilisation à 100 % des réservations retournées. Et comme le savings plan est un bénéfice flexible, rien ne garantit qu’il s’appliquera toujours en priorité aux ressources précédemment couvertes. Vérifiez votre couverture réelle dans les jours qui suivent l’opération.

8. Les pièges à connaître

Sept points de vigilance à garder sous la main quand vous allez manipuler votre portefeuille d’engagements dans les prochains mois.

  • Le plafond de remboursement. 50 000 USD de commitment annulé maximum sur 12 mois glissants, par billing profile ou enrollment. Bonne nouvelle : les remboursements issus d’un échange ne consomment pas ce plafond. Mauvaise nouvelle : si l’échange n’est plus disponible, toute sortie passe désormais par un remboursement qui, lui, décompte.
  • Le réapprovisionnement du plafond. Il n’est pas annuel civil. Si vous annulez 2 400 USD, votre marge tombe à 47 600 USD et remonte de 2 400 USD exactement 365 jours après l’opération.
  • Les gros engagements bloqués. Sur une réservation trois ans à 3 000 USD par mois, soit 108 000 USD, vous ne pouvez rien annuler tant que vous n’avez pas consommé 58 000 USD de votre engagement, parce que le reste dépasse le seuil de 50 000 USD.
  • Pas d’échange entre familles de produits. Une réservation Cosmos DB ne s’échange pas contre une réservation SQL Database. Les échanges restent cantonnés à la famille : compute avec compute, SQL avec SQL.
  • Certaines réservations n’ont jamais été échangeables. Les plans Red Hat, les plans SUSE Linux et tous les pre-purchase plans sont exclus de l’échange comme du remboursement, et ce point n’a pas changé.
  • Les droits sur le Reservation Order. Il faut être owner ou Reservation administrator sur le Reservation Order pour échanger ou rembourser. Ce n’est pas un rôle de subscription, et ça se prépare à l’avance.
  • Le cas CSP. Un client CSP ne peut pas échanger, annuler, renouveler ou rembourser lui-même : c’est le partenaire qui effectue l’opération pour son compte. Si vous êtes dans ce modèle, calez le sujet avec votre partenaire dès maintenant, pas le 25 janvier 2027.

Deux précisions financières utiles pour le dossier que vous allez devoir monter en interne. Côté EA, un remboursement revient sous forme de crédit sur l’Azure Prepayment, et ce crédit n’est valable que 90 jours : passé ce délai, il est perdu. Côté frais, Microsoft ne facture pas de frais de résiliation anticipée aujourd’hui, mais la documentation mentionne explicitement la possibilité de 12 % à l’avenir, sans date annoncée.

9. Votre plan d’action avant le 1er février 2027

Il vous reste environ cinq mois. Microsoft résume l’action attendue en une ligne : passez en revue votre portefeuille de réservations, évaluez vos besoins futurs de flexibilité, envisagez les savings plans là où c’est pertinent, et planifiez la façon dont vous voulez utiliser l’échange final. Voici comment je le décline concrètement.

  1. Inventoriez. Exportez la liste de vos réservations avec, pour chacune, le service, la date d’achat, le terme, la date d’expiration, la quantité et le taux d’utilisation. Si vous n’avez pas encore fait l’inventaire de vos VM par série, la procédure pas-à-pas est dans VM Azure : anticipez les dépréciations, et les deux exercices se font très bien dans la foulée.
  2. Classez chaque ligne en trois piles : stable et bien dimensionnée, sous-utilisée, ou obsolète parce que le workload a bougé.
  3. Right-sizez le parc avant de toucher aux engagements. On n’optimise pas une remise sur des ressources qu’on va éteindre, ni sur une série qui part à la retraite en 2028.
  4. Traitez la pile « sous-utilisée » avant le 31 janvier 2027, tant que les échanges sont encore illimités. C’est votre fenêtre de correction gratuite.
  5. Pour les workloads dont vous ne savez pas dire où ils seront dans un an, privilégiez le trade-in vers un savings plan plutôt que de consommer l’échange final sur un pari.
  6. Documentez, pour chaque réservation antérieure à la bascule, si son échange final est encore disponible. Sans ce suivi, personne ne saura répondre en 2028.
  7. Vérifiez dès maintenant les droits : owner ou Reservation administrator sur les Reservation Orders, rôle Savings plan purchaser pour les trade-in.
  8. Reprenez vos gabarits d’achat et vos process internes : à partir du 1er février 2027, un achat de réservation est un engagement ferme, il mérite le même niveau de validation qu’un investissement.

Conclusion

Voilà, en neuf sections, de quoi arrêter de subir cette annonce. Le changement n’est pas une catastrophe, c’est une remise à plat : Azure vous propose désormais deux produits d’engagement clairement séparés, un rigide et très remisé, un souple et un peu moins remisé, et vous demande de choisir en connaissance de cause.

Les quatre pièges à retenir :

  1. Un échange réalisé après le 1er février 2027 produit une réservation définitivement figée, parce qu’un échange est techniquement un rachat.
  2. L’échange final se compte à la quantité, pas à la réservation : c’est une marge de manœuvre, à condition de la suivre.
  3. Le commitment horaire proposé par défaut lors d’un trade-in ne garantit pas votre niveau de couverture précédent.
  4. Sans échange, la seule porte de sortie restante est le remboursement, et lui se heurte au plafond de 50 000 USD sur 12 mois glissants.

Sortez votre export de réservations, comptez les lignes sous-utilisées, et calez l’exercice avant fin janvier. Foncez, c’est le genre de chantier qui prend deux heures maintenant et coûte très cher plus tard.

🤖
Contenu assisté par IA
Cet article a été rédigé avec l’assistance d’une intelligence artificielle et relu par l’auteur. Conformément à l’AI Act (UE) en vigueur depuis le 2 août 2026.
VM Azure : anticipez les dépréciations !

Depuis quelques mois, à l’heure où j’écris ces lignes fin juillet 2026, vous avez peut-être déjà reçu un ou plusieurs mails d’Azure au sujet de certaines de vos machines virtuelles : des annonces sur les Reserved Instances, sur des séries qui partent à la retraite, et vous vous demandez ce qui va réellement vous tomber dessus, et surtout quand ? Cet article est fait pour vous.

Car ces annonces ne forment pas un seul événement, mais trois vagues distinctes qui convergent sur la même période. On va les démêler une par une, poser le calendrier noir sur blanc, puis dérouler, capture après capture, ce que vous devez vérifier et faire dès maintenant dans le portail Azure. Objectif : que vous ressortiez de cette lecture avec un plan d’action clair, pas juste une vague inquiétude.

Pour vous guider plus facilement dans cet article, voici des liens rapides :

  1. Pour rappel : de quoi on parle ?
  2. Vague 1 : la fin des Reserved Instances (1er juillet 2026)
  3. Vague 2 : le gel de la croissance de capacité (31 juillet 2026)
  4. Vague 3 : le calendrier de retraite des séries v1 à v4
  5. Vers quoi migrer ? Les séries cibles v5, v6, v7
  6. Ce que vous devez faire, concrètement
  7. En résumé : les pièges à retenir

Pour rappel : de quoi on parle ?

Les annonces Azure mélangent plusieurs vocabulaires, et la plupart des malentendus viennent de leur confusion. Le cycle de vie d’une taille de VM passe par quatre états successifs :

  • Génération courante : la série recommandée, avec capacité garantie.
  • Previous-gen (génération précédente) : encore pleinement supportée, mais sans garantie de capacité supplémentaire. Deux nuances, next-gen available (pas encore de date de retraite) et capacity limited (plus aucune capacité déployée).
  • Retraite annoncée : une date de fin est fixée, la VM tourne encore mais il faut migrer.
  • Retirée : la taille n’est plus disponible, impossible d’en provisionner.

Deux autres termes, financiers cette fois, reviennent sans arrêt :

  • Reserved Instance (RI) : un engagement d’un ou trois ans sur une série de VM précise, en échange d’une remise. C’est un dispositif de facturation, pas un état de la VM.
  • Quota : le plafond de cœurs que votre abonnement peut déployer pour une série donnée, dans une région donnée.

Le fil rouge de tout l’article tient en deux phrases : previous-gen ne veut pas dire retirée, et fin des RI ne veut pas dire retraite de la VM. Gardez ces distinctions en tête, elles évitent la grande majorité des paniques inutiles.

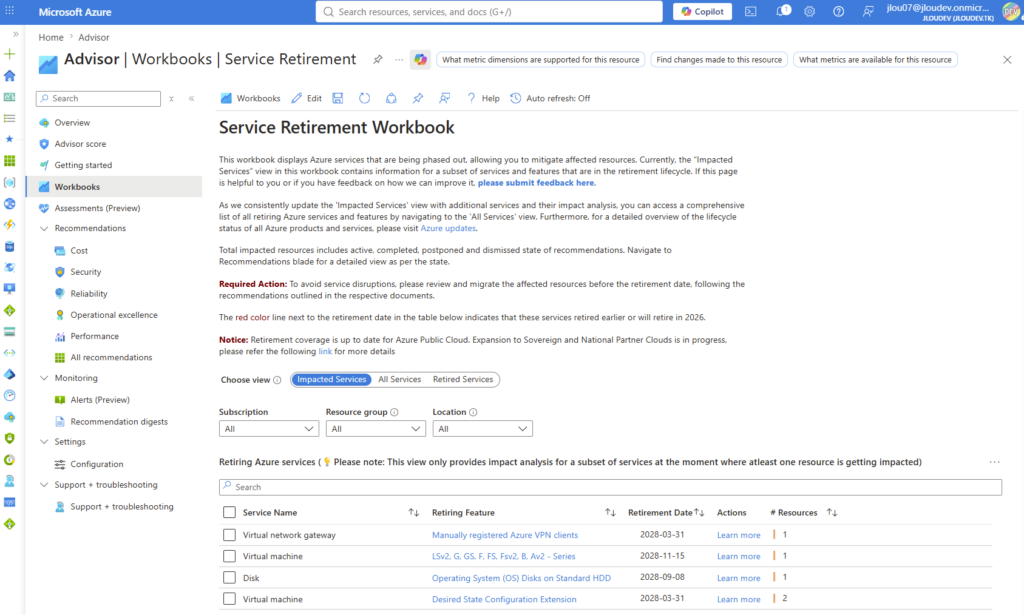
Voici d’ailleurs pour info un portail très utile des décommissionnements prévus par Microsoft, accessible directement depuis le portail Azure Advisor :

Vague 1 : la fin des Reserved Instances (1er juillet 2026)

Première vague dans l’ordre chronologique, et elle est déjà passée. Depuis le 1er juillet 2026, Azure ne vend plus et ne renouvelle plus certaines Reserved Instances. Mais l’histoire a commencé bien avant cette date, car les réservations 1 an et 3 ans ne s’arrêtent pas au même moment. Voici le tableau complet des échéances :

SériesRI 3 ans : plus d’achat ni de renouvellement depuisRI 1 an : plus d’achat ni de renouvellement depuis
D, Ds, Dv2, Dsv2, Ls1er mai 20251er juillet 2026
Av2, Amv2, Bv1, F, Fs, Fsv2, G, Gs, Lsv215 novembre 20251er juillet 2026
Dv3, Dsv3, Ev3, Esv31er juillet 20261er juillet 2026

Ce qu’il faut lire dans ce tableau : pour la plupart de ces séries, les réservations 3 ans ne sont déjà plus renouvelables depuis 2025 (mai pour la famille D et Ls, novembre pour les autres). Seules les réservations 1 an tenaient encore, et c’est cette dernière porte qui s’est refermée le 1er juillet 2026. Pour Dv3, Dsv3, Ev3 et Esv3, les deux durées s’arrêtent le même jour, le 1er juillet 2026.
Bon à savoir : cette date du 1er juillet 2026 pour les RI 1 an a été avancée. Elle était initialement fixée au 15 novembre 2027 (Azure Update 500682). Microsoft l’a donc rapprochée de plus d’un an, ce qui laisse encore moins de marge que ce qui était annoncé au départ.

Un point capital pour Dv3, Dsv3, Ev3 et Esv3 : ces séries ne sont pas retirées, elles restent « product active ». Ce sont seulement leurs réservations qui s’arrêtent. Ne confondez pas les deux.

Le piège classique : croire que le renouvellement automatique vous protège. Il ne joue plus pour ces séries. Vos réservations existantes restent valables jusqu’au bout de leur terme, un contrat 3 ans en cours court par exemple jusqu’à sa date de fin, mais à leur expiration, la charge bascule automatiquement en tarif pay-as-you-go, souvent bien plus cher, même si l’option de renouvellement automatique était cochée.

« July 1, 2026 does not terminate existing RIs. RIs remain valid until their individual expiration dates. »

Source : Transition guide for retired Azure Reserved VM Instances, Microsoft Learn
Attention : le 1er juillet 2026 ne résilie aucune réservation en cours. Une RI reste honorée jusqu’à sa date d’expiration individuelle. Le risque n’est pas une coupure, c’est une hausse de facture silencieuse le jour où elle expire.

Trois leviers, selon votre situation :

  • Passer à l’Azure savings plan for compute : un engagement basé sur la dépense horaire, flexible entre familles de VM et entre régions. C’est la recommandation numéro un de Microsoft.
  • Migrer vos charges vers une série récente, qui redonne accès aux RI comme aux Savings Plans.
  • Ne rien faire et assumer le pay-as-you-go, mais que ce soit un choix conscient, pas un oubli.

Note : la possibilité de renouveler une dernière fois les réservations 1 an existait jusqu’au 30 juin. Depuis le 1er juillet, cette porte est fermée pour les séries listées ci-dessus, et celle des réservations 3 ans l’était déjà depuis 2025 :

Vague 2 : le gel de la croissance de capacité (31 juillet 2026)

Deuxième vague, et de loin la plus imminente puisque la première est déjà derrière nous. À compter du 31 juillet 2026, Azure gèle la croissance de capacité des anciennes séries. Concrètement, les demandes suivantes ne seront plus approuvées :

  • les nouveaux déploiements de VM sur ces séries,
  • les opérations de scale-out qui réclament de la capacité supplémentaire,
  • les demandes d’augmentation de quota,
  • vos plans de croissance future sur ces séries.

Ce qui n’est pas touché, et c’est la bonne nouvelle : vos déploiements existants continuent de tourner dans la limite de la capacité déjà allouée. Aucune interruption, aucune VM coupée du jour au lendemain à cause de ce gel.

Les séries concernées se répartissent en deux groupes. D’abord celles qui partent à la retraite et sont soumises au gel :

  • Compute optimisé : F, Fs, Fsv2
  • Usage général : D, Ds, Dv2, Dsv2, Av2, Amv2, B, Bs
  • Mémoire : G, Gs
  • Stockage : Ls, Lsv2

Ensuite celles qui ne sont pas (encore) retirées mais déjà soumises au contrôle de croissance :

  • Usage général : Dv3, Dsv3, Dv4, Dsv4, Ddv4, Ddsv4, Dav4, Dasv4
  • Mémoire : Ev3, Esv3, Ev4, Esv4, Edv4, Edsv4, Eav4, Easv4
Attention : le gel ne coupe rien, mais il vous enferme. Si demain vous avez besoin d’ajouter des VM sur une de ces séries (montée en charge, nouveau projet, reprise d’activité dans une autre région), la demande peut être refusée. C’est précisément le scénario à anticiper avant le 31 juillet.

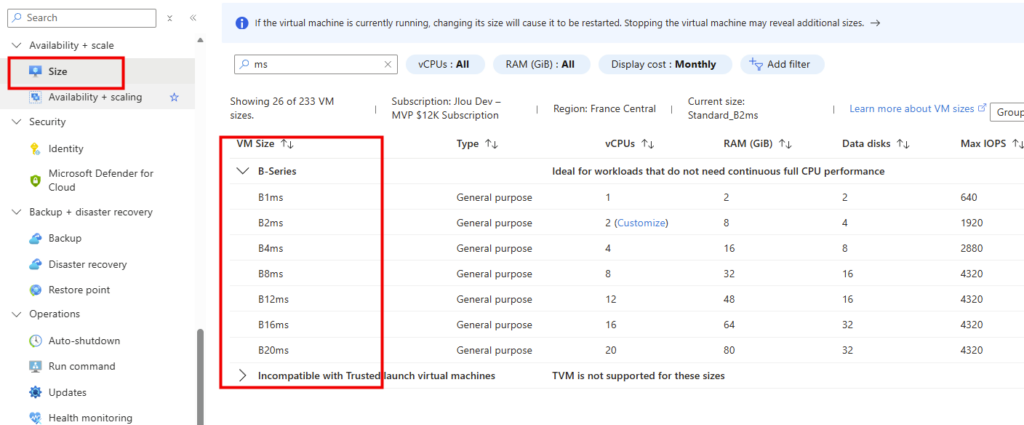
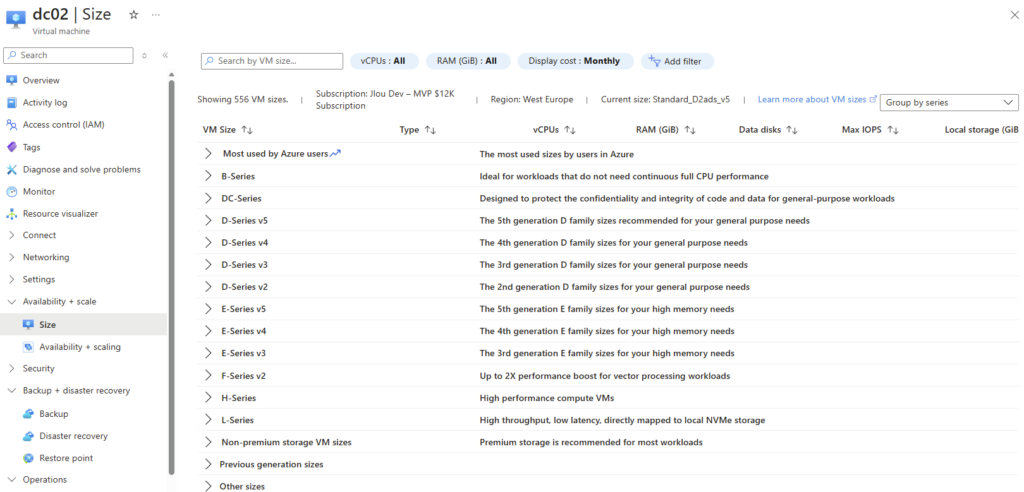
Je vous propose de regarder en exemple une machine virtuelle en série Bs avant la date du 31 juillet 2026. Le redimensionnement de celle-ci vers différentes tailles de la même famille est possible :
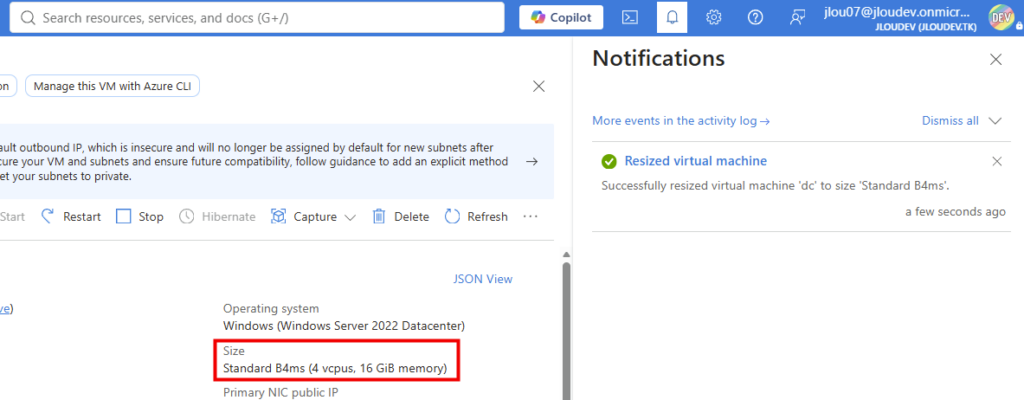
Et celui-ci fonctionne bien :

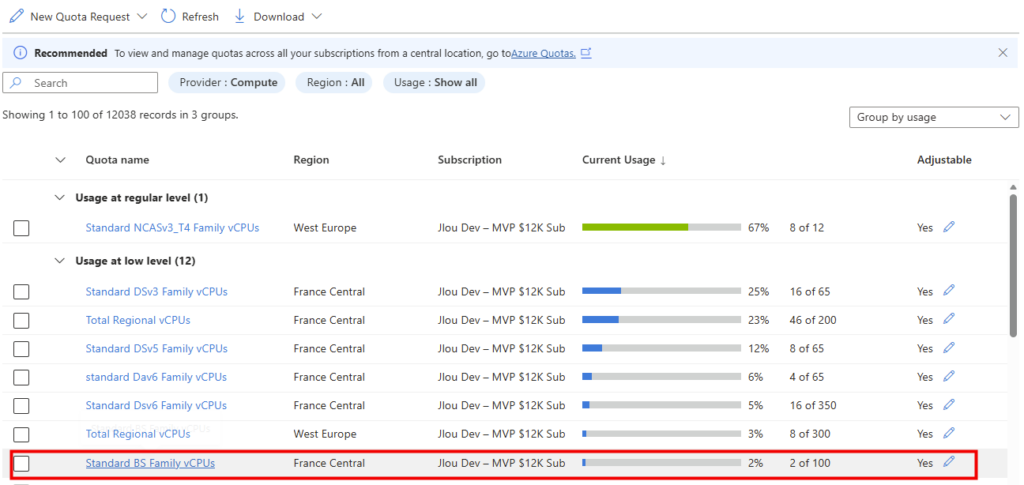
Par contre, j’avais déjà eu un refus de la part de Microsoft sur une demande d’augmentation de quota pour cette série :

Je vous referai dans quelques jours d’autres copies d’écran afin de comparer le changement à partir du 1er août.

Vague 3 : le calendrier de retraite des séries v1 à v4

Troisième vague, la plus étalée dans le temps. Voici le calendrier consolidé des retraites, de la plus ancienne (déjà effective) à la plus lointaine.

SérieCatégorieStatutDate de retraite
NCv3, NCv3-NC24rsGPURetirée30/09/2025
NVv3, NVv4GPUAnnoncée30/09/2026
M192idms_v2, M192ids_v2, M192ims_v2, M192is_v2MémoireAnnoncée31/03/2027
NP-seriesFPGAAnnoncée31/05/2027
D, Ds, Dv2, Dsv2Usage généralAnnoncée01/05/2028
LsStockageAnnoncée01/05/2028
Av2, Amv2Usage généralAnnoncée15/11/2028
B-series (V1)Usage généralAnnoncée15/11/2028
F, Fs, Fsv2Compute optimiséAnnoncée15/11/2028
G, GsMémoireAnnoncée15/11/2028
Lsv2StockageAnnoncée15/11/2028

Deux lectures à retenir. D’une part, certaines séries GPU sont déjà retirées depuis septembre 2025 : si vous tournez encore dessus, vous êtes hors support et hors SLA. D’autre part, le gros des séries généralistes (D, Ds, Av2, F, G et compagnie) part en 2028, ce qui vous laisse du temps pour planifier, à condition de commencer maintenant. Le lot du 15 novembre 2028 (F, Fs, Fsv2, Lsv2, G, Gs, Av2, Amv2 et la série B) fait d’ailleurs l’objet d’une annonce dédiée, l’Azure Update 500682.

Attention : la date de retraite n’est pas le seul mur. Dès qu’une série passe en capacity limited, vous pouvez vous heurter à un manque de capacité bien avant la date officielle. Le gel du 31 juillet, c’est exactement ça. Ne calez pas votre migration sur 2028 en pensant être tranquille.

Vers quoi migrer ? Les séries cibles v5, v6, v7

Bonne nouvelle, Microsoft fournit une table de correspondance claire. Voici les cibles recommandées, série par série.

Séries actuellesCibles recommandéesÀ noter
D, Ds, Dv2, Dsv2Dsv5/Ddsv5/Dasv5/Dadsv5, Dsv6/Ddsv6/Dasv6/Dadsv6, Dasv7/Dadsv7Contrôleur de disque SCSI en v5, NVMe en v6 et v7
Av2, Amv2Bsv2/Basv2, Dsv5/Dasv5, Esv5/Easv5, Dsv6/Dasv6, Esv6/Easv6SCSI en v5, NVMe en v6
Bv1Bsv2/Basv2, Dlsv5/Dalsv5, Dlsv6/Dalsv6Débit de stockage distant plus élevé
F, Fs, Fsv2Falsv6, Dlsv6/Daldsv6, Dlsv5/Dsv5/Ddsv5NVMe en v6
G, GsLsv3/Lasv3, Lsv4/Lasv4Stockage local NVMe, débit distant nettement supérieur
Ls, Lsv2Lsv3/Lasv3, Lsv4/Lasv4Lsv4 et Lasv4 sont la dernière génération L
Dv3, Dsv3 (RI arrêtées)Dsv5/Ddsv5/Dasv5, Dsv6/Ddsv6/Dasv6Pas retirées, mais plus de RI
Ev3, Esv3 (RI arrêtées)Esv5/Edsv5/Easv5, Esv6/Edsv6/Easv6Pas retirées, mais plus de RI
Attention : la génération v6 impose des prérequis. Elle exige le NVMe activé (donc un OS supporté), fonctionne uniquement avec des VM de Génération 2, et requiert l’adaptateur réseau MANA avec un OS compatible. Si l’un de ces points bloque, repliez-vous provisoirement sur la v5. Et vérifiez la capacité régionale de la cible, elle n’est pas garantie partout.

Ce que vous devez faire, concrètement

Assez de théorie. Voici la marche à suivre, étape par étape, capture après capture. Comptez une petite heure pour un premier inventaire propre.

Étape 1 : inventorier vos VM par série

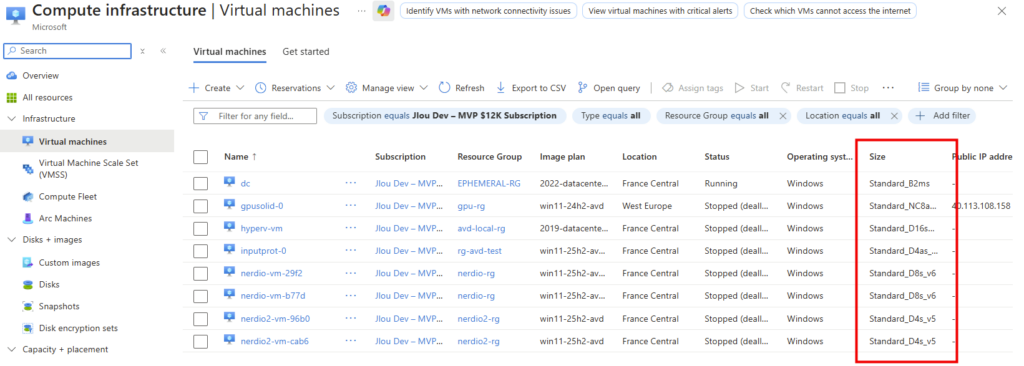
Direction le portail Azure. Dans la barre de recherche, tapez Virtual machines pour ouvrir la liste de vos VM. Ajoutez la colonne Size (bouton Manage view puis Edit columns) pour voir d’un coup d’œil la taille de chaque machine, puis repérez celles dont la série figure dans les tableaux ci-dessus :

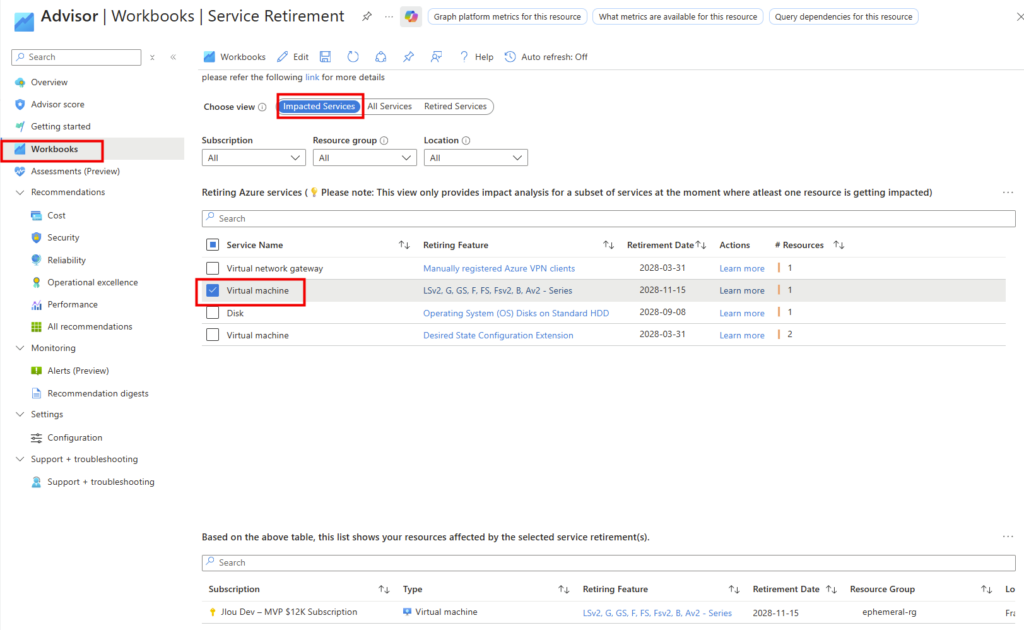
Vous pouvez aussi utiliser le rapport Service Retirement Workbook disponible dans Azure Advisor :

Étape 2 : auditer vos Reserved Instances

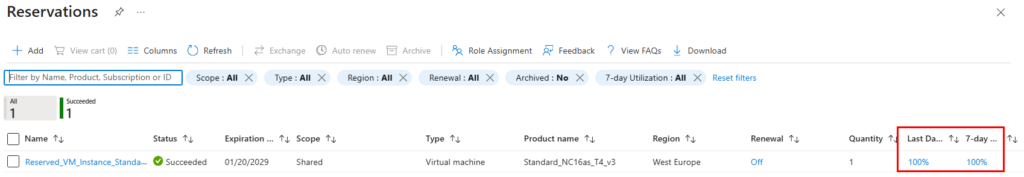
Toujours dans le portail, recherchez Reservations. Filtrez par Product type réglé sur Virtual machines, puis examinez deux colonnes, la VM family et la date d’expiration. Toute réservation dont la famille figure dans la liste de la vague 1 est concernée :

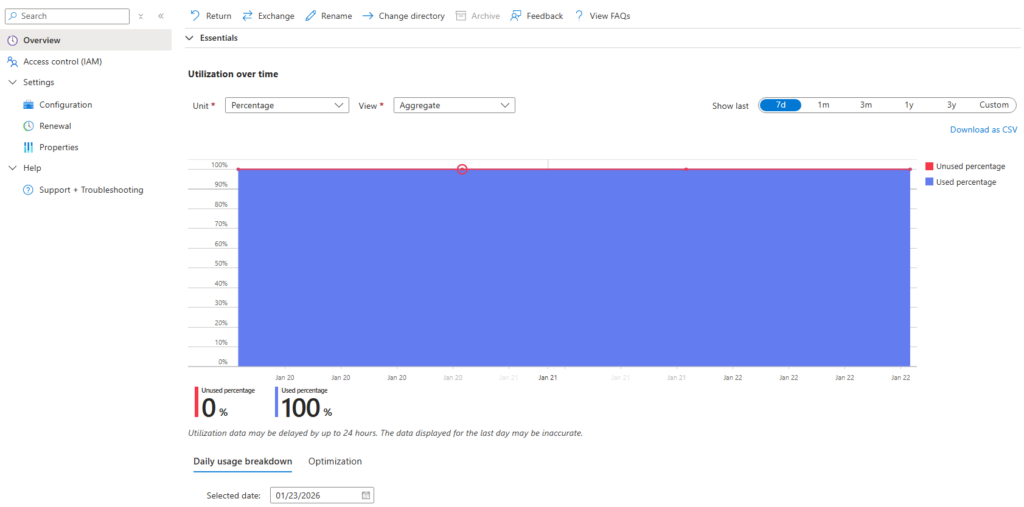
Pour aller plus loin, ouvrez le détail de la réservation concernée et vérifiez son taux d’utilisation ainsi que sa date de fin. Confirmez si la charge continuera au-delà de l’expiration : si oui, il faut agir avant :

Étape 3 : choisir votre stratégie de coûts

Pour chaque réservation ou VM concernée, tranchez entre trois options : basculer vers un Azure savings plan for compute, moderniser la VM, ou assumer le pay-as-you-go.

Le trade-in d’une réservation vers un Savings Plan se fait en libre-service depuis le portail :

Passez un instant sur le calculateur de prix Azure pour chiffrer l’écart entre votre coût actuel et la cible :

Étape 4 : vérifier le quota de la série cible

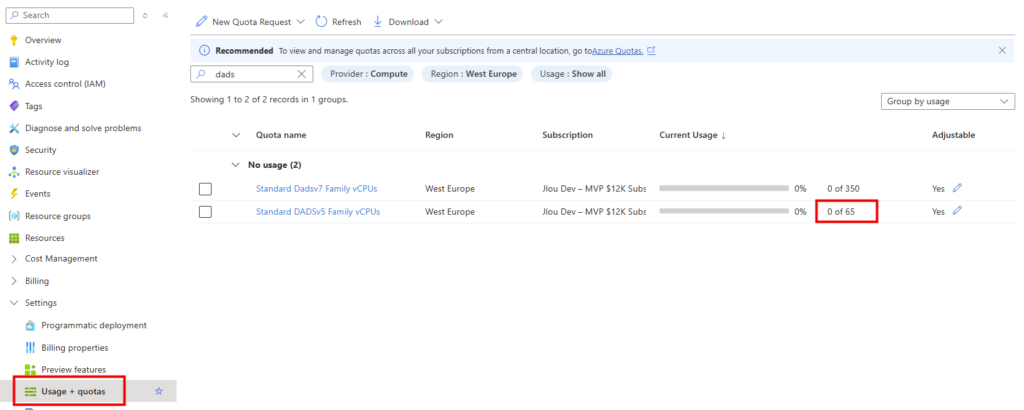
Avant de redimensionner, assurez-vous que votre abonnement dispose d’assez de quota pour la série visée. Ouvrez Subscriptions, sélectionnez votre abonnement, puis Usage + quotas :

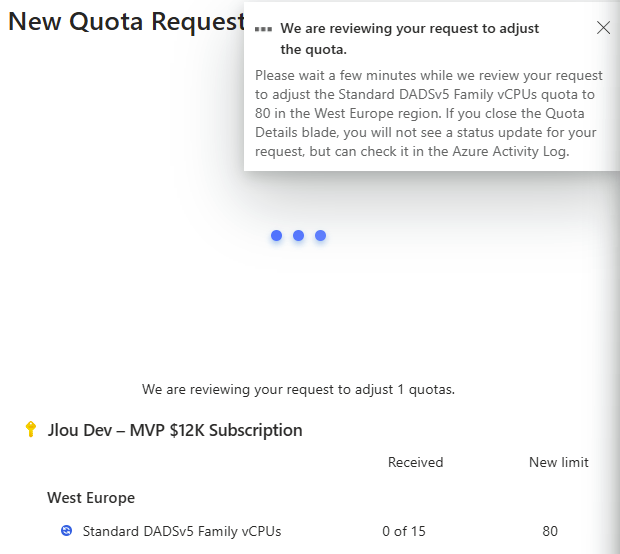
Si le plafond est trop bas, cliquez sur Request increase pour demander une augmentation sur la série cible :

Étape 5 : redimensionner la VM

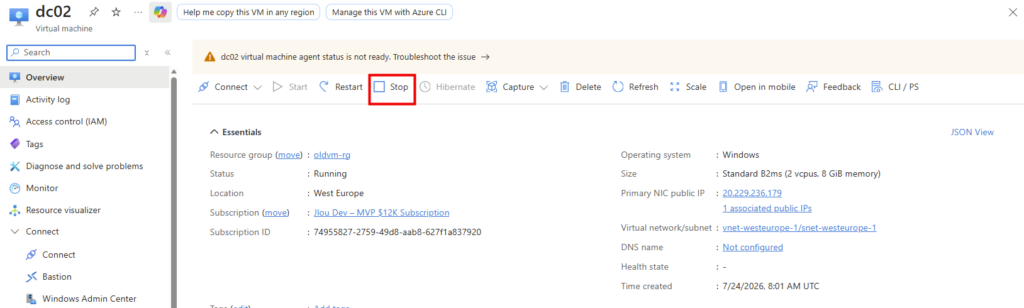
Dernière ligne droite. Le redimensionnement se fait en trois temps. Sur la VM, cliquez sur Stop pour la désallouer proprement avant :

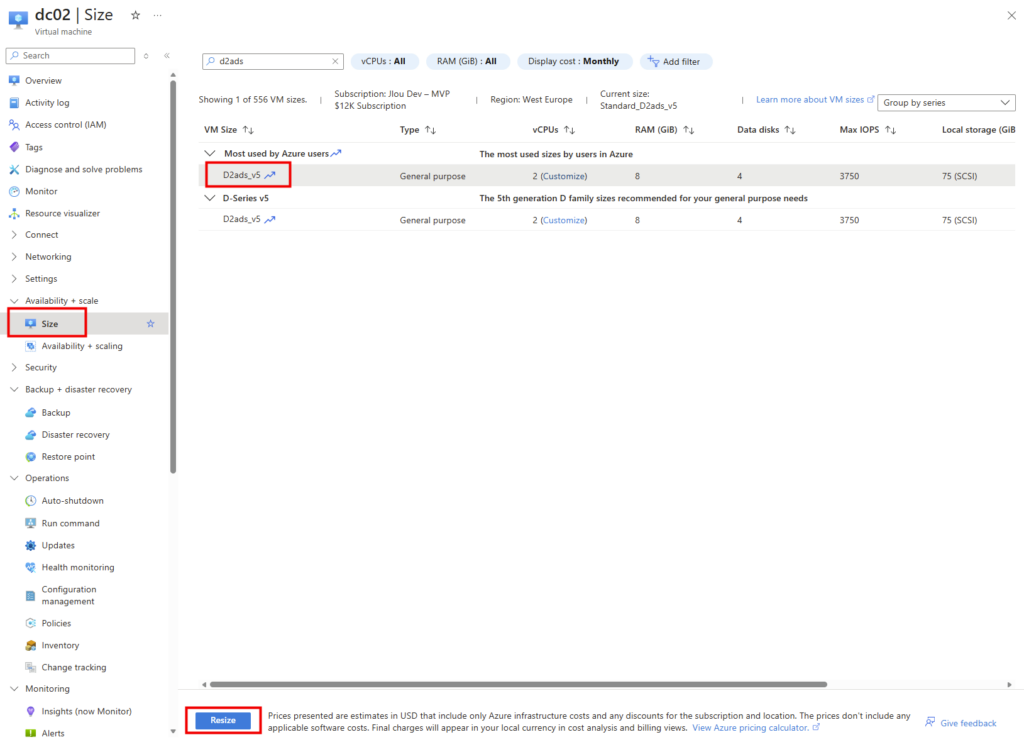
Une fois la machine virtuelle arrêtée et désallouée, ouvrez le volet Size, choisissez la taille cible, validez avec Resize :

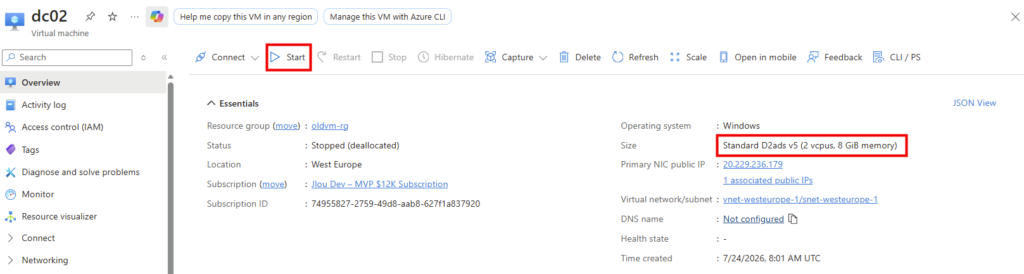
Une fois le redimensionnement réussi, cliquez sur Start pour redémarrer la machine :

Le piège classique : oublier que les données du disque temporaire et de la mémoire sont perdues à la désallocation. Les disques managés, eux, sont conservés. Prévenez donc les applications qui s’appuient sur le disque temporaire avant de lancer l’opération.

Mon retour terrain : planifiez ce chantier 6 mois avant chaque échéance, pas la veille. Alignez la bascule sur vos fenêtres de maintenance applicative et sur vos cycles d’achat de Savings Plan, et faites modéliser les coûts par votre équipe de compte Microsoft. Le faire dans l’urgence, c’est la garantie de payer plus cher et de casser quelque chose.

En résumé : les pièges à retenir

Voilà, en trois vagues, tout ce qui se joue sur vos anciennes VM Azure. Concrètement, qu’est-ce que vous devez garder en tête ?

  1. Deux dates pivots : le 1er juillet 2026 (fin des RI 1 an, déjà passé, les RI 3 ans ayant même cessé dès 2025) et le 31 juillet 2026 (gel de capacité, imminent).
  2. Previous-gen n’est pas retirée, mais capacity limited peut vous bloquer bien avant la date de retraite officielle.
  3. Fin des RI n’est pas retraite de la VM : Dv3, Dsv3, Ev3 et Esv3 restent actives, seules leurs réservations s’arrêtent.
  4. Le renouvellement automatique ne joue plus : à l’expiration, bascule silencieuse en pay-as-you-go.
  5. La v6 impose des prérequis (NVMe, Génération 2, MANA) et une capacité régionale non garantie : testez avant.
  6. À la désallocation, disque temporaire et mémoire perdus, disques managés conservés.
Le vrai message : aucune de ces vagues ne coupe vos VM du jour au lendemain, mais toutes récompensent ceux qui anticipent et punissent ceux qui attendent. Faites votre inventaire cette semaine, pendant que vous avez encore le temps de choisir plutôt que de subir.

Foncez auditer vos abonnements, et si cet article vous a fait gagner du temps, dites-le moi en commentaire.

Pour aller plus loin

Features AVD en GA en juin 2026

Vous les avez peut-être testées en préversion, comme moi : l’orchestration des hôtes de session, la mise à l’échelle dynamique et les disques OS éphémères sur Azure Virtual Desktop. Bonne nouvelle, depuis juin 2026 ces trois briques de gestion avancée des host pools sont annoncées en disponibilité générale. L’occasion de faire le point, de regrouper mes trois anciens tutos de préversion, et surtout de pointer ce qui a changé depuis, car un seul détail peut casser vos anciens déploiements.

Ces fonctionnalités, je les avais chacune détaillées dans un tutoriel pas-à-pas quand elles étaient en préversion. Plutôt que de vous renvoyer vers trois articles vieillissants, je les réunis ici en une synthèse à jour de la GA, avec des liens vers chaque tuto d’origine si vous voulez remettre les mains dans le portail.

1. De la préversion à la GA : ce qui change vraiment

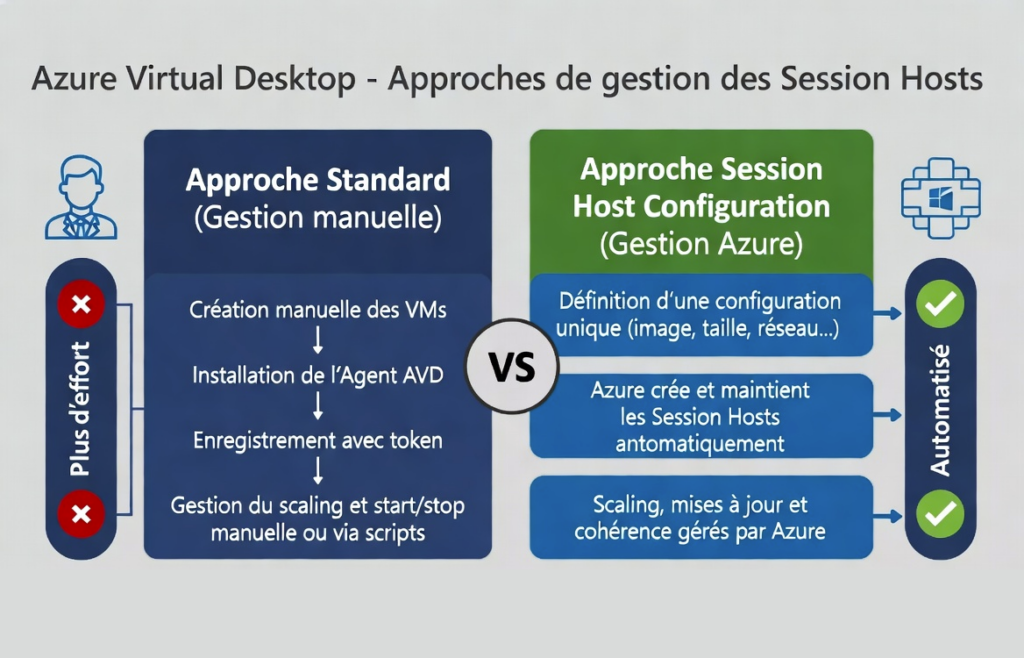
Avant d’entrer dans le détail, un rappel utile sur la notion de fond. Sur Azure Virtual Desktop, un pool d’hôtes partagé se gère de deux façons :

La gestion standard, où vous créez, mettez à jour et scalez vos hôtes avec vos propres outils, et la gestion par configuration d’hôte de session, celle que Microsoft qualifie d’automatisée. C’est cette seconde approche, et les capacités qui gravitent autour, qui passe en GA :

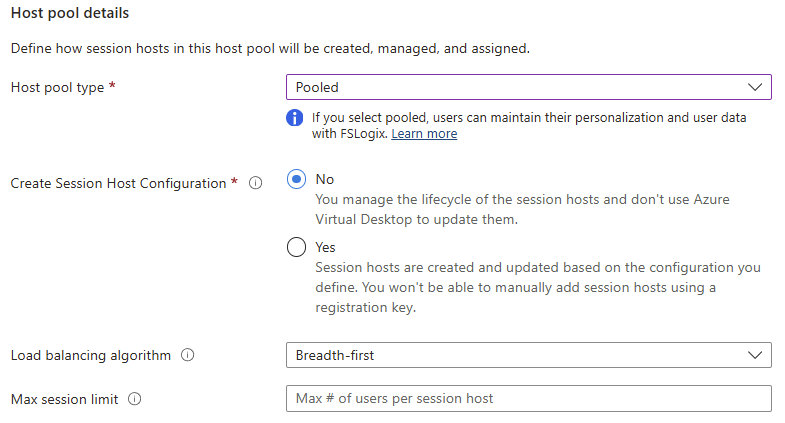
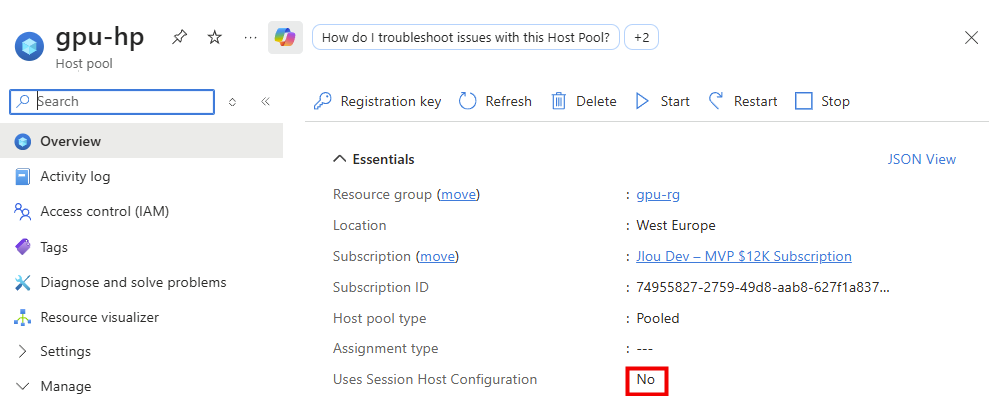
Point de vigilance à connaître dès maintenant : le choix de l’approche se fait à la création du pool d’hôtes et ne peut plus être modifié ensuite :

Un pool créé sans configuration d’hôte de session ne pourra jamais en recevoir une par la suite. Cette approche ne concerne par ailleurs que les pools d’hôtes mutualisés :

À surveiller : à l’heure où j’écris ces lignes, certaines pages de référence Microsoft, comme celle de la mise à jour de l’hôte de session ou celle de l’identité managée, portent encore la mention préversion. Le changelog officiel, lui, annonce bien la disponibilité générale et distingue clairement les nouveautés qui restent en preview. Le plus probable est un simple décalage de documentation, doublé d’un déploiement progressif. À vérifier dans votre tenant avant tout passage en production.

2. L’orchestration des hôtes de session

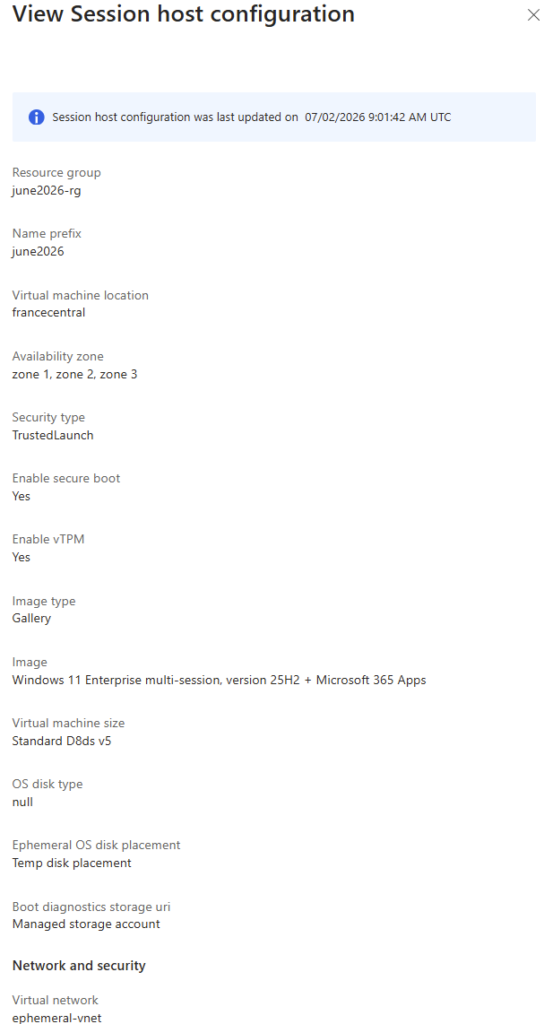
C’est la brique centrale. La configuration d’hôte de session, ou session host configuration, décrit une bonne fois pour toutes ce que doivent être vos hôtes : image, taille de VM, type de disque, type de sécurité, jonction de domaine, réseau, identité, tags.

Tous les hôtes du pool s’alignent sur cette configuration unique :

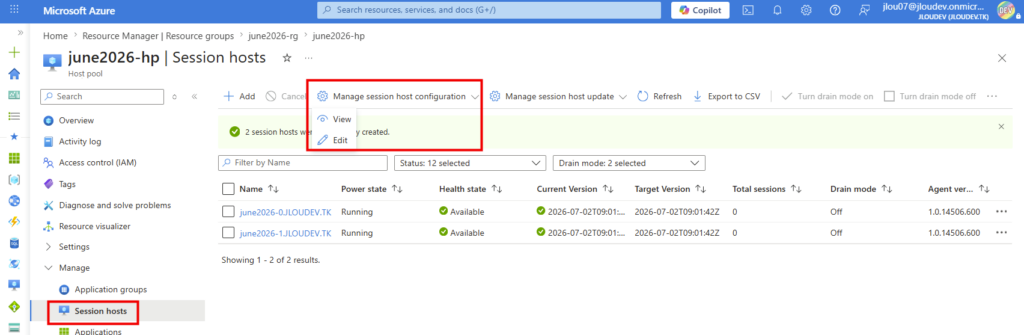
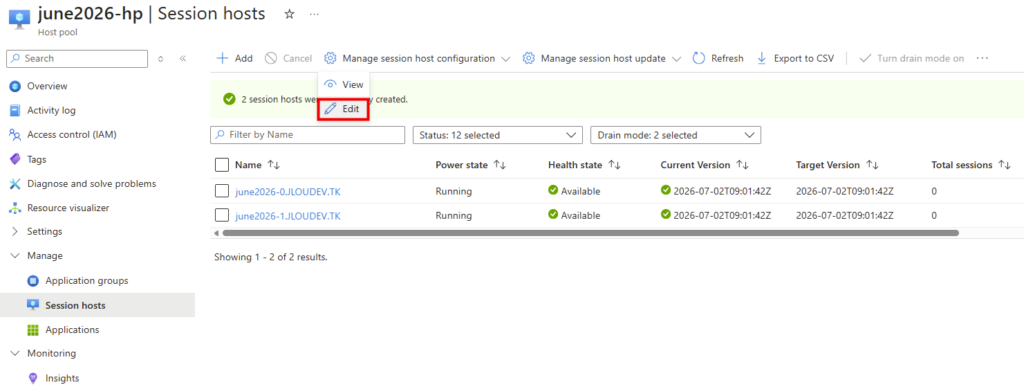
Pour faire évoluer votre parc, vous ne touchez plus chaque VM une par une, vous modifiez la configuration :

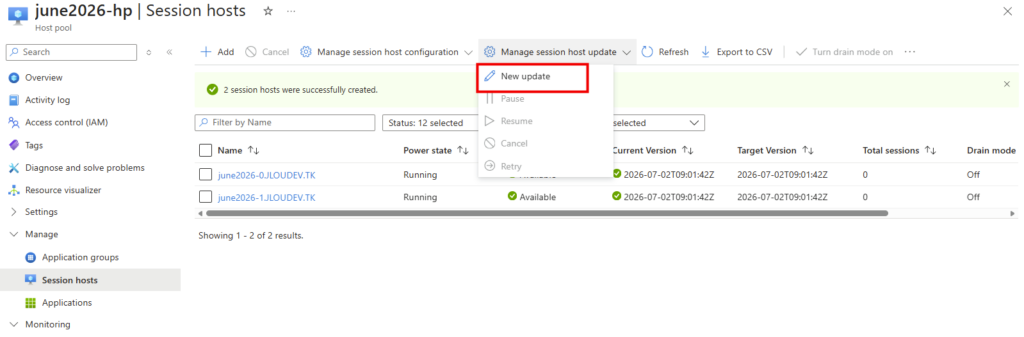
Puis vous déclenchez une mise à jour de l’hôte de session :

La mise à jour de l’hôte de session vous permet de mettre à jour le type de disque de machine virtuelle sous-jacente, l’image du système d’exploitation et d’autres propriétés de configuration de tous les hôtes de session dans un pool d’hôtes avec une configuration d’hôte de session. La mise à jour de l’hôte de session libère ou supprime les machines virtuelles existantes et en crée de nouvelles qui sont ajoutées à votre pool d’hôtes avec la configuration mise à jour.

Source : Mise à jour de l’hôte de session, Microsoft Learn

Concrètement, la mise à jour ne bricole pas vos VM en place, elle les remplace. Le service cible d’abord un seul hôte, dit initial, pour valider que le processus fonctionne de bout en bout, puis il traite le reste par lots dont vous fixez la taille :

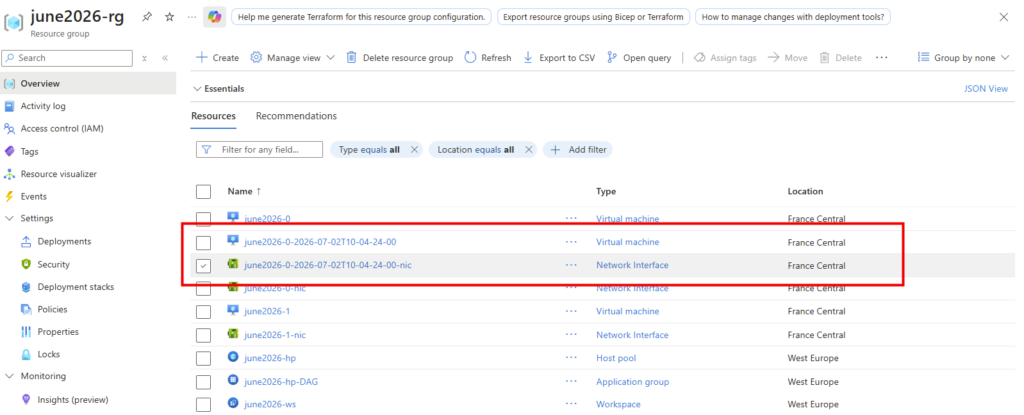
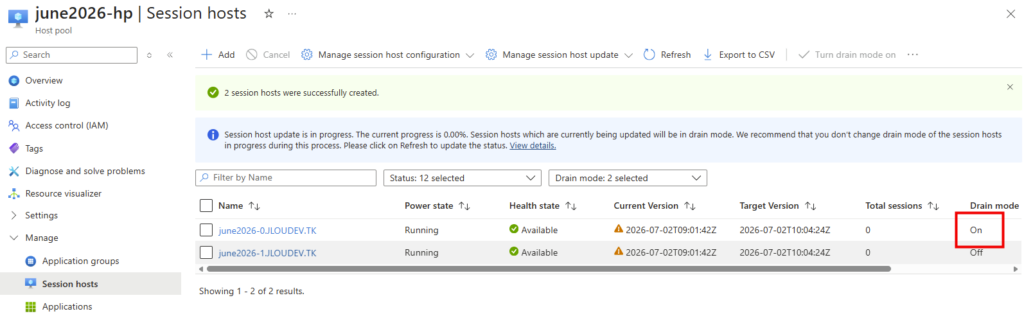
Chaque hôte concerné passe en mode drain, vos utilisateurs connectés reçoivent une notification et un délai avant déconnexion, l’ancienne VM est retirée du pool, une nouvelle est créée depuis la configuration à jour, jointe au domaine puis remise en service :

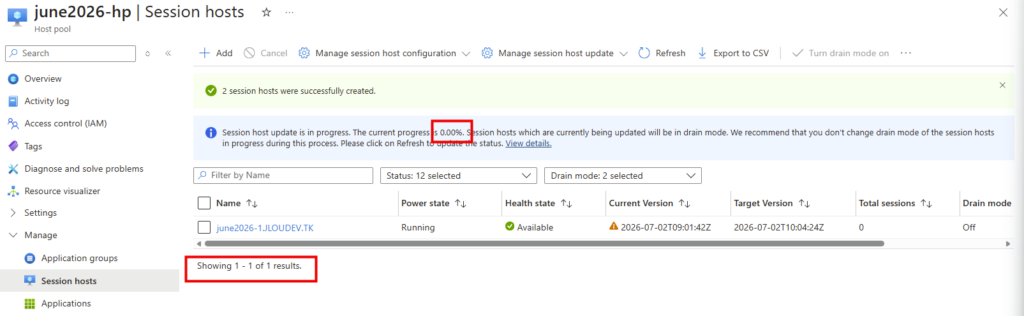
L’ancienne VM est enfin supprimée. La progression n’avance que lorsqu’un hôte est réellement terminé, ce qui explique qu’elle reste à 0 % pendant le traitement du tout premier.

Bon à savoir : l’état d’alimentation existant est respecté, vous pouvez donc lancer une mise à jour sur un pool dont tous les hôtes sont OFF pour limiter les coûts. Le pas-à-pas complet, du domaine managé jusqu’au déclenchement de la mise à jour, reste disponible dans mon tuto dédié : Orchestrez votre AVD.

3. La mise à l’échelle dynamique : créer et supprimer, pas seulement allumer et éteindre

Le plan de mise à l’échelle existait déjà pour optimiser les coûts d’un pool.

Ce qui arrive en GA, c’est sa méthode dynamique. La différence tient en une phrase :

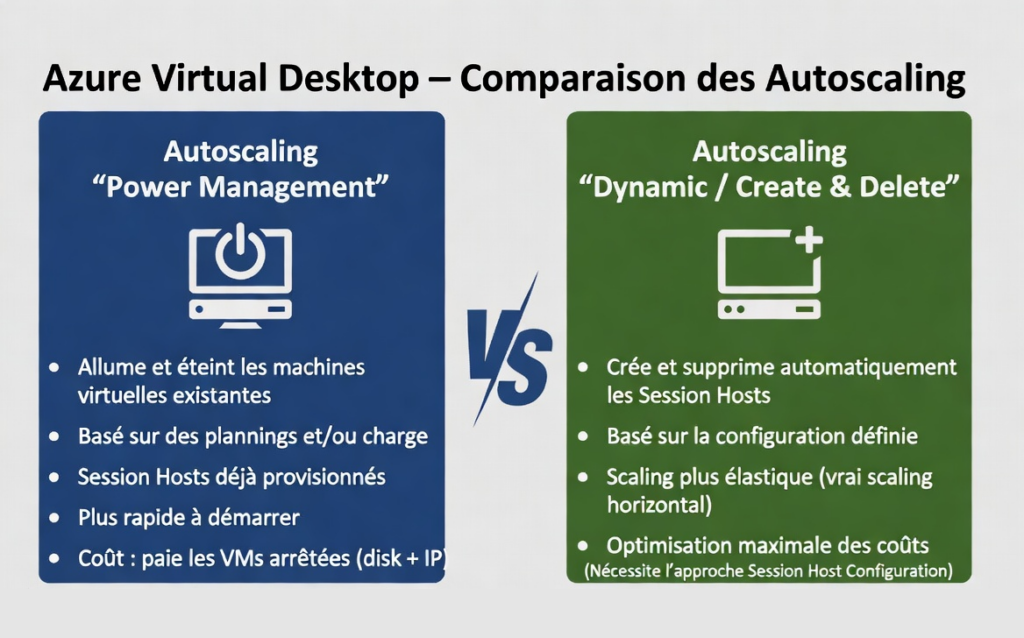
  • En gestion de l’énergie, le plan se contente d’allumer et d’éteindre des VM existantes :
  • En mode dynamique, il crée et supprime réellement les machines virtuelles selon l’usage et la planification, en s’appuyant sur la mise à jour de l’hôte de session pour les recréer dans leur dernière version :

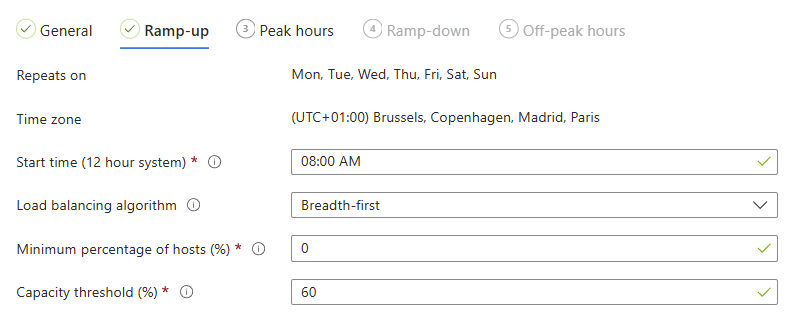
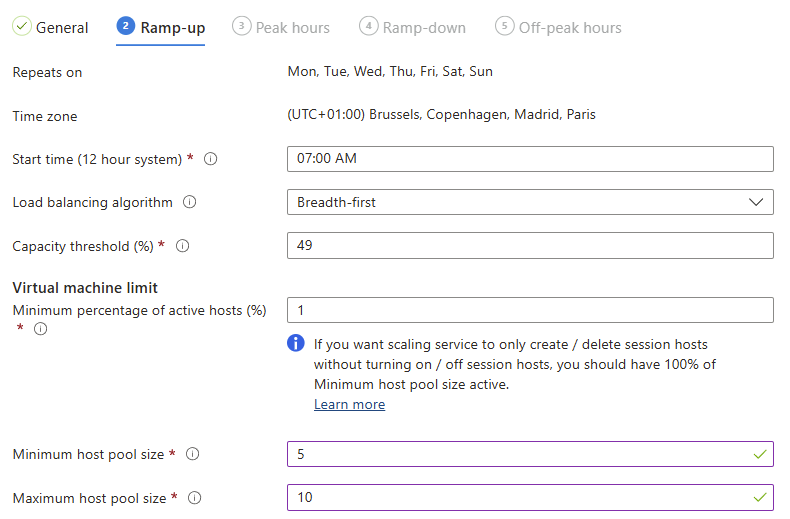
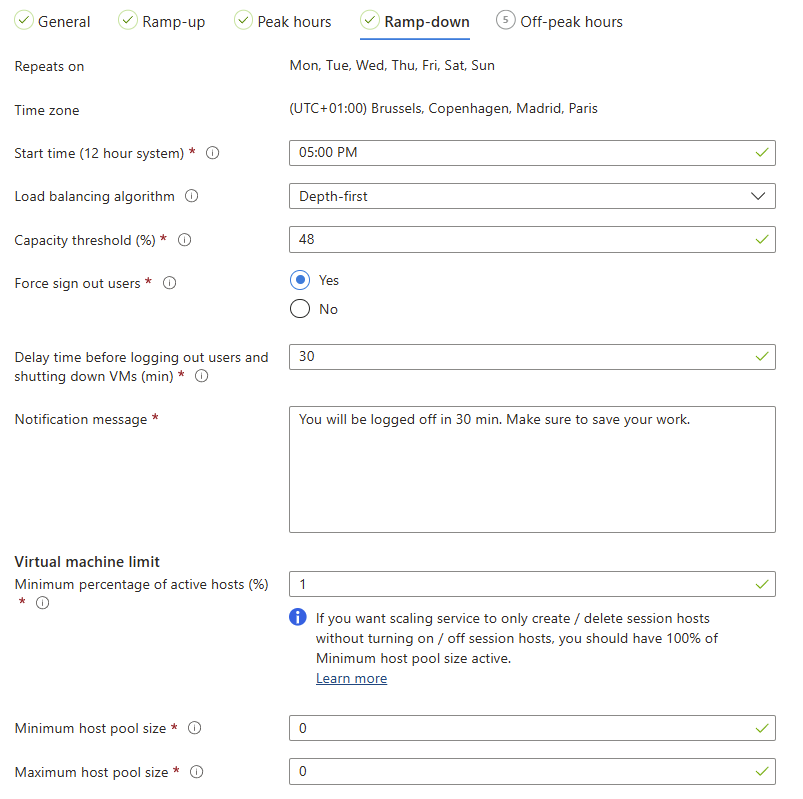
Les phases du plan, elles, ne changent pas : montée en charge, période de pointe, descente en charge et hors-période.

Vous y réglez les seuils de capacité, l’algorithme d’équilibrage, le nombre minimum et maximum de VM, et la déconnexion forcée éventuelle en descente de charge. L’intérêt du dynamique : quand la charge tombe, vous ne payez plus des VM éteintes qui traînent, elles disparaissent, puis se recréent à la demande :

Les mécanismes de fond, eux, restent les mêmes d’une méthode à l’autre.

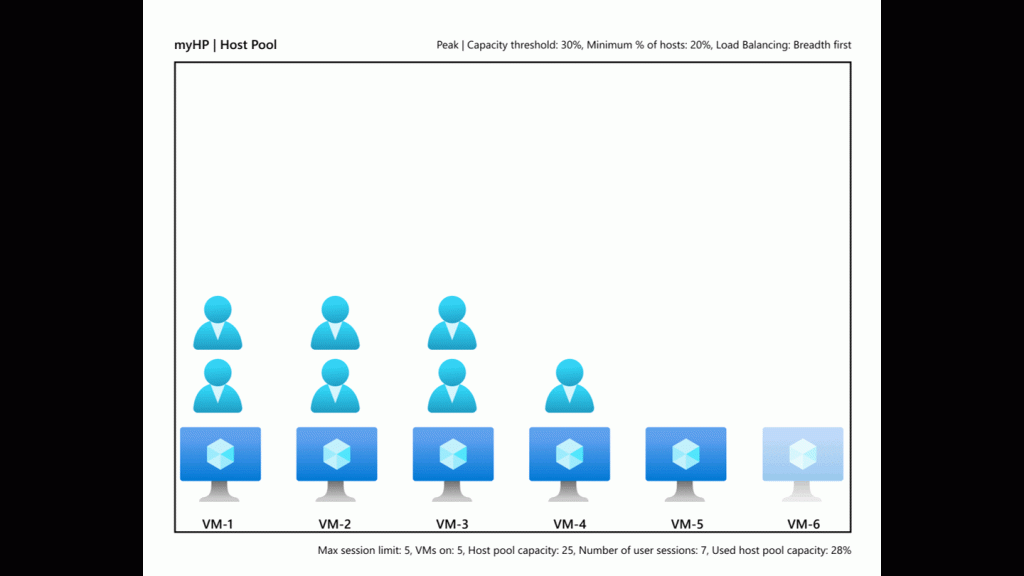
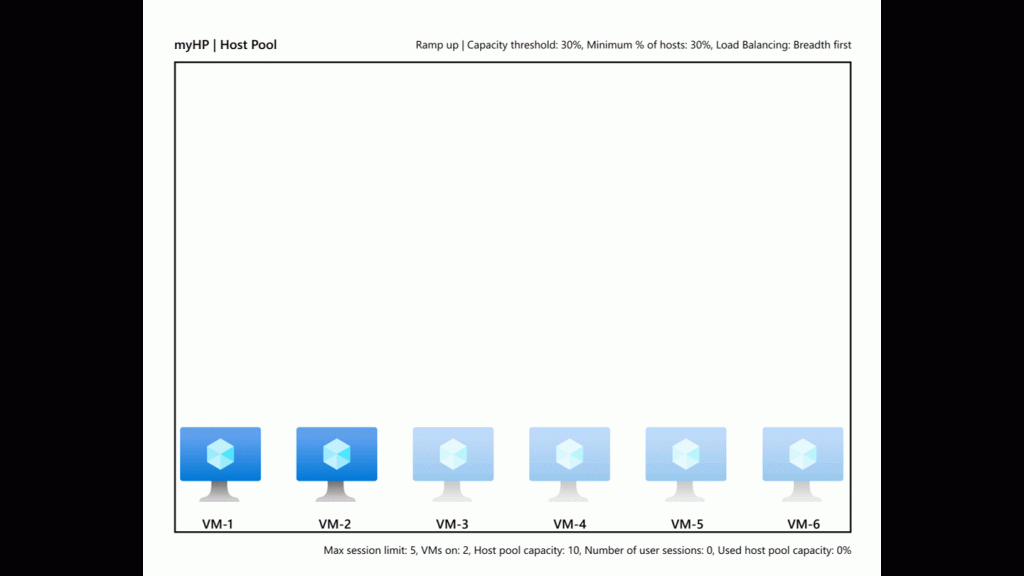
La mise à l’échelle démarre/crée progressivement des machines virtuelles quand une certaine limite d’utilisateurs est atteinte :

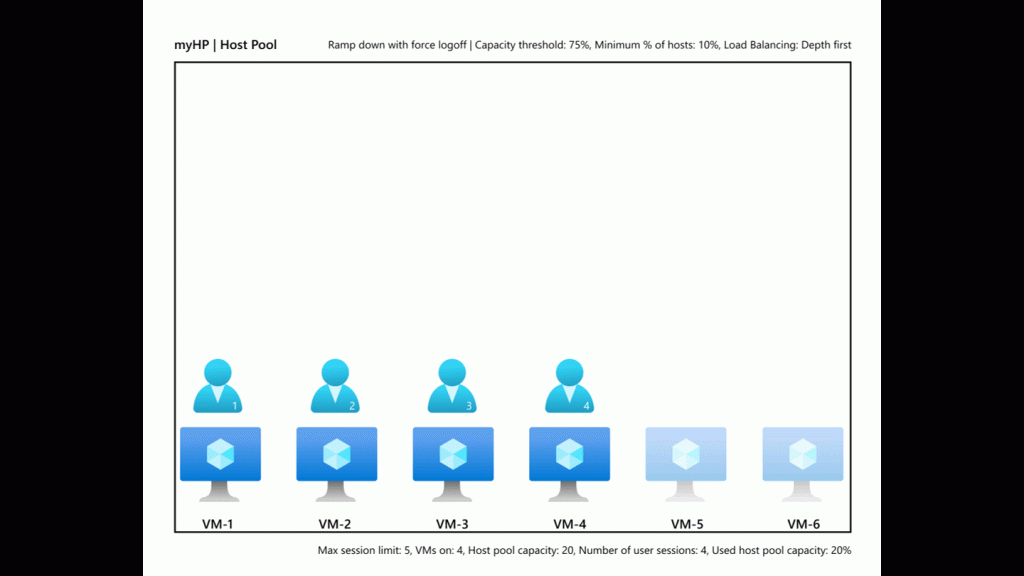
Elle éteint/supprime les machines virtuelles tant qu’elles ne sont pas exploitées :

Elle peut forcer la déconnexion des utilisateurs, uniquement si vous l’avez activé en descente de charge :

Quelques garde-fous à garder en tête : la méthode dynamique vise les pools mutualisés (pas les environnements personnels), s’appuie sur un pool déjà configuré avec la mise à jour de l’hôte de session, et connaît des restrictions selon le type de jonction et l’hébergement.

Le déroulé complet, avec les tests de création et de suppression de VM en direct, est dans mon tuto : AVD et la mise à l’échelle dynamique.

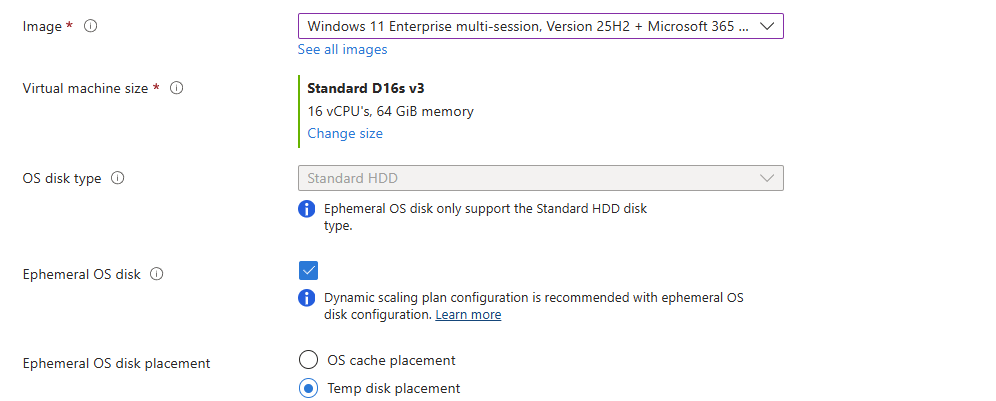
4. Les disques OS éphémères, enfin natifs

Troisième brique, les disques OS éphémères.

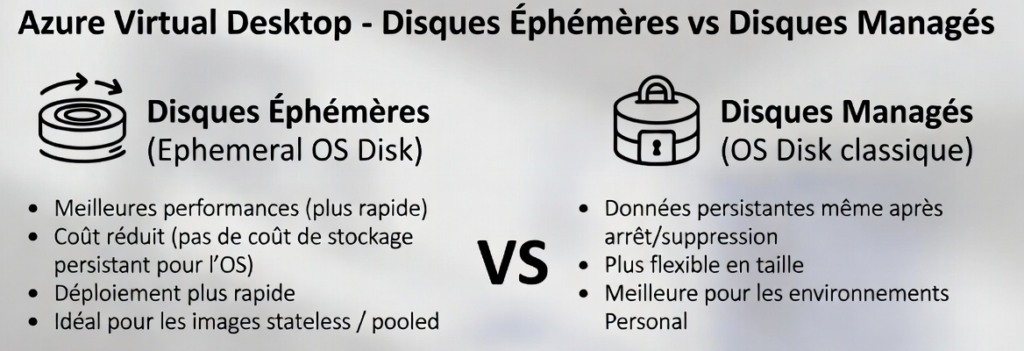
Le principe : le disque système vit sur le stockage local de l’hôte, pas sur du stockage distant managé :

Résultat, des lectures et écritures à plus faible latence, un provisionnement et une réinitialisation plus rapides :

Et un coût inclus dans celui de la taille de VM :

La contrepartie est assumée, ces disques ne conservent rien au-delà du cycle de vie de la machine :

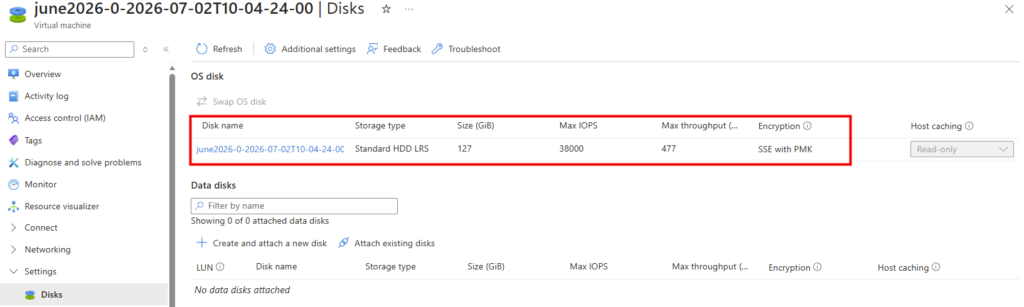
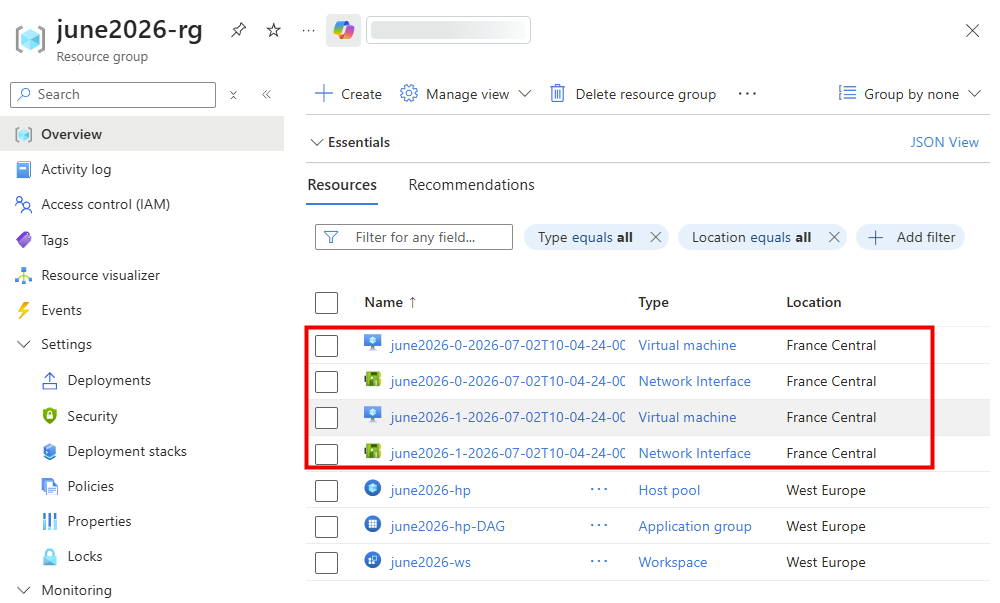
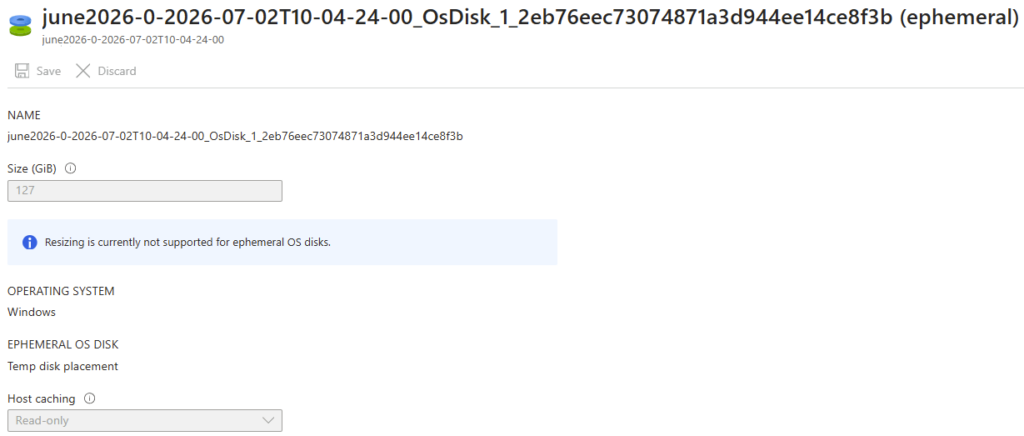
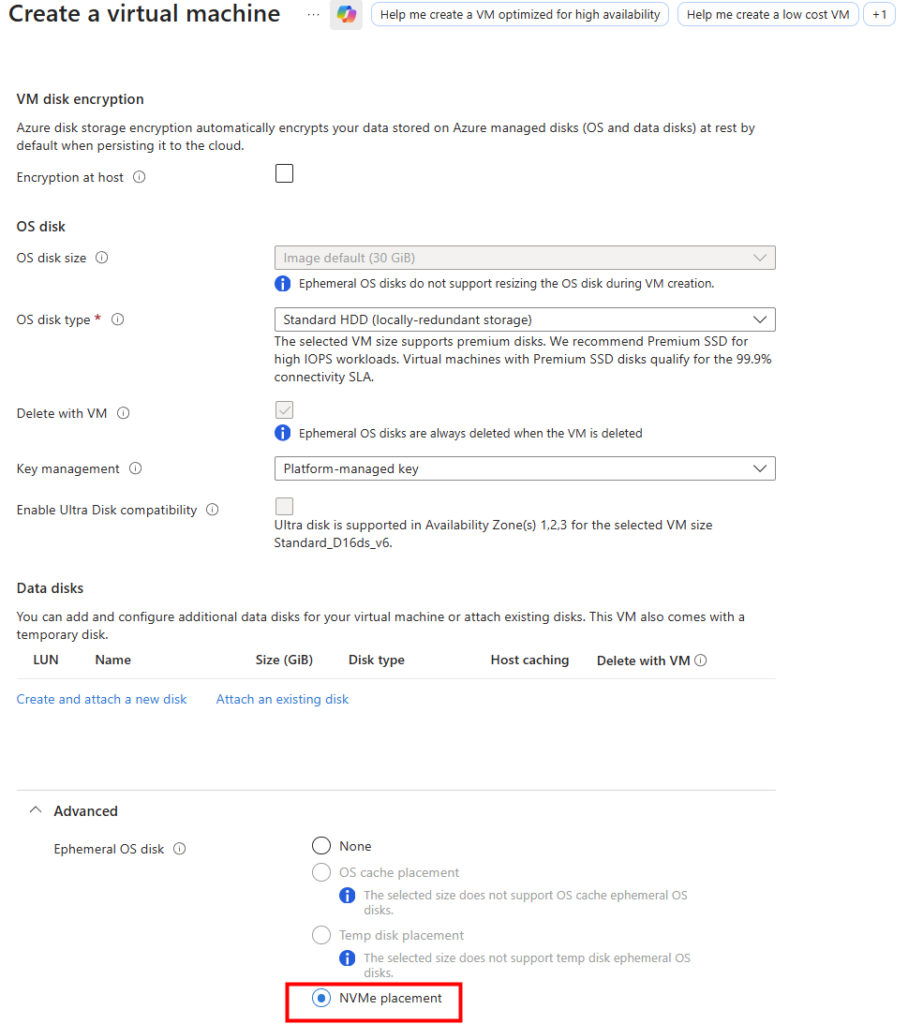
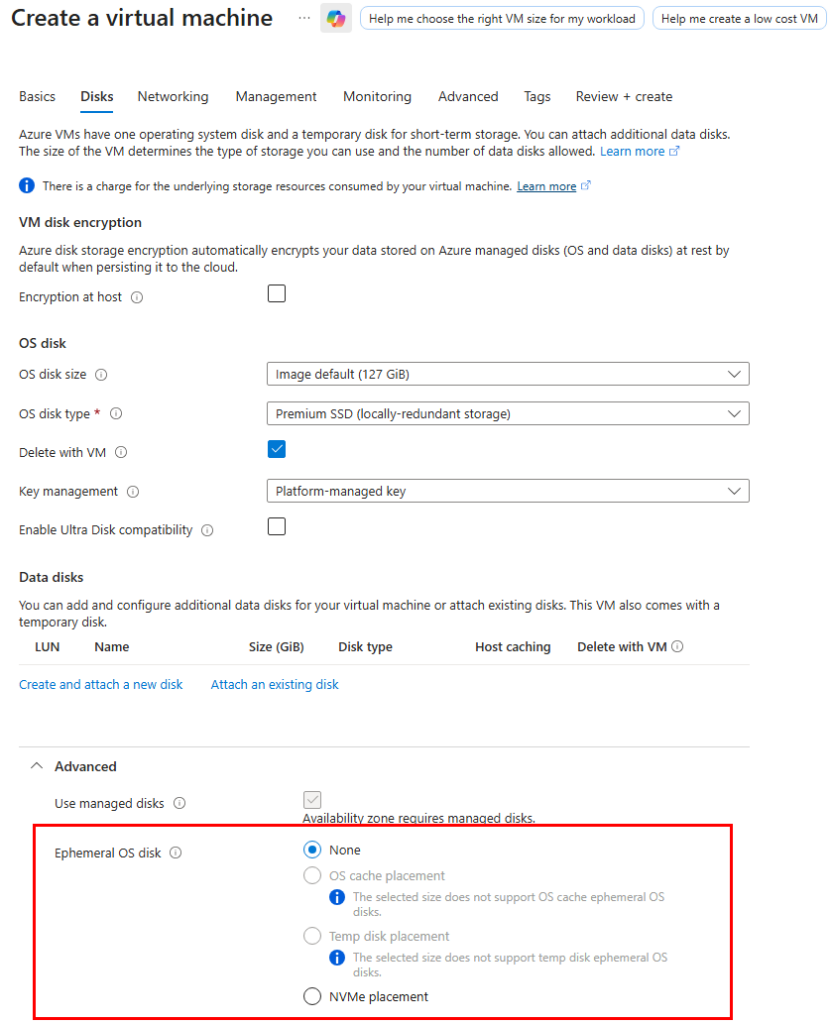
Le changement de la GA est là. En préversion, l’interface de création d’AVD ne permettait pas de choisir un disque éphémère, ce qui obligeait à un contournement, créer les VM à la main puis les rattacher au pool :

Microsoft annonce désormais les disques éphémères disponibles et optimisés pour Azure Virtual Desktop, et la configuration d’hôte de session inclut les informations du disque OS. La prise en charge devient donc officielle et intégrée, au lieu d’un montage manuel.

Pour bien saisir les différents disques éphémères sur Azure, l’excellente vidéo de John Savill reste la meilleure entrée en matière :

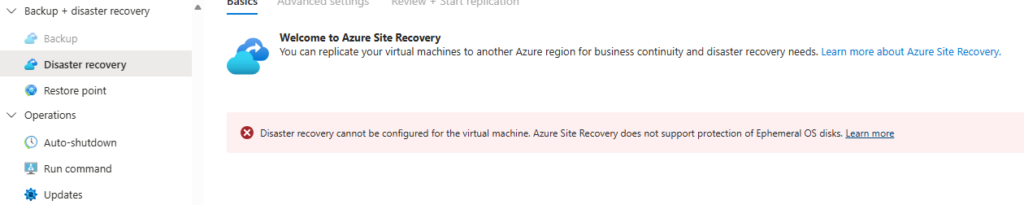
Les contraintes restent les mêmes, et il faut les connaître : pas de sauvegarde de la VM, pas de désallocation, et un redimensionnement qui fait perdre toute la donnée. Pour un pool AVD bâti sur une golden image et qui ne stocke pas de données utilisateur, ce ne sont pas des bloqueurs, plutôt des propriétés à assumer.

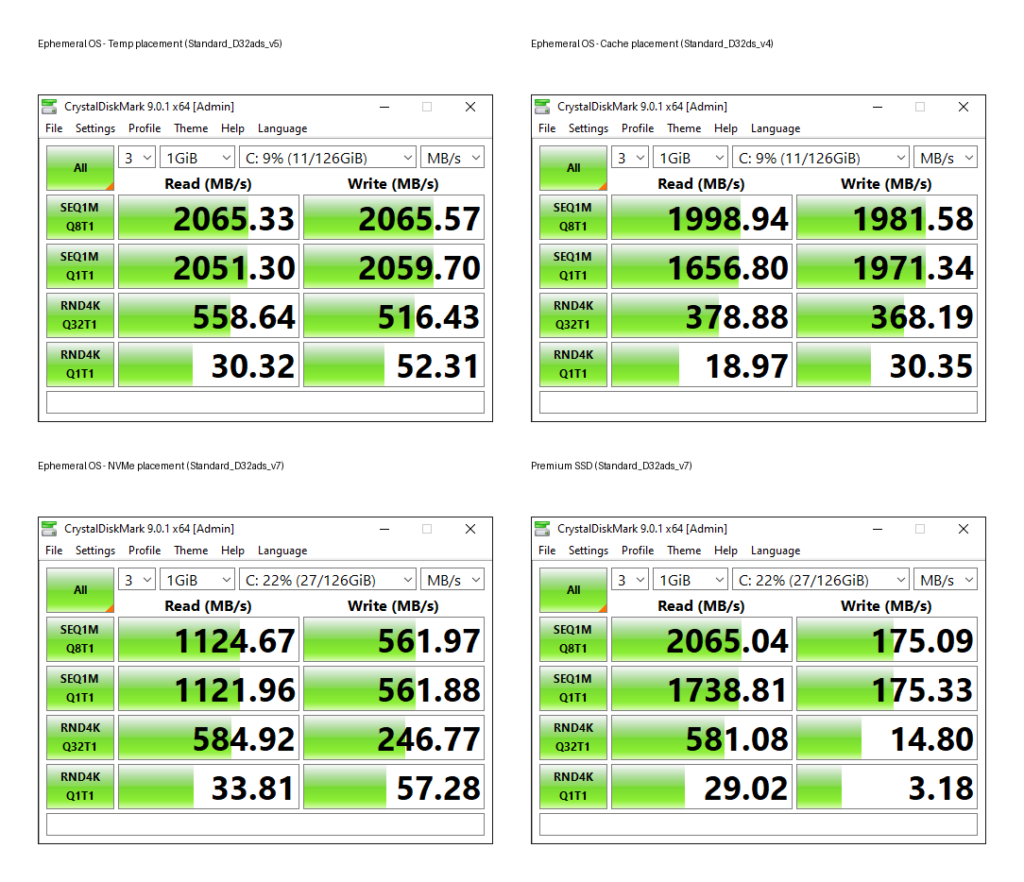
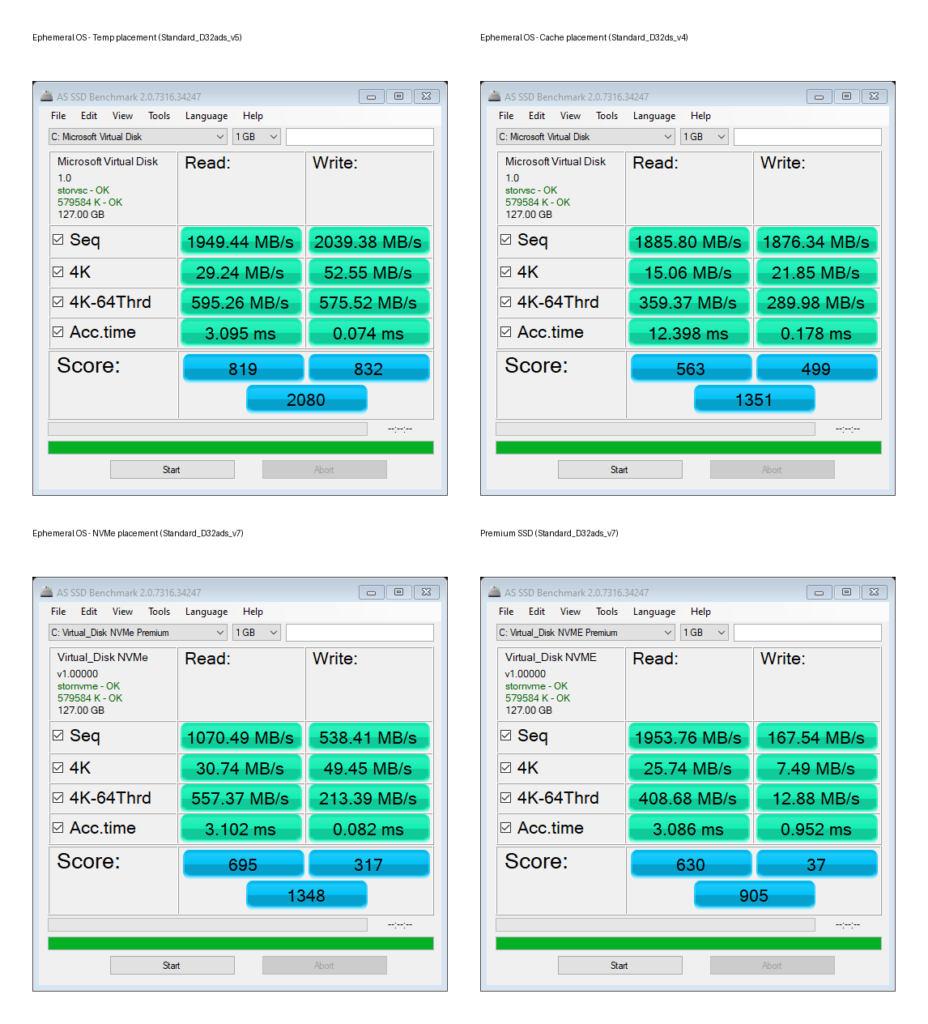
Mon comparatif de performances entre disque Premium SSD, cache et temporaire, tests DiskSpd à l’appui, est ici : Associez un disque éphémère à votre AVD. La référence Microsoft sur le sujet reste la page des disques OS éphémères.

5. Le vrai piège : l’identité managée devient incontournable

Si vous relisez mes anciens tutos, vous verrez que je faisais reposer les droits sur l’application de service Azure Virtual Desktop, avec des rôles RBAC assignés à la main sur le Key Vault et un rôle personnalisé pour la lecture de la configuration. Cette mécanique n’est plus la bonne. Microsoft a basculé vers l’identité managée, et ce n’est pas une simple recommandation :

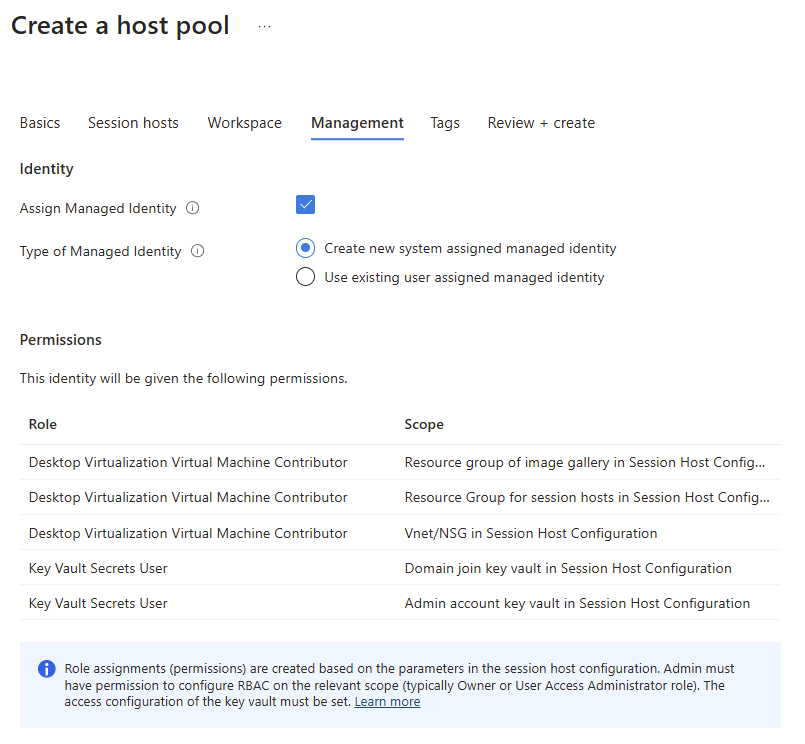
Attention : l’identité managée est devenue nécessaire pour les pools qui utilisent une configuration d’hôte de session. Le calendrier annoncé par Microsoft est sans ambiguïté : depuis le 19 septembre 2025, un nouveau pool de ce type doit être créé avec une identité managée ; depuis le 15 octobre 2025, un pool existant ne peut plus mettre à jour sa configuration sans en ajouter une ; et depuis le 15 novembre 2025, il ne peut plus créer d’hôtes sans elle. Si vous suivez encore la méthode service principal de mes anciens articles, vous allez vous heurter à un mur.

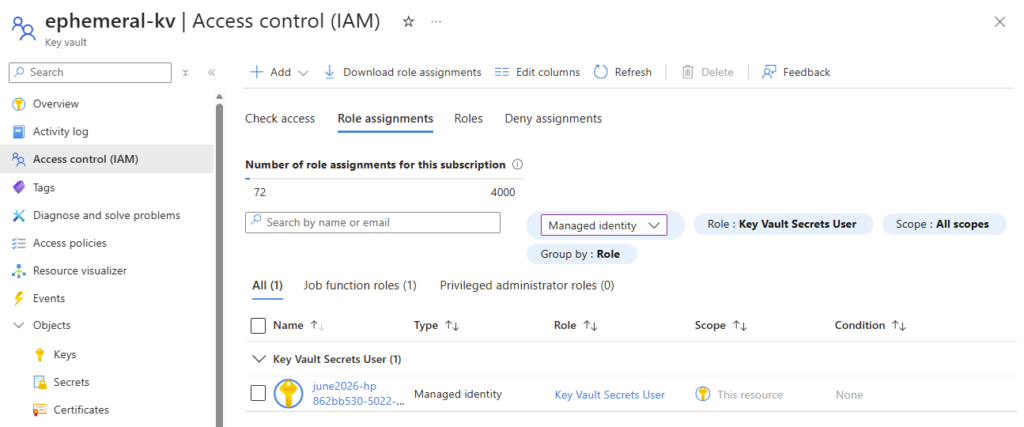
La bonne nouvelle, c’est que l’identité managée simplifie le tableau. Elle supprime le besoin d’assigner des permissions à l’application de service Azure Virtual Desktop, attribue automatiquement les droits en fonction des paramètres de la configuration d’hôte de session, et apporte un contrôle plus fin par pool :

Elle débloque aussi deux cas concrets : l’accès à un Key Vault dont l’accès public est désactivé, réservé aux services Microsoft de confiance, et l’usage d’une image hébergée dans un autre abonnement du même tenant. La marche à suivre est décrite sur la page de configuration de l’identité managée.

Concrètement, ça donne quoi ?

Voilà, en une synthèse, trois briques de préversion réunies et remises à niveau pour la disponibilité générale : la configuration d’hôte de session pour standardiser et mettre à jour votre parc, la mise à l’échelle dynamique pour créer et supprimer les VM au fil de la charge, et les disques éphémères désormais intégrés proprement.

Les pièges à retenir :

  1. L’identité managée n’est plus optionnelle, oubliez la méthode service principal de mes anciens tutos.
  2. L’approche de gestion se choisit à la création du pool et ne se change plus après.
  3. Les disques éphémères ne persistent rien, parfait pour une golden image, à proscrire pour de la donnée utilisateur.
  4. Certaines pages de doc portent encore le label préversion, vérifiez l’état réel dans votre tenant avant la prod.

Pour le détail pas-à-pas de chaque brique, mes trois tutos d’origine restent la référence : l’orchestration, la mise à l’échelle dynamique et les disques éphémères. Foncez tester tout ça en lab, maintenant que la production est autorisée. Pour suivre les évolutions, gardez un oeil sur le What’s new d’Azure Virtual Desktop.

Nerdio simplifie FSLogix

Vous avez déployé Nerdio Manager for Enterprise (peut-être en suivant mon article précédent), vous avez coché en passant « FSLogix Profiles Storage Configuration » dans le wizard, mais vous n’avez jamais vraiment creusé ce que Nerdio fabrique derrière ? Cette suite logique est pour vous. On va dérouler, étape par étape, ce que Nerdio fait à votre place sur FSLogix et surtout ce que vous auriez à faire à la main sans lui. Parce que FSLogix, c’est probablement la brique d’AVD qui génère le plus de tickets support, et ça vaut la peine de comprendre pourquoi Nerdio fait baisser ce volume.

Pour vous guider plus facilement dans cet article, voici des liens rapides :

1. Pourquoi FSLogix à la main, c’est pénible

Avant d’entrer dans Nerdio, faisons l’inventaire de ce qu’il faut faire pour avoir un FSLogix qui tourne proprement sur un host pool AVD Entra-only. La liste, que vous pouvez retrouver dans cet article, se décompose dans cet ordre :

  1. Provisionner un storage account
  2. Activer l’authentification Entra Kerberos
  3. Grant admin consent
  4. Exclure cette app des policies Conditional Access MFA
  5. Créer le file share
  6. Distribuer les rôles RBAC
  7. Régler les ACL NTFS
  8. Pousser les clés registry FSLogix
  9. Maintenir tout ça dans le temps
Mon retour terrain : à la main, comptez une bonne demi-journée pour un déploiement propre, plus le temps de débuggage des permissions NTFS qui vient quasi systématiquement. L’étape 7 (ACL NTFS) est celle qui génère le plus de tickets support sur tout AVD. Une fausse manip d’héritage et vous y passez la journée d’anniversaire de votre fils.

Maintenant, voyons ce que Nerdio peut faire pour vous.

2. Le wizard Create Azure Files Share

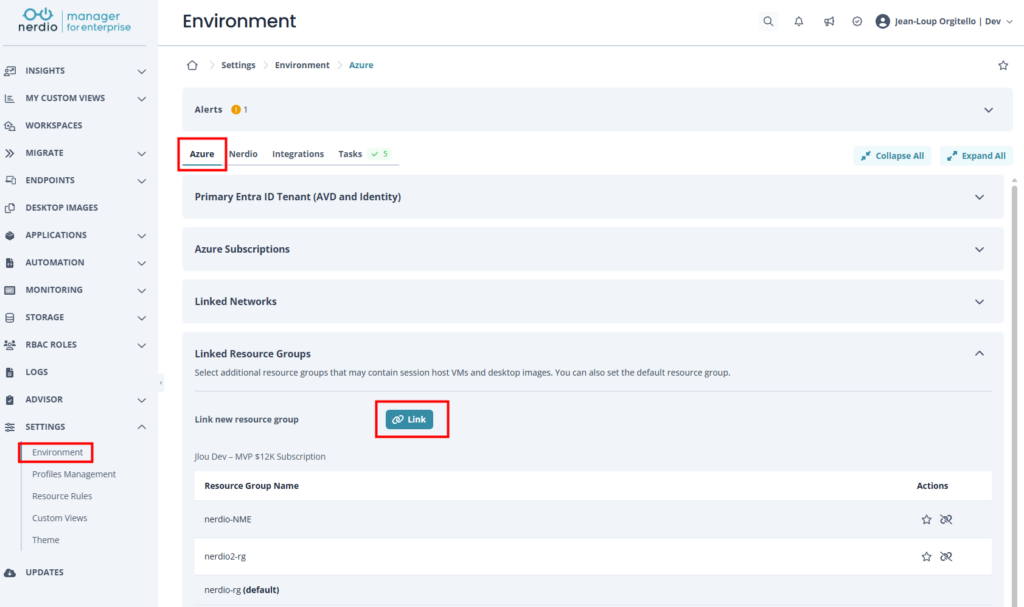
Avant toute chose, je vous conseille de créer le groupe de ressources sur le portail Azure, puis de lier ce dernier dans votre console Nerdio :

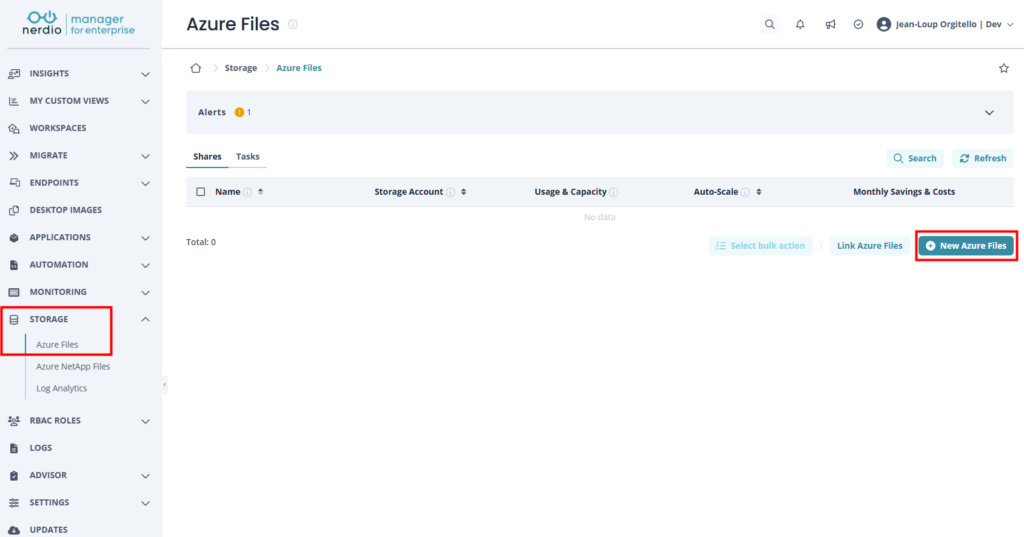
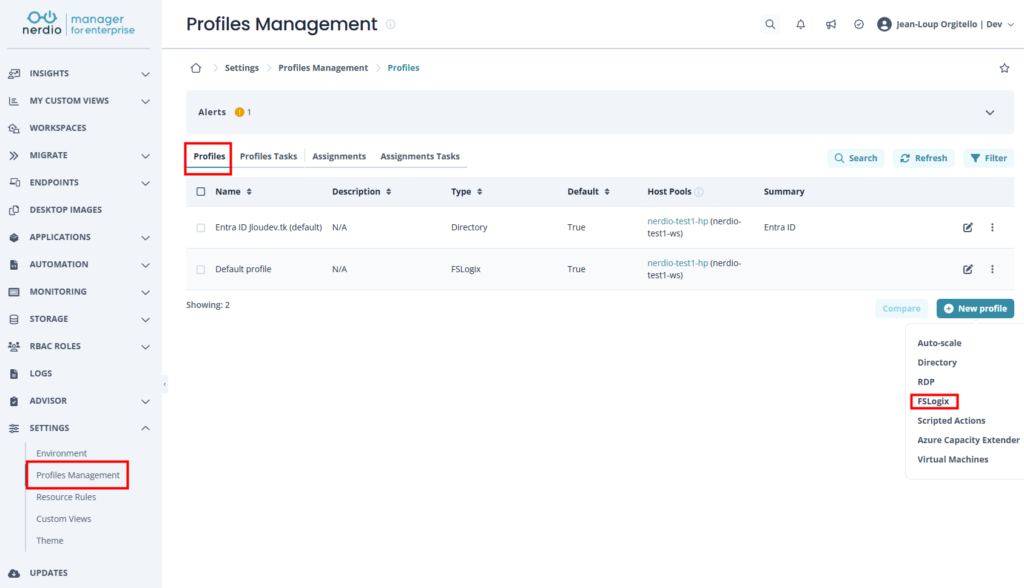
Dans Nerdio, direction Settings → FSLogix Profiles → Add Azure Files Share. Vous avez le choix entre pointer un storage account existant ou laisser Nerdio créer le share complet, du SA jusqu’aux ACL NTFS. Et oui, ça inclut le scénario Entra ID joined, c’est ce qu’on va dérouler ensemble :

Le wizard se passe en seulement 5 étapes :

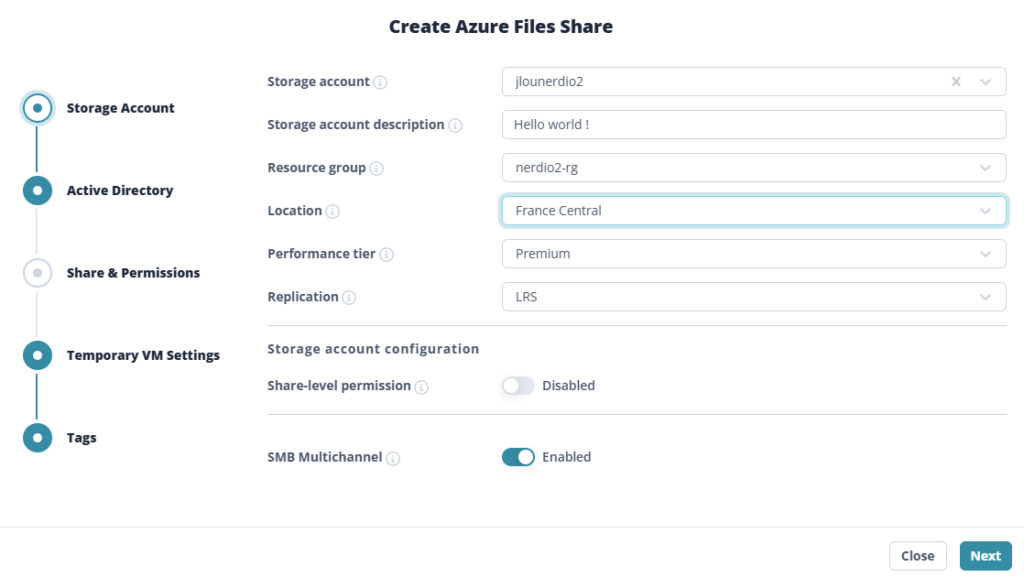
Étape 1 : Storage Account

Nom du SA, resource group, région, SKU (Standard ou Premium Files), réplication. Rien d’extraordinaire, mais tout se passe dans une seule fenêtre Nerdio plutôt que de naviguer dans quatre blades Azure différentes.

Étape 2 : Active Directory ou Entra ID

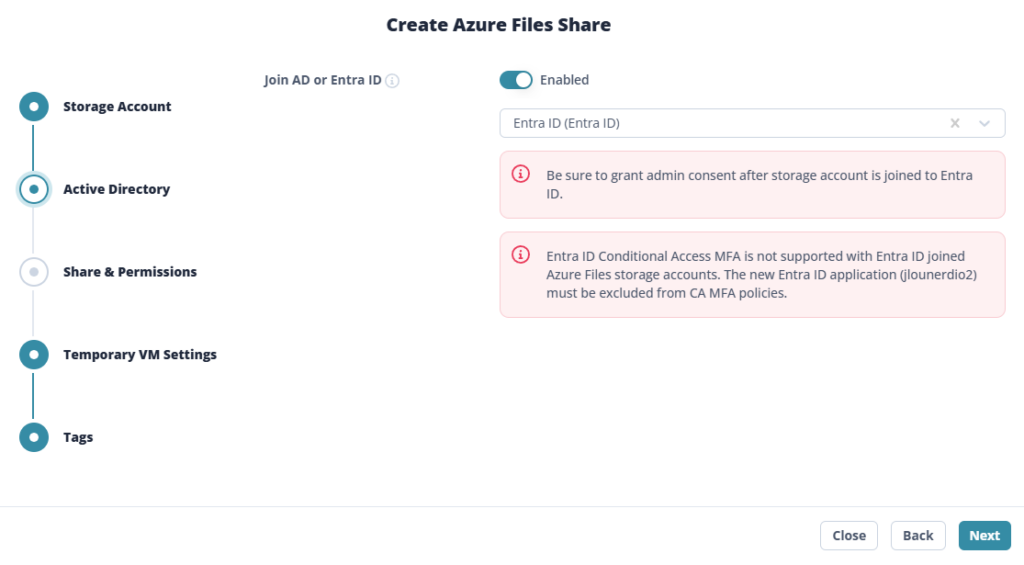
L’étape clé. Vous activez le toggle Join AD or Entra ID, puis vous choisissez Entra ID dans la liste déroulante. Et là, Nerdio vous met deux warnings honnêtes que vous devez lire avant de cliquer Next :

Attention : Nerdio vous prévient sur deux points avant de valider :

⚠️ Be sure to grant admin consent after storage account is joined to Entra ID.
⚠️ Entra ID Conditional Access MFA is not supported with Entra ID joined Azure Files storage accounts. The new Entra ID application must be excluded from CA MFA policies.

Ce sont les deux seules manips qu’il vous restera à faire à la fin. Nerdio s’occupe du reste : création de l’app registration, configuration Entra Kerberos sur le storage, le tout en une seule passe.

Étape 3 : Share & Permissions

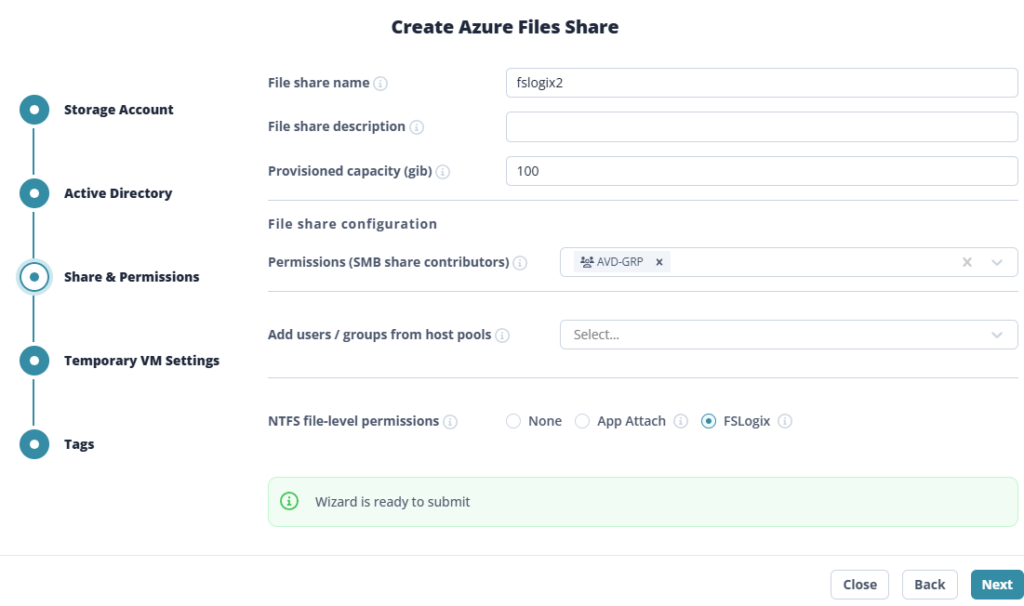
Vous donnez un nom au share, sa capacité (entre 100 GB et 100 TB), et vous attribuez les rôles RBAC SMB Share Contributor aux groupes Entra ID concernés. Mais surtout, et c’est là le gros gain, vous avez un dropdown NTFS Permission Preset avec une option FSLogix.

Ce preset, c’est exactement la combinaison Authenticated Users / CREATOR OWNER / Administrators de la section 1, avec les bons héritages.

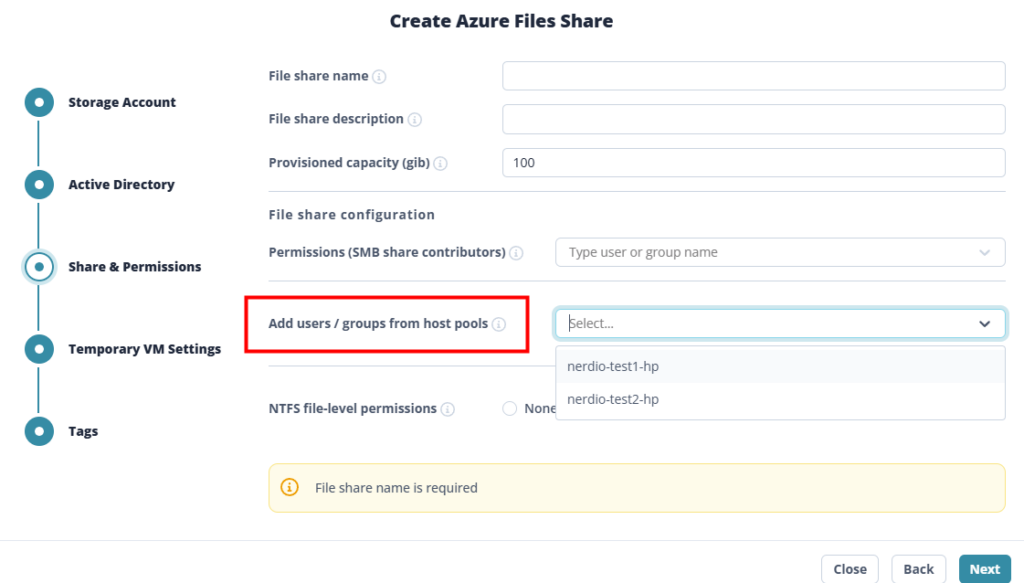
Bonus sécurité : la case Limit access to specific host pools vous permet de restreindre ce share à un ou plusieurs host pools précis. Pratique si vous avez plusieurs environnements (prod, dev, RH, finance…) et que vous voulez éviter qu’un host pool puisse écrire dans le profil d’un autre.

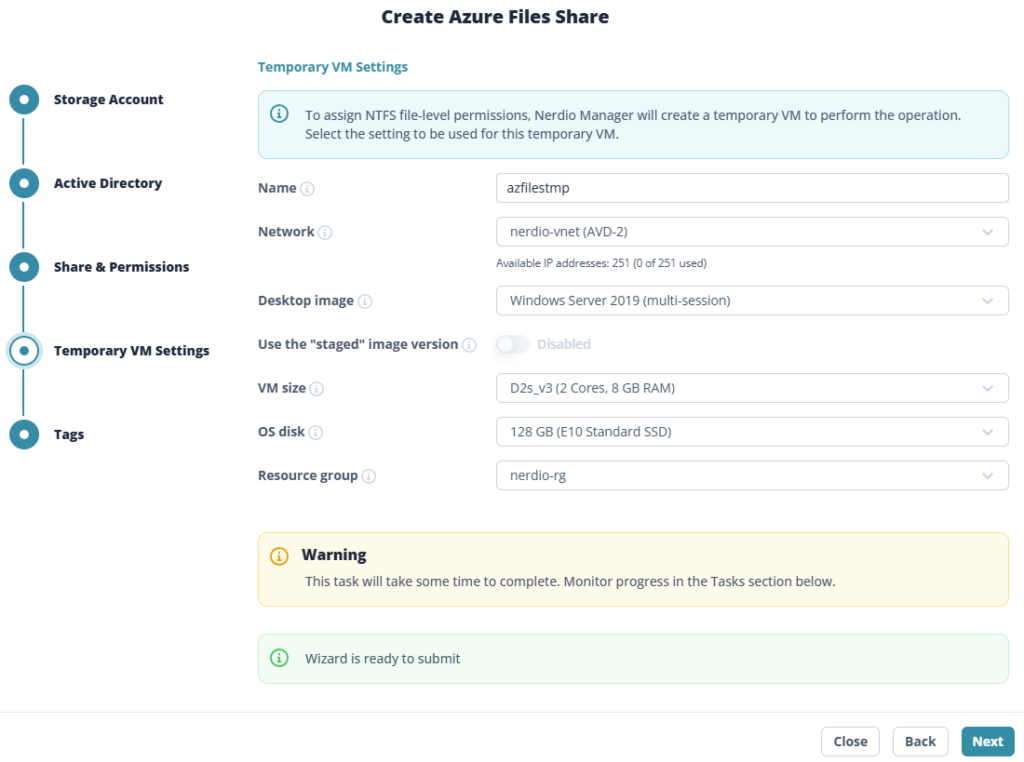
Étape 4 : Temporary VM Settings

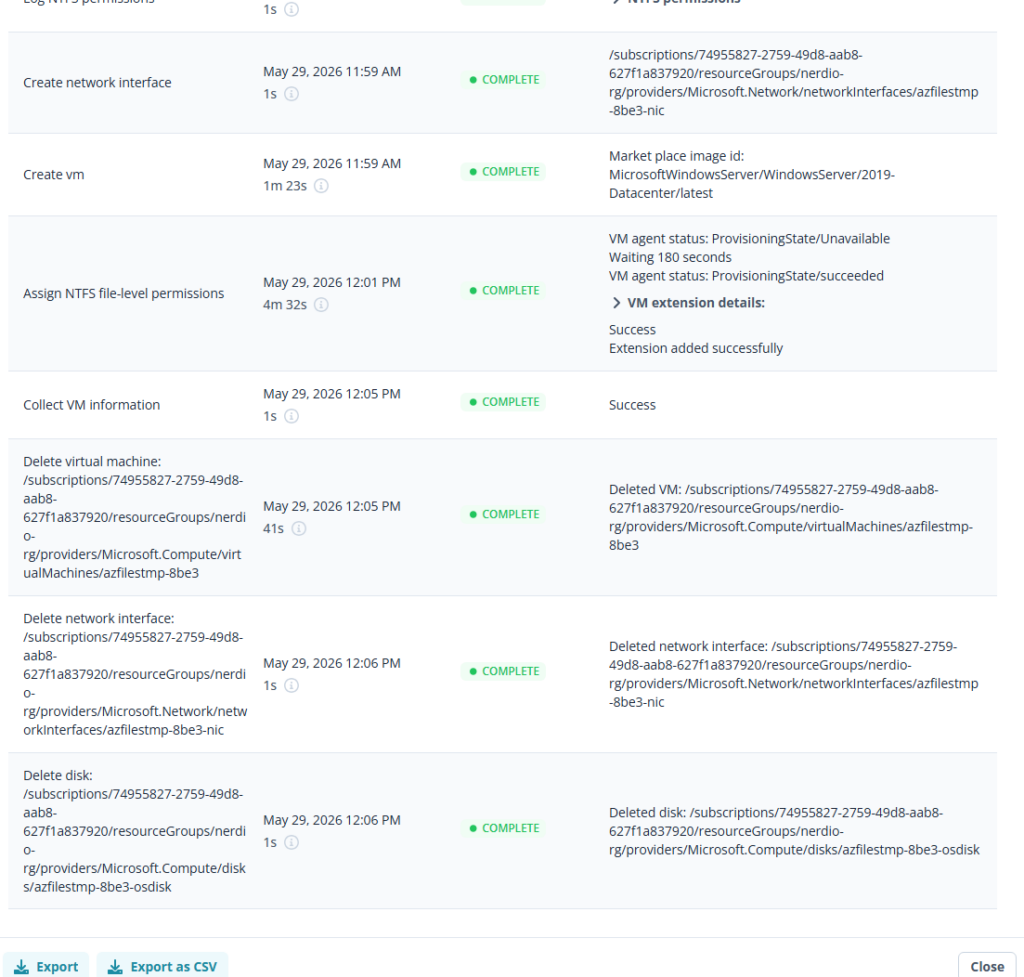
Pour appliquer les ACL NTFS et finaliser le join, Nerdio doit mount le share quelque part. Il monte donc une VM temporaire dans votre vNet le temps de la config, puis la supprime automatiquement.

Vous renseignez ici la taille de VM (le défaut B2s suffit), le subnet et éventuellement l’image. C’est cette VM qui va faire le icacls du preset FSLogix sur le share, donc gardez bien le subnet AVD ou un subnet qui peut joindre le storage.

Étape 5 : Tags

Classique. Submit.

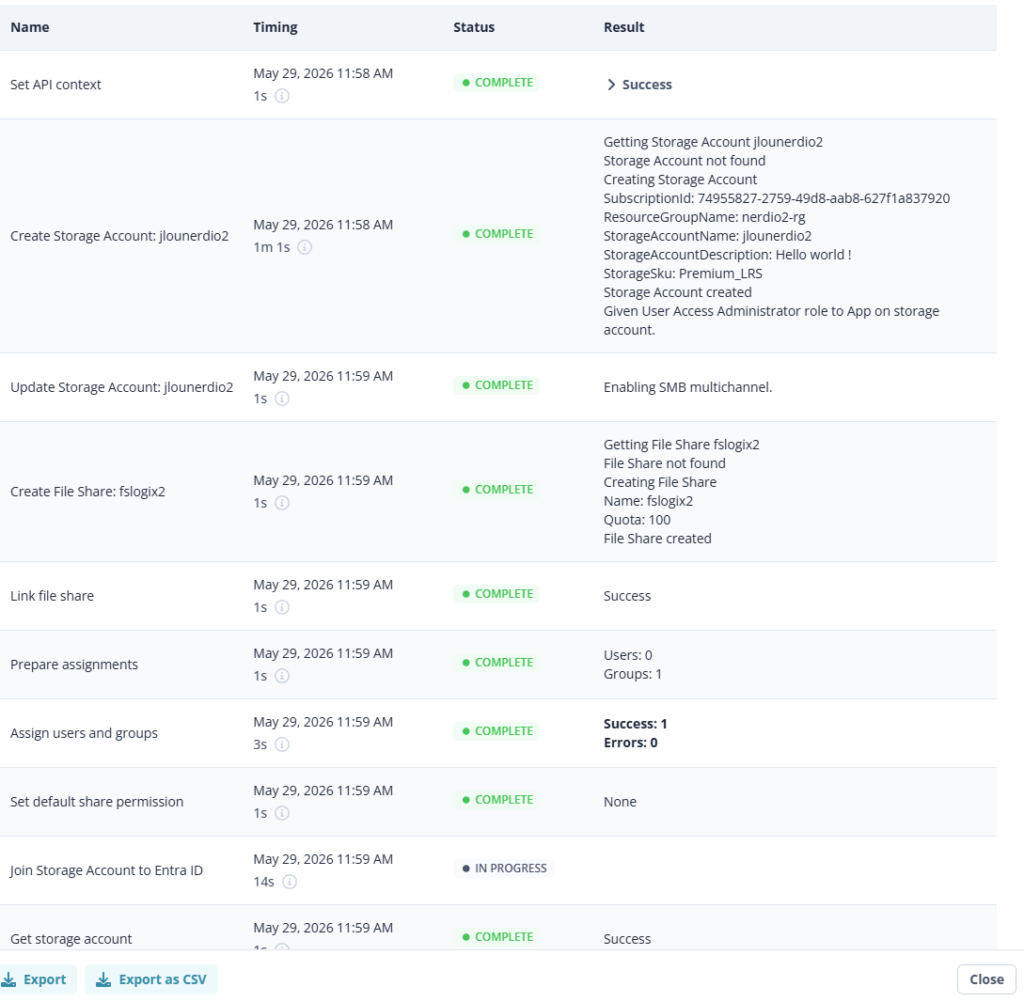
Le déploiement commence alors, et toutes les étapes sont indiquées dans le log :

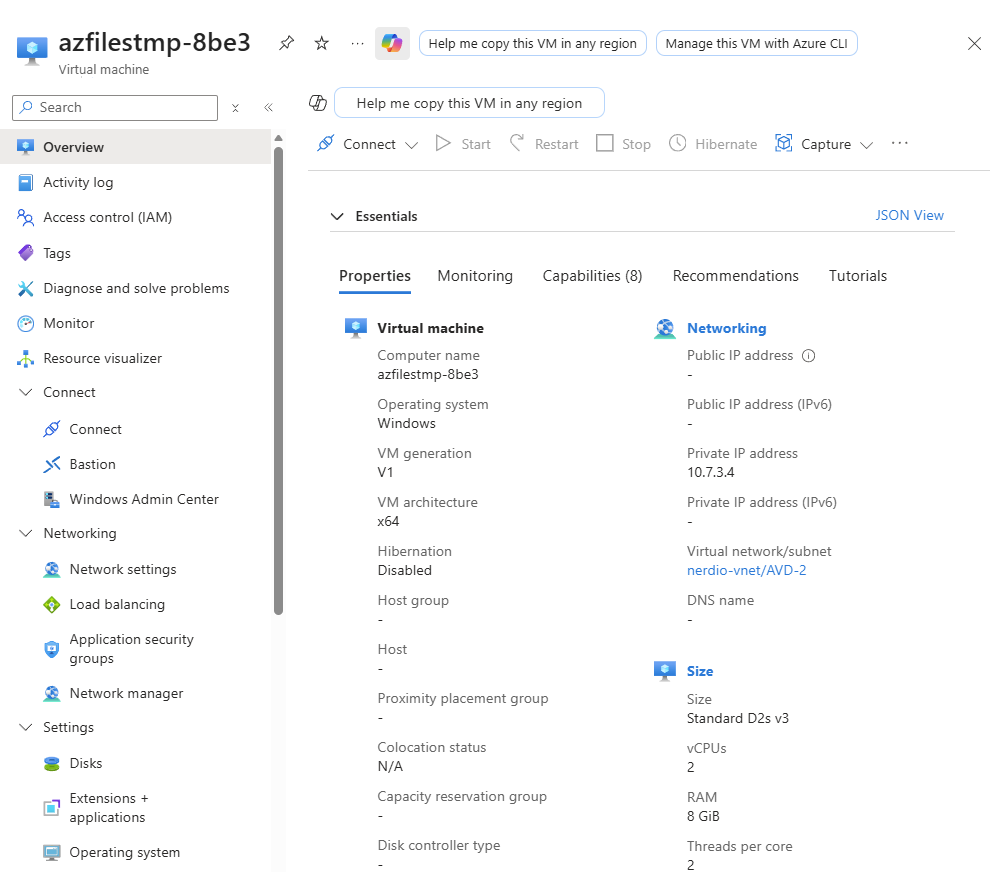
  • Sur le portail Azure, on retrouve la machine virtuelle temporaire créée pour l’occasion :
  • Une fois le traitement terminé, toutes les étapes sont bien détaillées dans le log :
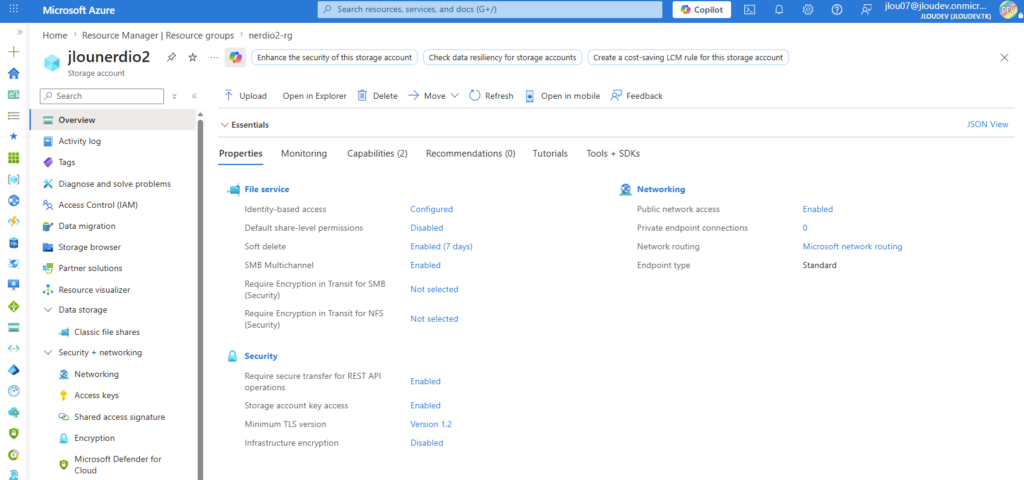
  • Le statut du compte de stockage est également visible dans le portail Azure :
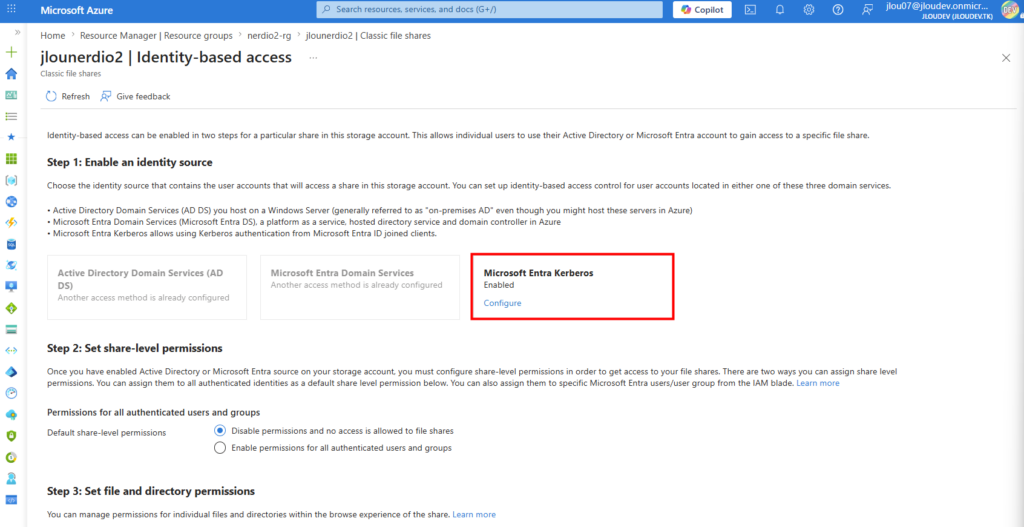
  • Et la configuration de la gestion identitaire Entra Kerberos est faite :
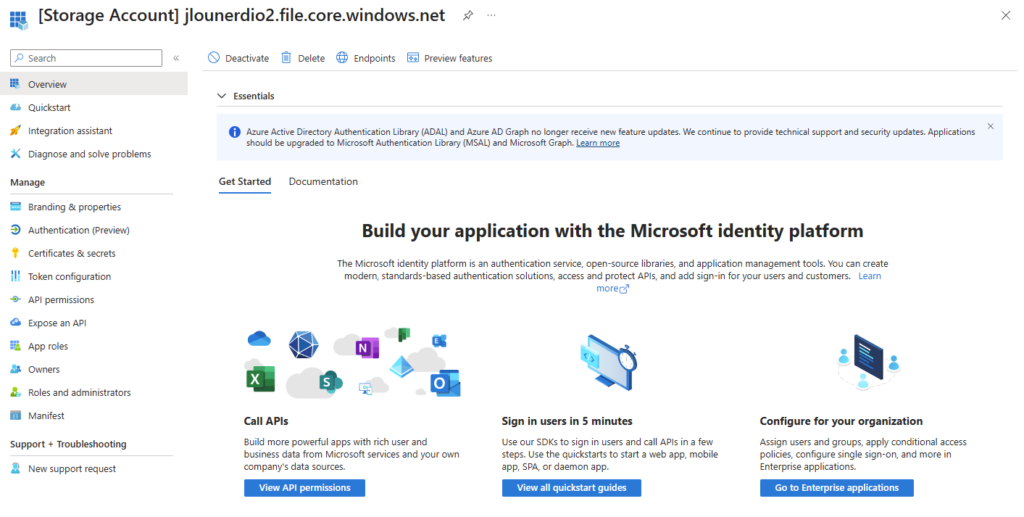
  • Dans Entra, l’app registration est bien créée :
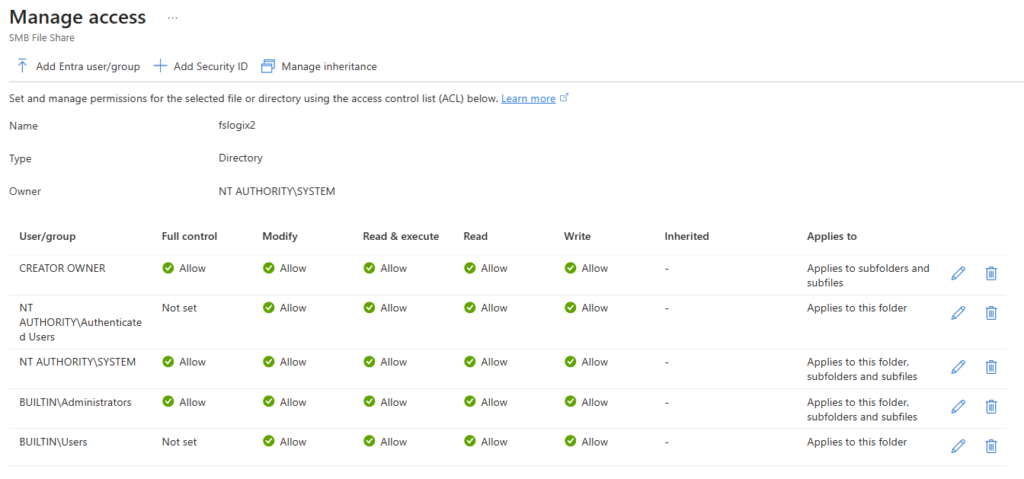
  • Les ACL de base sont bien appliquées (un durcissement des héritages NTFS reste possible si votre politique de sécurité l’exige) :
  • À l’issue de l’opération, la machine virtuelle temporaire se détruit automatiquement :

À la fin du traitement, trois actions restent à votre charge :

  • Allez dans Entra ID → Enterprise Applications, ouvrez la nouvelle app qui porte le nom de votre storage account, et cliquez sur Grant admin consent for [tenant].
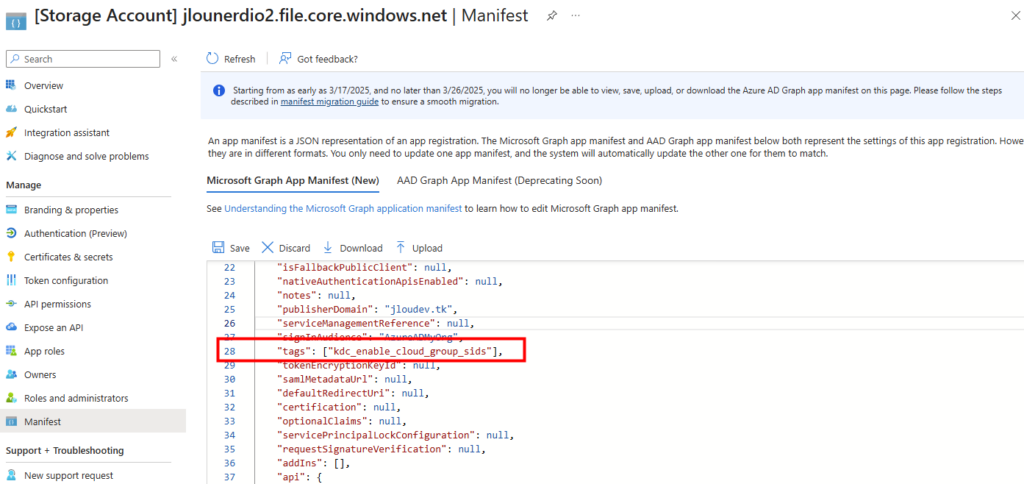
  • Ajoutez également la prise en charge des groupes dans le manifeste de l’app :
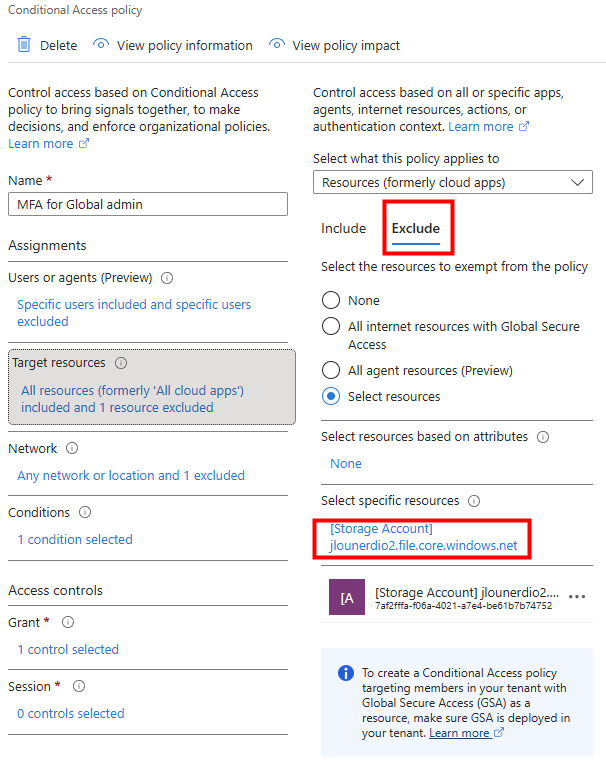
  • Si vous avez des Conditional Access policies MFA, ajoutez cette app dans la liste d’exclusion :

C’est tout. Comparez avec la liste de la section 1 : on est passé de 9 étapes à 3 manips de 30 secondes.

3. Les FSLogix Profiles : templates réutilisables

Voilà la deuxième brique qui change la vie : les FSLogix Profiles au sens Nerdio du terme, à ne pas confondre avec les profils utilisateurs FSLogix !

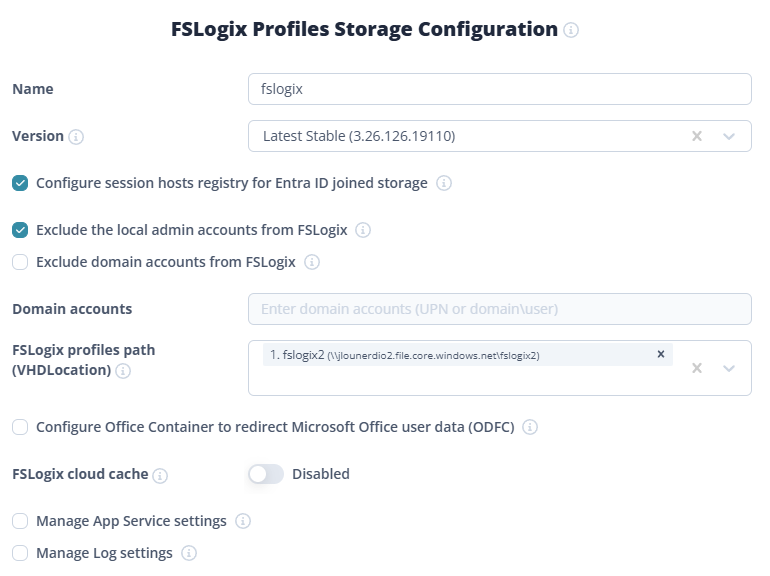
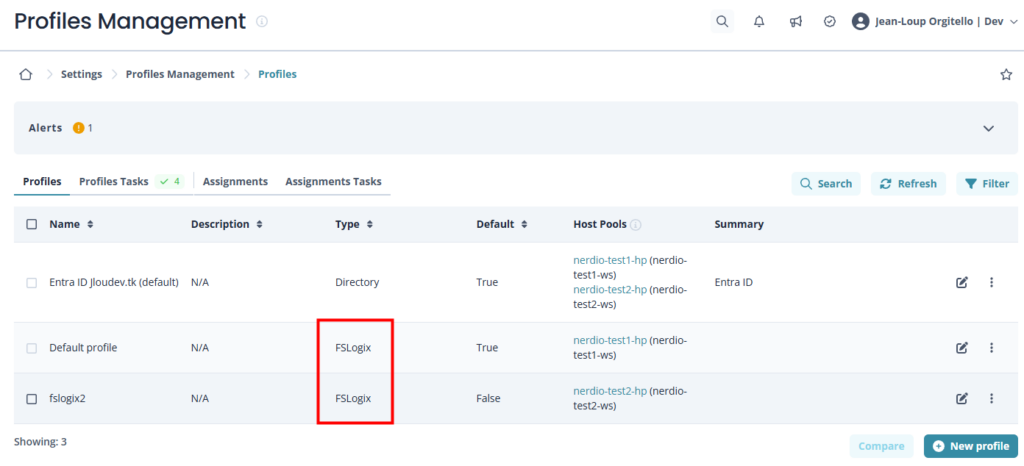
Dans Settings → FSLogix, vous créez un profil, c’est-à-dire un template de configuration FSLogix, que vous pourrez ensuite appliquer à n’importe quel host pool.

Concrètement :

  1. Nom du profil : par exemple « Standard AVD Users » ou « Power Users with bigger profiles ».
  2. Excluded users group : un groupe Entra ID dont les membres ne seront PAS soumis à FSLogix. Best practice : y mettre vos admins. Comme ça, si FSLogix casse, vos admins peuvent toujours se logger en profil local et venir réparer.
  3. Profile path : un dropdown qui vous propose tous les shares que vous avez créés à l’étape précédente. Vous n’avez plus à retaper le path UNC à la main.
  4. Office Container (ODFC) : checkbox pour activer le container Office séparé. Honnêtement, dans la grande majorité des cas AVD vous n’en avez pas besoin (j’y reviens en section 5).
  5. Cloud Cache : à laisser de côté sauf scénario multi-région avec DR actif-actif.

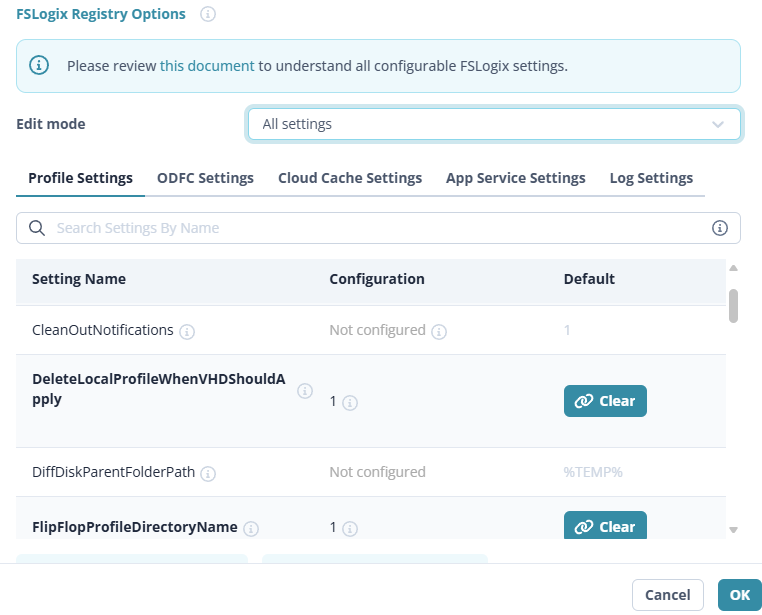
Toujours sur l’écran de configuration FSLogix, vous tombez sur la vraie matrice des réglages FSLogix. Et là, Nerdio fait deux choses qui valent la mention.

  • Les eye icons. Chaque setting a une petite icône œil que vous pouvez survoler pour avoir la description complète de la clé registry correspondante. Plus besoin d’aller chercher dans la doc Microsoft à chaque fois. C’est bête mais c’est ce qui transforme FSLogix d’un truc obscur en quelque chose de réellement administrable.
  • Les valeurs par défaut « Not configured ». Tant que vous ne touchez pas, Nerdio ne pousse rien sur cette clé : la valeur par défaut FSLogix est utilisée. Vous ne tunez que ce que vous voulez vraiment changer, ce qui rend votre conf lisible.

Les best practices que je pousse personnellement (et qui sont presque toutes pré-suggérées par Nerdio) :

RéglageValeurPourquoi
DeleteLocalProfileWhenVHDShouldApplyEnabledSur un environnement neuf, ça évite l’accumulation de profils locaux qui se baladent à côté des VHDX. À ne PAS activer si vous migrez depuis une infra existante avec des profils locaux à préserver.
FlipFlopProfileDirectoryNameEnabledMet le username AVANT le SID dans le nom du folder. Indispensable pour s’y retrouver quand vous cherchez le profil d’un user dans le share.
VolumeTypeVHDXDisque dynamique, grandit au fil du temps. Sur Standard Files, c’est ce qui vous évite de réserver 30 Go par user dès le premier login.
IsDynamicEnabledIdem, le VHDX commence à quelques Mo et grandit en fonction de l’usage réel.
LockedRetryCount / LockedRetryIntervalDéfauts, à augmenter si réseau capricieuxSi le VHD est temporairement locké (réseau qui tousse, session précédente qui ne s’est pas fermée proprement), FSLogix réessaye au lieu de filer un profil temp.
PreventLoginWithFailureEnabledSi FSLogix n’arrive pas à monter le profil, l’utilisateur est BLOQUÉ au login plutôt que de se retrouver sur un profil temporaire. Préférable : un user qui appelle le support > un user qui bosse 4 h sur un profil qui sera jeté au logoff.
PreventLoginWithTempProfileEnabledMême logique, ceinture et bretelles.
ProfileType0Mount sur un seul host à la fois. Le multi-mount (type 3) est une plaie à débugger, à n’activer que si vous avez vraiment besoin.
SizeInMBs30000 (30 GB)Plafond raisonnable. Tracez les profils qui s’en approchent dans le monitoring (section 7).
Compression au logoffEnabledÀ chaque logoff, FSLogix compacte le VHDX. Vous économisez pas mal de stockage à long terme.

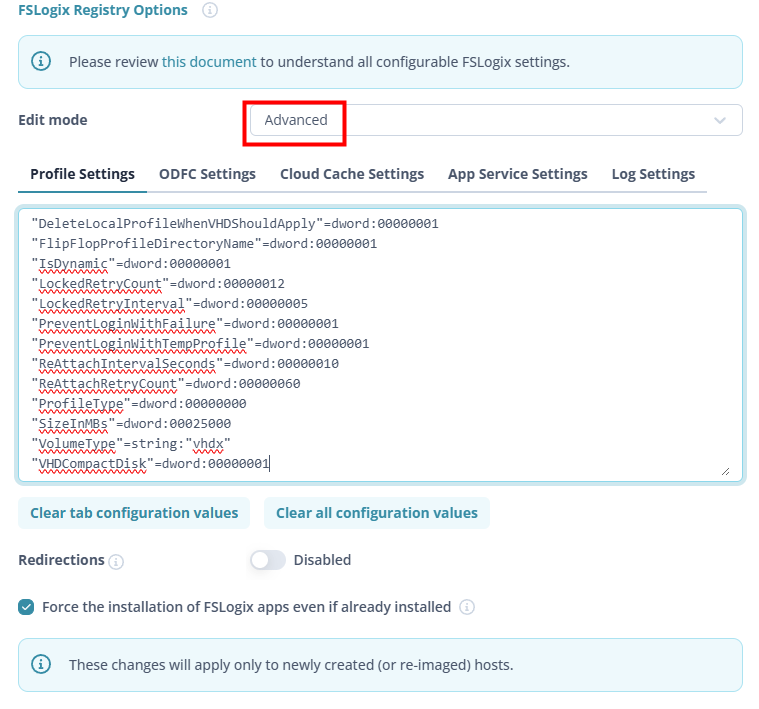
Et pour les puristes : le mode Advanced vous laisse taper directement les clés FSLogix par nom et valeur si vous voulez configurer quelque chose qui n’est pas exposé dans l’UI. Nerdio ne vous enferme pas :

"DeleteLocalProfileWhenVHDShouldApply"=dword:00000001
"FlipFlopProfileDirectoryName"=dword:00000001
"IsDynamic"=dword:00000001
"LockedRetryCount"=dword:00000012
"LockedRetryInterval"=dword:00000005
"PreventLoginWithFailure"=dword:00000001
"PreventLoginWithTempProfile"=dword:00000001
"ReAttachIntervalSeconds"=dword:00000010
"ReAttachRetryCount"=dword:00000060
"ProfileType"=dword:00000000
"SizeInMBs"=dword:00025000
"VolumeType"=string:"vhdx"
"VHDCompactDisk"=dword:00000001

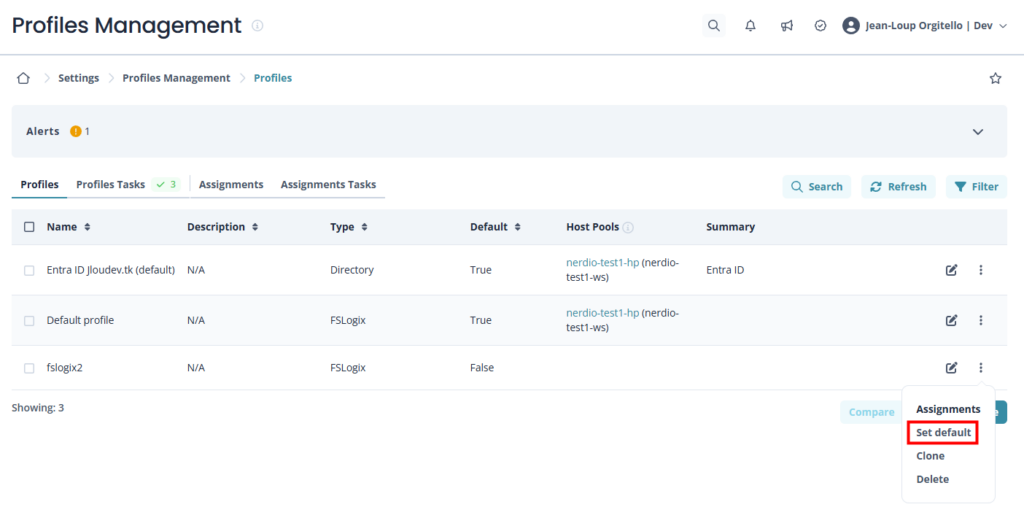
Une fois le profil créé, vous cliquez sur les trois points → Set as default :

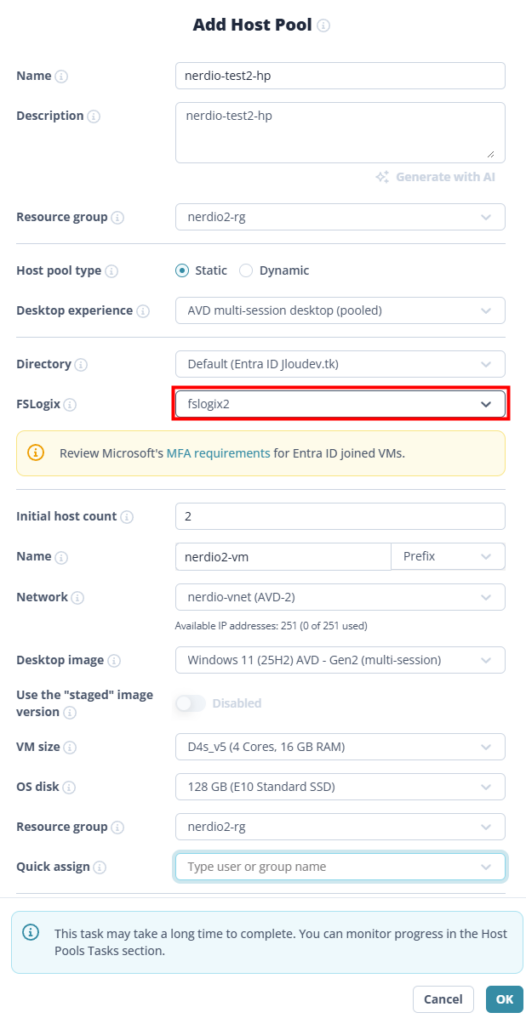
À partir de là, chaque nouveau host pool que vous créez héritera de cette config FSLogix automatiquement. Et bien sûr, vous pouvez override par host pool si vous avez besoin d’une config différente quelque part.

C’est ça le vrai gain par rapport à une approche GPO : ce que vous configurez une fois s’applique partout, sans recréer une GPO ni modifier votre image golden.

4. La config qui descend toute seule sur les session hosts

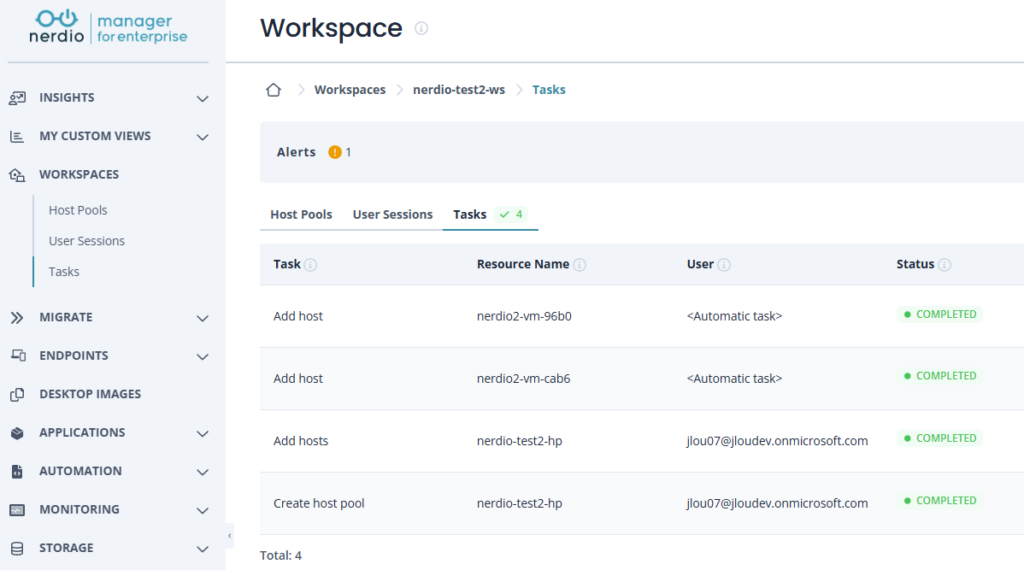
À la création (ou à la mise à jour) d’un host pool, Nerdio injecte la conf FSLogix via ses Scripted Actions au boot des session hosts :

Comme c’est magnifique, et tellement simple :

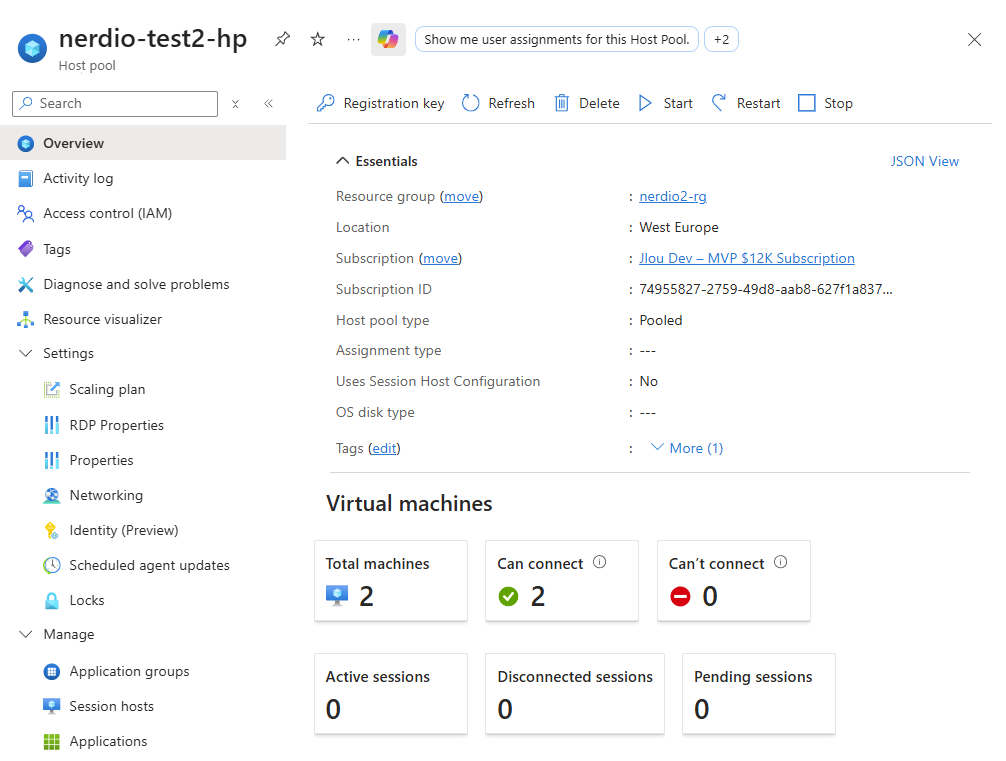
Les machines virtuelles sont bien visibles dans le pool d’hôtes :

Concrètement :

  • Pas besoin de GPO
  • Ça marche sur des hosts Entra-only ou joints à un domaine AD
  • Ça s’applique aussi bien sur les hosts existants que sur les nouveaux (auto-scale, re-image)

Si vous allez voir le registre d’un session host après le déploiement :

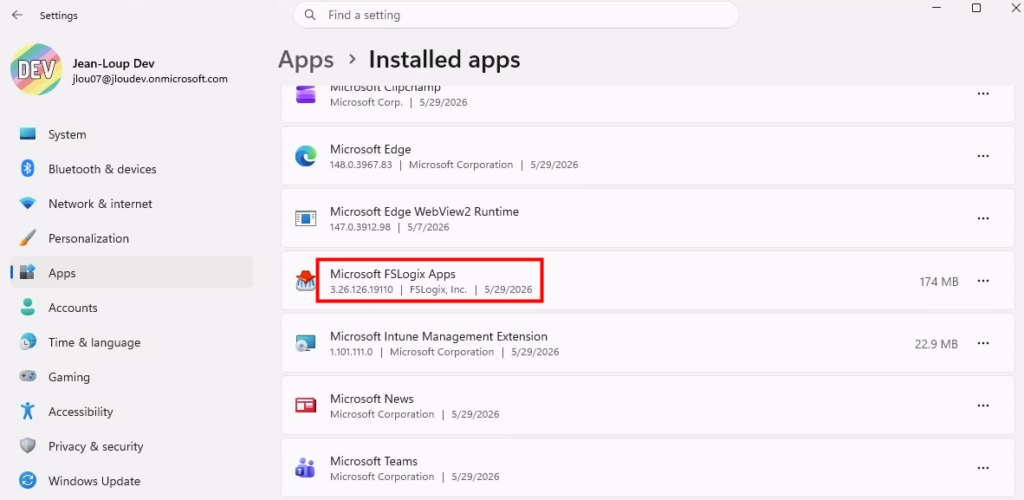
  • La version de FSLogix correspond à celle demandée :
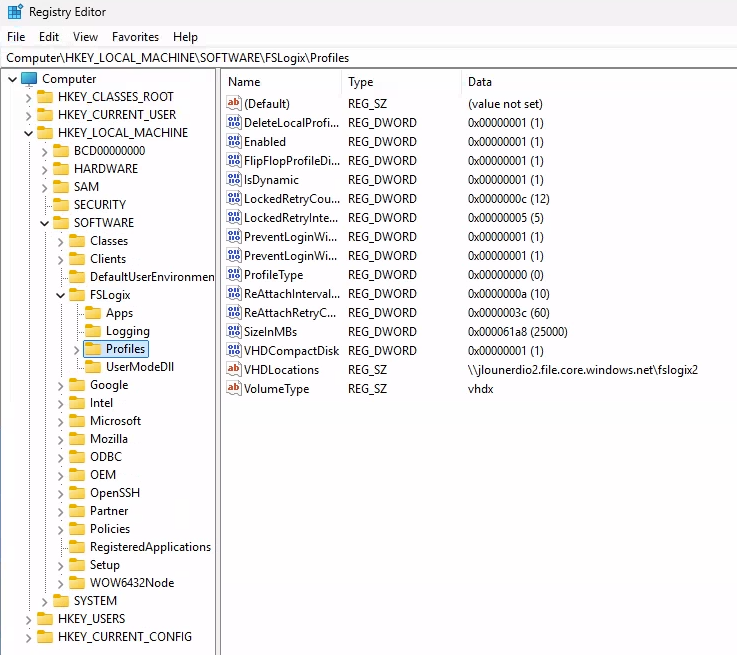
  • Vous retrouverez bien tout sous HKLM\SOFTWARE\FSLogix\Profiles, mais cette fois sans que vous ayez touché à un seul reg add ni à une GPO :

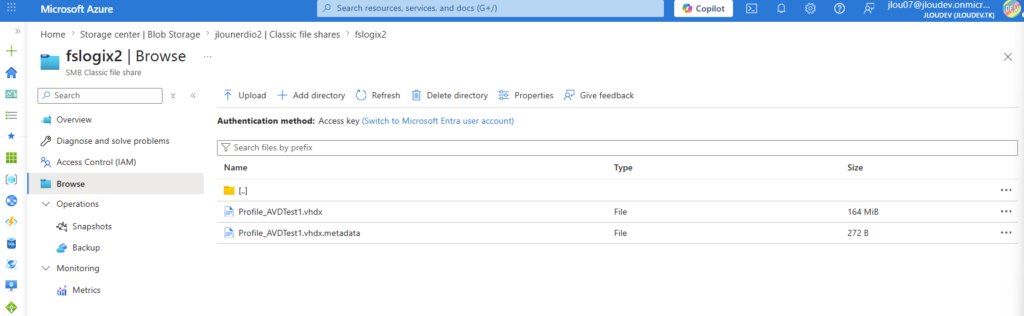
Et bien sûr, le profil VHDX se crée au premier démarrage de l’utilisateur :

Mon retour terrain : si vous changez la config dans le FSLogix Profile Nerdio, vous pouvez redéployer la conf sur tous les hosts d’un host pool en un clic, sans rebuilder l’image. Nerdio relance simplement le Scripted Action sur chaque host. C’est l’inverse du modèle « je rebuild mon image dorée à chaque tuning FSLogix » qu’on voyait avec les GPO.

5. Exclusions, redirections.xml, ODFC, Cloud Cache

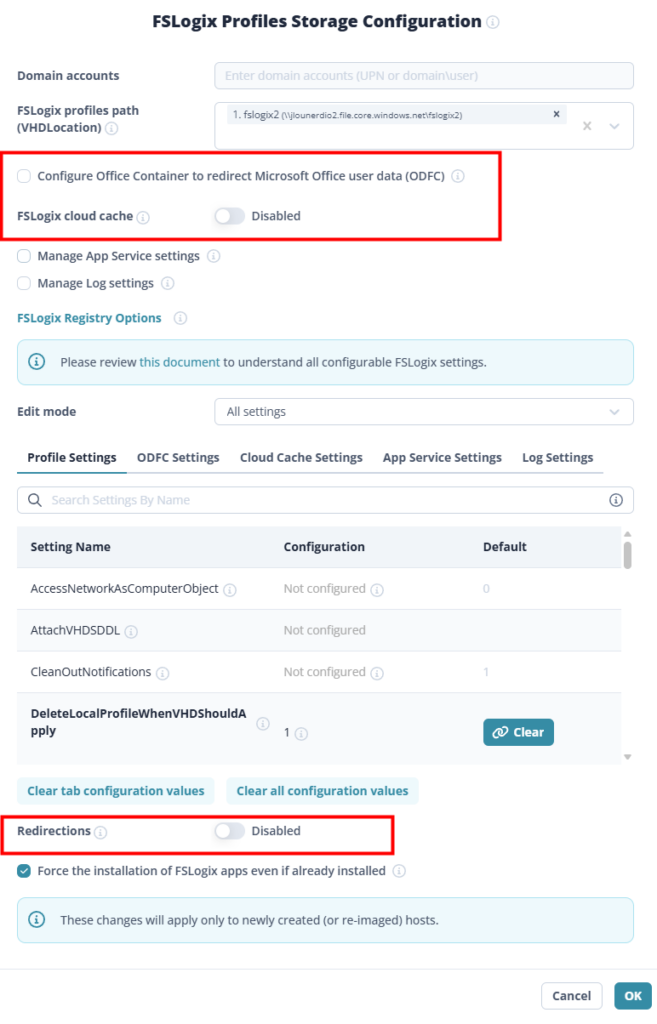
Exclusions registry. Toujours dans le FSLogix Profile, vous avez un onglet Profile Exclusions où vous gérez la liste des dossiers et fichiers que FSLogix doit ignorer (typiquement les caches Teams, les logs, les téléchargements). C’est l’équivalent de la clé HKLM\SOFTWARE\FSLogix\Profiles\Exclude List, mais éditable depuis une UI au lieu d’un import de fichier .reg.

Redirections.xml. Pareil, Nerdio gère l’upload et la synchronisation du redirections.xml sur le share. Vous le modifiez dans Nerdio, il est poussé automatiquement au prochain mount des profils.

Office Container (ODFC). Comme dit en section 3, dans la majorité des cas AVD vous n’en avez pas besoin. La doc Microsoft elle-même recommande de NE PAS mélanger Profile Container et ODFC sauf cas particulier (par exemple OneDrive en mode Files On-Demand avec beaucoup de fichiers). Si vous l’activez, comptez doubler la complexité de troubleshooting.

Cloud Cache. Outil puissant pour faire du multi-storage avec basculement automatique, mais à réserver aux scénarios DR actif-actif ou multi-région avec une vraie contrainte de continuité de service. Sur un host pool en région unique, Cloud Cache n’apporte rien que le Profile Container standard ne fasse déjà.

6. Multi-storage et scoping par host pool

Pour les déploiements qui grossissent, deux features valent le coup d’être mentionnées.

Plusieurs locations FSLogix. Vous pouvez déclarer plusieurs shares dans Nerdio (même un Azure NetApp Files si vous en avez un) et les pointer depuis différents FSLogix Profiles. Pratique pour séparer prod et dev, ou pour des shares dédiés par département.

Scoping par host pool. Souvenez-vous de la case Limit access to specific host pools à l’étape Share & Permissions (section 2). Couplée aux FSLogix Profiles par host pool, ça vous permet d’avoir une isolation stricte : un host pool « Finance » ne peut pas écrire dans le share « RH », et inversement. Tout ça géré dans la même UI, sans pondre des RBAC complexes à la main.

7. Monitoring et cleanup des profils orphelins

Plusieurs features moins glamour, mais qui paient leur licence Nerdio sur le long terme.

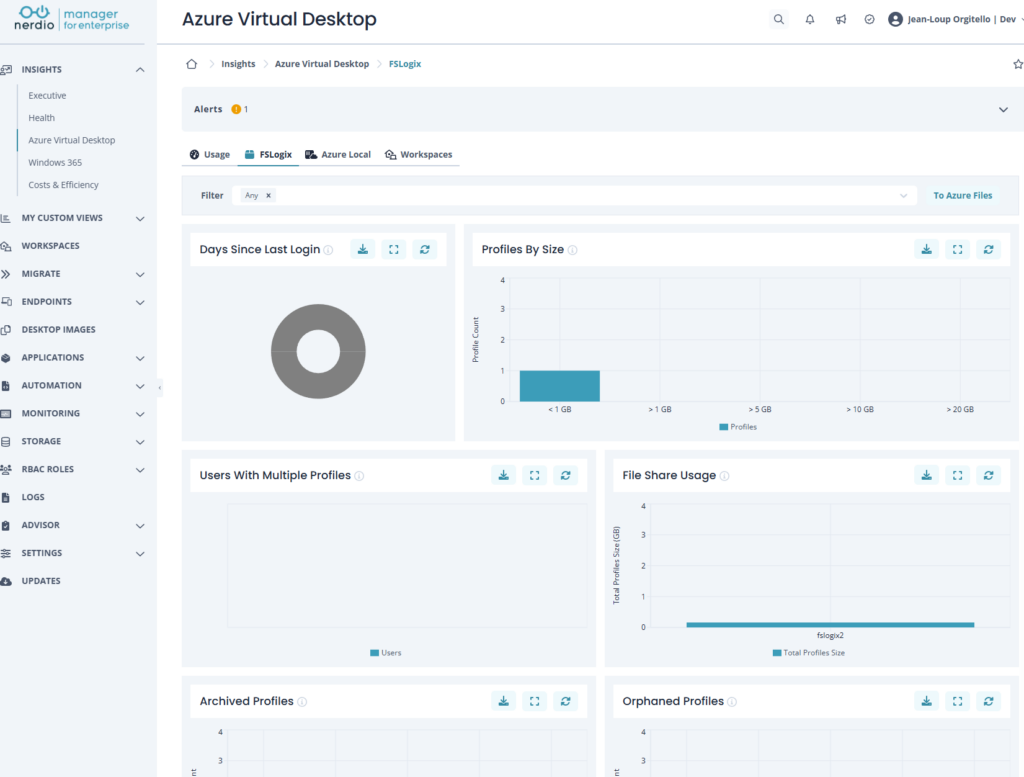
  • Monitoring des tailles de profil : Nerdio remonte pour chaque session active la taille du VHDX du user. Vous voyez tout de suite les profils qui gonflent (typiquement les boîtes OST Outlook, les caches Teams mal nettoyés). Vous pouvez tirer des alertes là-dessus.
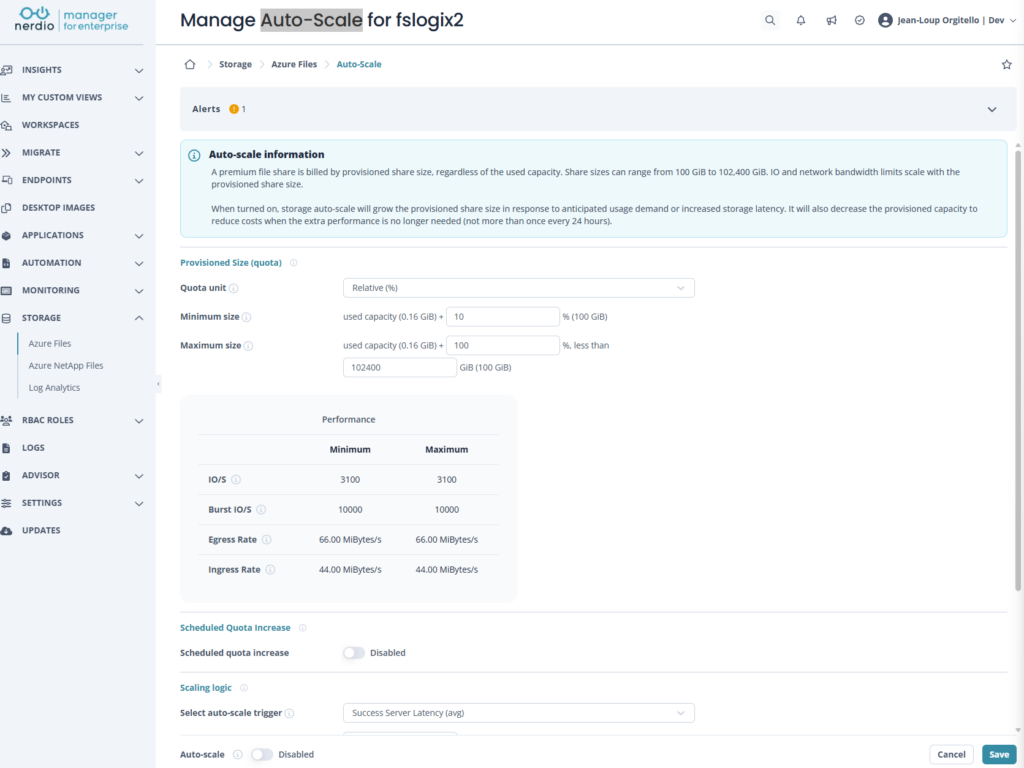
  • Auto-Scale du file share : Manage Auto-Scale for FSLogix permet d’automatiser le dimensionnement des ressources et la gestion des profils utilisateurs afin d’assurer performance et optimisation des coûts sans intervention manuelle, de la même façon que mon article sur la méthode scriptée dans Azure :
  • Cleanup des profils orphelins : Nerdio propose une Scripted Action prête à l’emploi qui scanne votre share FSLogix, compare la liste des folders aux users existants dans Entra ID, et supprime les VHDX des users qui n’existent plus (départs, comptes supprimés). Vous la planifiez en récurrent (une fois par mois par exemple) et vous oubliez.

À la main : il faut écrire le script PowerShell, le planifier (Automation Account, Function App, ou serveur dédié), le maintenir quand l’API Graph change. Avec Nerdio : checkbox + planification.

8. Verdict

Si vous gérez un seul host pool sur une infra stable, FSLogix à la main reste tenable et vous payez l’effort une fois, vous oubliez. Mais dès que vous avez :

  • Plusieurs host pools avec des configs FSLogix différentes,
  • Des changements de conf réguliers (ajout d’exclusions, redirections, tuning),
  • Du multi-département avec isolation des profils,

… Nerdio paye sa licence rien que sur la partie FSLogix. La création du share avec preset NTFS, le push de la conf au boot, le monitoring et le cleanup, c’est plusieurs jours de travail PowerShell que vous n’avez plus à faire ni à maintenir.

Voilà, en 8 sections vous avez fait le tour de ce que Nerdio fait pour vous sur FSLogix. Concrètement, ça donne quoi ? Vos tickets support « profil temporaire » devraient chuter de manière significative. Ce qui, dans la vie d’un admin AVD, n’a pas de prix.

Foncez tester en lab : le wizard Create Azure Files Share en mode Entra-joined, c’est cinq minutes à dérouler, et vous verrez tout de suite la différence avec le manuel. Prochain article de la série : on attaquera l’auto-scaling avec Nerdio, l’autre grande raison de payer cette licence (et la moins évidente à découvrir tout seul).

Remote Display Analyzer

Dans les environnements de bureaux à distance modernes (Azure Virtual Desktop, Windows 365, Citrix …) l’expérience utilisateur dépend énormément du protocole d’affichage distant, du réseau, des ressources , … Quand tout fonctionne bien, personne ne s’en préoccupe. Mais dès qu’un utilisateur dit : « mon Cloud PC lag », « la vidéo est saccadée », « j’ai un délai quand je tape au clavier » … on entre immédiatement dans une zone grise. Bon courage pour comprendre la cause !

Un problème d’affichage distant peut venir de nombreux endroits : réseau, client, serveur, GPU, codec vidéo, politiques de compression et j’en passe.

C’est exactement pour cela que j’aime beaucoup un outil que j’utilise régulièrement lors de phases de troubleshooting : Remote Display Analyzer (RDA).

Cet outil permet de voir et tester en direct ce que fait réellement le protocole d’affichage distant :

Avant d’aller plus loin, je voulais remercier l’équipe RDA de m’avoir donné une licence pour réaliser mes tests.

Et pour vous guider plus facilement dans cet article très long, voici des liens rapides :

Qu’est‑ce que Remote Display Analyzer ?

Remote Display Analyzer (RDA) est un petit et très léger outil conçu pour analyser les protocoles d’affichage utilisés dans les environnements de virtualisation de poste de travail.

Il ne supporte pas que des environnements Microsoft, mais bon nombre de solutions présentes sur le marché, notamment :

  • Microsoft RDP
  • Azure Virtual Desktop
  • Windows 365
  • Citrix HDX
  • Omnissa / VMware Horizon Blast
  • Nutanix Frame

Combien coûte RDA ?

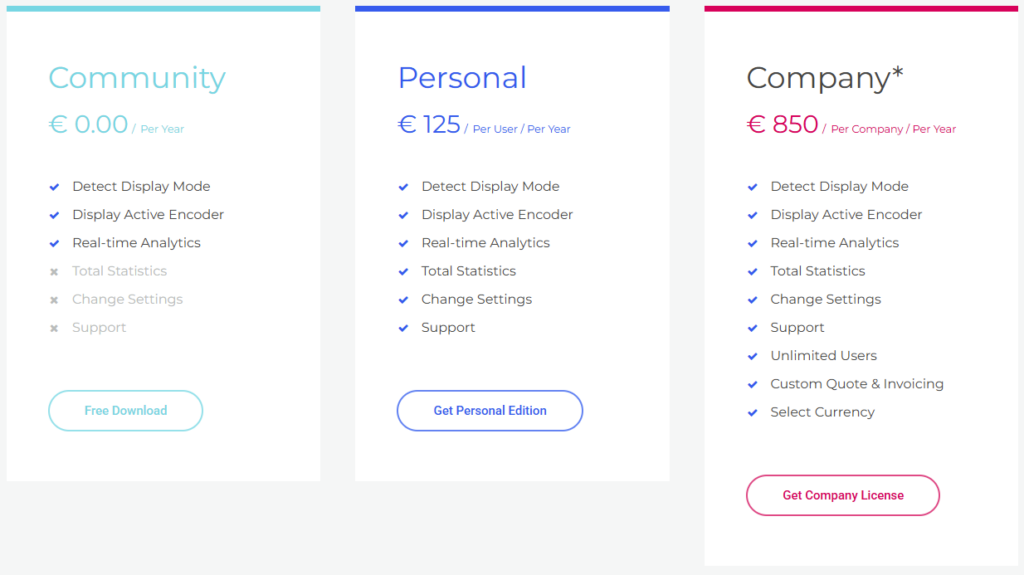
Remote Display Analyzer est décliné en plusieurs éditions afin de répondre à des besoins différents. En plus de l’édition Community, il existe une édition Personal ainsi qu’une édition Company, qui offrent des fonctionnalités avancées adaptées à des usages plus professionnels ou à grande échelle :

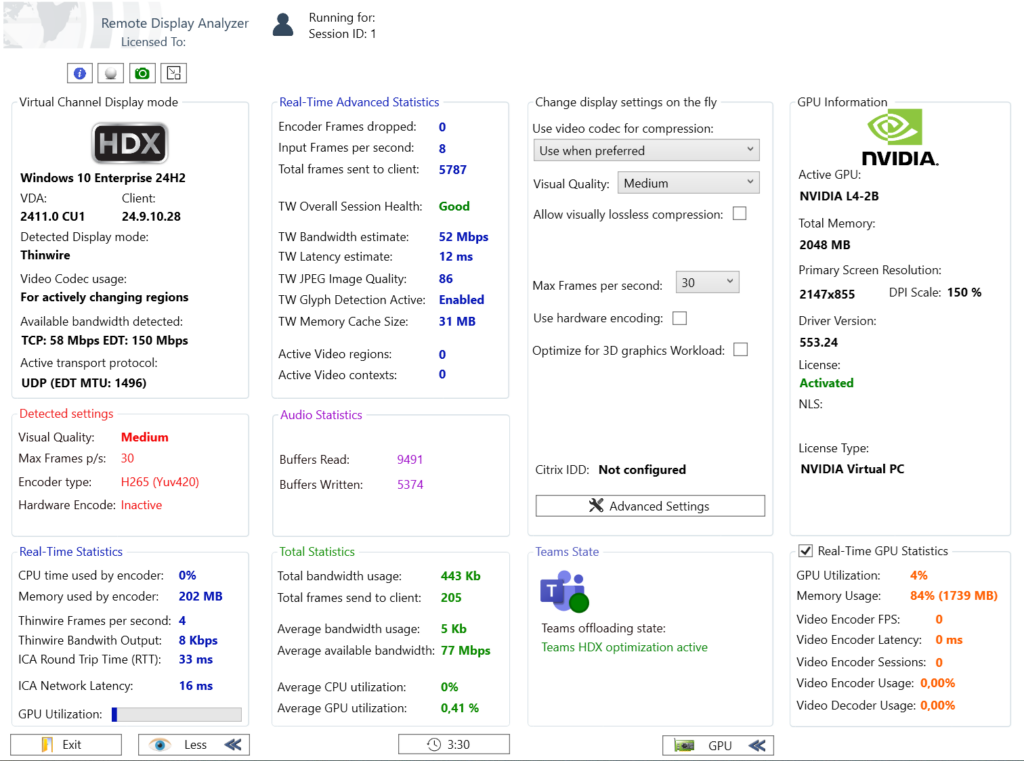
Il existe une version gratuite de RDA : l’édition Community permet d’accéder aux statistiques temps réel du protocole d’affichage, ce qui est largement suffisant pour de nombreux scénarios de diagnostic et de troubleshooting :

Voici un lien de téléchargement de la version gratuite de RDA. Enfin les deux autres versions payantes sont plus complètes, et remontent plus données :

Comment fonctionne RDA ?

Comme annoncé plus haut, Remote Display Analyzer ne nécessite aucune installation préalable. L’outil se présente sous la forme d’un simple exécutable qui peut être lancé directement à l’intérieur d’une session distante, sans configuration particulière.

Voici un lien vers ses fonctionnalités. Dès que RDA est lancé, il détecte automatiquement :

  • le protocole utilisé
  • le mode d’affichage actif
  • l’encodeur vidéo

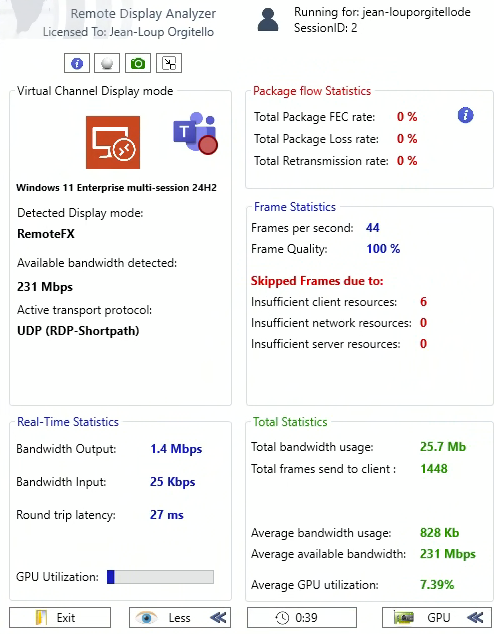
Dans le cas d’Azure Virtual Desktop, Remote Display Analyzer permet également de vérifier si la session utilise RDP Shortpath.

  • RDP Shortpath est un mode de transport UDP qui permet d’améliorer les performances et de réduire la latence dans les sessions AVD.
  • Lorsque Shortpath est actif, le trafic RDP ne passe plus uniquement par le service de gateway Azure, mais peut établir un chemin direct entre le client et la machine virtuelle.

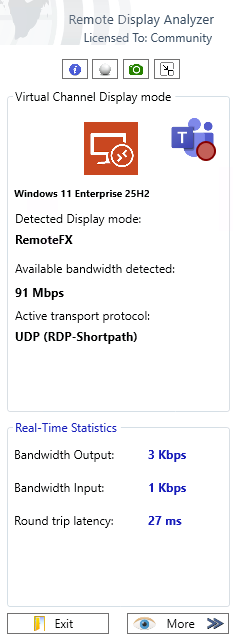
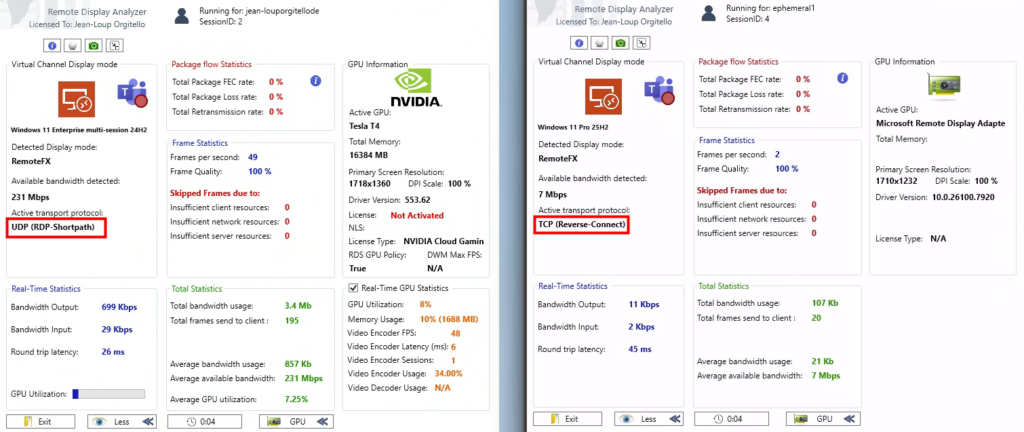
Remote Display Analyzer permet de vérifier immédiatement si la session utilise le transport TCP classique ou le mode UDP (RDP Shortpath) :

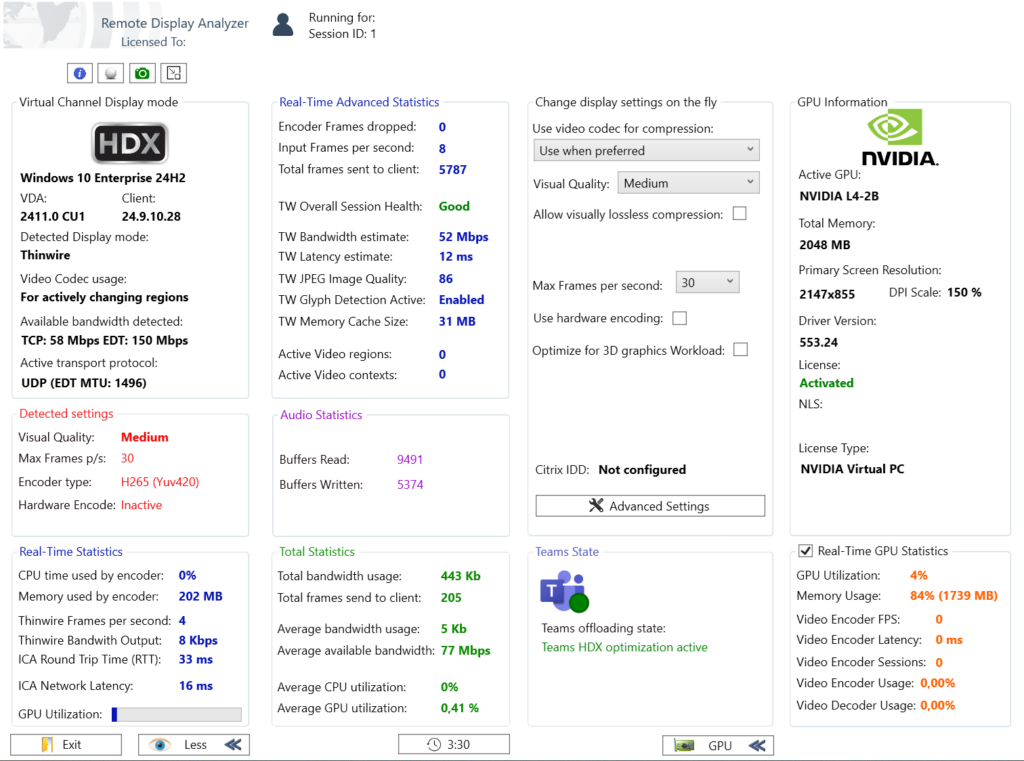
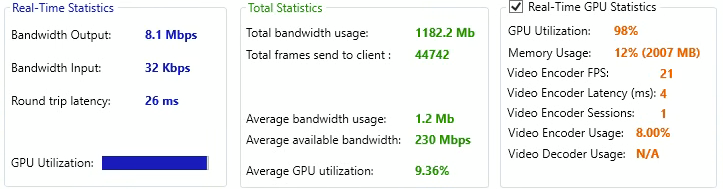
Il affiche également différentes métriques en temps réel, comme par exemple :

  • bande passante utilisée
  • latence réseau
  • nombre de frames
  • frames perdues
  • GPU

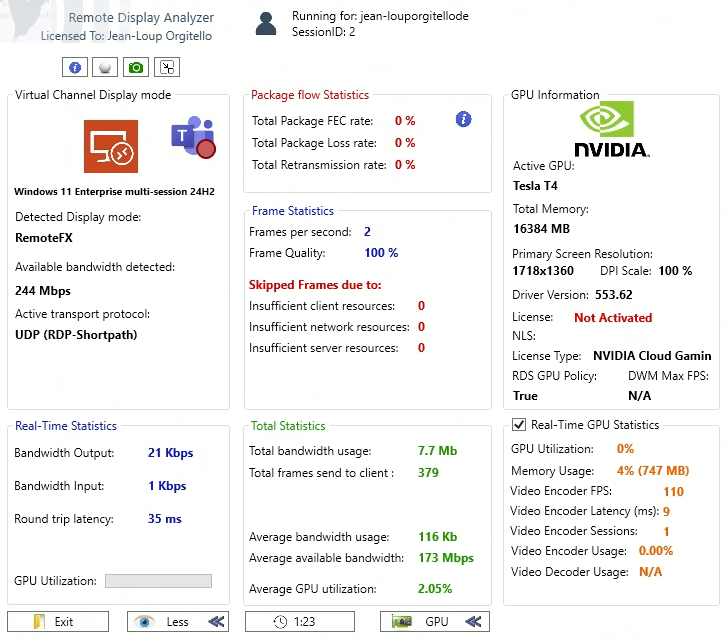
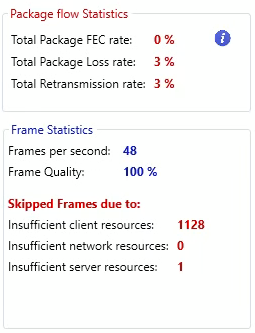
Il vous informe sur les statistiques portant sur les paquets envoyés et les contraintes potentielles sur ces derniers, mais également sur les FPS envoyés :

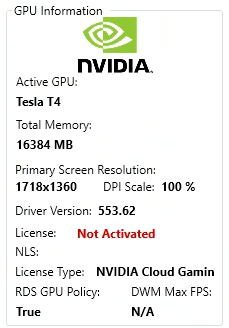
Enfin, il vous donne des informations utiles sur le GPU :

Dans les environnements Azure Virtual Desktop ou Windows 365 utilisant des machines virtuelles avec GPU (par exemple NV-series ou NVads), l’encodage vidéo peut être offloadé vers le GPU. Lorsque cette accélération est active :

  • la charge CPU diminue
  • l’encodage vidéo devient plus rapide
  • l’expérience utilisateur est plus fluide

Remote Display Analyzer permet de vérifier si l’encodeur vidéo GPU est réellement utilisé et d’observer en temps réel la latence de l’encodeur ainsi que le nombre de frames générées.

Cela permet notamment de vérifier que les politiques GPU sont correctement appliquées sur les session hosts AVD.

Comment interpréter les métriques de RDA ?

Certaines métriques sont particulièrement utiles pour comprendre l’expérience utilisateur.

  • FPS :
    • Un environnement fluide tourne généralement entre 25 FPS et 60 FPS
    • En dessous de 20 FPS, les utilisateurs commencent souvent à percevoir des saccades.
  • Latence round-trip :
    • < 40 ms → excellent
    • 40-80 ms → correct
    • 100 ms → visible
  • Video Encoder Latency
    • Une latence encodeur trop élevée peut indiquer : CPU saturé, GPU absent, codec mal configuré

Qu’est-ce que les « Skipped Frames » ?

Dans les protocoles d’affichage distants, toutes les images générées par l’application ne sont pas forcément envoyées au client.

Lorsque certaines ressources deviennent limitées, le protocole peut décider d’ignorer certaines images afin de maintenir une expérience utilisateur acceptable.

Remote Display Analyzer permet d’identifier trois types de frames ignorées :

Skipped frames – client

Cela signifie que le client ne peut pas décoder ou afficher les images assez rapidement. Les causes les plus fréquentes sont :

  • client peu puissant
  • GPU absent
  • décodage vidéo logiciel
  • écran haute résolution

Skipped frames – network

Dans ce cas, c’est le réseau qui devient le facteur limitant. Le protocole décide alors de réduire le flux graphique. Cela peut être causé par :

  • bande passante insuffisante
  • latence élevée
  • pertes de paquets
  • congestion réseau

Skipped frames – server

Ici le problème vient du serveur lui-même. Cela peut être dû à :

  • CPU saturé
  • GPU saturé
  • trop de sessions par host
  • encodage vidéo trop lourd

Quelques exemples de problèmes que RDA permet d’analyser :

Un premier cas fréquent concerne la latence élevée dans les sessions distantes. Les utilisateurs peuvent ressentir un délai entre l’action réalisée sur le clavier ou la souris et la réaction affichée à l’écran. Dans ce type de situation, Remote Display Analyzer permet de visualiser la latence réseau, le nombre de frames envoyées et les éventuelles frames perdues afin d’identifier si le problème vient du réseau, du serveur ou du client.

Dans l’exemple ci-dessous, RDA analyse une session Windows 11 dans Azure Virtual Desktop :

Comme la vidéo le montre, il peut être très instructif de simuler différents niveaux de latence réseau afin d’observer comment la session se comporte dans des conditions WAN plus difficiles. Remote Display Analyzer permet alors de suivre en temps réel l’impact de la latence sur la fluidité et la réactivité.

Un autre problème courant concerne les vidéos ou les animations qui deviennent saccadées. Les utilisateurs peuvent par exemple remarquer que Microsoft Teams, YouTube ou certaines applications graphiques ne sont pas fluides. Dans ce cas, l’outil permet d’analyser le nombre d’images par seconde, le codec vidéo utilisé ainsi que la bande passante réellement consommée par la session :

On rencontre également souvent des problèmes d’image floue ou de compression trop forte. Dans ces situations, le texte peut sembler légèrement dégradé ou certaines images peuvent apparaître très compressées. Remote Display Analyzer permet alors de tester différents niveaux de compression et différentes qualités d’image afin de trouver le bon compromis entre qualité visuelle et consommation réseau.

Enfin, certains environnements rencontrent des problèmes de charge CPU trop élevée sur les serveurs. Cela peut se produire lorsque l’encodage vidéo est effectué par le CPU plutôt que par le GPU. Dans ce type de scénario, RDA permet de vérifier si l’encodage GPU est réellement utilisé ou si le CPU est responsable du traitement graphique :

Peut-on modifier certains réglages graphiques avec RDA ?

Ce qui rend l’outil vraiment intéressant est une autre capacité. Remote Display Analyzer permet de modifier certains paramètres d’affichage en live pour les environnements Citrix. Cela permet de faire des tests très rapides pour comprendre l’impact réel d’une configuration. Par exemple :

  • codec vidéo
  • profondeur de couleur
  • compression
  • qualité d’image
  • frames par seconde

Comme le rappelle l’éditeur dans leur FAQ, RDA nécessite les droits administrateur pour pouvoir effectuer ces modifications.

Conclusion

Remote Display Analyzer est un outil extrêmement simple, mais particulièrement utile dans les environnements EUC.

Lorsqu’un utilisateur signale que son bureau distant est lent ou que la vidéo est saccadée, il est souvent difficile de savoir immédiatement si le problème vient du réseau, du client, du serveur ou du protocole lui-même.

Grâce à ses métriques en temps réel et à sa capacité à modifier certains paramètres graphiques à la volée, Remote Display Analyzer permet de mieux comprendre le comportement du protocole d’affichage distant.

Pour les administrateurs travaillant avec Azure Virtual Desktop, Windows 365, Citrix ou Horizon, c’est clairement un outil que je recommande d’avoir dans sa boîte à outils de troubleshooting.

Migrez de VMware vers Hyper-V grâce à Windows Admin Center

Le rachat de VMware par Broadcom a agi comme un électrochoc. Aujourd’hui, la question n’est plus faut-il migrer? , mais comment migrer sans tout casser ou y perdre tous ses cheveux?. Entre les solutions tierces payantes et les méthodes manuelles risquées, Microsoft a discrètement sorti une arme redoutable : l’extension VM Conversion pour Windows Admin Center (WAC).

Après avoir testé l’outil encore en préversion, je voulais partager avec vous mon expérience. Et pour vous guider plus facilement dans cet article très long, voici des liens rapides :

Pourquoi quitter VMware ?

Le rachat de VMware par Broadcom a agi comme un électrochoc. Beaucoup de clients ont vu les coûts augmenter fortement après le rachat, car Broadcom a changé le modèle de licences (par exemple passage d’une licence perpétuelle à un modèle d’abonnement) et restructuré les offres. Certains ont reçu des renouvellements jusqu’à plusieurs fois plus chers qu’avant pour les mêmes besoins.

Ces changements rapides dans la structuration des produits, des bundles et du support ont créé de l’incertitude sur la roadmap et l’avenir des produits VMware, ce qui amène les DSI à repenser leurs choix technologiques à long terme

On retrouve d’ailleurs pas mal de blogueurs parlant de cet exode :

Qu’est-ce que Windows Admin Center ?

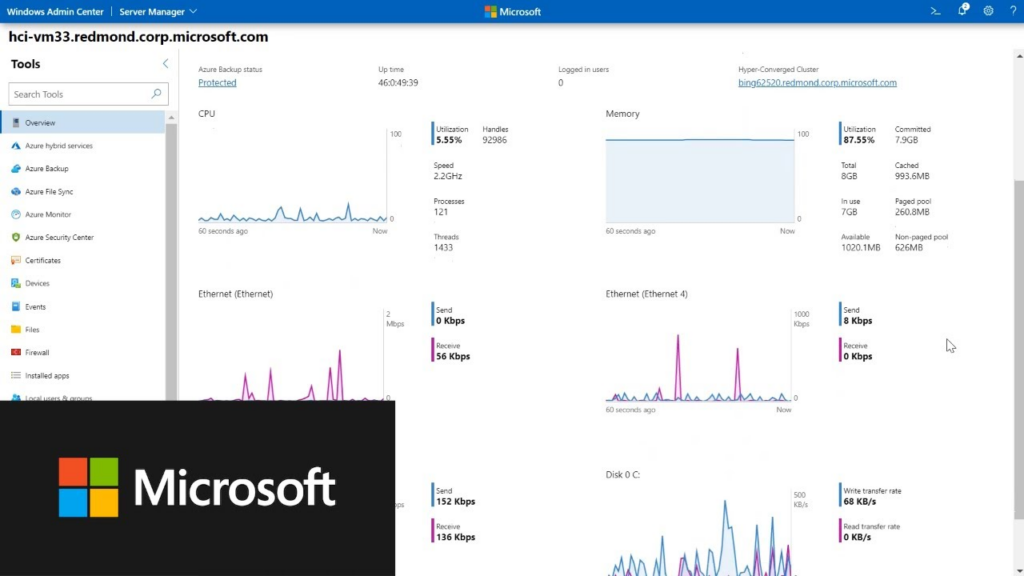
Présent depuis des années, Windows Admin Center (souvent abrégé WAC) est un outil d’administration web développé par Microsoft pour gérer des serveurs Windows, des clusters et des environnements hyperconvergés, depuis une interface moderne accessible via navigateur.

Concrètement, Windows Admin Center vous permet d’administrer, sans passer par du RDP, un grand nombre de services Microsoft :

  • Windows Server
  • Hyper-V
  • Clusters (Failover Clustering)
  • Machines virtuelles
  • Serveurs distants (on-prem ou Azure)
  • Stockage (Storage Spaces Direct)

Qu’est-ce que l’extension VM Conversion ?

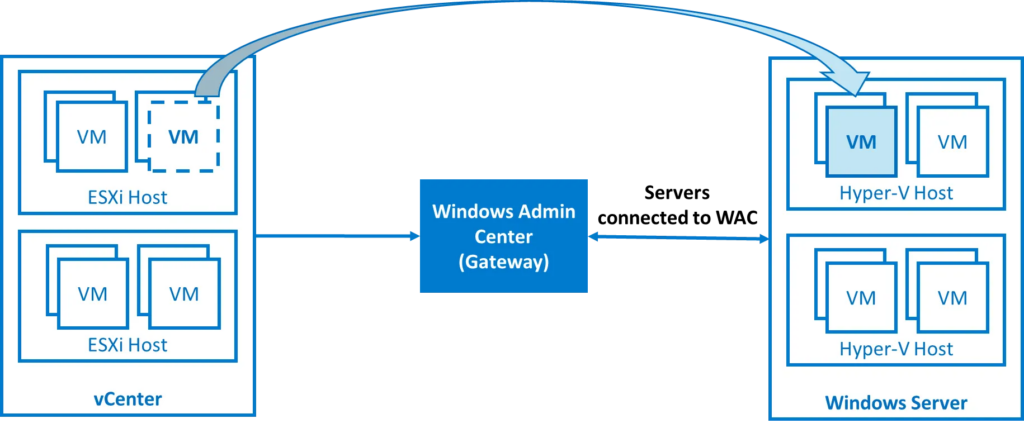
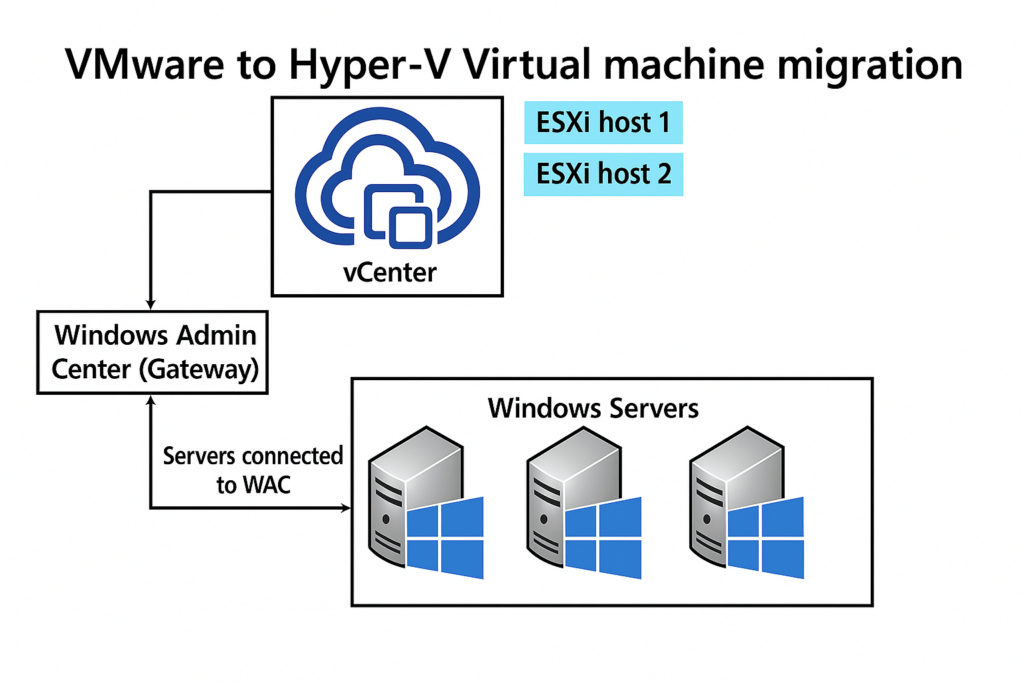
C’est un nouvel outil Microsoft intégré à Windows Admin Center qui permet de migrer des machines virtuelles depuis VMware vCenter/ESXi vers Hyper-V, en mode agentless :

Actuellement, Il s’agit d’une extension prévue pour minimiser le temps d’arrêt grâce à la réplication en ligne des disques.

Attention, cette extension n’est pas pour but de migrer vers Azure Local. Un autre article déjà écrit il y a plusieurs mois traite de ce type de migration : de VMware à Azure Local.

Combien coûte VM Conversion ?

L’extension est actuellement en préversion. Son usage n’implique aucun coût de licence supplémentaire, mais pas non plus de support garanti par Microsoft.

Quelles versions d’OS sont supportées ?

Microsoft annonce une large liste sur la compatibilité :

  • Tous les vCenter VMware 6.x, 7.x et 8.x sont pris en charge
  • Côté OS invités :
    • Windows Server 2025, 2022, 2019, 2016, 2012 R2
    • Windows 10/11
    • Ubuntu 20.04, 24.04
    • Debian 11, 12
    • Alma Linux
    • CentOS
    • Red Hat Linux 9.0

L’extension fonctionne également dans un environnement Hyper-V en cluster (WSFC) : elle est cluster-aware et détecte correctement les nœuds et ressources.

Il supporte la migration de VM depuis ESXi vers des clusters Windows Server Failover (WSFC) sous Hyper-V. Vous pouvez donc distribuer les VM migrées sur plusieurs nœuds Hyper-V pour HA ou performances.

Quels sont les prérequis pour VM Conversion ?

  • Côté Windows Admin Center :
    • WAC en version au moins v2410 build 2.4.12.10 ou supérieure
    • PowerShell et PowerCLI installés
    • VMware VDDK version 8.0.3 installé
    • Visual Studio 2013 et 2015 installés
  • Côté Hyper-V :
    • le rôle Hyper-V doit être installé sur le (s) hôte (s) cible
    • Le compte utilisé durant le processus doit être administrateur local ou membre du groupe Hyper-V Administrators).
    • Si des VMs migrées sont sous Linux, les modules Hyper-V (hv_vmbus, hv_netvsc, hv_storvsc) et Linux Integration Services (hyperv-daemons ou linux-cloud-tools) doivent être pré-installés dans l’initramfs avant migration.

Combien de VM puis-je migrer simultanément ?

Jusqu’à 10 machines virtuelles par lot. On peut grouper ces machines selon leur dépendance applicative, leur placement dans un cluster ou même selon des critères métier (ex : séparer environnement de test/prod). Cela facilite les migrations massives par workload.

Comment l’outil VM Conversion marche ?

Microsoft explique bien les deux phases présentes dans l’outil VM Conversion :

Synchronisation : l’extension effectue une copie complète initiale des disques de la machine virtuelle pendant que la VM source continue de fonctionner. Cette phase minimise les temps d’arrêt en vous permettant de planifier la migration finale à un moment qui vous convient.

Migration : l’extension utilise la fonctionnalité Change Block Tracking (CBT) pour rechercher et répliquer uniquement les blocs modifiés depuis la dernière synchronisation. Pendant la transition, la machine virtuelle source est mise hors tension et une synchronisation delta finale capture toutes les modifications restantes avant d’importer la machine virtuelle dans Hyper-V.

Microsoft Learn

Quid du temps d’arrêt ?

Pendant la phase de synchronisation, la VM source continue de tourner, pendant qu’une copie initiale des disques est envoyée sur l’hôte Hyper-V, via la création d’un snapshot pour suivre les changements.

Au moment de la bascule, la VM source est arrêtée pour un dernier delta-sync avant import; ce processus réduit donc au minimum la fenêtre d’arrêt.

Que devient VMware Tools sur le VM migré ?

La présence de VMware Tools dans une VM sous Hyper-V peut provoquer des conflits de pilotes, donc il vaut mieux les retirer.

  • Initialement, il fallait supprimer les outils VMware Tools manuellement après la bascule vers Hyper-V.
  • Depuis la version 1.8.0, l’extension supprime automatiquement VMware Tools sur les VM Windows migrées en fin de processus.
  • Pour les VM Linux, il est recommandé de ne pas réinstaller open-vm-tools sur la cible Hyper-V (on s’appuie uniquement sur les pilotes Hyper-V ajoutés).

Et enfin, comme toujours, je vous propose dans la suite de cet article d’effectuer ensemble un pas à pas pour couvrir la migration de machines virtuelles hébergées sur VMware vers Hyper-V :

Etape 0 – Rappel des prérequis :

Des prérequis sont nécessaires pour réaliser cet exercice dédié à la migration d’une machine virtuelle hébergée sur VMware vers Hyper-V via Windows Admin Center. Pour tout cela, j’ai utilisé :

  • Un environnement VMware
  • Un environnement Hyper-V
  • Une connexion réseau entre le réseau les deux hyperviseurs

Commençons par l’installation de Windows Admin Center sur une nouvelle machine hébergée sur VMware.

Etape I – Installation de Windows Admin Center :

Sur une machine virtuelle dédiée dans votre environnement VMware, téléchargez la dernière version de Windows Admin Center depuis la page officielle de Microsoft :

Choisissez l’installation avec l’option Express :

Dans cette démonstration, utilisez un certificat temporaire :

Lancez l’installation :

Une fois l’installation terminée, ouvrez la page de Windows Admin Center, puis authentifiez-vous avec votre compte :

Une fois connecté dans la console Windows Admin Center, attendez quelques minutes la fin de l’installation des extensions préinstallées :

Rendez vous dans les paramétrages dans WAC afin d’ajouter l’extension dédiée à la migration :

Etape II – Installation de prérequis WAC :

Comme indiqué dans la documentation Microsoft, certains prérequis doivent être installés sur la machine de Windows Admin Center.

Commencez par installer Visual C++ Redistributable Packages for Visual Studio 2013

Continuez en installant également Visual C++ 2015-2022 Redistributable 14.50.35719.0 :

Récupérez et décompressez VMware Virtual Disk Development Kit (VDDK), en version 8.0.3, dans le dossier WAC suivant :

Redémarrez ensuite votre machine virtuelle contenant Windows Admin Center.

Etape III – Connexion à Hyper-V depuis WAC :

Une fois la machine virtuelle WAC redémarrée, rouvrez la console, puis cliquez ici pour ajouter une connexion vers votre serveur Hyper-V :

Cliquez sur Ajouter :

Renseignez l’adresse IP de votre Hyper-V, les éléments d’identification, puis cliquez sur Ajouter :

La connexion est établie, cliquez dessus pour l’ouvrir :

Dans le menu de gauche, cherchez l’extension consacrée à la migration, cochez la case suivante pour installer PowerCLI, puis cliquez ici :

Attendez la fin de l’installation de PowerCLI :

Une fois l’installation terminée, cliquez ici ajouter une connexion à votre vCenter, renseignez vos informations de connexion, puis cliquez ici :

Une fois la connexion établie avec vCenter, les machines virtuelles s’afficheront :

Le protocole de test est maintenant en place. Commençons les tests par la migration d’une machine virtuelle fonctionnant sous Windows Server.

Etape IV – Test Windows : Synchronisation de la VM :

Toujours dans la liste des machines virtuelles, cochez sur une des VMs Windows disponibles, puis cliquez ici pour démarrer la synchronisation :

Renseignez le dossier de destination sur votre serveur Hyper-V, puis cliquez sur Synchroniser :

La phase de vérification préalable à la migration vient de démarrer (accessibilité, compatibilité matérielle, compatibilité OS, configuration réseau, …) :

La première copie des disques VMDK vers Hyper-V est en cours pour la création des fichiers VHDX par la suite :

Constatez d’ailleurs la création du dossier sur le serveur Hyper-V :

La migration passe en mode synchronisation différentielle afin de ne copier que les blocs modifiés depuis la synchronisation initiale, réduisant ainsi le volume de données à transférer avant le cutover :

Provisioning du disque cible Hyper-V (VHDX) : l’infrastructure prépare le stockage avant l’application des blocs synchronisés issus de la VM VMware :

Phase de delta sync : les blocs modifiés identifiés via CBT sont appliqués au disque Hyper-V afin d’aligner la VM cible avec l’état courant de la VM source :

Le monitoring de la carte réseau montre bien le transfert des données :

Synchronisation complète (100 %) : l’intégralité des données de la VM source est maintenant répliquée côté Hyper-V :

La VM cible est maintenant entièrement alignée avec la VM VMware et peut être basculée vers Hyper-V avec un dernier delta minimal.

Nous allons pouvoir procéder à la migration.

Etape V – Test Windows : Migration de la VM :

A ce stade, la machine virtuelle sous VMware est toujours allumée :

Testez le delta de migration en rajoutant sur votre machine virtuelle source de nouveaux fichiers :

Retournez ensuite sur Windows Admin Center afin de lancer la migration de celle-ci :

Choisissez ou non de désinstaller les outils VMware, puis cliquez ici :

Lancement de la migration : exécution des vérifications préalables avant bascule définitive vers la VM Hyper-V cible :

Vérifications pré-migration terminées : la synchronisation finale des blocs modifiés (delta sync) est en cours avant l’arrêt et la bascule de la VM :

Un snapshot est bien créé côté VMware :

Delta Sync en cours : application des derniers blocs modifiés afin d’aligner définitivement la VM cible avant le cutover final vers Hyper-V.

Arrêt de la VM source : la machine VMware est éteinte et la phase finale de synchronisation est lancée avant le démarrage côté Hyper-V :

La machine virtuelle est bien arrêtée côté VMware :

Migration terminée (100 %) : la VM cible Hyper-V est créée, synchronisée et prête à être démarrée en production :

La VM migrée s’exécute désormais sur Hyper-V, confirmant le succès du cutover depuis l’environnement VMware :

Windows détecte un arrêt inattendu lié au cutover, confirmant que la VM a bien été basculée depuis l’environnement VMware vers Hyper-V :


Erreur VMware Tools au premier démarrage : les anciens composants VMware, désormais incompatibles sous Hyper-V, doivent être désinstallés après la migration :

Désinstallez les VMware Tools devenus inutiles après le passage de la VM sous Hyper-V :

Les fichiers créés avant la commande Migrate sont bien présents après la bascule, confirmant l’intégrité de la synchronisation finale :

Notre serveur Windows a bien été migré depuis VMware vers Hyper-V avec succès. Testons maintenant la même opération avec un serveur Linux.

Etape VI – Test Linux : Synchronisation de la VM :

Exemple réalisé ici sur AlmaLinux / RHEL-like. Le but étant de :

  • Désinstaller VMware Tools
  • Installer composants Hyper-V
  • Recréer initramfs si nécessaire
  • Reboot

Pour cela créez une machine virtuelle Linux dont l’OS est compatible avec l’outil de Migration :

Avant la migration, ajoutez les pilotes Hyper-V à l’initramfs, reconstruction avec dracut, puis redémarrage pour assurer un démarrage correct sous Hyper-V.

echo 'add_drivers+=" hv_vmbus hv_storvsc hv_netvsc "' | sudo tee /etc/dracut.conf.d/hyperv.conf
sudo dracut -f --regenerate-all
sudo reboot

Toujours avant la migration, installez des services d’intégration Hyper-V (hyperv-daemons) afin d’optimiser les performances et l’interaction entre la VM Linux et l’hôte Hyper-V.

Exemple réalisé sur une distribution RHEL-like (AlmaLinux / Rocky / RHEL). (Adaptez la commande si vous êtes sur Ubuntu ou Debian) :

sudo dnf install hyperv-daemons -y

Vérifiez le chargement des modules Hyper-V (hv_*) dans le noyau Linux afin de confirmer la bonne prise en charge de l’environnement Hyper-V :

Toujours dans la liste des machines virtuelles, cochez sur une des VMs Linux disponibles, puis cliquez ici pour démarrer la synchronisation :

Renseignez le dossier de destination sur votre serveur Hyper-V, puis cliquez sur Synchroniser :

La phase de vérification préalable à la migration vient de démarrer (accessibilité, compatibilité matérielle, compatibilité OS, configuration réseau, …) :

La première copie des disques VMDK vers Hyper-V est en cours pour la création des fichiers VHDX par la suite :

Constatez d’ailleurs la création du dossier sur le serveur Hyper-V :

La migration passe en mode synchronisation différentielle afin de ne copier que les blocs modifiés depuis la synchronisation initiale, réduisant ainsi le volume de données à transférer avant le cutover :

Phase de delta sync : les blocs modifiés identifiés via CBT sont appliqués au disque Hyper-V afin d’aligner la VM cible avec l’état courant de la VM source :

Le monitoring de la carte réseau montre bien le transfert des données :

Synchronisation complète (100 %) : l’intégralité des données de la VM source est maintenant répliquée côté Hyper-V :

La VM cible est maintenant entièrement alignée avec la VM VMware et peut être basculée vers Hyper-V avec un dernier delta minimal.

Nous allons pouvoir procéder à la migration.

Etape VII – Test Linux : Migration de la VM :

Retournez ensuite sur Windows Admin Center afin de lancer la migration de celle-ci :

Lancement de la migration : exécution des vérifications préalables avant bascule définitive vers la VM Hyper-V cible :

Arrêt de la VM source : la machine VMware est éteinte et la phase finale de synchronisation est lancée avant le démarrage côté Hyper-V :

La machine virtuelle est bien arrêtée côté VMware :

Migration terminée (100 %) : la VM cible Hyper-V est créée, synchronisée et prête à être démarrée en production :

La VM migrée s’exécute désormais sur Hyper-V, confirmant le succès du cutover depuis l’environnement VMware :

Conclusion

La migration d’un environnement VMware vers Hyper-V n’est jamais une décision anodine. Elle est souvent motivée par des enjeux économiques, stratégiques ou organisationnels. Mais quelle qu’en soit la raison, elle doit rester avant tout une opération maîtrisée, structurée et techniquement fiable.

L’extension VM Conversion de Windows Admin Center n’est pas un simple assistant graphique. Elle propose une approche orchestrée et cohérente : synchronisation initiale, delta via CBT, puis phase de bascule contrôlée. Ce n’est pas “magique” et cela ne dispense pas d’une préparation sérieuse. En revanche, l’outil apporte un cadre clair qui simplifie fortement un processus historiquement complexe.

Dans mes tests, l’expérience s’est révélée stable et lisible. La gestion des clusters Hyper-V (WSFC), la logique de synchronisation progressive et l’interface unifiée dans WAC rendent la migration bien plus accessible qu’avec des méthodes artisanales. Cela reste une extension en preview, donc à évaluer sérieusement en environnement de test avant toute utilisation en production, mais la base technique est solide.

Ce qui est certain, c’est qu’une alternative crédible existe désormais pour les organisations qui souhaitent diversifier ou repositionner leur stratégie d’hyperviseur. La migration ne doit plus être perçue comme un saut dans l’inconnu, mais comme un projet structuré, pilotable et documenté.

Facilitez-vous la vie avec WVDAdmin

Combien de clics faut-il réellement pour capturer proprement une image AVD, la versionner dans une galerie, puis redéployer 10 hôtes sans erreur ? Si vous administrez Azure Virtual Desktop au quotidien, vous connaissez la réalité : le portail Azure fonctionne très bien… mais l’opérationnel est répétitif, chronophage, et parfois fragile. Image → Sysprep → Snapshot → Galerie → Version → Déploiement → Intégration au pool → Vérifications. Et on recommence !

Azure Virtual Desktop a énormément évolué ces dernières années. Builder, améliorations ARM/Bicep, automatisations natives… mais malgré tout, dans la vraie vie d’un admin ou d’un architecte, on cherche surtout à raccourcir la boucle opérationnelle.

C’est exactement là que WVDAdmin entre en jeu. Un outil communautaire, simple, direct, qui ne cherche pas à réinventer AVD, mais à compresser le quotidien.

Et pour vous guider plus facilement dans cet article très long, voici des liens rapides :

Qu’est-ce que WVDAdmin ?

WVDAdmin est un outil graphique communautaire pour administrer Azure Virtual Desktop (anciennement Windows Virtual Desktop) via une application installée localement. WVDAdmin a été développé par Marcel Meurer et est disponible via son blog ITProCloud.

Qui est Marcel Meurer ?

Marcel Meurer est un expert allemand spécialisé dans Azure Virtual Desktop (AVD) et l’automatisation Azure. Il a reçu une double nomination en tant que Microsoft MVP, et il fait partie de ce prestigieux programme depuis plus de onze années.

Marcel Meurer est également le créateur de Hydra for Azure Virtual Desktop. Nous reviendrons sur Hydra for Azure Virtual Desktop dans un prochain article.

Que peut-on faire avec WVDAdmin ?

Une bonne manière de comprendre WVDAdmin est la suivante : il ne cherche pas à « remplacer Azure Virtual Desktop », mais à compresser la boucle opérationnelle (image → déploiement → exploitation → mise à jour) en moins de clics et dans une interface unique.

Basé sur sa documentation officielle, voici un résumé de ce que WVDAdmin peut faire pour vous.

  • Workflow d’image golden : création d’images à partir d’un « golden master » sans détruire la VM maître/modèle, avec gestion de Sysprep, des applications modernes et des opérations de nettoyage.
  • Déploiement (rollout) : déploiement de plusieurs hôtes de session, choix des tailles de VM par déploiement, prise en charge des disques éphémères, et options telles que « AAD only / joint à MEM/Intune » (selon l’auteur).
  • Opérations sur les ressources AVD : création, ajout et suppression de pools d’hôtes, groupes d’applications, espaces de travail et hôtes de session.
  • Opérations sur les sessions : déconnexion, délogage, envoi de messages et shadowing.
  • Opérations générales sur les VM Azure : inventaire des VM sur plusieurs abonnements (via Azure Resource Graph, avec un délai signalé), exécution de scripts à distance, snapshots/restaurations, et même réduction de la taille des disques OS.
  • Opérations en simultané : WVDAdmin supporte plusieurs tâches en simultané afin de gagner en efficacité.

WVDAdmin vs Hydra for AVD ?

WVDAdmin est à l’origine un outil communautaire gratuit pour Azure Virtual Desktop. WVDAdmin est intéressant lorsqu’on cherche une méthode rapide pour faire de l’imaging et du déploiement AVD. C’est une application Windows utilisée de manière interactive, donc sans automatisation planifiée.

Hydra en est une évolution plus avancée et orientée production (autoscaling, multi-tenant, orchestration plus poussée, etc.). Hydra apporte l’automatisation complète, l’optimisation des coûts, le monitoring via l’Hydra Agent, et supporte aussi des scénarios Azure Local.

WVDAdmin est donc un choix pertinent si l’on veut éviter de déployer des ressources supplémentaires Azure comme celles nécessaires pour Hydra.

CritèreWVDAdminHydra
TypeOutil GUI localPlateforme SaaS
Autoscaling
Multi-tenantLimitéOui
CoûtGratuitPayant
Infrastructure supplémentaireNonOui

Est-ce que WVDAdmin est toujours maintenu ?

L’outil WVDAdmin existe maintenant depuis au moins 5 ans. WVDAdmin est toujours maintenu, mais n’est peut-être plus aussi activement développé comme avant (les efforts d’amélioration sont principalement concentrés sur Hydra).

Il reçoit encore des mises à jour, principalement pour prendre en compte les nouveaux SKUs Azure, corriger des bugs ou assurer la compatibilité avec certains changements d’API :

Quoi qu’on en dise, plusieurs dernières releases de WVDAdmin sont sorties en 2026, avec une dernière version publiée le 06/02/2026 :

Combien coûte WVDAdmin ?

Là encore nous pouvons lui dire merci, car WVDAdmin un outil licence-free pour Azure Virtual Desktop, utilisable sans frais supplémentaires pour l’administration des ressources AVD via une application Windows.

Comment WVD accède aux ressources du tenant ?

WVDAdmin accès aux ressources Azure par le biais d’un principal de service, protégé par un secret. Celui-ci dispose de permissions sur AVD et sur les ressources Azure. L

’objectif est notamment d’éviter toute confusion lorsque l’administrateur IT est un compte invité dans un tenant client et doit changer régulièrement de tenant.

Voici d’ailleurs un exemple de fonctionnement dans le cadre de plusieurs tenants :

Comment WVDInfra marche ?

Au travers de sa chaîne YouTube, Marcel a mis à disposition une playlist spécifiquement consacré à WVDInfra, de son installation à différentes qu’il peut faire sur votre environnement Azure Virtual Desktop :

Et enfin, comme toujours, je vous propose dans la suite de cet article d’effectuer ensemble un pas à pas pour couvrir l’installation de WVDInfra, sa mise en service, la capture d’une image Windows 11 custom et enfin la création d’une hôte dans un environnement AVD :

Etape 0 – Rappel des prérequis :

Pour réaliser ce test sur WVDInfra, il vous faudra disposer de :

  • Un abonnement Azure valide
  • Un tenant Microsoft

Commençons par l’installation de WVDInfra sur votre poste local.

Etape I – Installation de WVDInfra :

Utilisez la page officielle de WVDAdmin pour accéder au téléchargement :

Lancez l’installation en spécifiant le contexte d’utilisation de celle-ci, puis cliquez sur Suivant :

Acceptez les termes et conditions, puis cliquez sur Suivant :

Cliquez sur Suivant pour démarrer l’installation :

Une fois l’installation réussie, cliquez ici pour fermer :

Cliquez sur WVDAdmin présent dans dans le menu Démarrer :

WVDAdmin se charge et n’affiche pour le moment aucune ressource ou information de l’environnement Azure :

Pour cela WVDInfra vous demande les informations suivantes sur l’onglet « Welcome » :

  • l’ID de tenant
  • le secret client
  • l’ID client du principal de service

Mais avant d’aller plus loin, il est nécessaire de configurer ce nouveau principal de service sur votre tenant afin de donner à WVDInfra un moyen de s’y authentifier :

Etape II – Configuration Entra :

La création du principal de service via le centre d’administration Entra :

Nommez votre application, puis cliquez ici :

Pour permettre la résolution des utilisateurs et groupes, des permissions doivent être rajoutées :

Cherchez la permission suivante, puis cliquez sur Ajouter :

WVDInfra a besoin d’un consentement administration afin d’accorder les permissions demandées au nom de toute l’organisation :

Vérifiez le changement de statut des permissions :

Le client secret est l’équivalent d’un mot de passe pour l’application. Il sert à authentifier l’application lorsqu’elle demande un token OAuth à Microsoft Entra ID. Ajoutez un secret à votre application WVDInfra :

Copiez la valeur de votre secret immédiatement lors de sa création, car il ne sera plus affiché par la suite :

L’ID d’application (client) et l’ID du tenant doivent être conservés pour la suite :

Collez ces trois valeurs dans l’interface de WVDInfra, sauvegardez, puis lancez un rechargement de l’inventaire :

A ce stade, WVDInfra a bien accès au tenant mais pas encore au ressource Azure :

En l’état, l’application WVDInfra a le service principal, avec qui il peut s’authentifier avec son client ID et son secret, mais n’a par défaut aucun droit sur les ressources Azure. Il peut demander un token, mais ce token ne lui permet rien tant qu’on ne lui attribue pas un rôle RBAC.

Etape III – Configuration Azure :

WVD infra doit modifier des ressources Azure. Et attribuer un rôle RBAC au service principal WVDInfra revient à dire : “Cette application a le droit de faire telle action, sur tel périmètre.”

Pour cela, configurez avec le rôle RBAC de Contributeur sur l’application WVDInfra :

Sur WVDInfra, relancez un rechargement afin de voir apparaître l’inventaire des groupes de ressources et des VMs :

Etape IV – Test de capture d’une VM :

Microsoft recommande que tous les hôtes de session d’un pool soient issus de la même image afin de garantir une expérience utilisateur cohérente. WVDAdmin positionne l’imagerie comme une fonctionnalité centrale : création d’images à partir d’un golden master sans détruire la VM source.

Créez une machine virtuelle Azure :

Créez également une galerie d’images :

Sur WVDInfra, lancez la création d’image depuis votre machine virtuelle :

Les journaux de WVDInfra commence par montrer la création de ressources Azure temporaires (snapshot, VM temporaire, disque temporaire) :

Par la suite, les journaux de WVDInfra montre la généralisation de l’image, la création de la version dans la galerie :

Enfin, les journaux de WVDInfra montre le nettoyage complet des ressources Azure temporaires :

En quelques clics, nous avons une image prête à être déployée sur votre environnement Azure Virtual Desktop. La suite des étapes se fait toujours dans WVDInfra.

Etape V – Test de création d’un hôte :

Avant cela, créez les objets AVD de base (pools d’hôtes, groupes d’applications, espaces de travail) :

Retournez sur WVDInfra, sélectionnez la version d’image, puis lancez le processus de création d’hôtes AVD :

Renseignez le formulaire de déploiement :

  • le nommage des VM,
  • le nombre d’hôtes,
  • la version d’image,
  • le pool d’hôtes,
  • le sous-réseau,
  • les paramètres de disque,
  • la taille des VM,
  • les options de jointure Entra / Intune.

Puis lancez la création des machines virtuelle AVD :

Les journaux confirment la création de la VM et de son intégration au pool d’hôtes :

Constatez sur le portail Azure la création de ressources :

Votre pool d’hôtes affiche la nouvelle capacité disponible :

Dams mon cas, l’hôte de session apparait comme appareil joint à Entra ID :

Cette hôte de session est également enrôlés dans Intune :

Un test en session (nom de machine, version de l’OS, application installée) valide le bon fonctionnement :

Etape VI – Fonctionnalités annexes :

WVDAdmin couvre également beaucoup d’opérations IT sur les machines virtuelles Azure :

  • démarrage, arrêt, redémarrage, hibernation
  • changement de taille de la VM

Certains actions particulières, comme l’exécution de scripts, sont possibles :

Ou encore la création de snapshot ou le redimensionnement de disque OS :

D’autres sont propres aux machines virtuelles AVD :

  • gestion du mode drain
  • actions sur les sessions
  • suppression complète de l’hôte

Il permet aussi de modifier les affectations se font au niveau des groupes d’applications :

La gestion des applications publiées aussi possible :

Mon avis personnel

Je vais être clair. WVDAdmin n’est pas un remplacement du portail d’Azure Virtual Desktop.
Ce n’est pas non plus une solution d’architecture d’entreprise complète. C’est un accélérateur opérationnel.

Et dans certains un contextes, WVDAdmin est redoutablement efficace :

  • Lab
  • PoC
  • Environnement SMB
  • Client où l’on veut éviter de déployer une surcouche d’automatisation complète
  • Équipe IT réduite

La capture d’image est propre, le déploiement est rapide, L’interface centralise ce que le portail disperse. Besoin de plus ? Hydra for AVD sera peut être votre réponse.

Conclusion

Azure Virtual Desktop continue de se moderniser, les outils natifs progressent et l’automatisation devient centrale.

Mais entre la théorie et le terrain, il y a toujours l’opérationnel quotidien. WVDAdmin n’a jamais prétendu pas transformer votre architecture, mais il simplifie votre quotidien. Il évite les allers-retours dans le portail, réduit la friction et accélère les tâches répétitives.

Dans un monde où l’on parle beaucoup d’IA, d’automatisation avancée et de plateforme complexe, parfois un bon outil bien conçu fait simplement gagner du temps.

Et en tant qu’architecte AVD, je préfère toujours une solution claire, maîtrisée et comprise, plutôt qu’une sur-ingénierie inutile.

WVDAdmin ne remplace pas une stratégie, il optimise l’exécution. Et ça, pour un admin AVD, ça a énormément de valeur.

Tests du disque OS éphémère NVMe

Je voulais vérifier un point : un disque OS éphémère (Ephemeral OS Disk) peut être placé sur Temp, NVMe ou Cache selon la série de votre VM. La documentation Microsoft indique que l’option de placement ne change pas la performance ni le coût de l’Ephemeral OS Disk, car la perf dépend du stockage local disponible sur le SKU.

Dans la vraie vie (et dans mes chiffres) : même si les trois restent “OS + éphémère”, le placement change le chemin I/O réel, et donc le comportement sous pression : la différence la plus visible n’est pas toujours l’IOPS moyen, mais la distribution de latence (p95/p99/p99.9) et la stabilité en charge soutenue.

Plusieurs articles ont déjà été écrits sur les performances de stockages Azure :

Et pour vous guider plus facilement dans cet article très (trop?) long, voici des liens rapides :

Mais avant d’aller directement dans les tests, prenons le temps de parcourir ensemble quelques notions concernant le stockage temporaire local attaché une machine virtuelle.

Qu’est-ce qu’un stockage temporaire local ?

Certaines tailles de machine virtuelle Azure incluent un stockage local temporaire éphémère, certaines des tailles les plus récentes utilisant des disques NVMe locaux temporaires.

Le stockage temporaire local utilise des disques supplémentaires approvisionnés directement en tant que stockage local sur un hôte de machine virtuelle Azure, plutôt que sur le stockage Azure distant. Ce type de stockage convient le mieux aux données qui n’ont pas besoin d’être conservées définitivement, telles que les caches, les mémoires tampons et les fichiers temporaires. 

Microsoft Learn

Le disque temporaire (souvent D: sous Windows) est un disque local éphémère classique : les données sont potentiellement perdues en si maintenance/redeploy/deallocate. Un disque OS éphémère peut être placé dessus (Temp placement, NVMe, ou sur le cache disk) selon le SKU de la machine virtuelle :

Étant donné que les données stockées sur ces disques ne sont pas sauvegardées, elles sont perdues lorsque la machine virtuelle est libérée ou supprimée. Le stockage éphémère est recréé au démarrage. Les disques éphémères locaux sont différents des disques de système d’exploitation éphémères.

Microsoft Learn

Qu’est-ce qu’un disque OS éphémère ?

Un disque OS éphémère est un disque système stocké localement sur l’hôte Azure, et non sur un stockage distant Azure Storage. Le point le plus important est que celui-ci est non persistant : en cas de redéploiement, de recréation, le disque OS éphémère revient toujours à l’image de départ.

Les disques de système d’exploitation éphémères sont créés sur le stockage local de la machine virtuelle (VM) et ne sont pas enregistrés dans le Stockage Azure à distance.

Microsoft Learn

Pourquoi utiliser un disque OS éphémère ?

Le premier avantage concerne le prix : On ne paye pas le volume de stockage du disque éphémère. Celui-ci est intégré au prix de la machine virtuelle. De plus, les performances sont bien meilleures que la plupart des disques :

Les disques OS éphémères conviennent parfaitement aux charges de travail sans état, dans lesquelles les applications tolèrent les pannes de machines virtuelles individuelles tout en restant sensibles aux délais de mise en service ou à la réimagerie d’instances spécifiques.

Comparé à un disque de système d’exploitation standard, un disque éphémère offre une latence plus faible pour les opérations de lecture/écriture et permet une réinitialisation plus rapide des machines virtuelles.

Microsoft Learn

Pourquoi ne pas utiliser un disque OS éphémère ?

Comme annoncé plus haut, le disque OS éphémère ne doit pas contenir de la donnée critique. De plus, des fonctionnalités basiques ne sont pas disponibles :

  • Arrêt / Démarrage de la VM
  • Capture d’image VM
  • Captures instantanées de disque
  • Azure Disk Encryption
  • Échanges de disques système d’exploitation

Sur le portail Azure, certains menus sont tout simplement grisés pour ce type de VM :

Les fonctionnalités de sauvegarde et de reprise d’activité après sinistres sont elles aussi désactivés :

Comment savoir si le SKU de ma VM dispose d’un stockage temporaire local ?

La doc détaille trois placements possibles selon les VM :

  • NVMe Disk Placement (GA sur des séries récentes v6+)
  • Temp Disk / Resource Disk Placement
  • Cache Disk Placement

La nature et le volume du stockage temporaire local dépend en effet de la famille et du SKU de votre machine virtuelle :

Attention, certaines machines virtuelles n’ont tout simplement pas de stockage temporaire local :

Quid de la SLA d’une VM avec un disque OS éphémère ?

Le base disk influence l’engagement contractuel et certaines phases de provisioning, mais il ne modifie pas le chemin I/O steady-state de l’OS.

Depuis peu, Azure permet de choisir le type de “base disk” associé à un disque OS éphémère : Standard HDD, Standard SSD ou Premium SSD.

Attention cependant, ce “base disk” ne correspond pas au support physique sur lequel l’OS s’exécute.

Dans le cas d’un disque OS éphémère, le système fonctionne toujours sur le stockage local de l’hôte (NVMe / Temp / Cache selon le placement). Le type de base disk désigne le type de disque managé logique utilisé par Azure lors du provisioning et pour l’engagement contractuel.

La prise en charge SSD est une nouvelle option qui permet aux clients de choisir le type de disque principal utilisé pour le disque d’OS éphémère. Auparavant, le disque de base ne pouvait être qu’un HDD standard. À présent, les clients peuvent choisir entre les trois types de disques : HDD Standard (Standard_LRS), SSD Standard (StandardSSD_LRS) ou SSD Premium (Premium_LRS). En utilisant SSD avec disque de système d’exploitation éphémère, les clients peuvent bénéficier des améliorations suivantes :

  • Contrat SLA amélioré : les machines virtuelles créées avec SSD Premium fournissent un contrat SLA supérieur à celui des machines virtuelles créées avec hDD Standard. Les clients peuvent améliorer le contrat SLA pour leurs machines virtuelles éphémères en choisissant SSD Premium comme disque de base.

Microsoft Learn

Concrètement :

  • Le choix du base disk peut améliorer la SLA contractuelle de la VM.
  • Il peut également influer sur certaines phases spécifiques (provisioning, re-imaging, lectures liées au backing managed disk).
  • En revanche, il ne modifie pas les performances steady-state du stockage local sur lequel tourne réellement l’OS.

Autrement dit :

Choisir Premium SSD comme base disk améliore la SLA et certains scénarios liés au provisioning,
mais ne transforme pas un placement NVMe ou Temp en Premium SSD local.

Pourcentage de disponibilité (SSD Premium, SSD Premium v2 et Ultra Disk)Pourcentage de disponibilité (disque géré SSD standard)Pourcentage de disponibilité (disque géré HDD standard)Avoir Service
< 99,9 %< 99,5 %< 95 %10 %
< 99 %< 95 %< 92 %25 %
< 95 %< 90 %< 90 %100 %

Quid des performances d’une VM avec un disque OS éphémère ?

Les disques temporaires locaux ne sont pas comptabilisés par rapport aux IOPS et aux limites de débit de la machine virtuelle. De plus, Microsoft nous indique que les performances du disque OS éphémère dépendent de la machine et non du type de stockage local :

Le disque OS éphémère exploite le stockage local intégré à la machine virtuelle. Étant donné que différentes machines virtuelles ont différents types de stockage local (disque de cache, disque temporaire et disque NVMe), l’option de placement définit l’emplacement où le disque de système d’exploitation éphémère est stocké. Le choix du placement n’influence ni les performances ni le coût du disque OS éphémère. Ses performances reposent sur le stockage local de la machine virtuelle. Selon le type de machine virtuelle, trois modes de placement sont proposés.

  • Placement de disque NVMe (généralement disponible) : le type de placement de disque NVMe est désormais en disponibilité générale (GA) sur la dernière série de machines virtuelles v6 de la dernière génération, comme Dadsv6, Ddsv6, Dpdsv6, etc.
  • Placement de disque temporaire (également appelé Placement de disque de ressources) : le type de placement de disque temporaire est disponible sur les machines virtuelles avec un disque temp comme Dadsv5, Ddsv5, etc.
  • Emplacement du disque de cache : le type de placement du disque de cache est disponible sur les anciennes machines virtuelles qui avaient un disque de cache tel que Dsv2, Dsv3, etc.

Microsoft Learn

La performance théorique dépend du SKU, pas du placement. En revanche, comme chaque placement repose sur un support physique différent (NVMe, temp disk, cache disk), le comportement réel sous charge peut varier sensiblement.

Mais cette seconde partie de la documentation Microsoft m’intrigue quand même :

Amélioration des performances : en choisissant SSD Premium comme disque de base, les clients peuvent améliorer les performances de lecture du disque de leurs machines virtuelles. Bien que la plupart des écritures se produisent sur le disque temporaire local, certaines lectures sont effectuées à partir de disques managés. Les disques SSD Premium fournissent 8 à 10 fois plus d’IOPS que hDD Standard.

Microsoft Learn

J’ai créé plusieurs machines virtuelles avec le SKU Standard_D32ads_v7, dont voici les performances pour le stockage local :

Pourtant, les deux différents type de disque OS éphémère créés indiquent exactement les mêmes performances sur le portail Azure :

En extrapolant naïvement à partir de la capacité totale locale (440 Go x4), j’aurais pu m’attendre qu’en faisant un produit en croix basé sur la taille totale des 4 disques locaux attachés à ma VM, je m’attendais à trouver les performances suivantes sur mon disque OS éphémère :

  • IOPS max : 43296 IOPS
  • Bande passante max : 323 Mo/sec

Passons maintenant à l’approche utilisée pour mes tests.

Protocole de test que j’ai déployé :

  • Machines virtuelles Azure :

Pour éviter toute ambiguïté, les 4 VMs utilisent toutes un disque OS avec Windows Server 2022, mais sur des placements différents :

Nom de VMSKUType de disque OS
perftempStandard_D32ads_v5Ephemeral OS Disk – Temp placement
perfnvme-vmStandard_D32ads_v7Ephemeral OS Disk – NVMe placement
perfcacheStandard_D32ds_v4Ephemeral OS Disk – Cache placement
perfssdStandard_D32ads_v7OS Disk Premium SSD (référence)
  • Outils de mesure :

Plusieurs outils de mesures ont été utilisés afin de mieux comprendre les performances :

Nom de l’outilMesures effectuéesURL de téléchargement
fioIOPS (read/write), bande passante (MB/s), latence moyenne, percentiles (p95, p99), tests steady-state, profils personnalisés (4K, 64K, queue depth, etc.)https://github.com/axboe/fio
CrystalDiskMarkIOPS séquentiel et aléatoire, débit (MB/s), tests QD1/QD32, 4K/8K/1Mhttps://crystalmark.info/en/software/crystaldiskmark/
AS SSD BenchmarkIOPS 4K read/write, latence d’accès, score global (read/write/total), test copie (ISO, Program, Game), test incompressiblehttps://www.alex-is.de/PHP/fusion/downloads.php?cat_id=4

CrystalDiskMark – Smoke Test :

L’outil a été laissé dans sa configuration de base. Cela permet de provoquer :

  • Meilleur profit des caches (OS, contrôleur, stockage local, cache host)
  • Meilleur visu du burst (très bon pendant un court moment)
  • Ne force pas steady-state

Comme attendu, cela donne des chiffres parfois “spectaculaires”, notamment en lecture. Et c’est exactement le biais évoqué plus haut qui en ressort :

  • Tests courts
  • Pas de warm-up réel
  • Influence potentielle du cache

CrystalDiskMark confirme les tendances générales, mais ne permet pas de juger la stabilité sous charge soutenue.

AS SSD Benchmark – Latence & Incompressible :

AS SSD Benchmark va un peu plus loin que CrystalDiskMark et donne d’autres infos : Seq / 4K / 4K-64Thrd + “Acc.time”. Cela donne dans les résultats une meilleure visibilité des différences d’écriture, parfois très forts selon le disque.

AS SSD est connu pour être très sensible à :

  • la façon dont le chemin I/O gère les écritures (flush, cache, barrières)
  • la latence (et il la met en avant via “Acc.time”)
  • et la façon dont le driver/stack de stockage réagit

AS SSD peut donc apparaître comme plus sévère que CrystalDiskMark sur les écritures quand il tombe sur un scénario où le stockage/driver applique davantage de contraintes (flush/ordering).

Les tests faits via AS SSD nous apporte donc ici deux éléments intéressants :

  • Mesure directe de latence d’accès
  • Test incompressible (moins biaisé par cache/compression)

Dans notre cas, on peut donc en déduire que disque éphémère NVMe domine clairement en latence pure, que le disque éphémère temporaire reste très proche, que le disque éphémère cache montre une latence un peu plus élevée, et que le disque Premium SSD affiche la latence la plus importante.

Le score global reflète davantage l’expérience “ressentie” qu’un simple IOPS max.

fio – tests soutenus proches d’un workload :

Contrairement à CrystalDiskMark (smoke test court) et AS SSD (latence & incompressible), fio permet de :

  • contrôler précisément le pattern I/O
  • imposer une durée suffisante
  • forcer le bypass du cache OS (–direct=1)
  • introduire une phase de warm-up
  • mesurer les percentiles élevés (p95, p99, p99.9)

Autrement dit, fio mesure le comportement soutenu proche d’un workload réel.

Je suis passé par Chocolatey pour installer fio sur mes 4 machines virtuelles Azure grâce au script PowerShell suivant :

Set-ExecutionPolicy Bypass -Scope Process -Force

[System.Net.ServicePointManager]::SecurityProtocol = [System.Net.ServicePointManager]::SecurityProtocol -bor 3072
iex ((New-Object System.Net.WebClient).DownloadString('https://community.chocolatey.org/install.ps1'))

choco --version

choco install fio -y

fio --version

J’ai ensuite lancé le script fio suivant sur chacun des machines virtuelles pour générer et centraliser mes résultats sur un Azure file share. Dans ce script, fio teste :

  • Random 4K en montée de charge (sweep de queue depth QD1→64) en lecture/écriture
  • Un “peak” comparable : random 4K QD32, 8 jobs (lecture + écriture).
  • Un run plus long “steady-state” : random write 4K QD32, 8 jobs (soutenu).
  • Le coût de la durabilité/synchronisation : random write 4K QD1, 1 job, fsync=1.
  • Le débit séquentiel : read/write 1M, QD32, 4 jobs.
  • Et il fait un warmup au début.
# =========================
# FIO -> Z:\fio-results\ (NO subfolders)
# VM name only in OUTPUT (filename + header), not in folder structure
# Tests:
#  - Scaling (QD sweep) : randread4k / randwrite4k (for graphs, not for "max" headline)
#  - Peak controlled    : randread4k / randwrite4k @ QD32 NJ8 (reference "max comparable")
#  - Steady-state       : randwrite4k @ QD32 NJ8 (longer run)
#  - Sync durability    : randwrite4k QD1 NJ1 fsync=1
#  - Throughput         : seq read/write 1m @ QD32 NJ4
#
# Notes:
# - Uses --direct=1 (bypass OS cache)
# - Uses time_based + ramp_time (warm-up)
# - Emits a CSV summary you can aggregate across VMs
# =========================

param(
  [string]$OutDir   = "Z:\fio-results",
  [string]$Target   = "C:\fio_test.dat",   
  [string]$FileSize = "32G",               # Bigger => fewer cache illusions
  [int]   $Runtime  = 60,
  [int]   $RampTime = 10,
  [string]$FioExe   = "fio"                # Or full path: C:\fio\fio.exe
)

$VmName = $env:COMPUTERNAME

function Ensure-Dir {
  param([string]$Path)
  try {
    New-Item -ItemType Directory -Path $Path -Force | Out-Null
    return $true
  } catch {
    return $false
  }
}

# Prefer Z:\fio-results, fallback to C:\fio-results if Z: not available
if (-not (Ensure-Dir -Path $OutDir)) {
  $OutDir = "C:\fio-results"
  if (-not (Ensure-Dir -Path $OutDir)) {
    Write-Host "ERROR: Unable to create output directory (Z:\fio-results or C:\fio-results)." -ForegroundColor Red
    exit 1
  }
}

# Ensure fio exists
try { & $FioExe --version | Out-Null } catch {
  Write-Host "ERROR: fio not found. Put fio.exe in PATH or set -FioExe to its full path." -ForegroundColor Red
  exit 1
}

function Run-FioTest {
  param(
    [Parameter(Mandatory=$true)][string]$TestName,
    [Parameter(Mandatory=$true)][string]$TestType,
    [Parameter(Mandatory=$true)][string[]]$Args
  )

  $ts = Get-Date -Format "yyyyMMdd-HHmmss"
  $outFile = Join-Path $OutDir "$($VmName)_$($TestName)_$ts.txt"

  @(
    "VM: $VmName"
    "Date: $(Get-Date -Format 'yyyy-MM-dd HH:mm:ss')"
    "TestType: $TestType"
    "Test: $TestName"
    "Command: $FioExe $($Args -join ' ')"
    "----------------------------------------"
  ) | Out-File -FilePath $outFile -Encoding utf8

  & $FioExe @Args 2>&1 | Out-File -FilePath $outFile -Append -Encoding utf8
  return $outFile
}

function Parse-FioSummary {
  param(
    [Parameter(Mandatory=$true)][string]$FilePath,
    [Parameter(Mandatory=$true)][string]$TestType
  )

  $content = Get-Content $FilePath -Raw

  $readLine  = [regex]::Match($content, '^\s*read:\s*IOPS=([0-9\.]+[kKmM]?),\s*BW=([0-9\.]+[A-Za-z\/]+)', 'Multiline')
  $writeLine = [regex]::Match($content, '^\s*write:\s*IOPS=([0-9\.]+[kKmM]?),\s*BW=([0-9\.]+[A-Za-z\/]+)', 'Multiline')

  # fio prints percentiles when --percentile_list is used
    $p50  = [regex]::Match($content, '50\.00th=\[\s*([0-9]+)\]', 'Multiline')
    $p95  = [regex]::Match($content, '95\.00th=\[\s*([0-9]+)\]', 'Multiline')
    $p99  = [regex]::Match($content, '99\.00th=\[\s*([0-9]+)\]', 'Multiline')
    $p999 = [regex]::Match($content, '99\.90th=\[\s*([0-9]+)\]', 'Multiline')


  [PSCustomObject]@{
    VM         = $VmName
    TestType   = $TestType
    File       = Split-Path $FilePath -Leaf
    ReadIOPS   = if ($readLine.Success)  { $readLine.Groups[1].Value } else { "" }
    ReadBW     = if ($readLine.Success)  { $readLine.Groups[2].Value } else { "" }
    WriteIOPS  = if ($writeLine.Success) { $writeLine.Groups[1].Value } else { "" }
    WriteBW    = if ($writeLine.Success) { $writeLine.Groups[2].Value } else { "" }
    P50_usec   = if ($p50.Success)  { $p50.Groups[1].Value } else { "" }
    P95_usec   = if ($p95.Success)  { $p95.Groups[1].Value } else { "" }
    P99_usec   = if ($p99.Success)  { $p99.Groups[1].Value } else { "" }
    P999_usec  = if ($p999.Success) { $p999.Groups[1].Value } else { "" }
  }
}

# Common args (cache-light, more comparable)
$common = @(
  "--filename=$Target",
  "--size=$FileSize",
  "--direct=1",
  "--ioengine=windowsaio",
  "--runtime=$Runtime",
  "--ramp_time=$RampTime",
  "--time_based",
  "--group_reporting",
  "--thread",
  "--percentile_list=50:95:99:99.9"
)

$tests = @()

# ------------------------------------------------------------
# 0) Optional preconditioning (light warm-up) for consistency
# ------------------------------------------------------------
$tests += @{
  Type="warmup"
  Name="warmup_write1m_qd8_nj1_30s"
  Args=@(
    "--name=warmup",
    "--filename=$Target",
    "--size=$FileSize",
    "--direct=1",
    "--ioengine=windowsaio",
    "--bs=1m",
    "--iodepth=8",
    "--numjobs=1",
    "--rw=write",
    "--runtime=30",
    "--ramp_time=0",
    "--time_based",
    "--group_reporting",
    "--thread"
  )
}

# ------------------------------------------------------------
# 1) Scaling (QD sweep) - for graphs only
#    Keep it longer than micro-runs to reduce burst artifacts
# ------------------------------------------------------------
foreach ($qd in @(1,2,4,8,16,32,64)) {
  $tests += @{
    Type="scaling"
    Name="scaling_randread4k_qd$qd_nj8_90s"
    Args=@(
      "--name=rr_qd$qd",
      "--filename=$Target",
      "--size=$FileSize",
      "--direct=1",
      "--ioengine=windowsaio",
      "--bs=4k",
      "--iodepth=$qd",
      "--numjobs=8",
      "--rw=randread",
      "--runtime=90",
      "--ramp_time=15",
      "--time_based",
      "--group_reporting",
      "--thread",
      "--percentile_list=50:95:99:99.9"
    )
  }

  $tests += @{
    Type="scaling"
    Name="scaling_randwrite4k_qd$qd_nj8_90s"
    Args=@(
      "--name=rw_qd$qd",
      "--filename=$Target",
      "--size=$FileSize",
      "--direct=1",
      "--ioengine=windowsaio",
      "--bs=4k",
      "--iodepth=$qd",
      "--numjobs=8",
      "--rw=randwrite",
      "--runtime=90",
      "--ramp_time=15",
      "--time_based",
      "--group_reporting",
      "--thread",
      "--percentile_list=50:95:99:99.9"
    )
  }
}

# ------------------------------------------------------------
# 2) Peak controlled (reference values, comparable across disks)
# ------------------------------------------------------------
$tests += @{
  Type="peak"
  Name="peak_randread4k_qd32_nj8_120s"
  Args=@(
    "--name=peak_rr",
    "--filename=$Target",
    "--size=$FileSize",
    "--direct=1",
    "--ioengine=windowsaio",
    "--bs=4k",
    "--iodepth=32",
    "--numjobs=8",
    "--rw=randread",
    "--runtime=120",
    "--ramp_time=20",
    "--time_based",
    "--group_reporting",
    "--thread",
    "--percentile_list=50:95:99:99.9"
  )
}

$tests += @{
  Type="peak"
  Name="peak_randwrite4k_qd32_nj8_120s"
  Args=@(
    "--name=peak_rw",
    "--filename=$Target",
    "--size=$FileSize",
    "--direct=1",
    "--ioengine=windowsaio",
    "--bs=4k",
    "--iodepth=32",
    "--numjobs=8",
    "--rw=randwrite",
    "--runtime=120",
    "--ramp_time=20",
    "--time_based",
    "--group_reporting",
    "--thread",
    "--percentile_list=50:95:99:99.9"
  )
}

# ------------------------------------------------------------
# 3) Steady-state style (longer, to see sustained behavior)
# ------------------------------------------------------------
$tests += @{
  Type="steady"
  Name="steady_randwrite4k_qd32_nj8_180s"
  Args=@(
    "--name=steady_rw",
    "--filename=$Target",
    "--size=$FileSize",
    "--direct=1",
    "--ioengine=windowsaio",
    "--bs=4k",
    "--iodepth=32",
    "--numjobs=8",
    "--rw=randwrite",
    "--runtime=180",
    "--ramp_time=30",
    "--time_based",
    "--group_reporting",
    "--thread",
    "--percentile_list=50:95:99:99.9"
  )
}

# ------------------------------------------------------------
# 4) Sync durability penalty (OS-like durability semantics)
# ------------------------------------------------------------
$tests += @{
  Type="sync"
  Name="sync_randwrite4k_qd1_nj1_fsync1_60s"
  Args= $common + @(
    "--name=sync_rw",
    "--bs=4k",
    "--iodepth=1",
    "--numjobs=1",
    "--rw=randwrite",
    "--fsync=1"
  )
}

# ------------------------------------------------------------
# 5) Throughput (large blocks)
# ------------------------------------------------------------
$tests += @{
  Type="throughput"
  Name="seqread1m_qd32_nj4_60s"
  Args= $common + @(
    "--name=sr_1m",
    "--bs=1m",
    "--iodepth=32",
    "--numjobs=4",
    "--rw=read"
  )
}

$tests += @{
  Type="throughput"
  Name="seqwrite1m_qd32_nj4_60s"
  Args= $common + @(
    "--name=sw_1m",
    "--bs=1m",
    "--iodepth=32",
    "--numjobs=4",
    "--rw=write"
  )
}

# ------------------------------------------------------------
# Run + summary
# ------------------------------------------------------------
$results = @()

foreach ($t in $tests) {
  Write-Host "Running $($t.Type) / $($t.Name) ..." -ForegroundColor Cyan
  $file = Run-FioTest -TestName $t.Name -TestType $t.Type -Args $t.Args
  $results += Parse-FioSummary -FilePath $file -TestType $t.Type
}

$ts = Get-Date -Format "yyyyMMdd-HHmmss"
$summaryCsv = Join-Path $OutDir "fio_summary_$($VmName)_$ts.csv"
$summaryTxt = Join-Path $OutDir "fio_summary_$($VmName)_$ts.txt"

$results | Export-Csv -NoTypeInformation -Path $summaryCsv -Encoding UTF8
$results | Sort-Object TestType, File | Format-Table -AutoSize | Out-String | Out-File -FilePath $summaryTxt -Encoding utf8

Write-Host "Done. Outputs in: $OutDir" -ForegroundColor Green
Write-Host "Summary CSV: $summaryCsv" -ForegroundColor Green
Write-Host "Summary TXT: $summaryTxt" -ForegroundColor Green

Synthèse des résultats :

Cela nous donne les synthèses suivantes :

DiskPeak 4K ReadPeak 4K WriteSteady 4K WriteSeq ReadSeq WriteSync 4K Write
Temp (D32ads_v5)153k153k153k1951 MiB/s1950 MiB/s9.3k
Cache (D32ds_v4)98k93k94k1888 MiB/s1888 MiB/s7.9k
NVMe (D32ads_v7)146k60k60k1071 MiB/s536 MiB/s7.6k
Premium SSD10k4k3k152 MiB/s127 MiB/s507
DiskIOPSP50 (µs)P95 (µs)P99 (µs)P99.9 (µs)
Temp (D32ads_v5)153k212381523903
Cache (D32ds_v4)93k2694526281104
NVMe (D32ads_v7)60k2614376011048
Premium SSD4k40276110891827

Ce que peut en dire de ces tests :

Sur Temp, Cache et NVMe, on peut lire que Peak ≈ Steady. Cela signifie que :

  • Pas de burst artificiel
  • Pas d’effet cache court terme
  • Pas de chute après 30 secondes
  • Pas d’effondrement après warm-up

Le comportement observé est soutenu, et c’est extrêmement important, car beaucoup de benchmarks “rapides” montrent un pic initial qui s’effondre après 1 à 2 minutes.
Ici, ce n’est pas le cas.

  • NVMe vs Temp : contre-intuitif

Intuitivement, on pourrait penser que NVMe est supérieur à Temp. Or, en écriture 4K soutenue :

  • Temp : 153k IOPS
  • NVMe : 60k IOPS

Ce n’est pas un artefact. De plus : Peak = Steady sur NVMe Cela indique un plafond structurel, pas un effet transitoire. La performance dépend donc du chemin I/O exposé par le SKU, pas uniquement de la nature “NVMe” du support. C’est un point fondamental.

  • Premium SSD : changement de catégorie

Enfin, nous sommes dans un monde différent avec le premium ssd, En 4K write steady, le Premium SSD monte à 2 926 IOPS, avec un pique à 3500 IOPS. On n’est plus dans la même catégorie. Le disque managé respecte son cap IOPS contractuel :

Ce test montre très clairement la différence entre un stockage managé distant avec limite provisionnée et stockage local intégré au SKU.

Si un stockage persistant est nécessaire, à vous maintenant de voir quel disque correspondra mieux à vos besoins :

  • Pourquoi regarder p99/p99.9 et pas juste les IOPS ?

Microsoft documente les notions de limites cached/uncached et le fait qu’un workload peut être IO capped. Quand cela arrive :

  • Les IOPS plafonnent
  • La file d’attente sature
  • La latence augmente

Ton plateau write NVMe en 4K random (QD sweep) a exactement la signature d’une limite plateforme. Deux disques peuvent faire 100k IOPS :

  • L’un avec P99.9 à 10 ms
  • L’autre avec P99.9 à 50+ ms

Ils n’auront pas du tout la même sensation côté OS. Le P99.9 capture les moments où :

  • la queue est saturée
  • un flush bloque
  • un throttling intervient

C’est ce qui compte en production.

  • Comment le cache d’Azure nous trompe ?

Microsoft indique qu’un disque avec host caching peut temporairement dépasser la limite disque. Cela explique pourquoi :

  • CrystalDiskMark peut afficher des chiffres “incroyables”
  • Un bench court peut mesurer le cache plutôt que le support réel

Si un benchmark va “trop vite”, c’est souvent un cache. De plus :

  • Microsoft recommande un warm-up
  • Les cached reads atteignent leurs meilleurs chiffres après stabilisation

Le cache modifie donc la mesure. En write, ce n’est pas magique :

Quand le caching est en Read/Write, l’écriture doit être validée dans le cache et sur le disque.
Elle compte dans les limites cached et uncached. Le cache ne supprime pas la limite soutenue.

  • Pourquoi certains outils de mesure peuvent être trompeur lors de tests sur Azure ?

De ce fait, certains outils comme CrystalDiskMark, sont très bien pour un smoke test, mais :

  • Les durées courtes,
  • Les patterns,
  • et l’absence de phase de warm-up

font qu’ils mesurent souvent le cache, pas le support réel. Un chiffre « trop beau » est souvent… un cache.

  • La limite n’est pas le disque. C’est la VM :
VMvCPUPeak 4K ReadPeak 4K WriteSteady 4K WriteP99 Write (µs)P99.9 Write (µs)
D32ads_v732~146k~60k~60k~601~1048
D64ads_v764~291k~120k~120k~580~1010
VMSeq ReadSeq Write
D32ads_v7~1071 MiB/s~536 MiB/s
D64ads_v7~2144 MiB/s~1067 MiB/s

Ces nouveaux tests montrent un comportement très clair :

  • NVMe en D32 plafonne à ~60k IOPS write
  • Le même NVMe en D64 monte à ~120k IOPS
  • La latence reste comparable

Le support physique n’a pas changé. Le workload n’a pas changé. Le placement n’a pas changé.Ce qui a changé : le SKU, cela démontre que Le plafond de performance est imposé par la capacité I/O exposée par la VM, pas par le média NVMe lui-même.

Autrement dit, le NVMe ne “donne” pas 60k IOPS, la VM D32 expose 60k IOPS.

Mais attention, les chiffres donnés dans la documentation Microsoft décrivent le potentiel maximal du stockage local temporaire de la VM (souvent agrégé sur plusieurs disques). Un disque OS éphémère ‘NVMe placement’ n’est pas automatiquement équivalent à ce chemin I/O, et un test ‘fichier’ ajoute un overhead. On compare donc des plafonds de nature différente.

  • Pourquoi les tests “fsync=1” ne prouvent pas la durabilité ?

fsync=1 mesure le coût d’un flush côté OS, mais ne prouve pas la persistance réelle sur le média ou la résistance à un crash hôte. fio indique qu’en non-buffered I/O, il peut ne pas sync comme attendu :

  • fsync=1 force un flush côté OS
  • mais ça ne valide pas une persistance réelle côté hyperviseur / host
  • ce n’est pas un test de crash-consistency

Donc si tu veux un “durability test”, il faut une variante (ex : buffered ou job dédié) et mesurer la phase sync séparément.

Conclusion

Si je résume :

  • Les trois disques OS éphémères surpassent le Premium SSD managé
  • NVMe offre une latence très stable et évolue fortement avec le SKU
  • Temp placement reste le plus performant en écriture 4K soutenue dans ce test précis
  • Cache dépend davantage du comportement de file d’attente

Mais surtout, Microsoft a raison : la performance dépend du stockage local. Mais ce que la documentation ne met pas en avant, c’est que le stockage local n’est pas homogène selon le placement. Et c’est là que tout se joue :

  • Les différences ne sont pas toujours visibles sur l’IOPS moyen. Elles apparaissent dans les percentiles élevés (p99/p99.9)
  • C’est exactement ce que Microsoft ne détaille pas explicitement : la performance dépend du stockage local… mais le stockage local n’a pas la même nature physique selon le placement

D’un point de vue technique :

  1. Le placement ne change pas le coût
  2. Le placement ne change pas la “promesse marketing”
  3. Mais le placement change le chemin I/O réel

Et donc, en fonction de la charge de travail :

  • Pour une charge de travail sensible à la latence (SQL temporaire, build intensif, traitement parallèle), le NVMe placement est clairement le plus intéressant.
  • Pour des workloads stateless classiques, Temp reste un excellent compromis.
  • Le Cache placement, sur des générations plus anciennes, reste viable mais moins moderne.
  • Enfin, un Premium SSD managé reste plus simple opérationnellement, mais il est largement dépassé en performance pure par le stockage local éphémère.

Créez des alertes Advisor pour vos instances réservées Azure

Les services de calcul représentent souvent l’essentiel des coûts sur Azure. Pour les charges de travail qui fonctionnent en continu, les instances réservées apportent une réduction notable des tarifs à la carte. En s’engageant sur une durée d’un ou trois ans, il est possible de réaliser jusqu’à grosses économies par rapport au modèle pay‑as‑you‑go. Mais est-on alerté quand ces réductions sont disponibles pour notre environnement Azure, ou qu’elles expirent ?

Dans cet article, nous revenons sur le fonctionnement des instances réservées, leur gestion (notamment le renouvellement automatique) et sur la création d’alertes Azure Advisor pour être notifié lorsqu’une réservation devient pertinente ou expire.

Qu’est-ce qu’une instance réservée Azure ?

Une instance réservée est un engagement de capacité : vous acceptez d’utiliser un type d’instance ou une famille d’instances dans une région spécifique pendant une durée déterminée, en échange d’un prix réduit. Les réservations s’achètent pour un an ou trois ans :

Quand acheter une réservation ?

Les instances réservées sont particulièrement adaptées aux charges stables et prévisibles. La documentation Microsoft recommande d’opter pour une réservation lorsque vous prévoyez d’utiliser le même type d’instance ou la même famille dans une région donnée pendant toute la durée de l’engagement.

À l’inverse, si vos applications changent fréquemment de configuration ou de région, les savings plans peuvent être plus appropriés car ils s’appliquent à un montant horaire sur plusieurs services et régions. Néanmoins, une instance réservée reste l’option la plus économique lorsque son utilisation est maximale.

Que doit-on faire pour appliquer la remise ?

Une fois la réservation achetée, la remise est appliquée automatiquement aux machines virtuelles, SQL Database, Cosmos DB ou d’autres services éligibles qui correspondent aux attributs choisis (SKU, région, étendue).

Les réservations n’affectent pas l’état d’exécution des ressources : si une machine est mise à l’arrêt ou redimensionnée, le rabais se reporte sur une autre ressource compatible, sinon la portion inutilisée est perdue :

Quid d’une machine virtuelle dont la taille varie ?

Une instance réservée s’applique sur une famille de machines virtuelles : même si le SKU d’une RI correspond à un SKU spécifique d’une VM, il peut s’appliquer à d’autres tailles d’une même famille via un ratio :

Le tableau ci-dessus affiche des instances réservées pour des machines virtuelles. Comment fonctionne une instance réservée ? Il faut simplement voir celle-ci comme une place de parking, louée pour un ou trois ans chez Microsoft :

Il est donc possible d’optimiser votre réservation pour la flexibilité de taille. Dans ce mode, la remise s’applique à toutes les tailles d’instances d’un même groupe. Par exemple, une réservation achetée pour une instance de la série DSv2 (par exemple Standard_DS3_v2) peut s’appliquer aux autres tailles de ce groupe : Standard_DS1_v2, Standard_DS2_v2, Standard_DS3_v2 et Standard_DS4_v2

Quid de la durée et la fréquence de paiement ?

Le choix de la durée dépend de la stabilité de votre charge. Les engagements d’un an offrent plus de flexibilité tandis que les engagements de trois ans maximisent les économies. Vous pouvez régler la réservation en une seule fois ou mensuellement ; le coût total reste identique et aucune pénalité n’est appliquée en cas de paiement échelonné, sauf le taux de change qui varie dans le temps :

Qu’est-ce qui n’est pas couvert par la RI ?

La remise porte uniquement sur les coûts de calcul. Pour les machines virtuelles, elle concerne les cœurs et la mémoire mais ne couvre pas les licences Windows ni les frais de stockage, réseau ou logiciels.

Les licences peuvent être prises en charge via l’Azure Hybrid Benefit, et les autres coûts sont facturés séparément. En revanche, de nombreux services Azure disposent de capacités réservées pour réduire leurs propres coûts de calcul.

Qu’est-ce qu’Azure Hybrid Benefit ?

Azure Hybrid Benefit est un avantage en matière de licences qui vous permet de réduire considérablement les coûts d’exécution de vos charges de travail dans le cloud. Son fonctionnement consiste à vous autoriser à utiliser vos licences Windows Server et SQL Server compatibles sur Azure.

Il est donc possible d’acheter des licences en souscriptions annuelles ou pluriannuelles. Les économies représentent des sommes non négligeables.

Cet avantage permet donc d’utiliser les licences Windows Server ou SQL Server existantes éligibles, et ainsi de ne payer que le tarif de base des machines virtuelles.

Que se passe-t-il à la fin du contrat de la RI ?

Lorsque vous achetez une réservation, le renouvellement automatique est souvent activé par défaut. Cette fonction permet de racheter automatiquement une réservation équivalente à l’expiration de la précédente, afin de continuer à bénéficier de la remise sans surveillance quotidienne.

Vous pouvez activer ou désactiver cette option à tout moment dans le portail Azure. Le prix du renouvellement est disponible 30 jours avant la date d’expiration. Si la réservation n’est pas renouvelée, vos ressources continuent de fonctionner, mais elles repassent en facturation à l’usage.

Peut-on annuler une instance réservée en cours d’engagement ?

Oui, Microsoft permet l’annulation d’une RI pendant sa durée d’engagement, sous conditions :

  • Les remboursements sont calculés en fonction du prix le plus bas de votre prix d’achat ou du prix actuel de la réservation.
  • Nous ne facturons actuellement aucun frais de résiliation anticipée, mais des frais de résiliation anticipée de 12 % pourraient s’appliquer à l’avenir en cas d’annulation.
  • L’engagement total annulé ne peut pas dépasser 50 000 USD dans une période de 12 mois pour un profil de facturation ou une inscription unique.

Microsoft Learn

Voici un exemple donné par Microsoft :

Lorsqu’une réservation est échangée ou annulée, le remboursement est calculé en fonction du nombre de jours restants dans la période de réservation. Le calcul est effectué au format UTC et utilise une formule cohérente pour garantir l’équité et la transparence.

Par exemple, si vous avez acheté une réservation le 10 juillet 2024 et que vous l’avez échangée le 9 juillet 2025, seulement 1 jour reste dans la réservation. Vous recevrez un petit remboursement pour ce seul jour.

Instances réservées vs. Savings Plan ?

Bien que les savings plans partagent l’objectif de réduire les coûts, ils fonctionnent différemment. Une instance réservée vous engage sur un type ou une famille d’instances dans une région donnée et vous apporte la remise la plus élevée lorsque vos machines fonctionnent en continu.

À l’inverse, un savings plan fixe un montant horaire applicable sur plusieurs services de calcul et dans toutes les régions. Cette flexibilité est utile pour les charges de travail qui évoluent et qui se déplacent entre régions, mais les économies sont généralement moindres que celles d’une instance réservée utilisée à 100 %.

Dans la majorité des cas, un utilisateur qui connaît ses besoins à moyen terme gagnera à privilégier la réservation et à activer le savings plan seulement pour les charges variables.

Qu’est-ce qu’Azure Advisor ?

Azure Advisor est un assistant cloud personnalisé qui analyse en continu ta configuration Azure et ton usage pour te fournir des recommandations proactives afin d’optimiser :

  • la fiabilité
  • la sécurité
  • la performance
  • les coûts
  • l’excellence opérationnelle

Peut-on y créer des alertes concernant le besoin de RI ?

Comme montré dans une copie d’écran plus haut, Azure Advisor affiche des conseils sur les économies financières possibles sur votre infrastructure Azure. Ces conseils portent également sur l’achat d’instances réservées pour vos services de calcul.

Azure Advisor analyse l’utilisation de vos ressources et émet donc des recommandations lorsqu’il détecte des économies potentielles.

Lorsque Advisor identifie une nouvelle recommandation (par exemple l’achat d’une instance réservée), un événement est enregistré dans le journal d’activité. Il est possible de déclencher une alerte à chaque nouvelle recommandation afin d’être averti par courriel ou via un webhook :

Comme vous pouvez le voir, j’ai créé cette nouvelle alerte sur le type de recommandation suivant :

Consider virtual machine reserved instance to save over the on-demand costs

Comme les alertes configurées dans Azure Monitor, un groupe d’action peut y être affecté :

Une fois l’alerte en place, chaque nouvelle recommandation Advisor se traduira par une notification. Cela vous permet d’acheter les réservations appropriées dès qu’elles sont pertinentes et de réagir lorsque l’une d’elles arrive à expiration.

Ayant configuré une adresse email sur ce groupe d’action, et une fois l’alerte déclenchée, l’email suivant me parvient :

Un clic sur le lien présent dans l’email nous affiche la recommandation concernée dans le portail Azure :

Il ne me reste plus alors qu’à acheter, ou racheter, l’instance réservée appropriée 😎

Conclusion

La maîtrise des coûts est un volet essentiel de l’architecture cloud. En engageant vos ressources sur une durée ferme, les instances réservées vous permettent de réduire significativement vos dépenses tout en conservant la flexibilité de changer de taille ou d’échanger votre réservation en cas d’évolution de vos besoins.

Les fonctionnalités de renouvellement automatique garantissent la continuité des remises, et les alertes Azure Advisor vous aident à prendre les bonnes décisions au bon moment. En combinant analyse de l’utilisation (Advisor), estimation des coûts (calculateur de tarification) et stratégie d’engagement, vous disposez de tous les outils pour optimiser votre facture Azure.

Azure Disk Encryption / Encryption at Host / SSE

Le chiffrement des disques Azure existe depuis longtemps, mais il reste souvent mal compris : SSE, Encryption at Host, ADE… tout ne fonctionne pas au même niveau, et tout n’a pas le même impact. Je vous propose ici un tour d’horizon concret : explications, tests de performance et retour d’expérience sur la migration depuis Azure Disk Encryption.

Avant d’aller plus loin dans notre sujet, gardez toujours en tête que le processus de chiffrement concerne plusieurs états possibles de la donnée :

Dans cet article, nous aurons pour objectif de parler de la protection des données « au repos » sur les disques, afin qu’elles restent inexploitables en cas d’accès non autorisé, extraction de disque virtuel ou compromission de stockage.

Vue d’ensemble des options de chiffrement des disques de VM :

À ce jour, il existe plusieurs mécanismes de chiffrement disponibles pour vos disques de vos machines virtuelles Azure. Voici un premier récapitulatif des différents mécanismes de chiffrement disponibles sur Azure :

  • Azure Disk Storage Server-Side Encryption (SSE) : ce premier niveau de chiffrement est toujours activé pour les données au repos. Il chiffre automatiquement les données stockées sur les disques gérés Azure (disques OS et disques de données, à l’exception des disques temporaires et des caches disque).

Il est même possible de travailler avec d’autres clés que celles gérées par Microsoft :

  • Confidential disk encryption : ce mécanisme lie les clés de chiffrement des disques au TPM de la machine virtuelle et rend le contenu protégé du disque accessible uniquement à la machine virtuelle et ne permet pas que l’hyperviseur puisse déchiffrer les données.
  • Encryption at host : option au niveau de la machine virtuelle qui améliore le chiffrement côté serveur Azure Disk Storage afin de garantir que tous les disques temporaires et les caches disque sont chiffrés au repos et transférés chiffrés vers les clusters de stockage.
  • Azure Disk Encryption (ADE) : ce mécanisme chiffre le système d’exploitation et les disques de données des machines virtuelles Azure (VM) à l’intérieur de vos VM à l’aide de la fonctionnalité DM-Crypt de Linux ou de la fonctionnalité BitLocker de Windows. Azure Key Vault permet de contrôler et gérer les clés et les secrets de chiffrement de disque.

Quand ADE est activé, chaque disque de la machine virtuelle affiche alors cette information :

Une extension ADE est sur la machine virtuelle :

Est-ce que Azure Disk Encryption est déprécié ?

Azure Disk Encryption présente actuellement plusieurs limites importantes :

  • Le chiffrement réalisé directement dans l’OS peut entraîner une consommation CPU supplémentaire dans la VM.
  • ADE n’est pas compatible avec l’ensemble des types de disques ni toutes les distributions Linux.
  • Son intégration étroite avec l’OS et l’agent Azure le rend plus sensible et plus complexe à maintenir.

Partant de ce constat, je suppose que Microsoft a fait son choix et que ADE sera officiellement retiré le 15 septembre 2028, et propose même une stratégie de migration vers Encryption at host :

Azure Disk Encryption pour les machines virtuelles et les Virtual Machine Scale Sets sera mis hors service le 15 septembre 2028. Les nouveaux clients doivent utiliser le chiffrement sur l’hôte pour toutes les nouvelles machines virtuelles.

Les clients existants doivent planifier la migration des machines virtuelles ADE actuelles vers le chiffrement sur l’hôte avant la date de mise hors service pour éviter toute interruption de service.

Microsoft Learn

Qu’est-ce que Encryption at host ?

Encryption at Host est un mécanisme de chiffrement fourni par la plateforme Microsoft Azure permettant de chiffrer les disques de machines virtuelles au niveau de l’hôte (l’hyperviseur), avant que les données ne soient écrites sur le stockage.

Plutôt que de chiffrer les disques directement dans la machine virtuelle via BitLocker ou DM-Crypt, ce mode déplace le chiffrement sur l’hyperviseur Azure lui-même.

Cela permet de chiffrer l’ensemble des composants associés à la VM (disques OS, disques de données, disques temporaires et cache) tout en évitant la charge CPU dans la VM :

Quelles sont les restrictions liées à cette migration ?

Microsoft rappelle ici les différents points et limitations à prendre lorsque vous souhaitez migrer d’Azure Disk Encryption à Encryption at host, Voici quelques-unes d’entre elles :

  • Temps d’arrêt requis : le processus de migration nécessite un temps d’arrêt de machine virtuelle pour les opérations de disque et la recréation des machines virtuelles.
  • Aucune migration sur place : vous ne pouvez pas convertir directement des disques chiffrés par ADE en chiffrement sur l’hôte. La migration nécessite la création de disques et de machines virtuelles.
  • Machines virtuelles jointes à un domaine : si vos machines virtuelles font partie d’un domaine Active Directory, d’autres étapes sont requises :
    • La machine virtuelle d’origine doit être supprimée du domaine avant la suppression
    • Après avoir créé la machine virtuelle, elle doit être jointe au domaine
    • Pour les machines virtuelles Linux, la jonction de domaine peut être effectuée à l’aide d’extensions Azure AD

Commençons par un rappel des prérequis.

Etape 0 – Rappel des prérequis :

Pour réaliser cet exercice sur les différentes méthodes de chiffrements, il faut disposer de :

  • Un tenant Microsoft
  • Une souscription Azure valide

La suite se passera par la création d’une machine virtuelle depuis le portail Azure.

Etape I – Création de la machine virtuelle Azure :

Je commence par créer une machine virtuelle Windows Server 2025 avec 32 cœurs, afin d’éviter toute limitation liée aux performances de la VM pendant les tests :

Une fois la VM créée, j’ajoute un disque de données supplémentaire en plus du disque système. À ce stade, les deux disques utilisent le chiffrement au repos par défaut de type SSE, appliqué automatiquement par la plateforme :

Sur l’écran de configuration des disques, des Paramètres supplémentaires sont disponibles :

Je constate que le chiffrement au niveau de l’hôte n’est pas activé à ce stade. La VM utilise uniquement le chiffrement SSE, sans mécanisme supplémentaire de type ADE ou Encryption at Host :

Je me connecte à la machine virtuelle via Azure Bastion :

Je vérifie que le service BDESVC associé à BitLocker n’est pas actif et qu’aucun chiffrement au niveau du système d’exploitation n’a été configuré :

Get-Service BDESVC
manage-bde -status

Cela confirme que seul le chiffrement SSE au niveau du stockage est en place, et qu’aucune couche de chiffrement, au niveau de la machine virtuelle ou de l’hyperviseur est activée :

Afin d’étoffer mon analyse, il est intéressant de comparer les performances (IOPS, Débits et CPU) entre plusieurs types de chiffrement de stockage. Pour cela j’utiliserai l’outil de mesure Diskspd et les métriques disponibles sur le portail Azure.

Etape II – Installation de l’outil de mesure Diskspd :

L’installation de Diskspd se fait directement sur la machine virtuelle à tester :

DISKSPD est un outil que vous pouvez personnaliser pour créer vos propres charges de travail synthétiques. Nous utiliserons la même configuration que celle décrite ci-dessus pour exécuter des tests d’évaluation. Vous pouvez modifier les spécifications pour tester différentes charges de travail.

Microsoft Learn

Microsoft recommande d’utiliser l’utilitaire DiskSpd pour générer une charge sur un système de disques (stockage) et … pour mesurer les performances du stockage et obtenir la vitesse maximale disponible en lecture/écriture et les IOPS du serveur spécifique.

Windows OS Hub

Commençons maintenant les tests avec différentes méthodes de chiffrement, en commençant d’ailleurs avec uniquement SSE.

Etape III – Tests de performance avec le chiffrement au repos SSE :

Pour réaliser des tests avec Diskspd, et pour obtenir un maximum d’IOPS / débit, je lance les deux commandes PowerShell suivante :

C:\DiskSpd\amd64\diskspd.exe -d900 -r -w100 -F4 -o128 -b8K -Sh -L -c50G E:\diskpsdtmp.dat > IOPS-PremiumSSDv2-0encryption.txt

C:\DiskSpd\amd64\diskspd.exe -d900 -r -w100 -F4 -o128 -b64K -Sh -L -c50G E:\diskpsdtmp.dat > Throughput-PremiumSSDv2-0encryption.txt

J’ouvre Task Manager afin d’observer en temps réel l’activité du disque :

Je surveille l’utilisation CPU de la VM depuis le portail Azure :

Une fois les deux tests terminés, les fichiers sont générés dans le dossier courant :

  • le premier fichier TXT généré est pour consigner les IOPS :
  • Le second fichier TXT est généré pour consigner les débits :

Continuons les tests de performances avec Encryption at host d’activé.

Etape IV – Tests de performance avec Encryption at host :

Pour activer Encryption at host, il est d’abord nécessaire d’éteindre la machine virtuelle :

Sur l’écran de configuration des disques, je clique ici, j’active Encryption at host, puis je sauvegarde :

Une fois la modification appliquée, je redémarre la machine virtuelle :

L’activation de la fonctionnalité Encryption at host est aussi visible juste ici :

Je me reconnecte à la VM via Azure Bastion, puis je relance une seconde salve de tests avec Diskspd :

C:\DiskSpd\amd64\diskspd.exe -d900 -r -w100 -F4 -o128 -b8K -Sh -L -c50G E:\diskpsdtmp.dat > IOPS-PremiumSSDv2-encryptionathost.txt

C:\DiskSpd\amd64\diskspd.exe -d900 -r -w100 -F4 -o128 -b64K -Sh -L -c50G E:\diskpsdtmp.dat > Throughput-PremiumSSDv2-encryptionathost.txt

J’ouvre Task Manager afin d’observer en temps réel l’activité du disque :

Je surveille l’utilisation CPU de la VM depuis le portail Azure :

Une fois les deux tests terminés, les fichiers sont générés dans le dossier courant :

  • le premier fichier TXT généré est pour consigner les résultats IOPS :
  • Le second fichier TXT est généré pour consigner les résultats débits :

Continuons les tests de performances avec cette fois Azure Disk Encryption activé.

Etape V – Tests de performance avec Azure Disk Encryption :

Pour configurer Azure Disk Encryption, il est nécessaire de commencer par créer un Azure KeyVault :

Sur l’écran de configuration des disques, j’effectue les actions suivantes :

  • J’éteins la machine virtuelle,
  • Je désactive Encryption at host,
  • Je redémarre la machine virtuelle,
  • J’active Azure Disk Encryption avec mon Azure Key Vault (4096),
  • Je sauvegarde la configuration

Azure lance alors le déploiement automatique d’ADE :

Une extension s’installe alors sur la machine virtuelle :

Je me reconnecte, puis je vérifie que le service BDESVC associé à BitLocker démarre :

Get-Service BDESVC
manage-bde -status

Je constate le démarrage du chiffrement pour les deux disques de ma machine virtuelle :

Quelques minutes plus tard, le chiffrement est terminé :

Je constate l’apparition de la mention ADE sur le disque OS :

Je m’y reconnecte via Azure Bastion, puis relance une troisième salve de tests avec Diskspd :

C:\DiskSpd\amd64\diskspd.exe -d900 -r -w100 -F4 -o128 -b8K -Sh -L -c50G E:\diskpsdtmp.dat > IOPS-PremiumSSDv2-ADEencryption.txt

C:\DiskSpd\amd64\diskspd.exe -d900 -r -w100 -F4 -o128 -b64K -Sh -L -c50G E:\diskpsdtmp.dat > Throughput-PremiumSSDv2-ADEencryption.txt

J’ouvre Task Manager afin d’observer en temps réel l’activité du disque :

Je surveille l’utilisation CPU de la VM depuis le portail Azure :

Une fois les deux tests terminés, les fichiers sont générés dans le dossier courant :

  • le premier fichier TXT généré est pour consigner les résultats IOPS :
  • Le second fichier TXT est généré pour consigner les résultats débits :

Etape VI – Comparaison des performances de chiffrement :

Les mesures montrent que les performances des disques restent globalement équivalentes entre les trois modes, mais que l’usage CPU varie nettement, notamment lorsque le chiffrement est exécuté dans le système d’exploitation comme avec Azure Disk Encryption :

Mode de chiffrementCPU moyen (%)
SSE (Storage Service Encryption)1.5 %
Encryption at Host1.0 %
ADE (Azure Disk Encryption)2.8 %
  • SSE et Encryption at Host ont un impact CPU faible et comparable.
  • ADE présente une charge CPU sensiblement supérieure, liée au chiffrement effectué par BitLocker dans la VM, ce qui correspond à l’architecture même de ce mode.

La surcharge induite par ADE reste faible, mais l’hétérogénéité des latences confirme qu’il reste plus sensible que les modes opérés directement par la plateforme.

Etape VII – Migration d’ADE vers Encryption at host :

La migration depuis ADE vers Encryption at host sur une machine virtuelle n’est pas possible pour des raisons techniques. Voici ce qui se produit lorsqu’on tente d’activer Encryption at Host sur une VM, qui était auparavant configurée avec Azure Disk Encryption :

Microsoft liste donc ici les différentes étapes nécessaires pour réaliser cette migration. Nous allons commencer par désactiver Azure Disk Encryption.

Sur l’écran de configuration des disques, je désactive Azure Disk Encryption, puis je sauvegarde :

Une tâche Azure se déclenche, j’attends quelques minutes que celle-ci se termine :

Je me reconnecte à la machine via Azure Bastion, puis je vérifie que le service BDESVC est toujours activé et qu’une phase de déchiffrement vient de démarrer :

Get-Service BDESVC
manage-bde -status

Quelques minutes plus tard, le déchiffrement est entièrement terminé :

Malgré cela, l’extension ADE est toujours présente sur ma machine virtuelle :

Je la désinstalle depuis le portail Azure :

Quelques minutes plus tard, la notification Azure suivante apparaît :

Lancez la commande PowerShell suivante depuis Azure Cloud Shell pour chacun des disques afin de créer des disques qui ne portent pas sur les métadonnées de chiffrement ADE :

Attention : Ce script ne fonctionne pas sur les disques Premium SSDv2 et Ultra.

# Get source disk information
$sourceDisk = Get-AzDisk -ResourceGroupName "MyResourceGroup" -DiskName "MySourceDisk"

# Create a new empty target disk
# For Windows OS disks
$diskConfig = New-AzDiskConfig -Location $sourceDisk.Location -CreateOption Upload -UploadSizeInBytes $($sourceDisk.DiskSizeBytes+512) -OsType Windows -HyperVGeneration "V2"

# For Linux OS disks (if not ADE-encrypted)
# $diskConfig = New-AzDiskConfig -Location $sourceDisk.Location -CreateOption Upload #   -UploadSizeInBytes $($sourceDisk.DiskSizeBytes+512) -OsType Linux #   -HyperVGeneration "V2"

# For data disks (no OS type needed)
# $diskConfig = New-AzDiskConfig -Location $sourceDisk.Location -CreateOption Upload #   -UploadSizeInBytes $($sourceDisk.DiskSizeBytes+512)

$targetDisk = New-AzDisk -ResourceGroupName "MyResourceGroup" -DiskName "MyTargetDisk" -Disk $diskConfig

# Generate SAS URIs and copy the data
# Get SAS URIs for both disks
$sourceSAS = Grant-AzDiskAccess -ResourceGroupName "MyResourceGroup" -DiskName $sourceDisk.Name -Access Read -DurationInSecond 7200
$targetSAS = Grant-AzDiskAccess -ResourceGroupName "MyResourceGroup" -DiskName $targetDisk.Name -Access Write -DurationInSecond 7200

# Copy the disk data using AzCopy
azcopy copy $sourceSAS.AccessSAS $targetSAS.AccessSAS --blob-type PageBlob

# Revoke SAS access when complete
Revoke-AzDiskAccess -ResourceGroupName "MyResourceGroup" -DiskName $sourceDisk.Name
Revoke-AzDiskAccess -ResourceGroupName "MyResourceGroup" -DiskName $targetDisk.Name

Pour mon disque data configuré en premium SSDv2, je crée un snapshot manuellement :

Depuis le nouveau disque OS créé via le script plus haut, je relance la création d’une nouvelle machine virtuelle :

Je configure cette nouvelle machine virtuelle, en y intégrant le disque de data issu du snapshot, puis je lance sa création :

Une fois la machine virtuelle créée, j’éteins celle-ci, puis j’active Encryption at host dans les paramétrages des disques :

Je redémarre la machine virtuelle, puis je constate dans l’affichage du diagnostic le bon démarrage de celle-ci :

Conclusion

Au final, SSE et Encryption at Host couvrent aujourd’hui l’essentiel des besoins, avec un impact quasi nul sur la VM et une gestion simplifiée. SSE reste la base, toujours activée, tandis qu’Encryption at Host ajoute une couche complète de protection sans coût CPU notable.

ADE fonctionne encore, mais son intégration à l’OS et sa charge CPU supplémentaire en font une solution plus lourde à exploiter. Avec les résultats obtenus et sa dépréciation annoncée, il devient clairement le mécanisme à éviter pour les nouvelles machines virtuelles.

  • SSE : excellente base, impact minimal, tout est géré par la plateforme.
  • Encryption at Host : même niveau de performance que SSE, avec la garantie que toutes les couches (OS, data, cache, disque temporaire) sont chiffrées directement par l’hyperviseur.
  • ADE : Performances disque similaires, mais CPU plus élevé, dû au chiffrement dans la VM. Cela confirme pourquoi ce mode est progressivement remplacé par les autres mécanismes gérés par la plateforme.

Pour la majorité des workloads, Encryption at Host apparaît désormais comme l’option la plus propre, la plus simple et la plus pérenne.