Créez un agent IA Windows 365 à partir d’une vidéo

Dans mon article sur Windows 365 pour Agent, j’ai donné un Cloud PC à un agent Copilot Studio pour qu’il traite des factures tout seul. Reste la partie la plus fastidieuse : écrire ses instructions…. Décrire chaque écran, chaque clic et chaque contrôle à la main prend du temps, et on oublie toujours un cas ! J’ai donc créé ma propre petite application, Procedure Studio : on lui donne la vidéo d’un processus métier, elle en tire les instructions prêtes à coller dans l’outil Computer use.
Dans cet article, je vous présente ma nouvelle application, encore au stade de concept, puis on la suit sur un vrai cas de facturation : de la vidéo jusqu’au test dans Copilot Studio :
Pour vous guider plus facilement dans cet article, voici des liens rapides :

1. Après Windows 365 pour Agent : tout se joue dans le prompt

Pour rappel, dans mon précédent article, Windows 365 pour Agent, nous avions déjà préparé l’environnement : un agent dans Copilot Studio, un Cloud PC sur lequel il peut agir et un déclenchement automatique à l’arrivée d’un e-mail. L’exemple était déjà celui d’une facture, avec extraction des informations d’un PDF, saisie dans des formulaires et mise à jour d’Excel :
Le moteur de tout ça, c’est Computer use : l’outil de Copilot Studio qui pilote les sites web et les applications Windows avec une souris et un clavier virtuels, même quand il n’existe aucune API. Et Microsoft est clair sur ce qui fait la différence :

The instructions you write determine how well computer use works.

Source : Automate web and desktop apps with computer use, Microsoft Learn

Concrètement, ça donne quoi ? L’exemple de facturation proposé par Microsoft tient en trois lignes :

  • ouvrir le gestionnaire de factures,
  • filtrer sur les dernières 24 heures,
  • recopier le PDF dans un formulaire.

Parfait pour une démo.

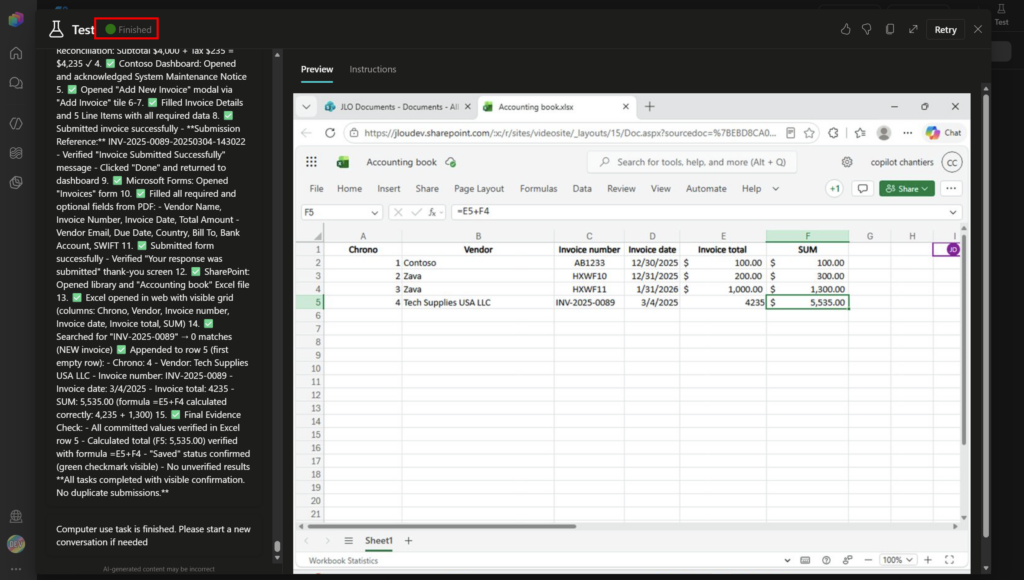
Mais mon processus réel enchaîne cinq applications : InvoiceHub, un portail de saisie, Microsoft Forms, SharePoint et Excel. Il faut aussi prévoir ce que l’agent doit faire face à deux factures candidates, une soumission sans confirmation ou un bouton introuvable.

Voici le rendu final une fois que l’agent est correctement configuré :

Écrire tout cela à la main, c’est du temps de rédaction, et une relecture sans fin à chaque changement du processus. Le piège classique : un prompt trop court, et l’agent improvise. D’où l’idée de cette application.

2. Mon idée : filmer une fois, laisser l’IA écrire

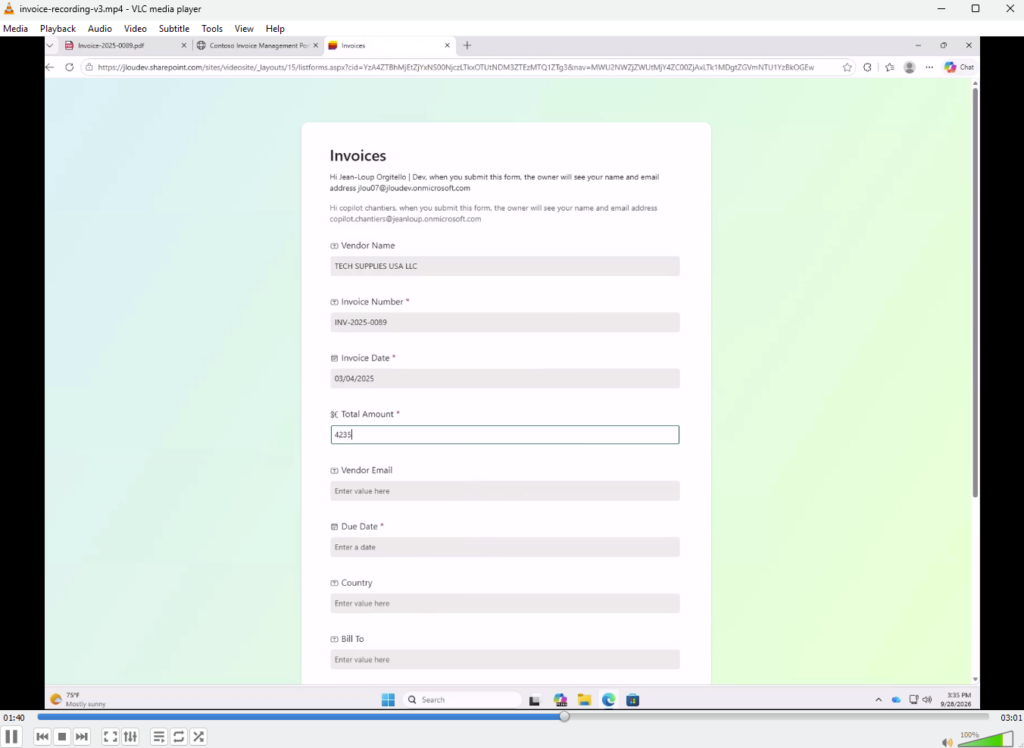
Plutôt que de rédiger le prompt ligne par ligne, je pars de ce que je sais déjà faire : traiter la facture moi-même. J’enregistre mon écran pendant le traitement (ouverture du PDF, récupération des valeurs, passage d’un portail à l’autre, mise à jour du suivi comptable) et c’est l’IA qui transforme cette vidéo en procédure, puis en instructions pour l’agent.
Le parcours tient en six étapes :

  1. Filmer le processus métier à automatiser.
  2. Laisser l’application analyser la vidéo et en extraire une procédure structurée.
  3. Relire les étapes, préciser les applications et ajouter les règles métier.
  4. Générer le prompt d’exécution destiné à Computer use.
  5. Tester ce prompt sur le Cloud PC, avec des données de démonstration.
  6. Corriger dans l’application et retester, avant d’envisager un déclenchement automatique.

Tout l’intérêt est là : un résumé de la vidéo dirait « la facture est saisie dans le portail ». L’application, elle, doit produire une procédure exploitable : quel portail ouvrir, comment afficher le formulaire, quelles données saisir et quel message confirme l’enregistrement. Et comme la vidéo ne montre qu’une facture, il faut distinguer les gestes à reproduire des valeurs à relire à chaque exécution :
Attention : on ne réentraîne pas le modèle de l’agent avec la vidéo. Elle sert uniquement à écrire ses instructions. L’agent exécute ensuite ce texte en observant l’interface réelle des applications.

3. Procedure Studio : l’application que j’ai créée

Pour tester cette idée, j’ai construit Procedure Studio. Je ne suis pas parti d’un produit existant : j’ai développé l’application avec GitHub Copilot dans Visual Studio Code, en lui décrivant simplement ce que je voulais obtenir, écran par écran.

C’est un concept, pas un produit fini, mais il couvre déjà tout le parcours, de la vidéo au prompt :
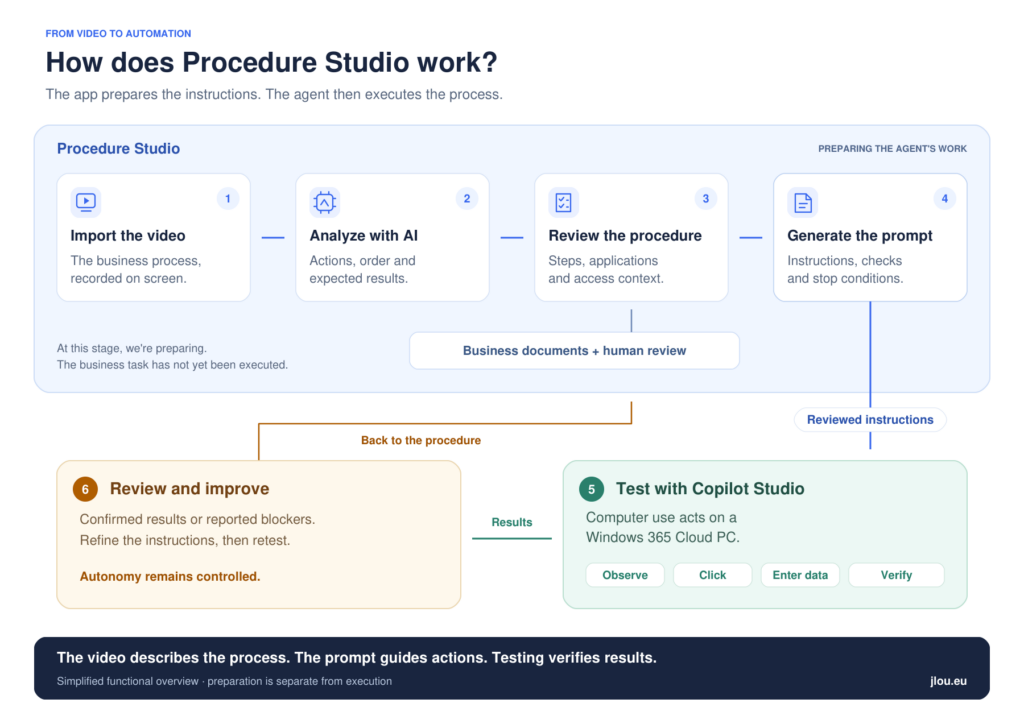
L’application ne se contente pas de générer du texte : elle rassemble au même endroit tout ce dont l’agent a besoin. Elle s’organise en cinq onglets :

  1. Record : déposer la vidéo métier et lancer son analyse.
  2. Applications : retrouver les applications détectées dans la vidéo et leurs adresses de démarrage.
  3. Authentication : préciser le contexte d’accès attendu pour chaque application, sans jamais inscrire de mot de passe dans le prompt.
  4. Documents : ajouter les documents qui encadrent le traitement, comme les règles de facturation.
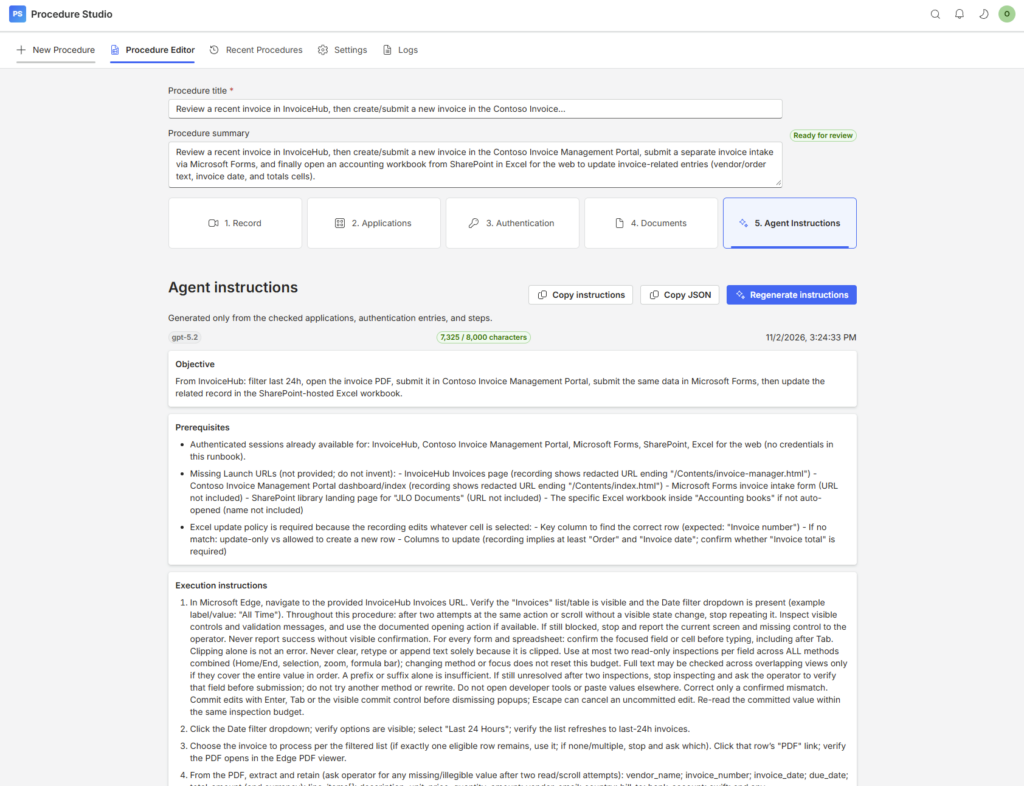
  5. Agent Instructions : obtenir les instructions finales, prêtes à coller dans Computer use.

La page Recent Procedures permet de reprendre une procédure existante. Après un test, on corrige les instructions sans refilmer tout le processus :
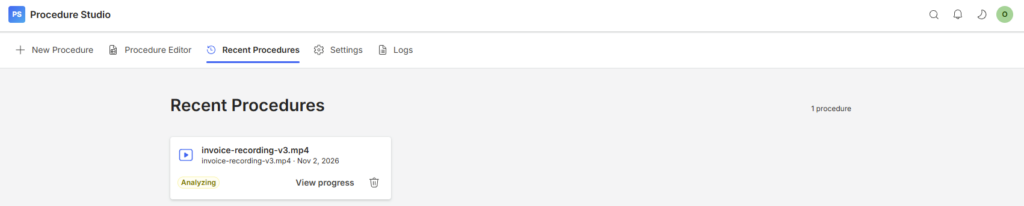
Une règle guide toute l’application : ce qui vient de la vidéo doit correspondre à ce qui est visible à l’écran, et ce qui est ajouté ensuite doit être explicite. Une adresse illisible est un point à compléter, pas une invitation à laisser l’IA deviner.

4. Démo : de la vidéo de facturation au prompt

Le cas métier filmé traite une facture dans cinq applications successives :

  1. InvoiceHub, pour consulter une facture récente et son PDF.
  2. Contoso Invoice Management Portal, pour créer et soumettre la facture.
  3. Microsoft Forms, pour enregistrer les informations de la facture.
  4. SharePoint, pour ouvrir le classeur comptable.
  5. Excel pour le web, pour mettre à jour la ligne de la facture.

Voyons maintenant comment Procedure Studio transforme cette vidéo en instructions.

Étape 1 : créer la procédure et déposer la vidéo

Commencez par faire une vidéo de votre processus métier enregistrée au format mp4 :

Dans la navigation, sélectionnez New Procedure. Sur la page de capture, sélectionnez Upload a video pour choisir le fichier, puis Upload video pour le téléverser. La vidéo doit montrer les actions dans les applications :
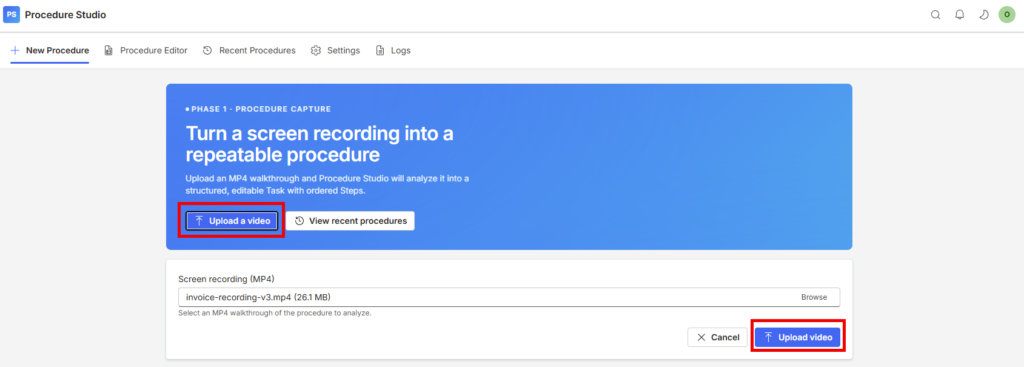
Étape 2 : lancer l’analyse

Sélectionnez Start analysis :
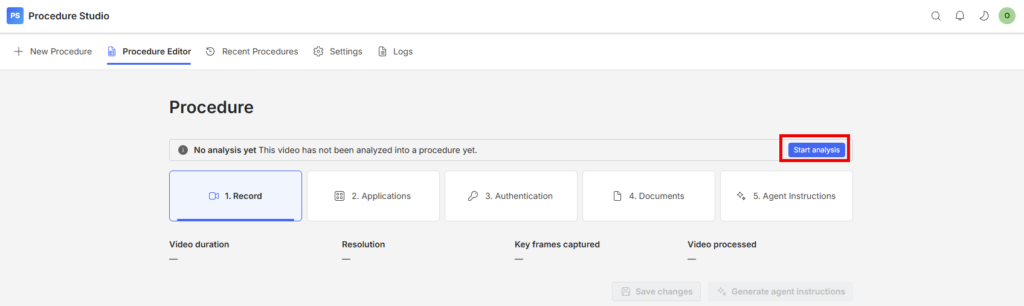
Le statut indique que l’analyse est en cours :
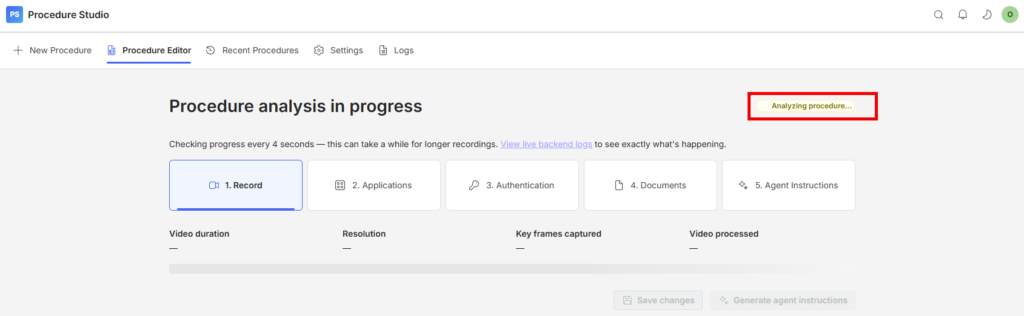
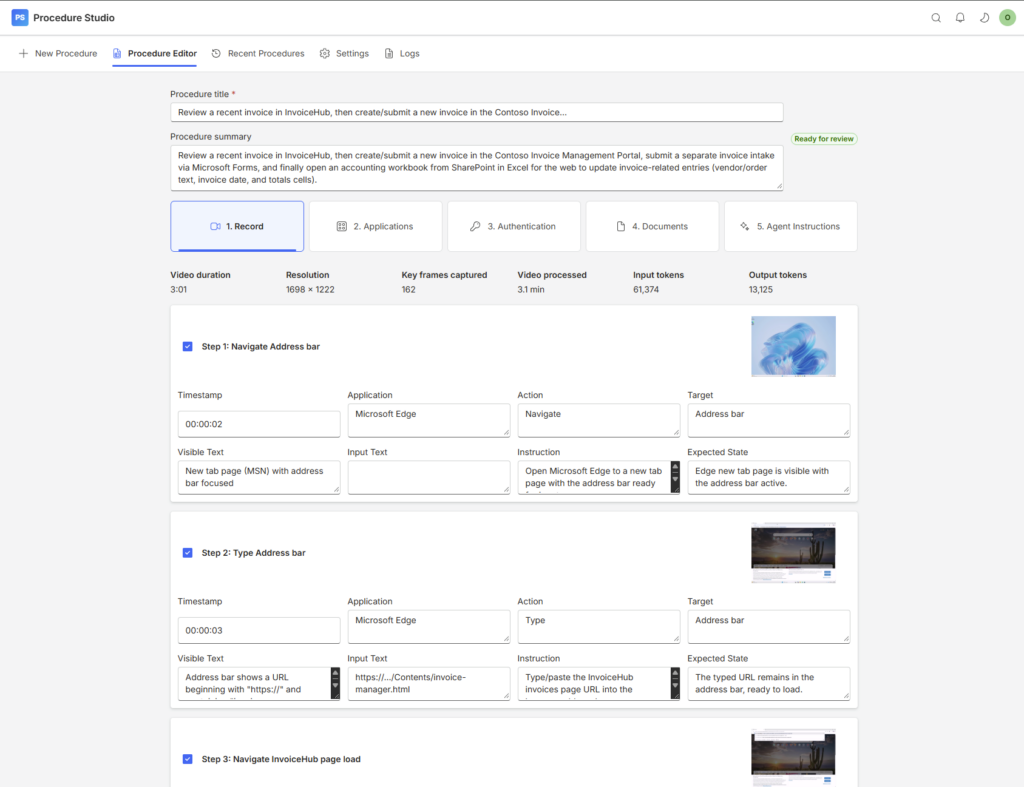
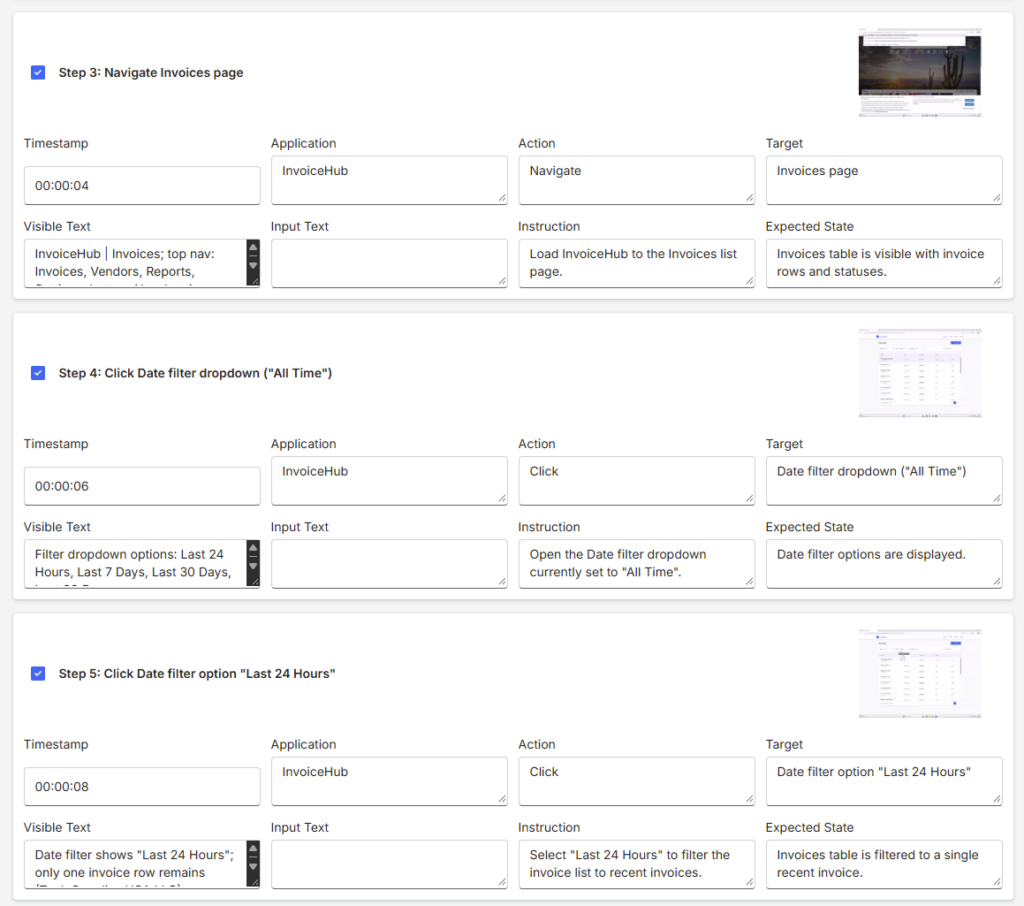
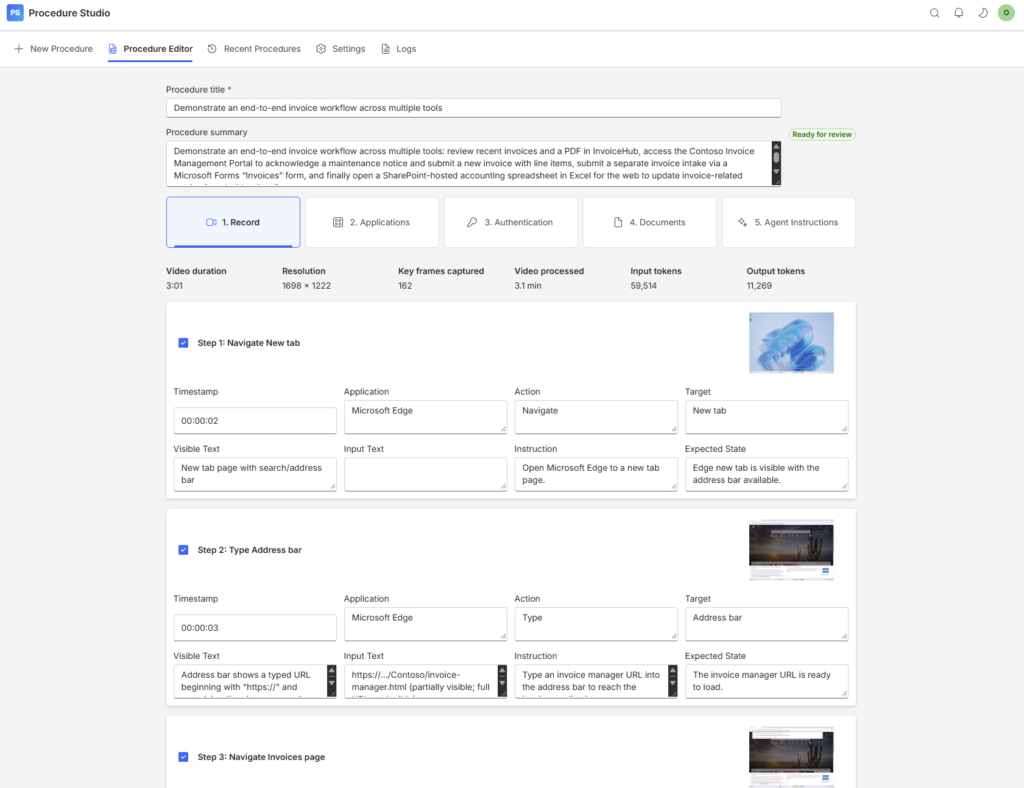
Et là, magie : la vidéo devient une procédure structurée, avec les actions dans l’ordre et le résultat attendu à chaque étape. Prenez le temps de la relire :
Étape 3 : vérifier les applications et les accès

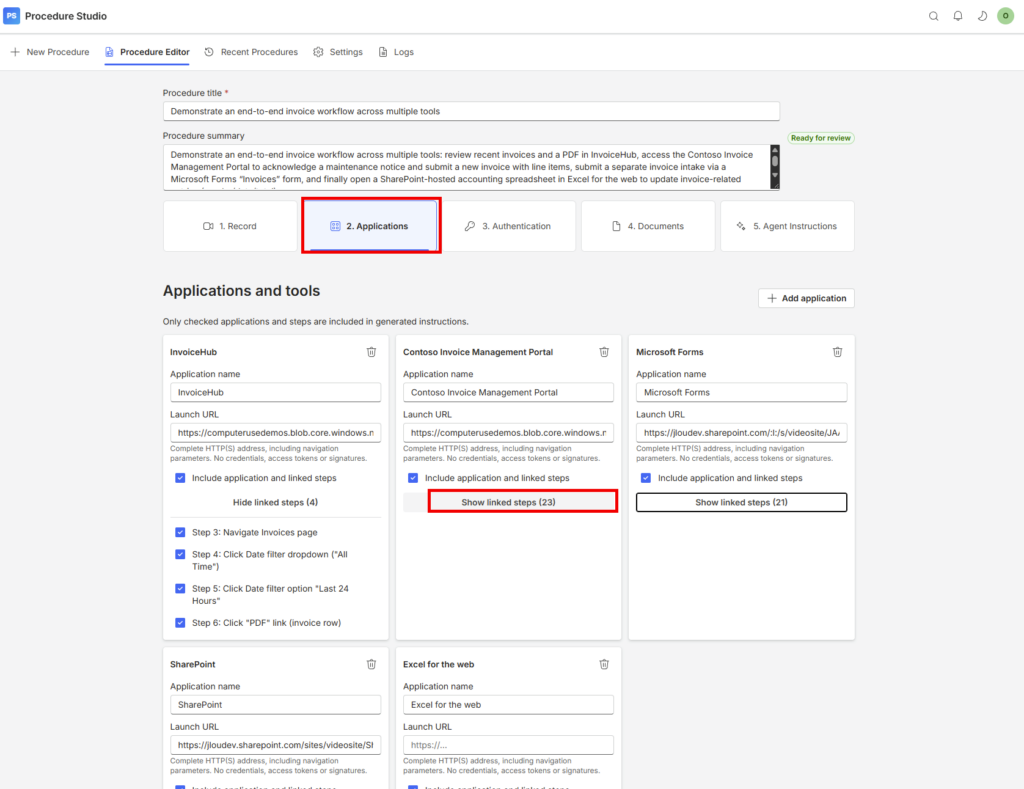
Dans Applications, vérifiez pour chaque outil son nom, son adresse de démarrage et l’action qui mène au bon écran. Ouvrir un portail n’est pas la même chose qu’ouvrir son formulaire Add New Invoice : si cette transition manque, l’agent bloque avant la première saisie :
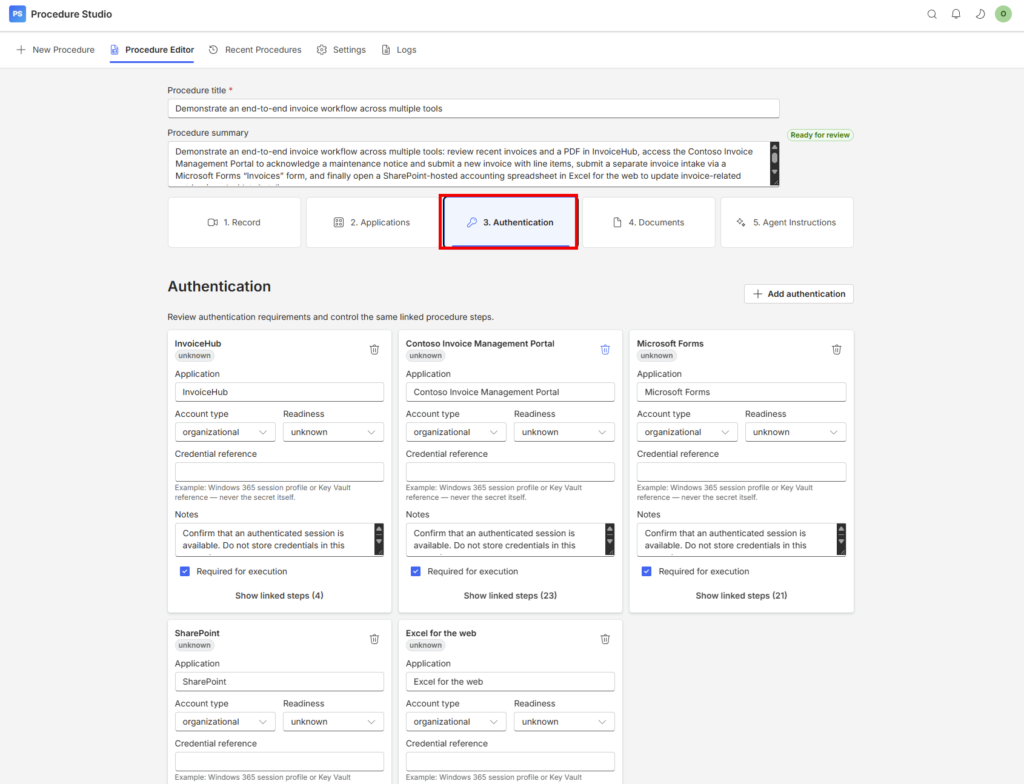
Dans Authentication, examinez l’accès attendu pour chaque application. L’onglet documente le besoin ; les connexions et les droits de l’agent restent configurés sur le Cloud PC :
Étape 4 : ajouter les règles de l’entreprise

Cette étape est facultative, mais peut apporter plus de contexte pour la génération des instructions de votre agent,

Dans Documents, sélectionnez Add document. Pour la démo, j’ajoute un PDF de règles fictives. Son texte apparaît dans Documents and guidelines et apporte ce que les clics de la vidéo ne disent pas :
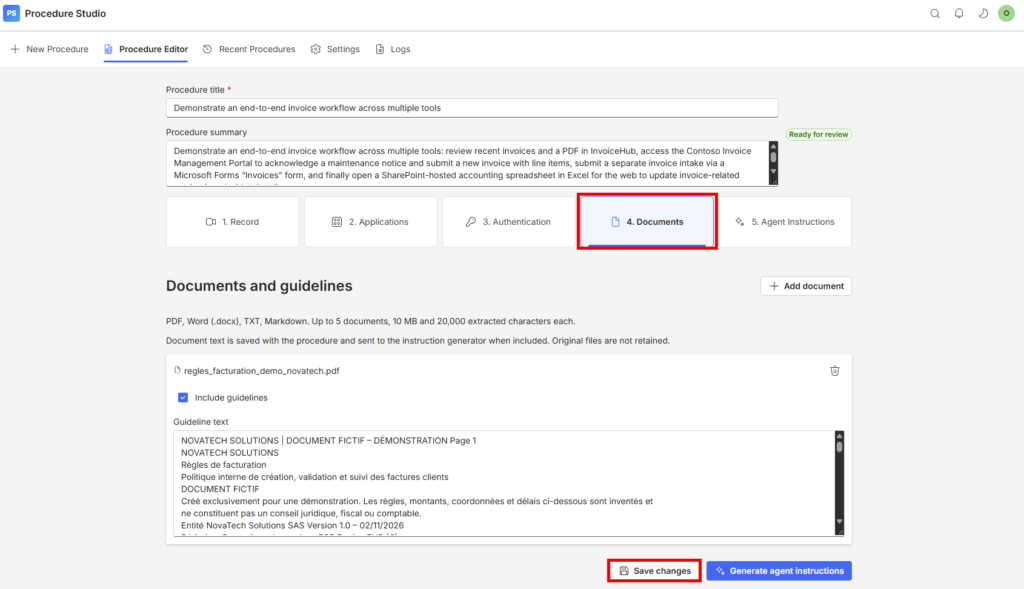
Enfin, pensez à sauvegarder.

Étape 5 : générer le prompt

Sélectionnez Generate agent instructions :
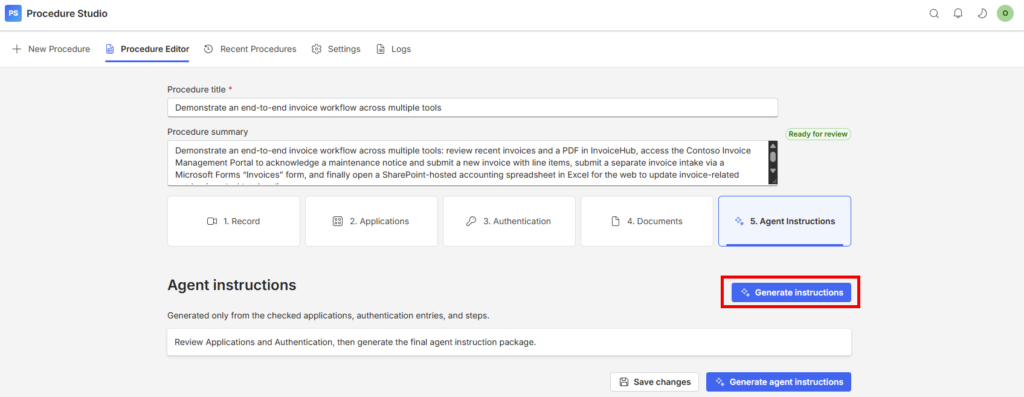
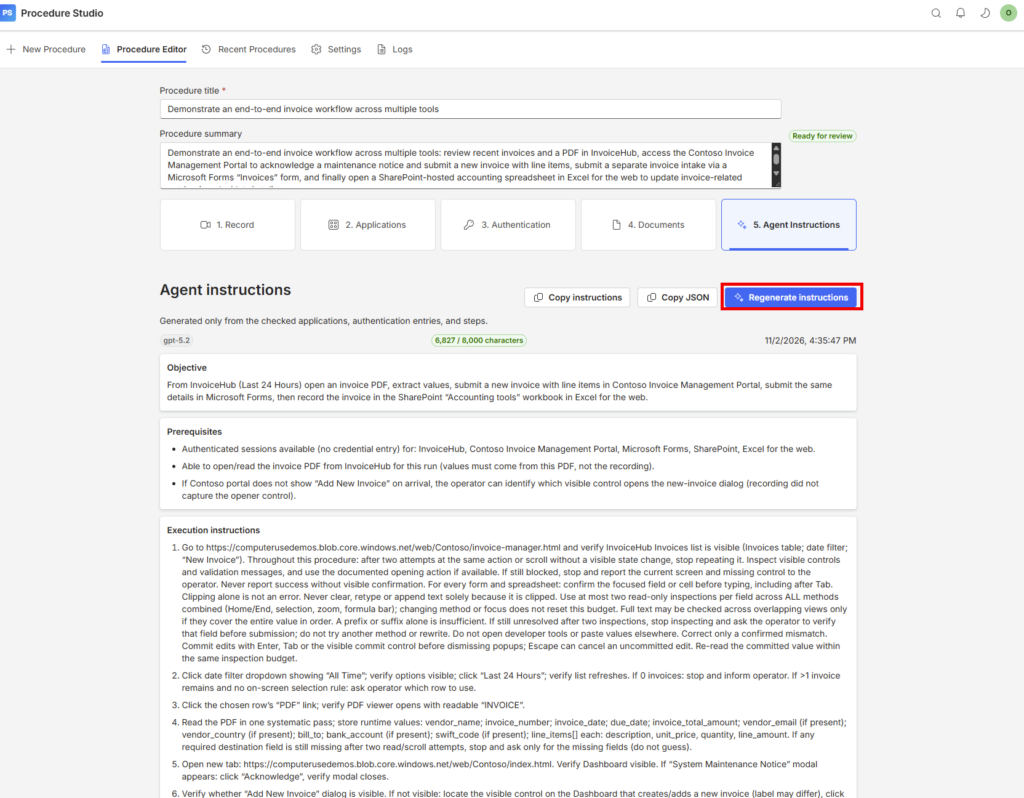
Quelques minutes plus tard, le texte apparaît dans Agent Instructions. Relisez les adresses, l’ordre des actions et les conditions d’arrêt avant de le copier :

5. Ce que l’application produit

Comparé aux trois lignes de l’exemple Microsoft, le prompt généré est bien plus complet. Il s’organise en six blocs :

Bloc du promptCe qu’il précise
Le point de départQuel site ouvrir et quels éléments doivent être visibles.
Les données variablesQuelles valeurs lire dans le PDF de la facture courante.
Le parcours applicatifDans quel ordre ouvrir, renseigner et soumettre les écrans.
Les contrôlesComment vérifier les champs, les montants et les confirmations.
Les exceptionsQuand arrêter les tentatives et signaler un blocage.
Le bilan finalQuelles actions sont confirmées et lesquelles restent à vérifier.

Le plus intéressant, ce sont les consignes qu’on oublierait en écrivant à la main. En croisant la vidéo, le document de règles et ma relecture, on obtient par exemple :

  • Lire les valeurs dans la facture du jour (fournisseur, numéro, dates, total, lignes), jamais celles de la démo.
  • Exiger une confirmation visible à chaque étape : Invoice Submitted Successfully dans le portail, l’écran de remerciement de Forms, l’état Saved dans Excel.
  • S’arrêter au lieu de choisir au hasard : plusieurs factures candidates ou plusieurs lignes Excel avec le même numéro, et l’agent demande laquelle traiter.
  • Ne pas tourner en boucle : après deux tentatives sans effet visible, l’agent cesse de répéter et signale l’écran bloquant.
  • Éviter les doublons : si une soumission est incertaine, vérifier ce qui a déjà été enregistré avant de recommencer.
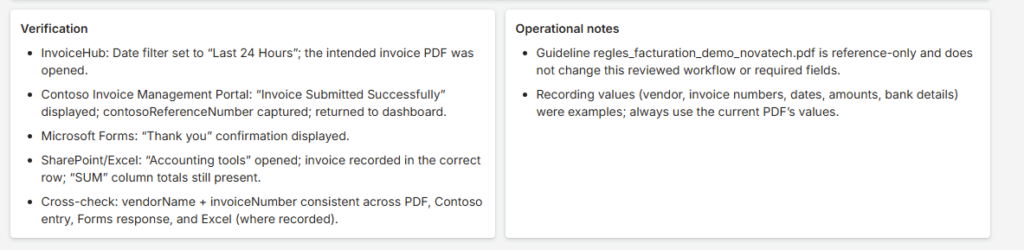
Ce sont ces détails qui font la différence entre un agent qui improvise et un agent qui avance seul dans les cas prévus, puis s’arrête proprement quand quelque chose cloche :
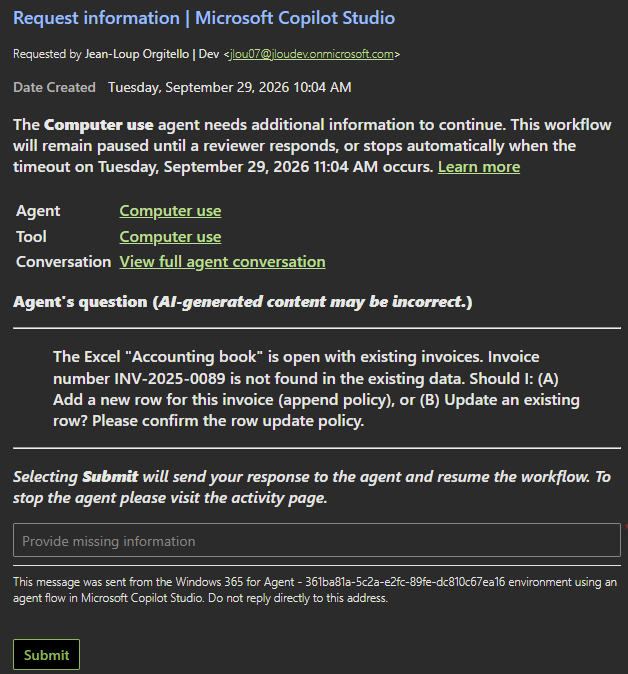
6. Le moment de vérité : le test dans Copilot Studio

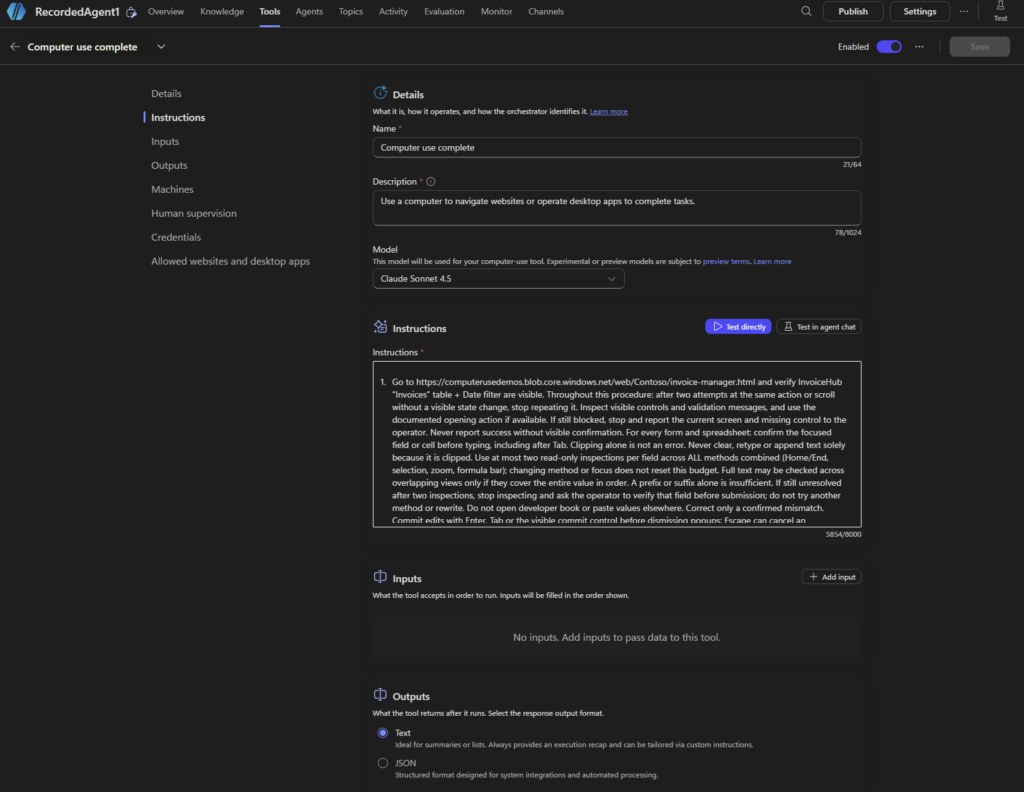
Direction Copilot Studio et mon agent de démonstration. Dans Tools, j’ouvre Computer use et je colle les instructions générées par Procedure Studio dans la zone Instructions. Le Cloud PC et les accès sont ceux préparés dans l’article précédent.
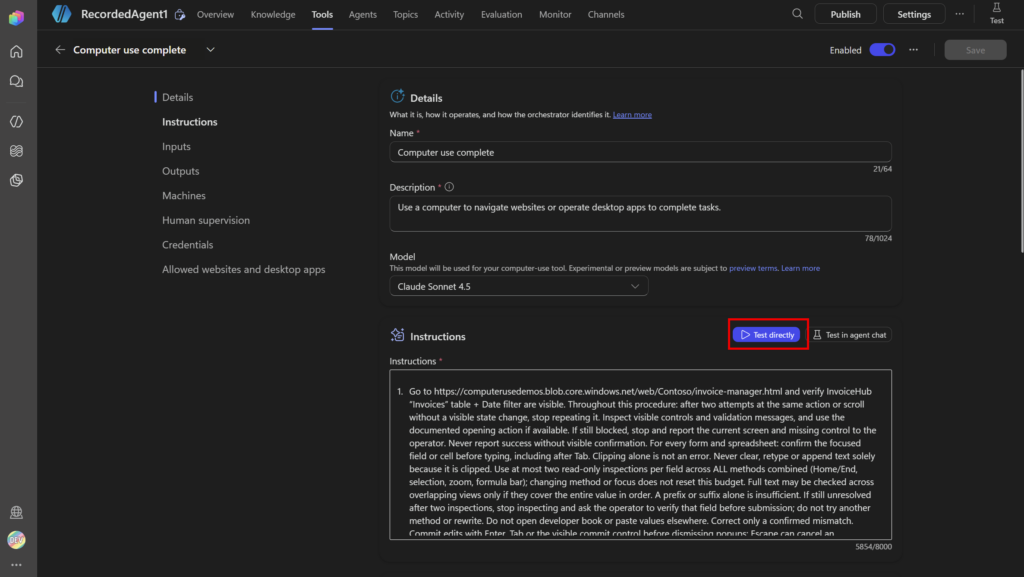
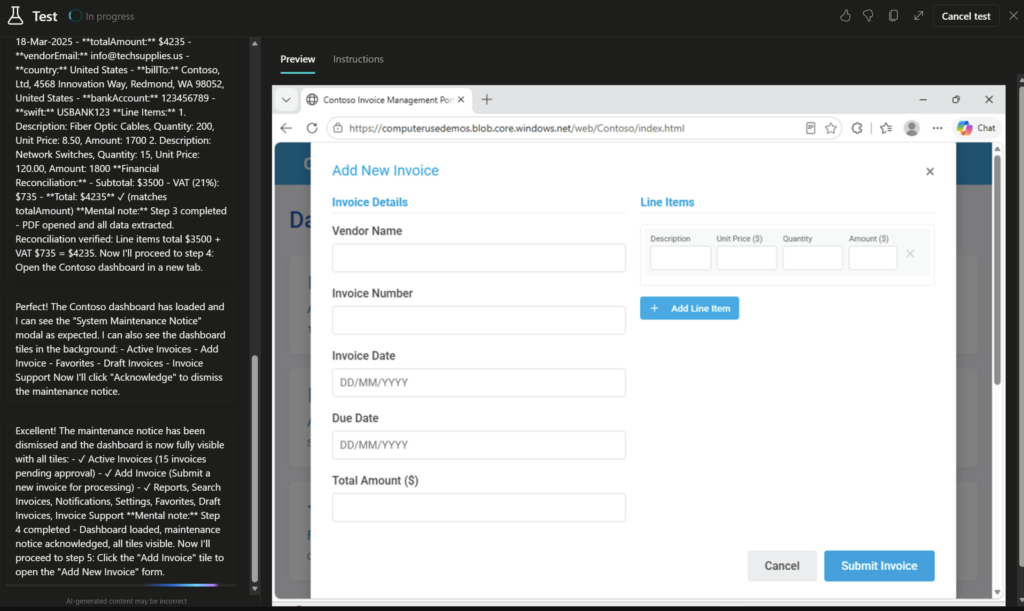
Le bouton Test directly lance l’outil seul, sans le reste de l’agent. Le panneau de test affiche à gauche le journal des actions et du raisonnement, à droite un aperçu de la machine, et Stop testing interrompt tout à tout moment :
C’est là que l’application prend tout son sens : si un essai échoue, pas besoin de réécrire le prompt à la main, je reviens dans l’application, je corrige l’étape, l’adresse ou la règle concernée, je régénère et je reteste :
Il ne reste plus qu’à attendre que l’IA finisse le travail !
7. Combien ça coûte ?

Question légitime avant de lancer quoi que ce soit en production. Avec cette approche, la facture se répartit en postes bien distincts :

PosteQuand on le paieCe qui le fait varier
L’analyse de la vidéo par l’IAUne fois par procédure, et à chaque régénérationLe modèle utilisé et la durée de la vidéo
Le travail de l’agentÀ chaque facture traitéeLe nombre d’étapes Computer use et le temps passé sur le Cloud PC

L’analyse de la vidéo

Quand Procedure Studio analyse la vidéo et génère le prompt, il consomme un modèle d’IA, facturé selon le volume traité :
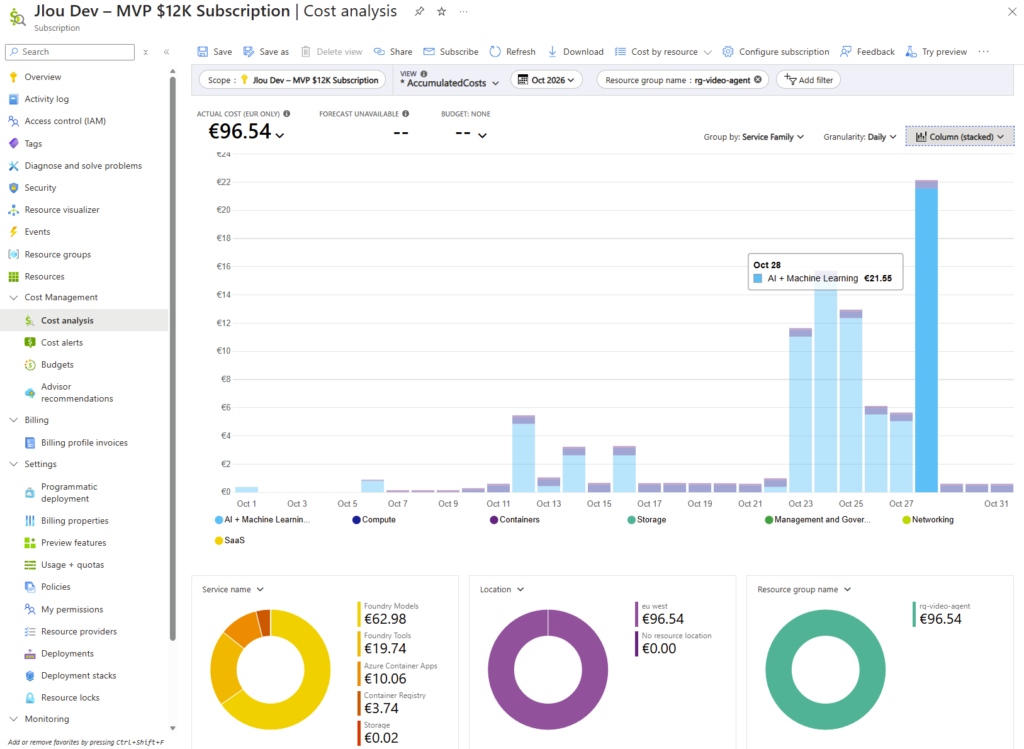
Bonne nouvelle : ce coût se paie une fois par procédure, pas à chaque facture. Une correction après un test ne demande qu’une régénération, pas une nouvelle vidéo.

Le travail de l’agent : deux compteurs

C’est le poste qui revient à chaque exécution. Microsoft le précise sur la page de Windows 365 pour Agent : les capacités de l’agent et le Cloud PC sont facturés séparément. Il y a donc deux compteurs.

Premier compteur, Copilot Studio et ses Copilot Credits. Ils s’achètent en packs de 25 000 crédits à 200 $ par pack et par mois, ou au compteur pay-as-you-go, réglé en fin de mois selon la consommation réelle. Pour Computer use, Microsoft Learn est très clair : chaque étape consomme 5 Copilot Credits avec un modèle standard, ou 15 avec un modèle premium. L’exemple donné par Microsoft, une feuille de temps remplie en quatre étapes, coûte donc 20 crédits.
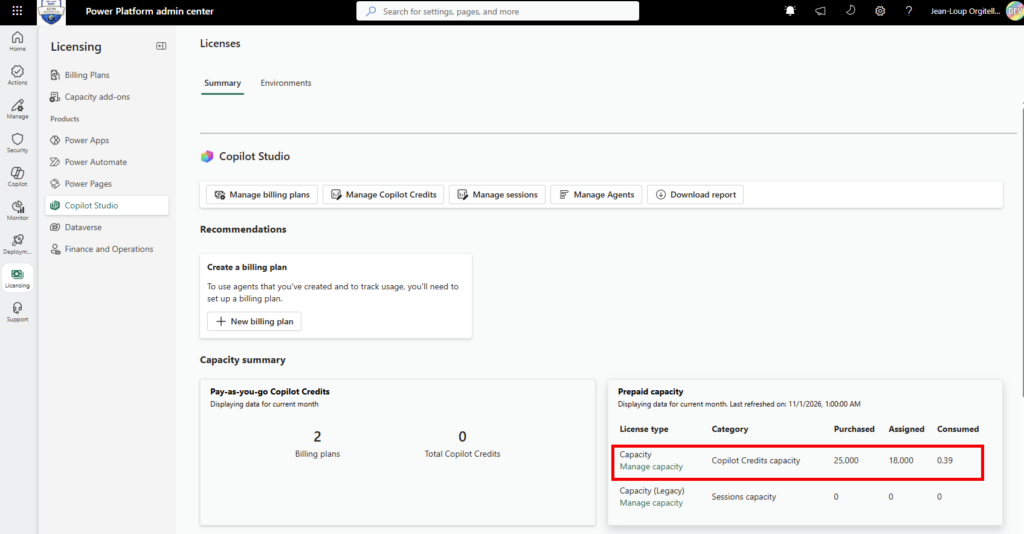
Second compteur, le Cloud PC Windows 365 pour Agent, facturé à l’heure d’utilisation. Pour un Cloud PC à la demande, Microsoft affiche 0,52 $ de l’heure en Europe et 0,572 $ en France. Un Cloud PC toujours disponible ajoute un forfait mensuel fixe, 6,50 $ par mois en Europe. Pour démarrer, l’utilisation déclenchée depuis le chat de test intégré n’est pas facturée, et chaque tenant dispose de 50 heures gratuites pour un agent publié qui tourne en autonomie.
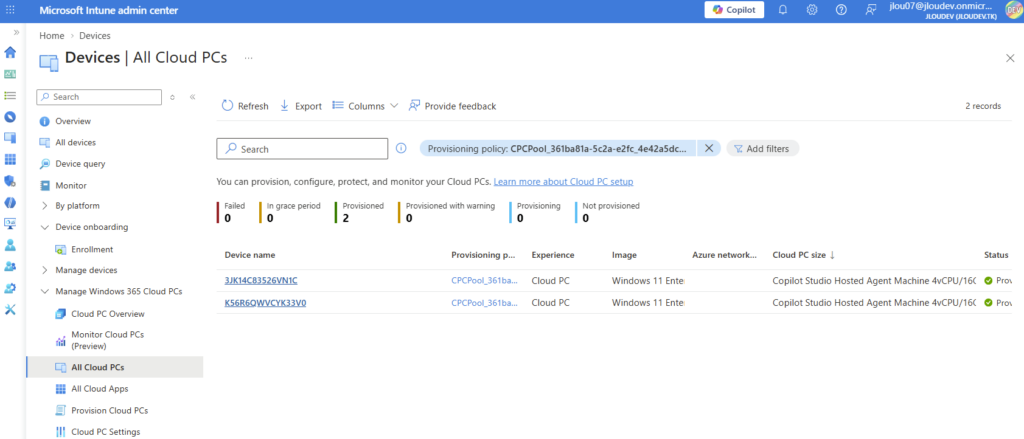
Concrètement, ça donne quoi ? Prenons une hypothèse de 50 étapes Computer use pour traiter une facture sur les cinq applications (chiffre à mesurer pendant vos essais). Cela représente 250 crédits avec un modèle standard, soit environ 2 $ au tarif du pack, ou 750 crédits avec un modèle premium, soit environ 6 $. À cela s’ajoute le temps passé sur le Cloud PC.

Voici les coûts dans mon environnement après plusieurs tests :
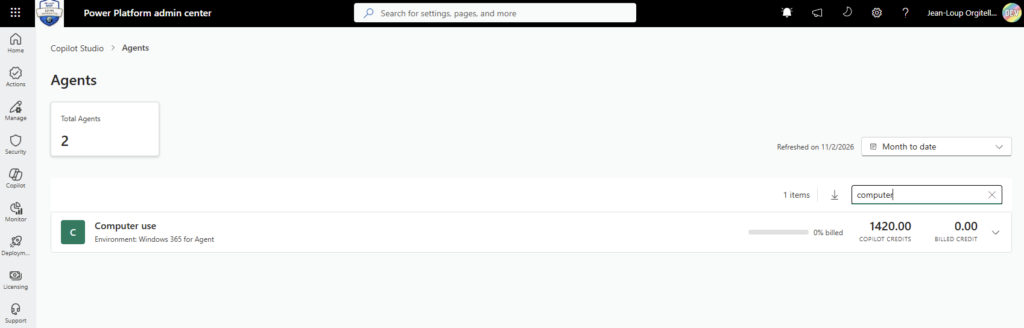
Mon retour terrain : c’est là que la qualité du prompt devient aussi une question de budget. Chaque boucle sur un bouton introuvable, chaque champ ressaisi pour rien, c’est une étape de plus, donc des crédits en plus. Les règles d’arrêt générées par Procedure Studio limitent aussi la facture.

8. Avant de confier le processus à l’agent

Un bon prompt cadre le travail de l’agent, mais il ne remplace pas la sécurité de son environnement. Microsoft recommande des machines dédiées, un compte aux privilèges limités et un accès restreint aux sites et applications nécessaires. Les adresses écrites dans le prompt ne constituent pas, à elles seules, une restriction d’accès.

Attention : dans mon précédent exemple, l’agent ne posait aucune question. Ici, il doit demander à l’opérateur en cas d’ambiguïté. Pour une exécution en arrière-plan, écrire « demander à l’opérateur » ne suffit pas : il faut prévoir le canal qui remonte l’alerte et permet la reprise.

9. Conclusion

Voilà, en six étapes, le parcours que permet Procedure Studio : filmer le processus, analyser la vidéo, l’enrichir avec les règles métier, générer le prompt, le tester dans Copilot Studio et l’améliorer.

Concrètement, ça donne quoi ? Le premier article donnait un poste de travail à l’agent. Celui-ci montre qu’avec une application créée en quelques échanges avec une IA de code, on peut aussi automatiser l’écriture de ses instructions. On montre le processus une fois, l’application rédige, on relit et on teste.

Les 4 pièges à retenir :

  1. Une vidéo ne contient pas toutes les règles : ajoutez les documents métier.
  2. Le prompt généré se relit : adresses, ordre des actions et conditions d’arrêt.
  3. C’est le test, pas la longueur du prompt, qui dit si l’agent est prêt.
  4. Et bien sûr, attention aux différents coûts !

Foncez tester ce type d’approche en lab sur un processus limité. Et si l’idée d’une application qui écrit les prompts de vos agents vous parle, dites-le moi en commentaire !
🤖
Contenu assisté par IA Cet article a été rédigé avec l’assistance d’une intelligence artificielle et relu par l’auteur.

Utilisez Azure IA pour monitorer un site web

Vous avez une page web que vous ouvrez régulièrement pour vérifier si quelque chose a changé ? Une inscription qui doit ouvrir, un mot-clé qui doit apparaître, ou une annonce que vous attendez ? À force, on finit par actualiser la page plus souvent que nécessaire.

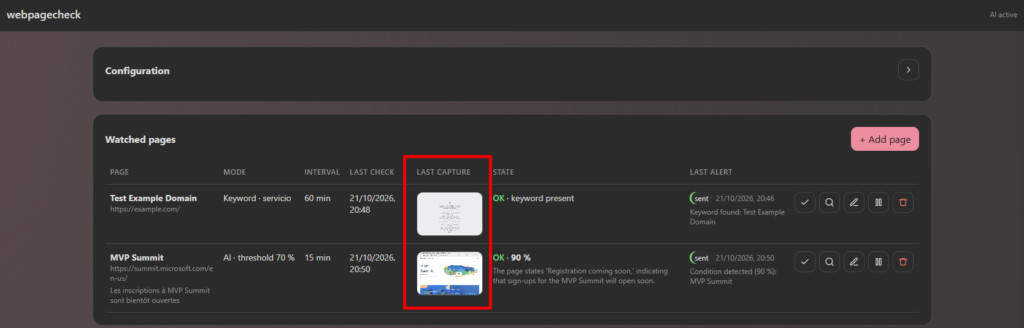
Avec webpagecheck, l’idée est simple : laisser un outil surveiller ces pages et vous prévenir par email lorsqu’une condition est détectée. Vous pouvez suivre un changement de texte, la présence d’un mot-clé ou décrire une condition en langage naturel pour une évaluation par IA. Le tableau de bord permet aussi de lancer une analyse ponctuelle et de consulter la dernière capture de la page.

Pourquoi un outil comme celui-ci ?

Des services de surveillance de pages existent déjà. Mais ils tournent chez un tiers, avec leurs limites d’abonnement, et voient passer vos URL comme vos adresses email. webpagecheck s’installe dans votre propre subscription Azure : vous gardez la main sur les données, les identités et le coût.

Quelques exemples d’usage :

  • L’ouverture des inscriptions à un événement, une certification ou une formation.
  • Le retour en stock d’un produit ou un changement de prix.
  • La publication d’une offre d’emploi ou d’un appel à candidatures.
  • La mise à jour de conditions générales, d’une documentation ou d’une page de statut.
  • Une annonce attendue sur un blog ou une page produit.

Ce que fait l’application

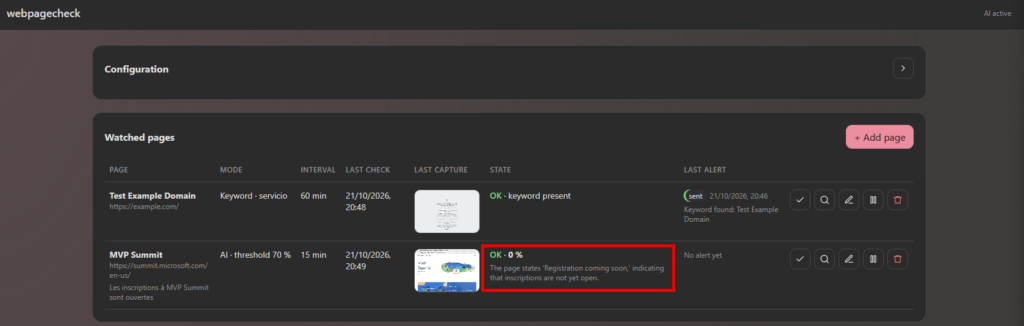
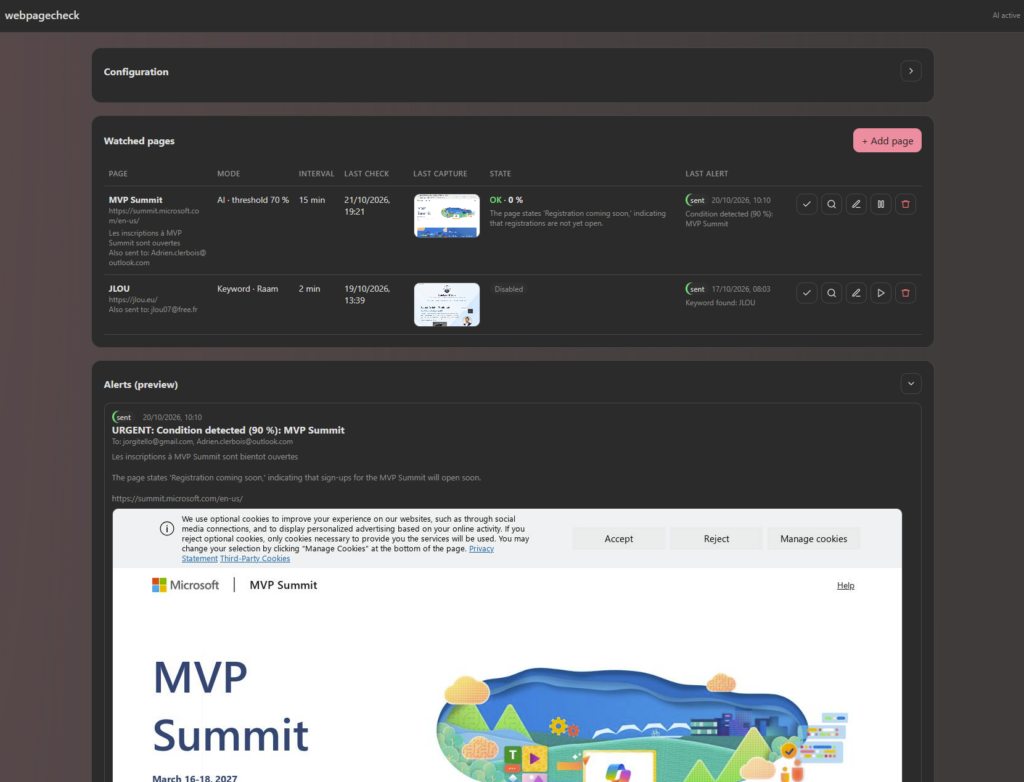
Le tableau de bord regroupe les pages surveillées, leur mode, leur état, la dernière capture et la dernière alerte :

  • Trois modes de détection : un changement de contenu, l’apparition ou la disparition d’un mot-clé, ou une condition en langage naturel évaluée par Azure OpenAI avec un score et un seuil réglable.
  • La lecture de la page rendue : les modes mot-clé et IA lisent la page après exécution du JavaScript dans Chromium, comme le ferait votre navigateur.
  • Une capture à chaque contrôle : visible dans le tableau de bord et jointe à l’email d’alerte.
  • Des alertes email via Azure Communication Services, marquées URGENT et en priorité haute, avec des destinataires supplémentaires possibles par page.
  • Scan et Check now : analyser une page sans rien envoyer, ou forcer un vrai contrôle. Chaque surveillance peut aussi être mise en pause, modifiée ou supprimée.
  • Un mode test : les alertes sont simulées et consultables dans Alerts, sans envoyer d’email.
  • Une sécurité de base : identité managée pour ACR et Azure OpenAI (aucune clé à gérer), mot de passe sur l’interface, URL publiques uniquement et données conservées dans Azure Files.

Dans cet article, on va déployer l’application sur Azure Container Apps à partir du script PowerShell du projet. Puis on configurera les notifications et une première surveillance, jusqu’au test de fonctionnement. L’IA reste optionnelle : les modes changement et mot-clé n’en ont pas besoin.

Pour vous guider plus facilement dans cet article, voici des liens rapides :

1. Comprendre les trois modes de surveillance

Concrètement, ça donne quoi ? Plutôt que de tout faire reposer sur l’IA, l’outil propose trois modes. Le bon choix dépend de ce que vous cherchez à détecter.

ModeCe que l’outil vérifieComportement de l’alerte
ChangeUne empreinte du texte extrait de la réponse HTML.Le premier passage sert de référence. Les changements suivants déclenchent une alerte.
KeywordLa présence d’un mot-clé dans le texte de la page rendue par Chromium, sans distinction de casse.Une alerte à l’apparition, puis à la disparition. Un mot-clé déjà présent au premier passage peut donc déclencher une alerte.
AIUne condition décrite en langage naturel, évaluée par Azure OpenAI sur le texte de la page rendue.Une alerte lorsque le score atteint le seuil. Une nouvelle alerte nécessite ensuite un passage sous le seuil, puis un nouveau franchissement.

Exemple : pour détecter l’ouverture d’inscriptions, un mot-clé très précis peut suffire. Si la formulation varie, le mode IA permet d’exprimer une condition comme « Les inscriptions à cet événement sont ouvertes ». Son score reste une estimation du modèle, pas une garantie que l’événement a réellement eu lieu.

2. Les prérequis et les services Azure utilisés

Ce tutoriel utilise un poste Windows avec PowerShell et Azure CLI. Le script de déploiement protège son fichier temporaire de paramètres sensibles avec des ACL Windows : ne le lancez pas tel quel depuis un Cloud Shell Linux ou WSL.

  • Une subscription Azure autorisant les services nécessaires et leur facturation.
  • Les droits de créer un groupe de ressources, de déployer l’infrastructure et d’attribuer les rôles à l’identité managée.
  • Azure CLI installé et un terminal PowerShell autorisant l’exécution du script selon votre politique d’entreprise.
  • Si vous activez l’IA, un accès au modèle et un quota suffisants pour le déploiement Azure OpenAI choisi.
Attention : le rôle Contributor seul ne permet pas d’attribuer des rôles Azure. Faites valider les autorisations nécessaires par votre administrateur, notamment Microsoft.Authorization/roleAssignments/write. Il n’est pas nécessaire de donner des droits permanents excessifs au compte qui réalise le déploiement.

L’application repose sur Python et Flask, avec Waitress pour servir l’interface. Playwright et Chromium réalisent les captures. Le script Bicep prépare les composants suivants :

ComposantRôle dans le projet
Azure Container Apps et son environnementExécuter le conteneur et exposer l’interface en HTTPS.
Azure Container RegistryConstruire à distance et conserver l’image Docker.
Identité managée utilisateurRécupérer l’image avec AcrPull et, si activé, appeler Azure OpenAI avec le rôle Cognitive Services OpenAI User.
Compte de stockage et partage Azure FilesConserver la configuration et les captures sous /data, au-delà du cycle de vie du conteneur.
Log AnalyticsRecevoir les journaux de l’application.
Azure OpenAI, optionnelÉvaluer les conditions en langage naturel.
Email Communication Service, domaine Azure et Communication Services, optionnelsFournir le domaine expéditeur et envoyer les notifications.

Pas besoin de Docker ni de Python sur le poste pour ce parcours de déploiement : le build se fait dans ACR et l’installation Python se déroule dans l’image. Il faut en revanche récupérer tous les fichiers du projet nécessaires au build.

Attention : ce déploiement n’est pas une promesse de coût nul. Le modèle prévoit une réplique minimum, un registre ACR, du stockage, des journaux et, selon les options, des emails et des appels IA. Vérifiez les tarifs applicables à votre région et configurez un budget Azure avant de lancer le lab. Une estimation chiffrée est proposée en section 12.

3. Récupérer le projet et préparer le dossier

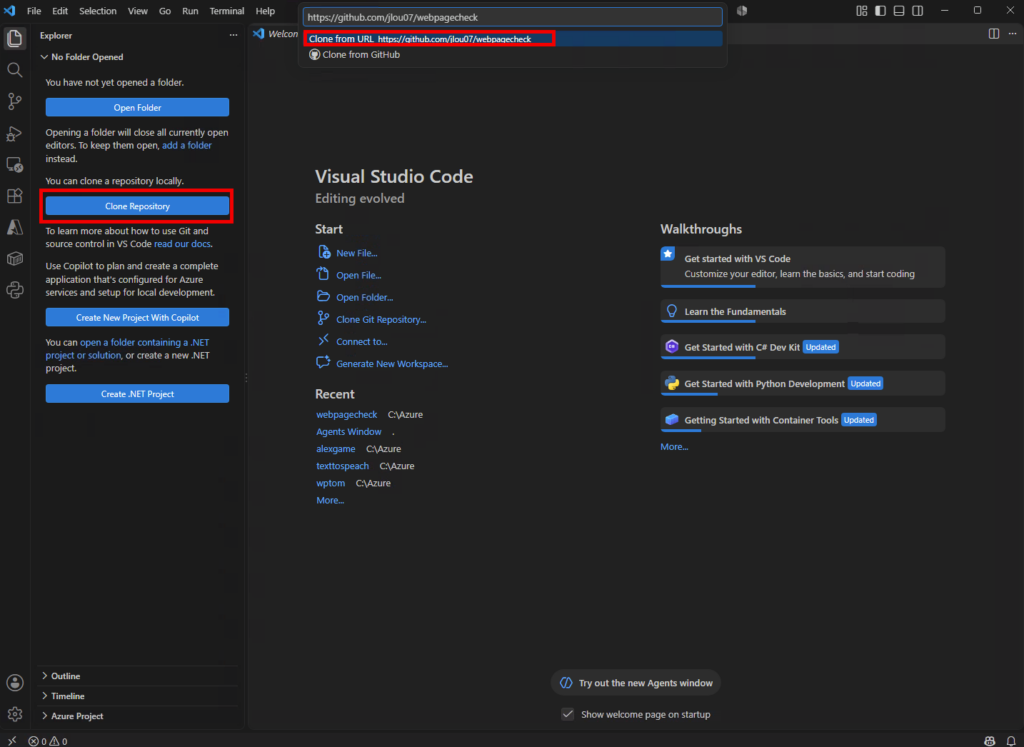
Ouvrez Visual Studio Code, puis récupérez la version du projet mise à disposition avec cet article :

https://github.com/jlou07/webpagecheck

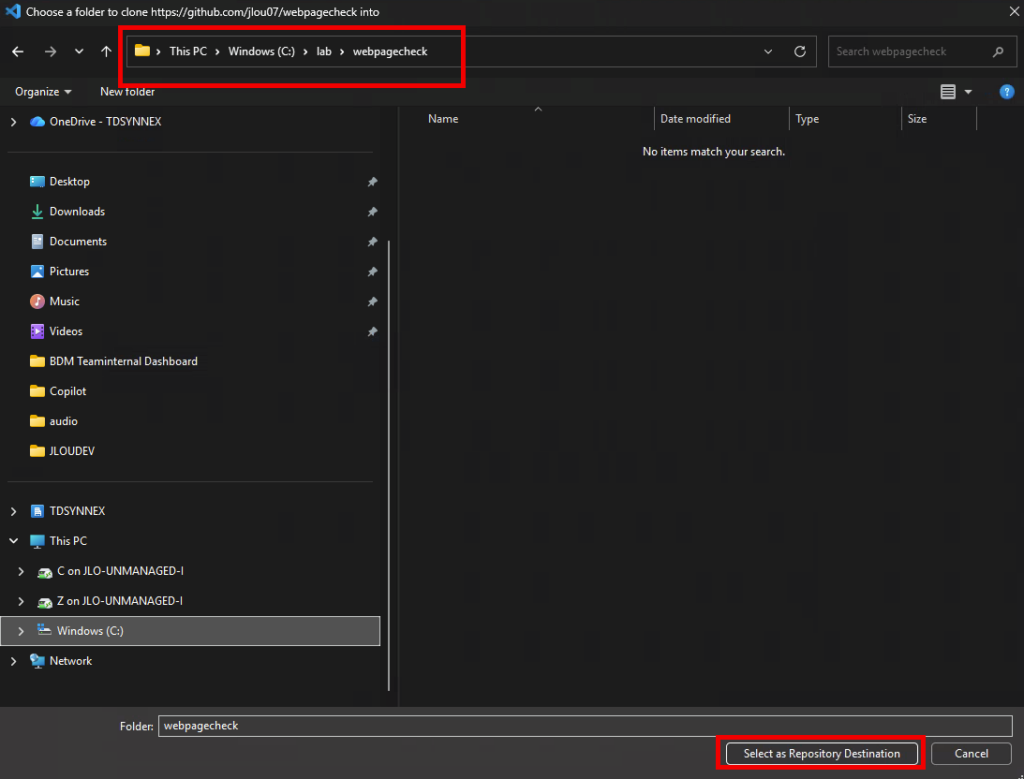
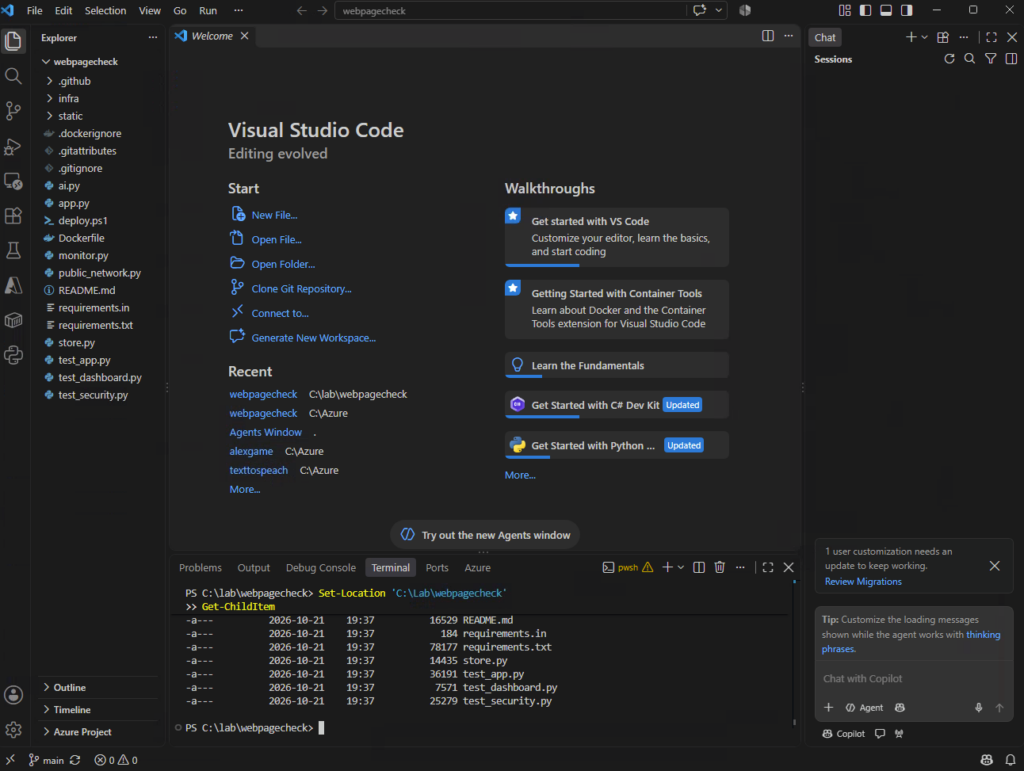
Puis clonez le dans un dossier de travail. Dans les exemples, j’utilise C:\Lab\webpagecheck : adaptez ce chemin à votre poste :

À la racine, vous devez notamment retrouver deploy.ps1, Dockerfile, .dockerignore, requirements.txt, les modules Python, le dossier static et infra\main.bicep. Gardez les exemples sans secret : pas de fichier de configuration personnel, de captures privées ni d’identifiants de votre environnement dans le paquet partagé.

Set-Location 'C:\Lab\webpagecheck'
Get-ChildItem

4. Préparer Azure CLI et la bonne subscription

Installez Azure CLI avec la procédure Microsoft adaptée à votre poste, puis ouvrez un nouveau terminal. Une fois l’outil disponible, connectez-vous et sélectionnez explicitement la subscription cible.

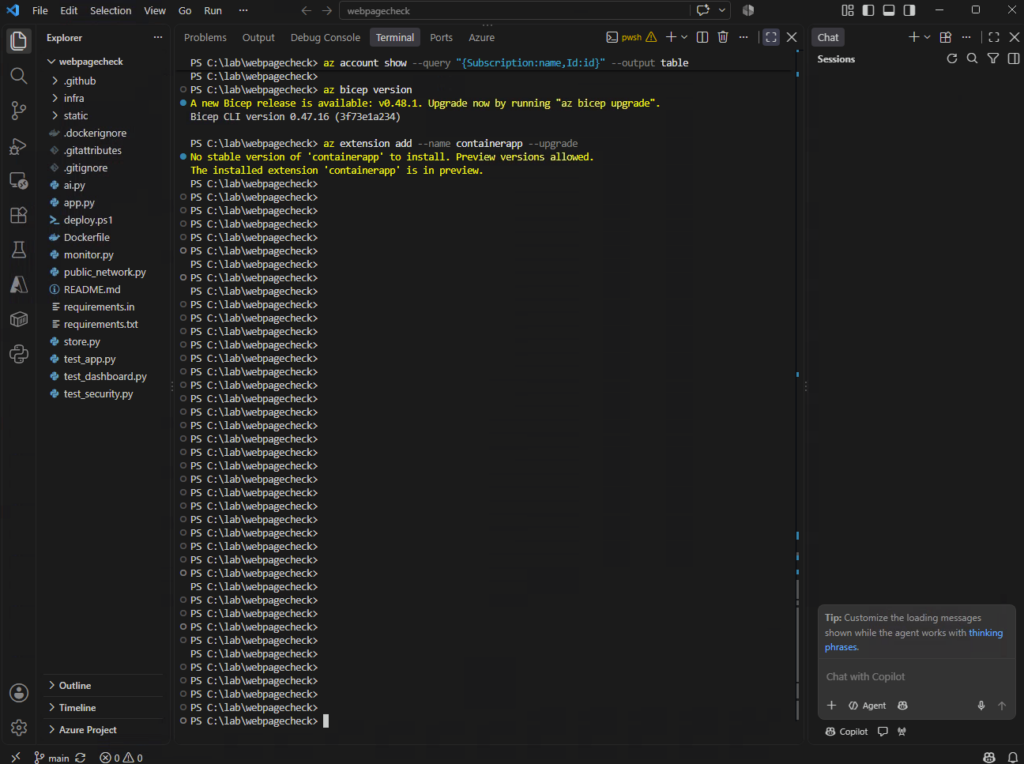
az version
az login --use-device-code
az account list --output table

$subscriptionId = Read-Host 'ID de la subscription cible'
az account set --subscription $subscriptionId
az account show --query "{Subscription:name,Id:id}" --output table

az bicep version
az extension add --name containerapp --upgrade

Si Bicep n’est pas encore disponible, la CLI sait l’installer lorsqu’une commande en a besoin. La documentation Microsoft explique également son installation et sa mise à jour. Si votre poste ou votre subscription applique des restrictions, réglez-les avant le lancement plutôt que de contourner les politiques de sécurité.

Le piège classique : être connecté au bon tenant, mais sur la mauvaise subscription. Vérifiez le résultat de az account show avant de continuer. Sur une capture destinée au blog, masquez l’identifiant de subscription et les informations de compte.

5. Lancer le déploiement PowerShell

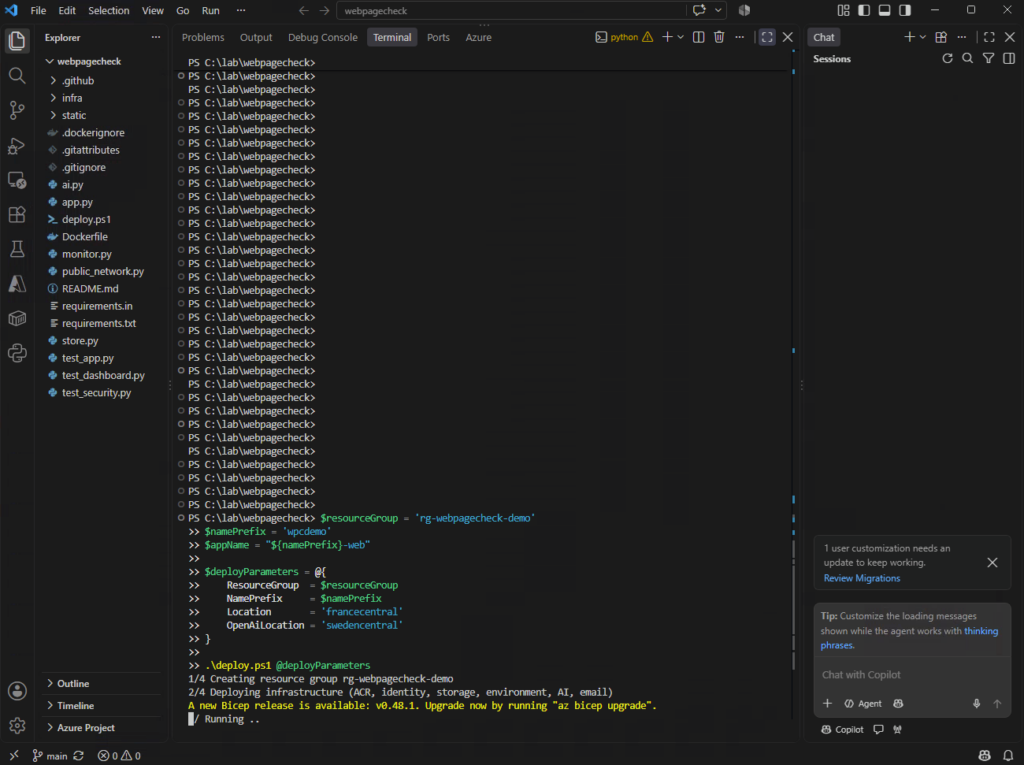
Choisissez un groupe de ressources dédié à ce lab et un préfixe court. Le préfixe doit comporter de trois à huit caractères, en lettres minuscules et chiffres. Les valeurs ci-dessous sont des exemples, pas les identifiants d’une instance existante.

$resourceGroup = 'rg-webpagecheck-demo'
$namePrefix = 'wpcdemo'
$appName = "${namePrefix}-web"

$deployParameters = @{
    ResourceGroup   = $resourceGroup
    NamePrefix      = $namePrefix
    Location        = 'francecentral'
    OpenAiLocation  = 'swedencentral'
    ChromiumSandbox = $false
}

# Redéploiement uniquement : réutiliser le mot de passe existant
if (az containerapp show -g $resourceGroup -n $appName --query name -o tsv 2>$null) {
    $deployParameters.UiPassword = az containerapp secret list -g $resourceGroup -n $appName --show-values `
        --query "[?name=='ui-password'].value | [0]" -o tsv
}

.\deploy.ps1 @deployParameters

Au premier déploiement, l’application n’existe pas encore : le script génère alors un mot de passe initial. Lors d’un redéploiement, le bloc if réutilise le mot de passe existant. Le paramètre ChromiumSandbox = $false est nécessaire pour les captures sur Container Apps : il est expliqué en section 10.

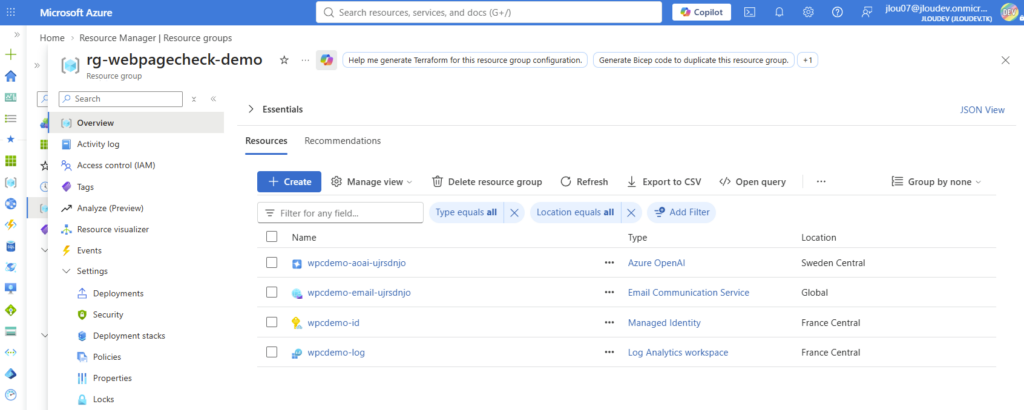
Les ressources Azure commencent à apparaître :

Par défaut, l’email et Azure OpenAI sont activés. Le modèle configuré dans le Bicep du projet est gpt-4.1-mini, version 2025-04-14, en déploiement Global Standard. Vérifiez sa disponibilité, son cycle de vie et votre capacité à le déployer avant de lancer le script. Les régions d’exemple ne constituent pas une garantie de disponibilité pour votre subscription.

Pour commencer sans IA, ajoutez cette ligne avant l’appel du script :

$deployParameters.DeployOpenAi = $false

Cette option conserve les modes changement et mot-clé. L’option DeployEmail = $false existe également, mais elle retire l’envoi d’emails attendu dans ce tutoriel. Choisissez vos options avant l’exécution, ne lancez pas chaque variante à la suite.

Le script déroule quatre opérations :

  1. Créer le groupe de ressources.
  2. Déployer l’infrastructure avec Bicep, sans l’application dans cette première passe.
  3. Construire l’image dans Azure Container Registry.
  4. Déployer la Container App avec l’image qui vient d’être construite.

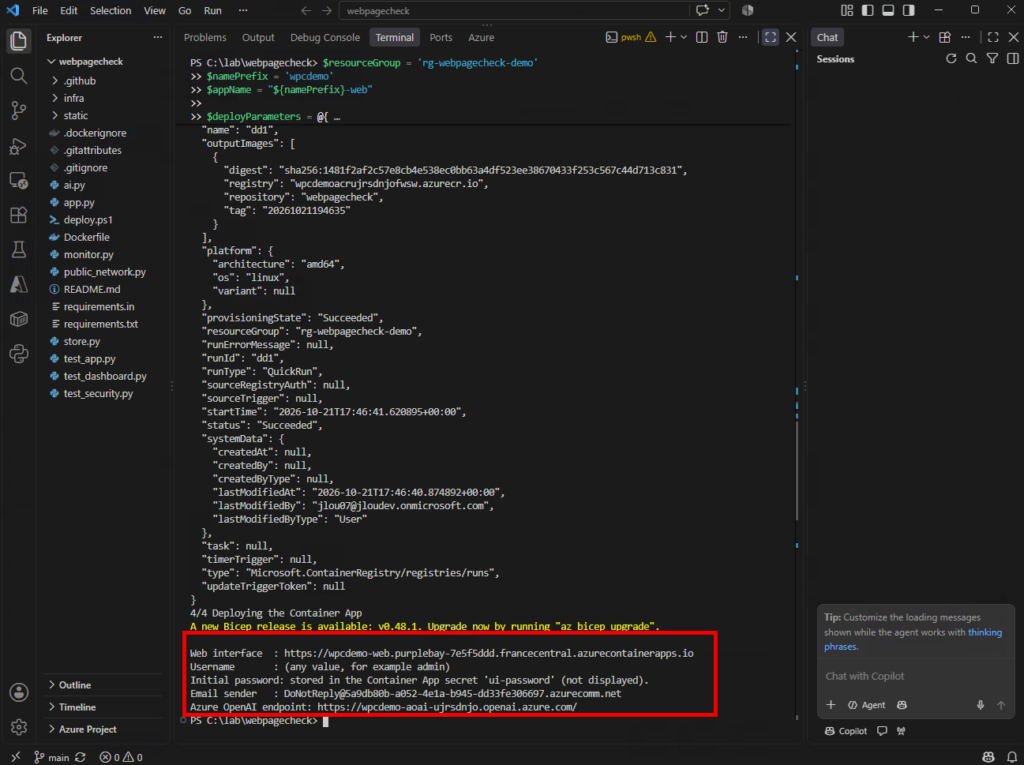
À la fin, le script affiche l’URL de l’interface, l’adresse expéditrice si l’email est activé et l’endpoint OpenAI si l’IA est activée :

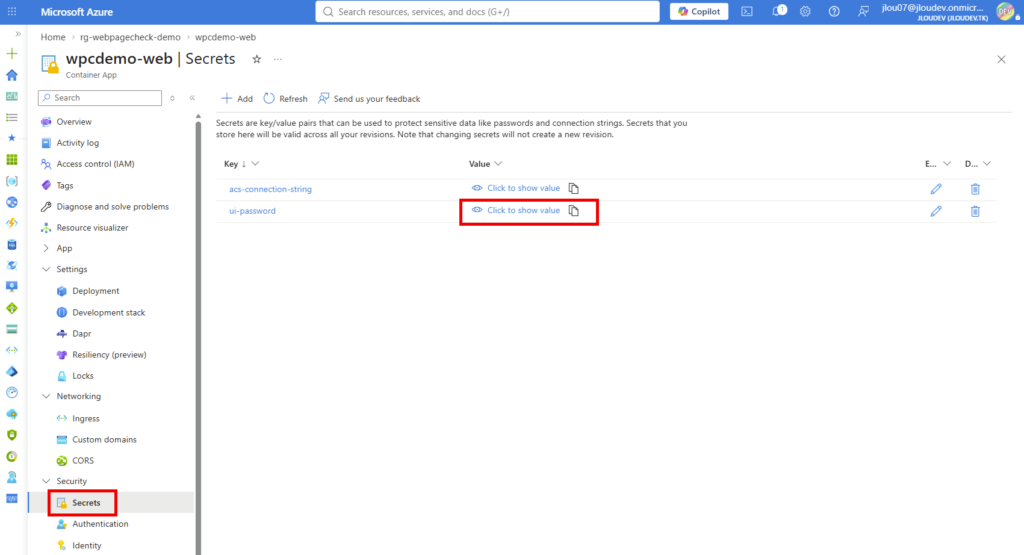
Il n’affiche pas automatiquement le mot de passe initial. Vous pouvez le retrouver ici côté portail Azure :

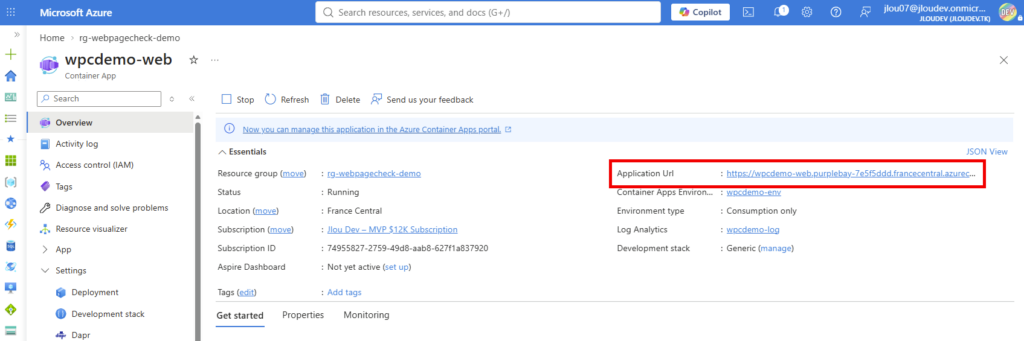
L’URL est aussi disponible juste là:

Attention : le script est un parcours complet d’infrastructure et de build, pas une simple commande de mise à jour de l’application. Sans paramètre UiPassword, chaque exécution génère un nouveau mot de passe initial et remplace ce secret. Ne le relancez pas au hasard pour corriger un réglage. Un identifiant déjà enregistré dans l’interface reste, lui, prioritaire sur ce mot de passe initial.

6. Ouvrir l’application et configurer l’accès

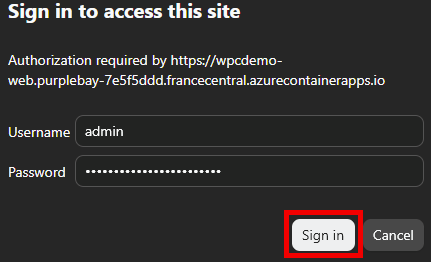
Ouvrez la page de l’application, puis saisissez les identifiants :

Vous voilà dans l’application, rien de plus !
7. Configurer les notifications email

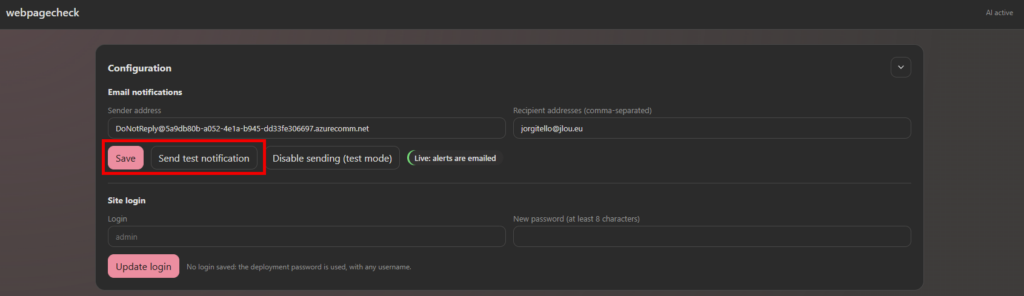
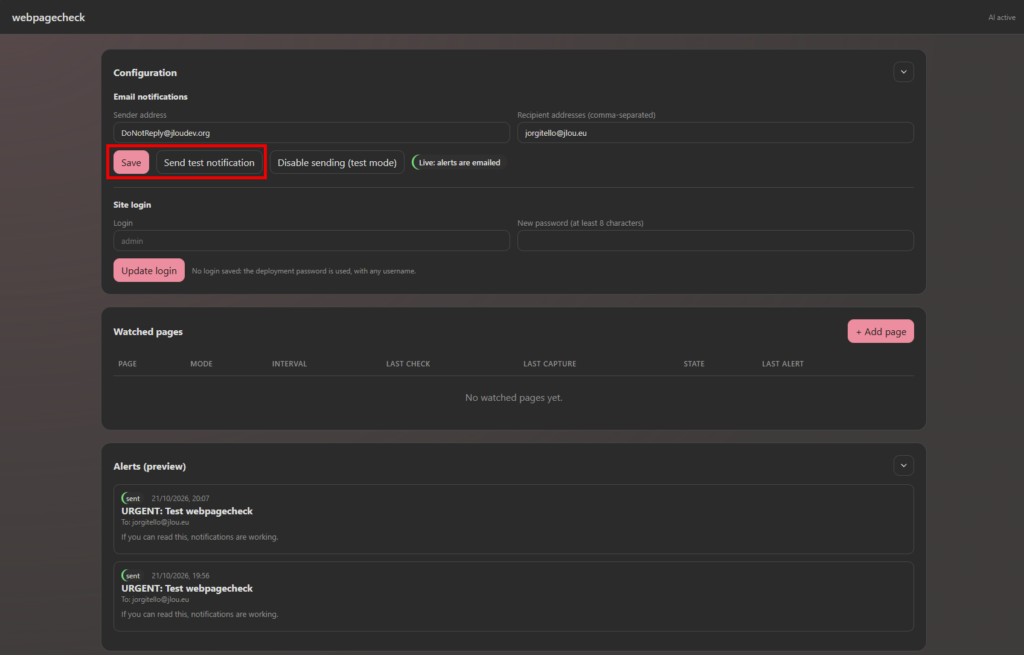
Dans le panneau Configuration, renseignez l’adresse expéditrice indiquée à la fin du déploiement et une adresse de destination que vous contrôlez. Pour le premier test, un seul destinataire suffit :

  1. Renseignez Sender address avec l’expéditeur fourni par le domaine Azure Communication Services. Une adresse arbitraire de votre messagerie ne convient pas.
  2. Renseignez Recipient addresses. Plusieurs adresses peuvent être séparées par des virgules.
  3. Enregistrez les paramètres.
  4. Vérifiez que l’envoi est actif et utilisez Send test notification pour recevoir un véritable email.

En mode test, les alertes sont conservées comme simulées dans l’interface, mais aucun email ne part. Le test de notification est lui aussi simulé lorsque l’envoi est désactivé. Un statut simulé ne prouve donc pas que votre messagerie a reçu quelque chose.

Attention : pour un domaine géré par Azure, la documentation Microsoft indique une limite de 5 emails par minute et 10 par heure, à l’échelle de la subscription. Ces limites ne sont pas augmentables pour ce type de domaine. Les essais et les destinataires multiples consomment ce budget. Un domaine personnalisé vérifié permet de demander des limites supérieures.

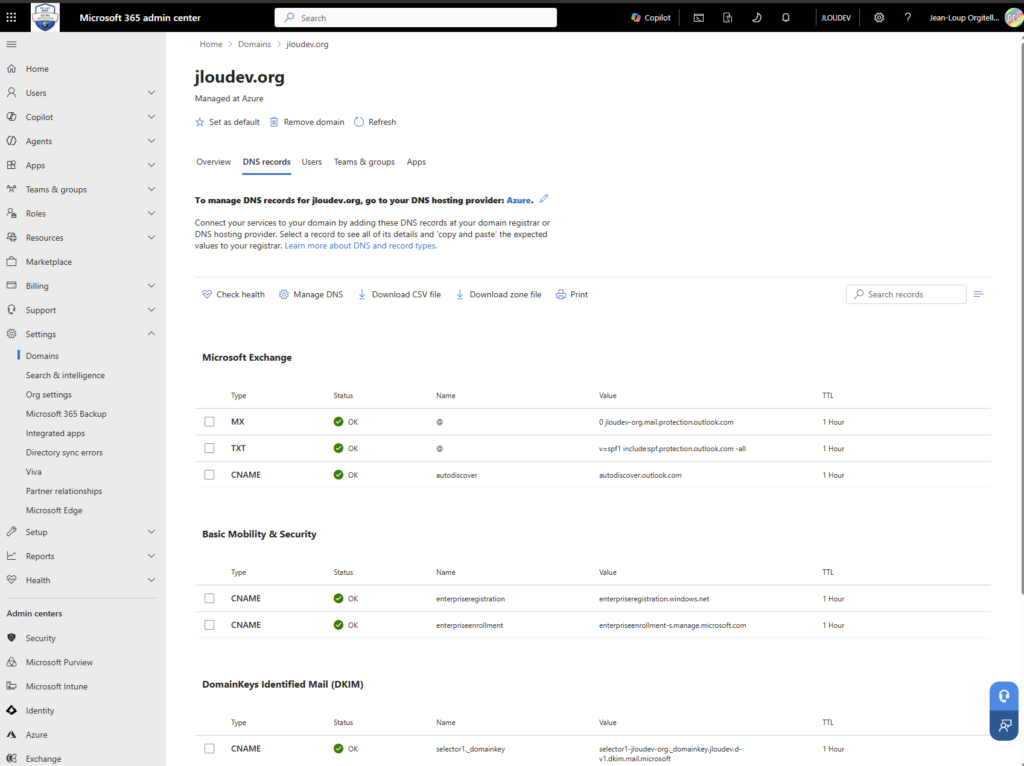
Si vous utilisez votre propre domaine, c’est parfaitement possible. Voici un domaine déjà utilisé dans Microsoft 365 :

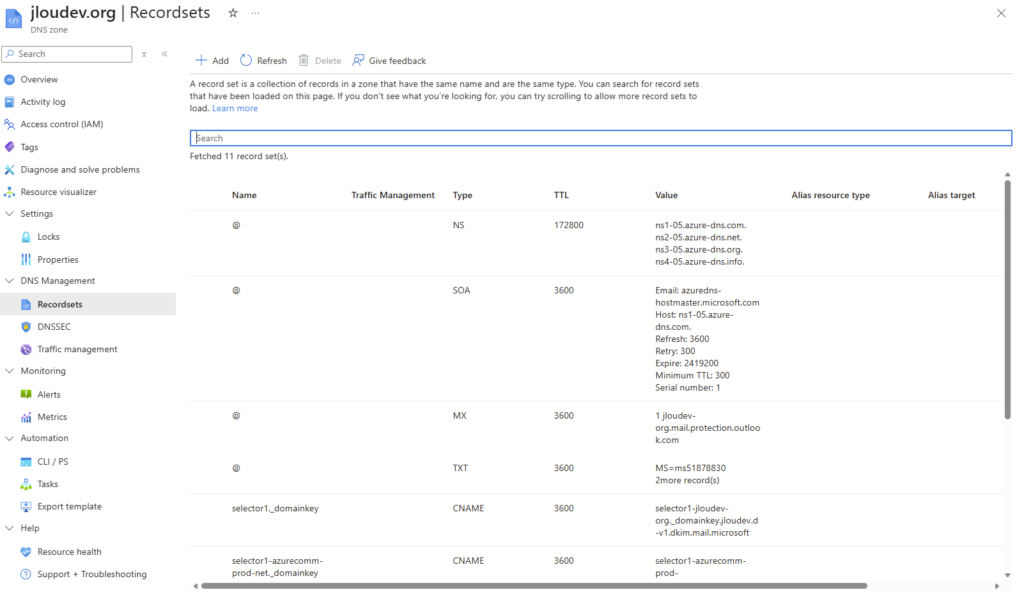
Et dont la zone DNS est gérée sous Azure :

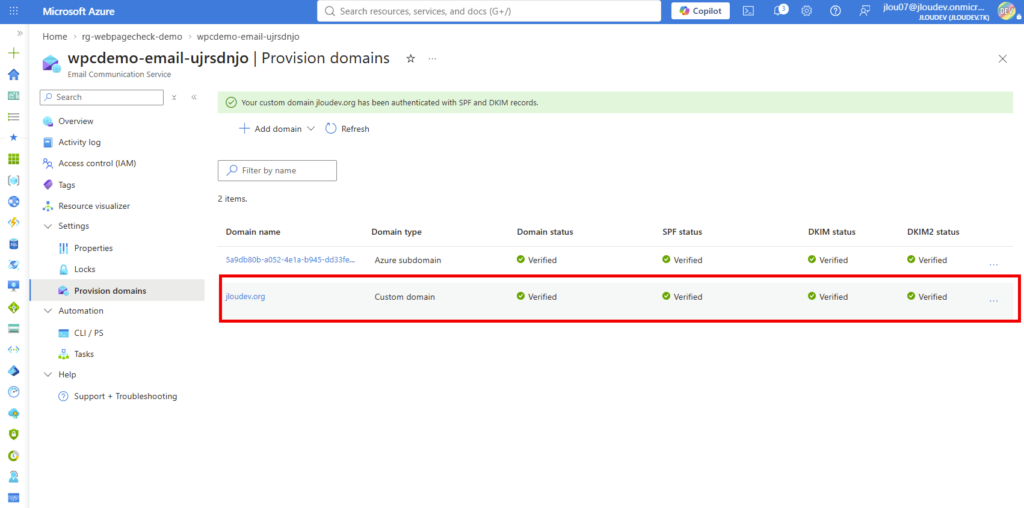
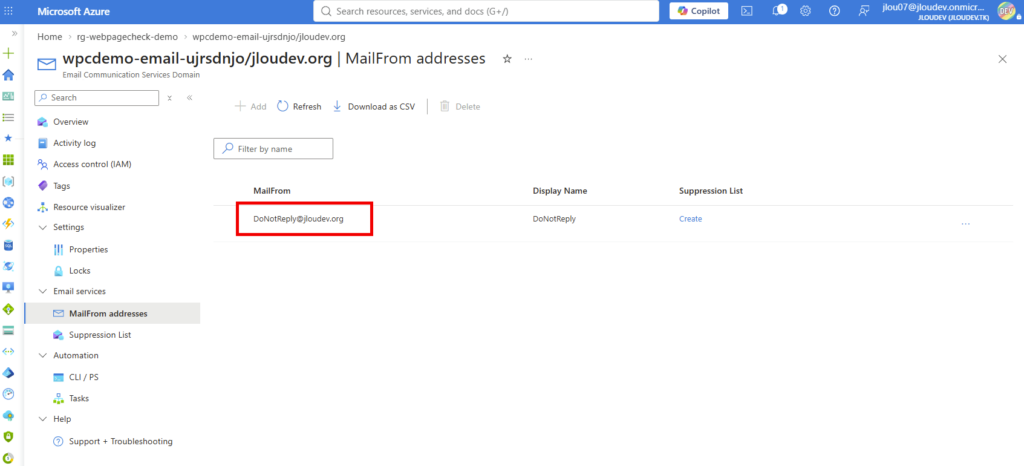
Depuis le portail Azure, sur les ressources créées, commencez par le vérifier dans le service Email :

Créez si besoin un MailFrom :

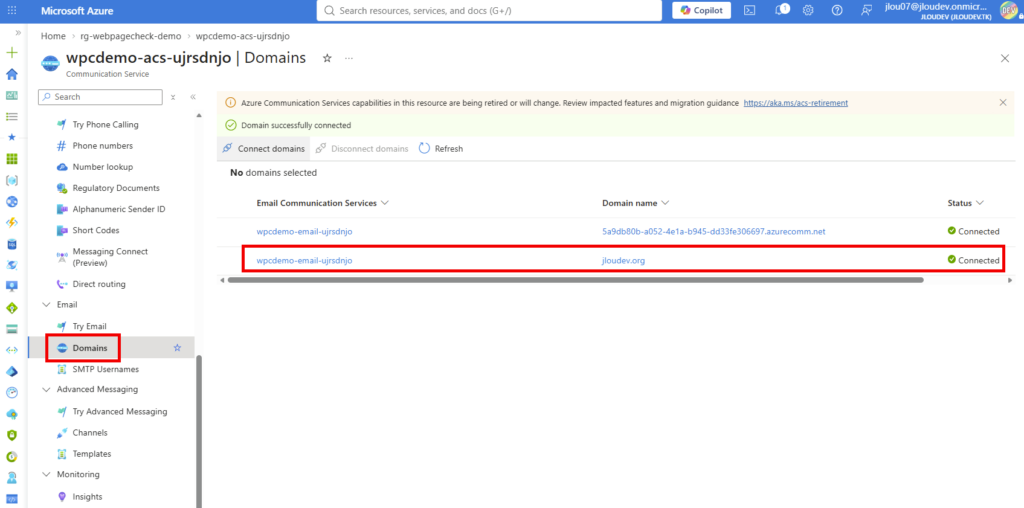
Puis liez-le à la ressource Communication Services :

Reconfigurez puis refaites un test d’envoi :

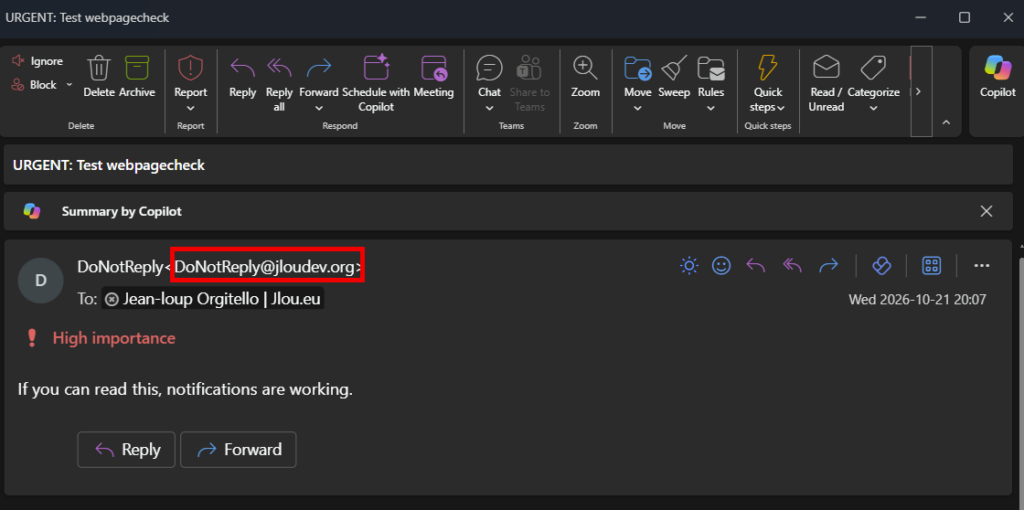
Contrôlez la bonne réception du test :

L’option CustomEmailDomain du script doit être conservée lors de ses prochaines exécutions : sinon, le déploiement revient au seul lien avec le domaine Azure.

8. Créer et tester une première surveillance

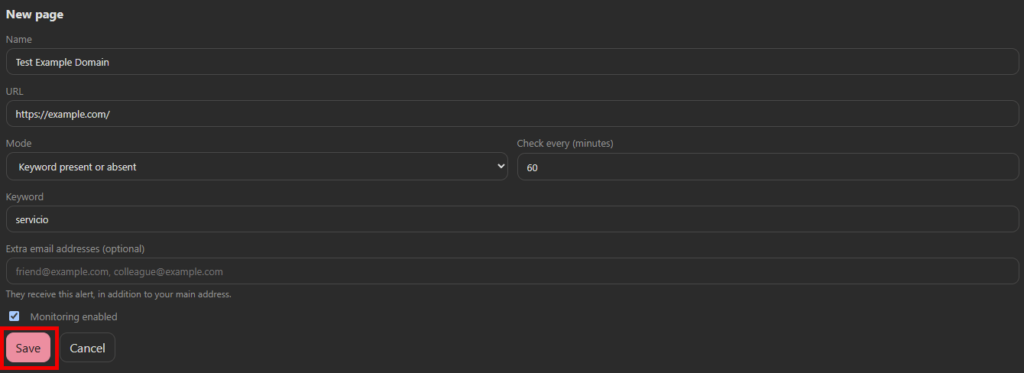
On commence avec un cas simple et sans IA. Ajoutez une page avec les valeurs suivantes :

ChampValeur d’exemple
NameTest Example Domain
URLhttps://example.com/
ModeKeyword
Keywordservicio
Interval60 minutes
Extra email addressesLaisser vide pour le premier test.

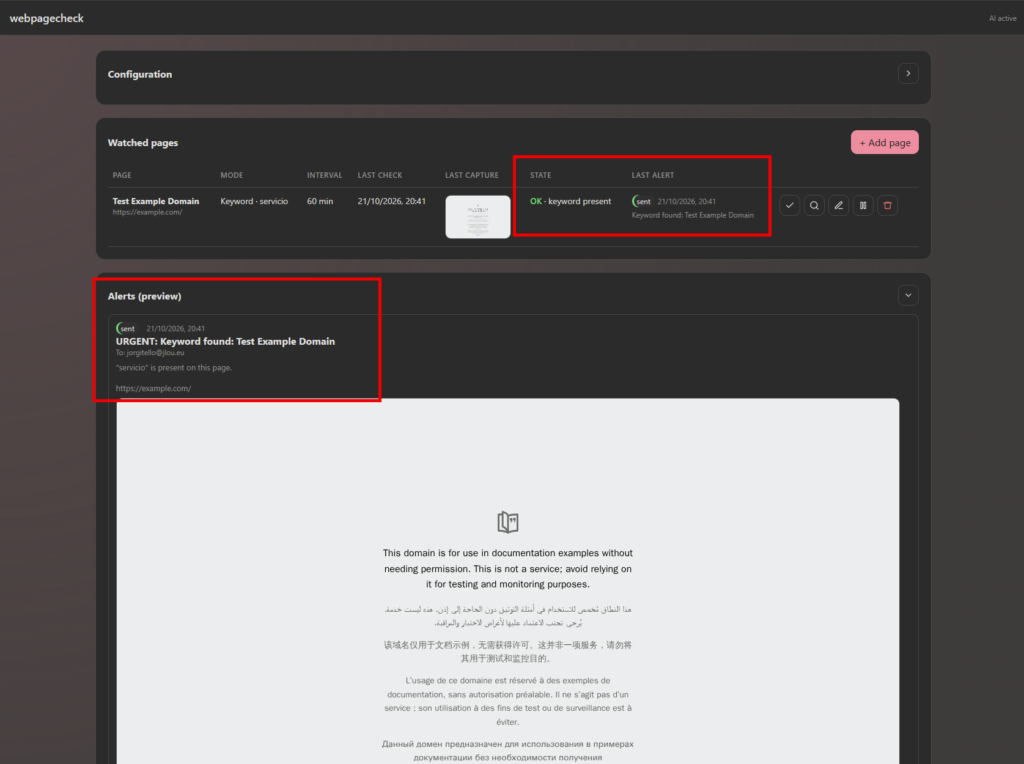
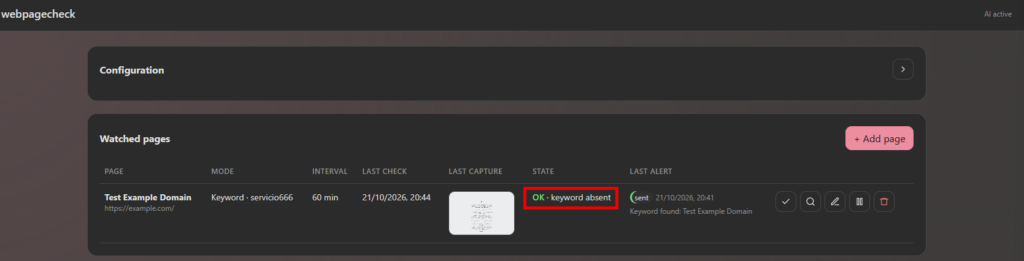
Enregistrez la page, puis attendez quelques secondes le résultat de l’analyse automatique :

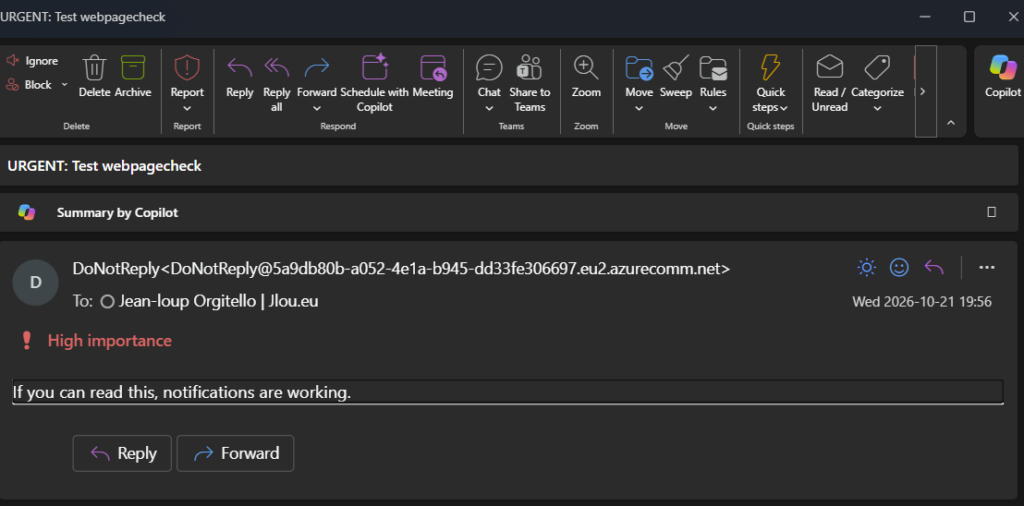
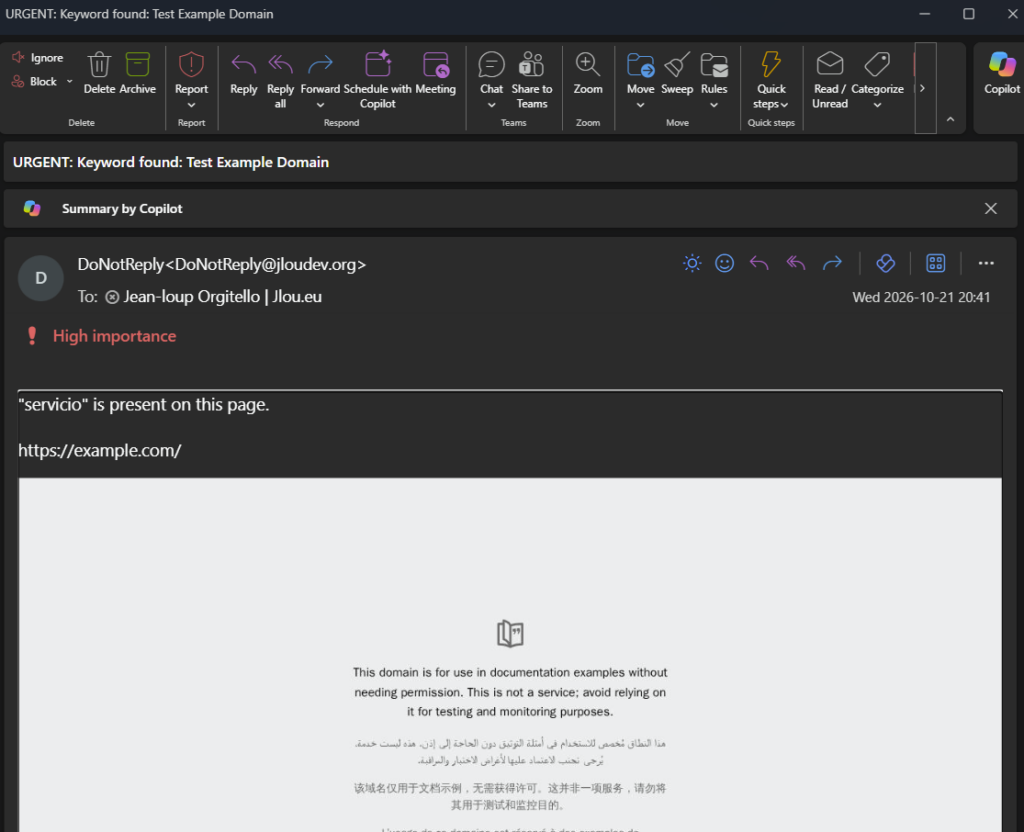
Quelques secondes plus tard, le mail d’alerte arrive également :

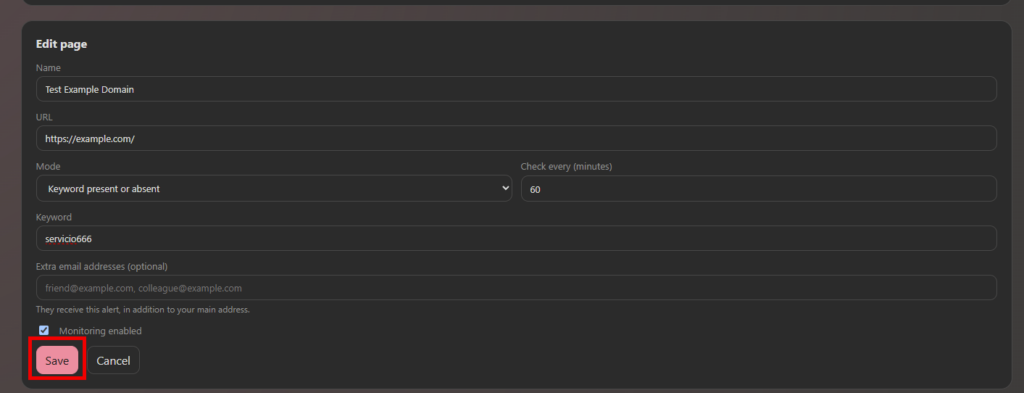
Modifiez le test existant en remplaçant le mot par un autre qui n’existe pas, sauvegardez :

Quelques secondes plus tard, constatez le résultat de la seconde analyse automatique :

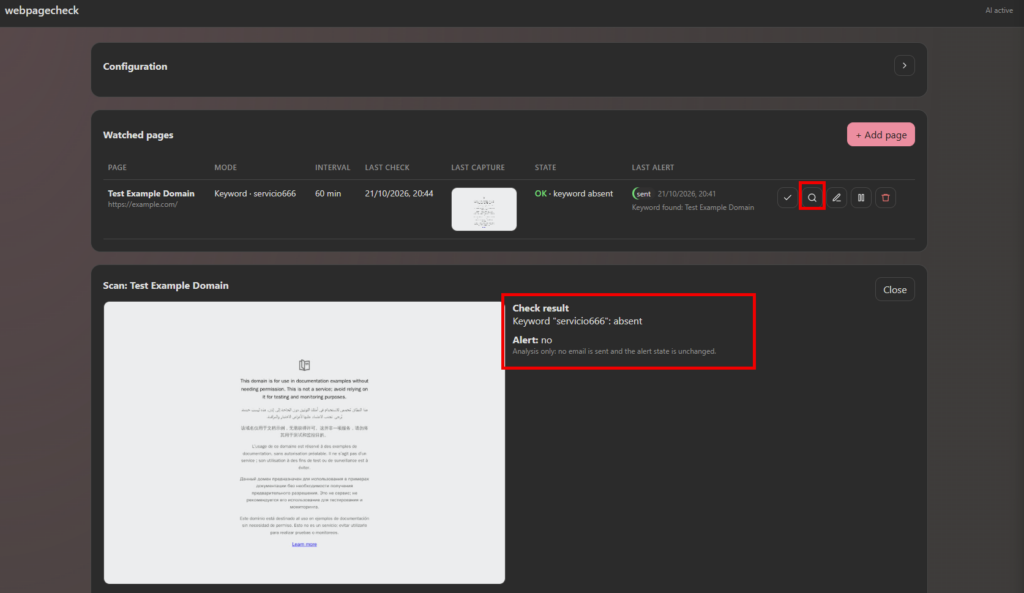
L’icône Scan affiche l’analyse et le contenu de l’email qui serait préparé. Le Scan ne modifie pas l’état de référence de la surveillance et n’envoie pas d’email :

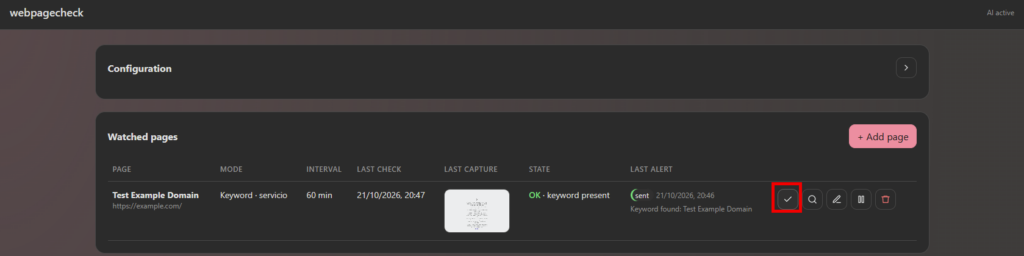
L’icône Check now est différente : elle réalise une vraie vérification, met à jour l’état et peut déclencher une alerte si la condition le justifie :

Le piège classique : réactiver les emails après une détection simulée ne rejoue pas cette alerte. Le moteur suit des transitions. Pour vérifier une alerte réelle, utilisez ensuite un changement contrôlé sur une page publique que vous maîtrisez, ou une surveillance de test distincte. N’attendez pas qu’un Scan expédie un message : ce n’est pas son rôle.

Le moment de vérité : une fois l’analyse validée, réactivez l’envoi et provoquez une transition contrôlée. Vérifiez la réception de l’email, puis son statut dans Alerts. Une fois ce parcours validé, choisissez un intervalle raisonnable pour vos vraies surveillances.

9. Aller plus loin avec le mode IA

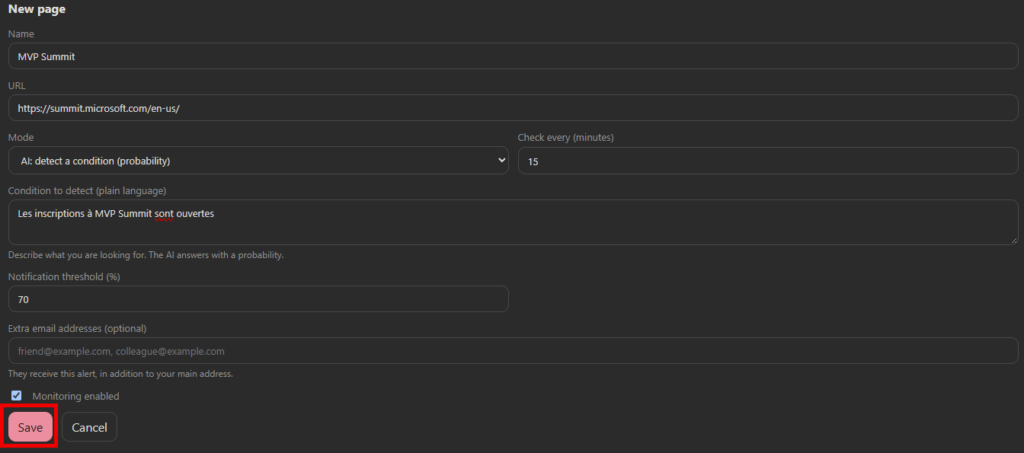
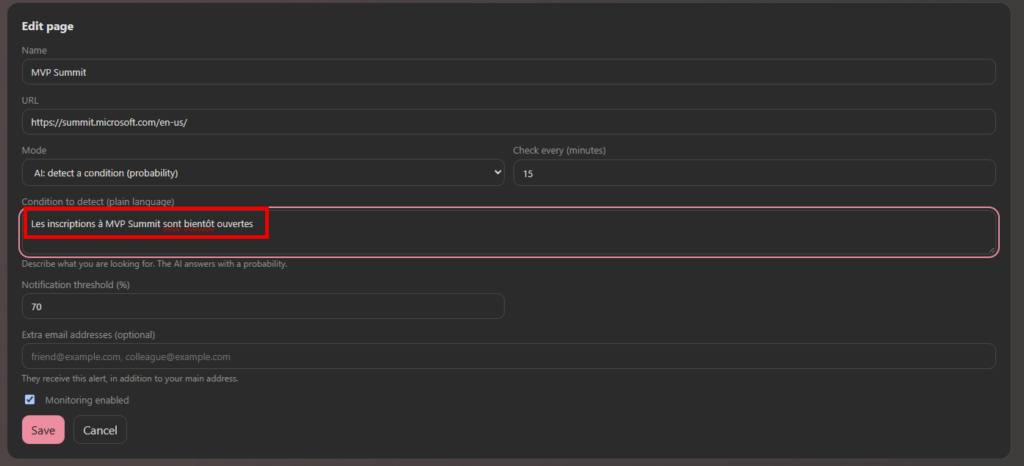
Si Azure OpenAI a été déployé, le badge de l’interface indique que l’IA est active. Vous pouvez créer une surveillance en mode AI, décrire votre condition et fixer le seuil de déclenchement. La valeur par défaut est 70 %.

Sur une page d’inscription publique, une condition utile serait par exemple : « Les inscriptions sont ouvertes et un lien permet de s’inscrire maintenant, pas seulement de consulter la date d’ouverture. » Soyez précis sur ce qui distingue le résultat attendu d’une simple annonce.

Le modèle reçoit la condition et le texte extrait de la page, limité aux 12 000 premiers caractères. Il retourne un score et une explication. L’application utilise son identité managée pour appeler Azure OpenAI dans ce déploiement : vous n’avez pas de clé OpenAI à coller dans le navigateur.

Attention : le score n’est pas une probabilité statistiquement calibrée. Une page peut être ambiguë ou contenir des instructions trompeuses pour le modèle. Vérifiez la page avant une décision importante et gardez à l’esprit que même un Scan en mode IA consomme des appels au service.

Changez le test pour vérifier le comportement :

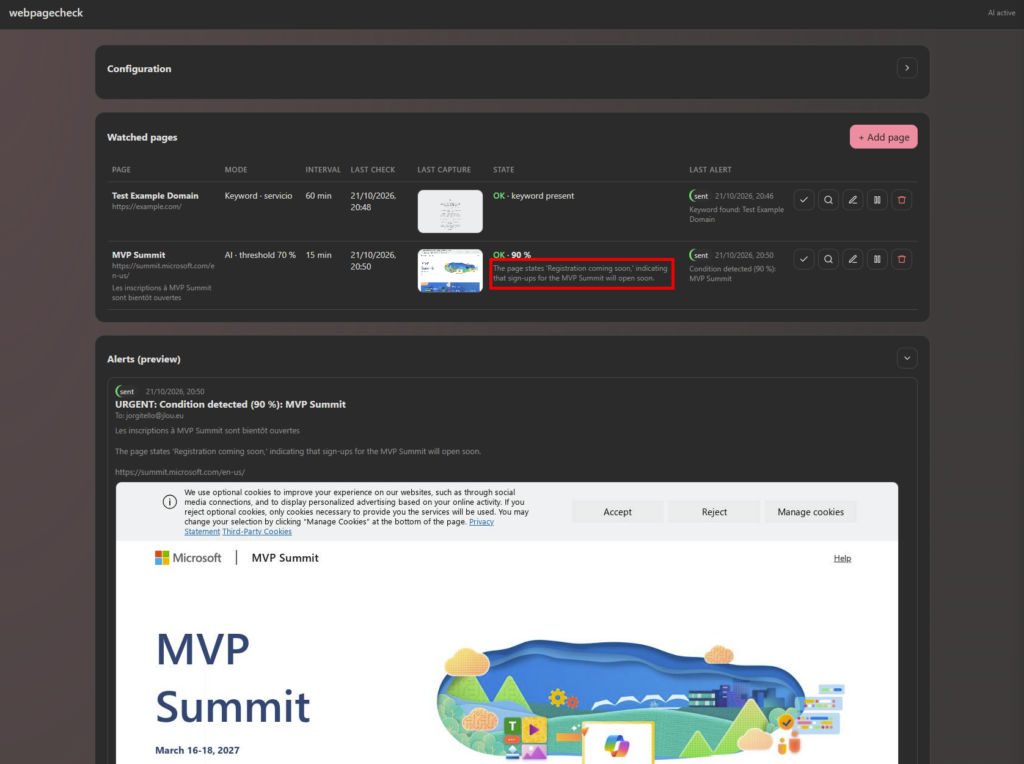
L’IA arrive bien à faire la distinction avec ce changement de test :

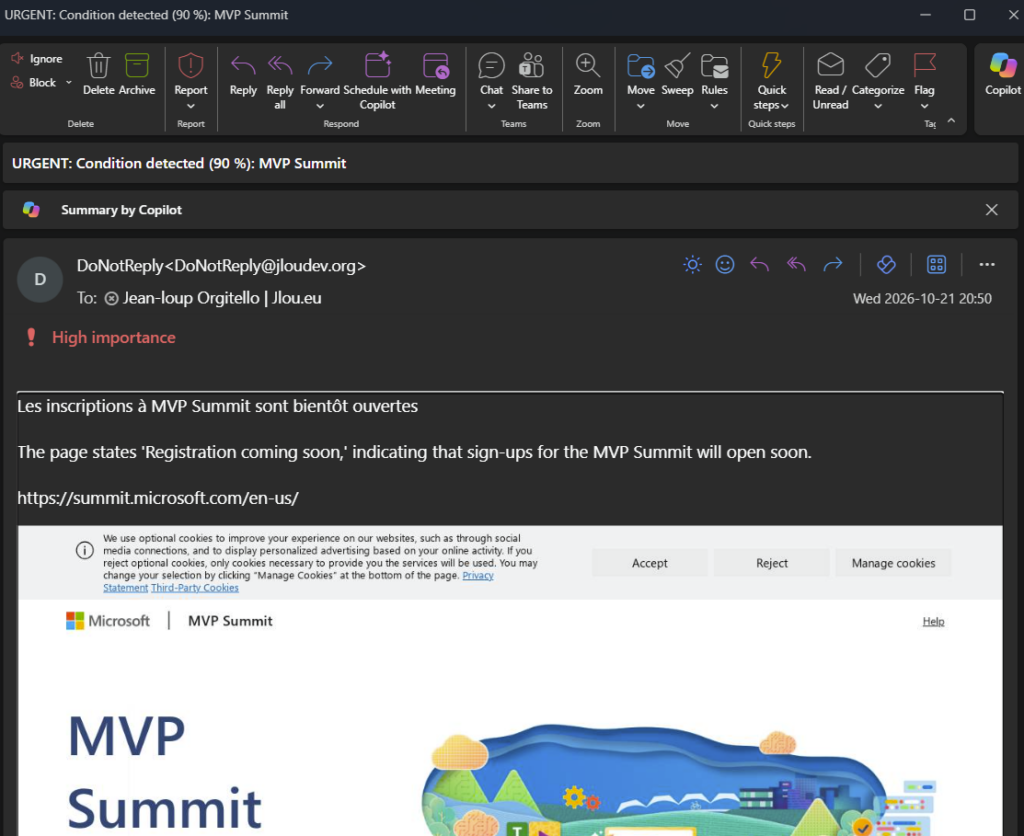
Et l’email d’alerte arrive bien :

10. Comprendre les captures et le choix de sandbox

Chaque véritable contrôle essaie de prendre une capture, même sans alerte à envoyer. La colonne Last capture donne accès à cette image. Seule la dernière capture de contrôle est conservée par page, dans le stockage persistant. Le Scan dispose de sa propre capture et ne remplace pas celle du dernier contrôle :

Si une capture échoue, l’ancienne image est retirée plutôt que présentée comme récente. La collecte du texte et les alertes peuvent continuer sans image. Consultez les journaux pour distinguer un échec de navigation, un blocage du site et un problème de lancement de Chromium.

La sandbox Chromium est activée par défaut dans le code et dans le Bicep. Sur Azure Container Apps, elle ne peut pas démarrer : le conteneur n’a pas accès aux namespaces utilisateur et Chromium s’arrête avec l’erreur No usable sandbox!. C’est pourquoi le déploiement de la section 5 passe ChromiumSandbox = $false. Il n’existe aucun basculement automatique vers un navigateur sans sandbox.

Attention : désactiver la sandbox réduit l’isolation du navigateur. Le navigateur partage alors toujours le conteneur de l’application, ses données et son accès aux secrets. Pour une isolation plus forte, préférez un service de capture séparé. L’anti-SSRF ne remplace pas une sandbox.

Si vous avez déployé sans ce paramètre et que les journaux affichent cette erreur, la commande suivante change uniquement cette variable d’environnement et crée une nouvelle révision, sans relancer tout le déploiement :

az containerapp update `
    --resource-group $resourceGroup `
    --name $appName `
    --set-env-vars CHROMIUM_SANDBOX=false `
    --output none

Ce choix ne désactive ni le proxy public uniquement, ni les vérifications TLS, ni l’utilisateur non-root du conteneur. Si vous rejouez plus tard le déploiement complet, l’option PowerShell correspondante est -ChromiumSandbox:$false. Sans cette option, le modèle Bicep réactive la sandbox. Ne réduisez pas l’isolation simplement pour faire disparaître un message d’erreur non diagnostiqué.

11. Les pièges à connaître avant de laisser tourner

Une capture visible n’est pas la preuve que le texte surveillé est complet

Les modes mot-clé et IA lisent le texte de la page rendue par Chromium, après exécution du JavaScript : un texte ajouté dynamiquement, comme les traductions de la page example.com, est donc bien détecté. Si Chromium échoue, l’application se rabat sur le HTML brut de la collecte HTTP, qui peut ne pas contenir ce texte. Le mode changement compare toujours le HTML brut, pour éviter les fausses alertes dues aux éléments dynamiques. Les pages avec authentification, CAPTCHA ou protection anti-bot peuvent également ne pas convenir. Testez votre cible avec le Scan avant de lui faire confiance.

Uniquement des destinations publiques

Les URL privées, locales et de métadonnées cloud sont refusées. Les redirections et les ressources chargées par Chromium passent par un proxy temporaire authentifié qui vérifie les adresses et se connecte à l’adresse IP contrôlée. Ce n’est donc pas un outil pour surveiller votre intranet. Respectez aussi les conditions d’utilisation des sites surveillés et évitez les fréquences agressives.

Une seule réplique pour cette version

La persistance repose sur un fichier JSON et des images dans Azure Files. Le déploiement fixe une réplique minimum et maximum. Ne montez pas simplement le nombre de répliques pour « faire plus robuste » : cette version ne dispose pas d’un ordonnanceur distribué ni d’une coordination multi-instance.

Prévoir une vraie frontière de sécurité

L’interface utilise une authentification Basic sur HTTPS. Cela ne fournit pas, à lui seul, un SSO Entra ID, du MFA ou une gestion multi-utilisateur. Pour une exposition plus large qu’un usage personnel ou de lab, étudiez un contrôle d’accès en amont, des restrictions réseau adaptées et une protection contre les tentatives répétées de connexion.

Les dépendances Python sont verrouillées avec des hachages et l’image s’exécute avec un utilisateur non-root. Des tests couvrent notamment les URL privées, les redirections, le DNS rebinding, la validation TLS et le traitement du mot de passe au déploiement. Ces protections ne constituent pas une certification de sécurité : maintenez aussi l’image de base, les paquets système et Chromium à jour, et réalisez un audit de vulnérabilités avant une exposition sensible.

12. Combien ça coûte ?

Voici une estimation pour un mois complet avec les paramètres par défaut du script : une page ou quelques pages contrôlées toutes les heures, Container Apps en France Central et Azure OpenAI en Sweden Central. Les prix sont les tarifs publics en dollars, relevés en octobre 2026, hors remise et hors taxes.

ComposantBase de facturationEstimation mensuelle
Container Apps (0,5 vCPU, 1 Gio, une réplique permanente)vCPU actif 0,000024 $/s, inactif 0,000003 $/s. Mémoire 0,000003 $/Gio-s. Offre gratuite mensuelle de 180 000 vCPU-s et 360 000 Gio-s par subscription.≈ 10 $ si la réplique est surtout inactive, jusqu’à ≈ 34 $ si elle est active en permanence.
Container Registry Basic0,1666 $ par jour.≈ 5 $
Azure Files (Standard LRS, quota 1 Gio)0,075 $ par Go et par mois, plus les transactions.< 0,50 $
Log Analytics5 Go gratuits par mois, puis 2,76 $ par Go.≈ 0 $ pour ce lab
Azure OpenAI gpt-4.1-mini (Global Standard)0,40 $ par million de tokens en entrée, 1,60 $ en sortie.≈ 0,15 à 1,20 $ pour une page en mode IA contrôlée toutes les heures
Communication Services Email0,00025 $ par email, plus 0,00012 $ par Mo.Quelques centimes
Total≈ 15 à 16 $ par mois (environ 14 €) pour un usage léger

La facture est dominée par deux postes fixes : la réplique Container Apps qui tourne en permanence et le registre ACR. Les appels IA, le stockage et les emails restent marginaux à cette échelle.

Ce que j’ai réellement payé

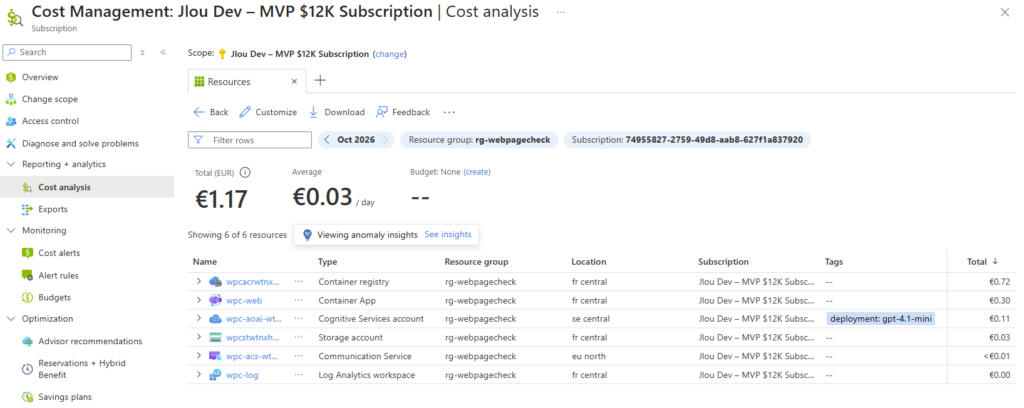
Sur mon lab, du 16 au 21 octobre 2026, soit environ 5 jours, Cost Management affiche environ 1,17 € pour le groupe de ressources : 0,72 € pour ACR, 0,30 € pour Container Apps, 0,11 € pour Azure OpenAI, 0,03 € pour le stockage, 0,01 € pour l’email et 0 € pour Log Analytics.

Attention : ne multipliez pas ce chiffre par six pour obtenir un mois. L’offre gratuite mensuelle de Container Apps a absorbé l’essentiel du calcul sur ces premiers jours. Elle est partagée entre toutes les Container Apps de la subscription : si vous en avez déjà d’autres, elle sera consommée plus vite.

Comment réduire la facture

  • Désactivez l’IA si les modes changement et mot-clé suffisent : $deployParameters.DeployOpenAi = $false.
  • Choisissez des intervalles raisonnables : chaque contrôle lance Chromium et, en mode IA, un appel au modèle.
  • Ne comptez pas sur le scale to zero : le planificateur tourne dans le processus de l’application, la réplique minimum est donc fixée à 1 dans cette version.
  • Créez un budget Azure avec une alerte sur le groupe de ressources avant de laisser tourner le lab.
  • À la fin du lab, supprimez tout le groupe de ressources : az group delete --name $resourceGroup --yes --no-wait. La ressource Azure OpenAI passe alors en suppression réversible : purgez-la si vous voulez réutiliser le même nom.

Pour votre propre estimation, utilisez la calculatrice de prix Azure et les pages de tarifs de Container Apps, Container Registry et Azure OpenAI. Pour le budget, suivez le tutoriel Créer et gérer des budgets, Microsoft Learn.

13. Conclusion

Voilà, du déploiement PowerShell à la première surveillance, vous avez de quoi automatiser une vérification que vous faisiez jusque-là à la main. Le plus intéressant n’est pas forcément d’ajouter de l’IA partout : un mot-clé bien choisi ou un simple suivi de changement peut déjà répondre au besoin.

Les pièges à retenir : choisir la bonne subscription, distinguer Scan et Check now, surveiller les quotas email et ne pas confondre une capture réussie avec une analyse complète de la page. Pour les captures, le compromis de sandbox doit rester un choix explicite, pas un détail caché.

Foncez tester en lab, avec une page publique et une boîte de réception que vous contrôlez. Validez le parcours complet avant de laisser tourner vos vraies surveillances.

🤖
Contenu assisté par IA Cet article a été rédigé avec l’assistance d’une intelligence artificielle et relu par l’auteur.

IA Azure : Convertissez un Word en mp3

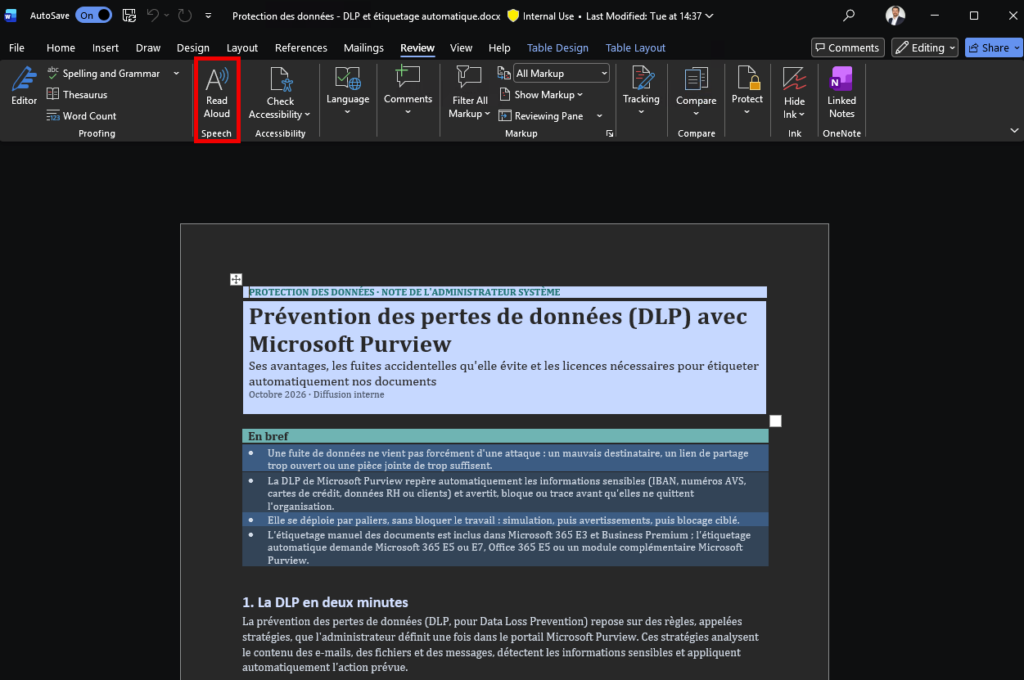
Vous utilisez la Lecture à voix haute de Word pour écouter vos lonnnnnnnnnng textes, mais vous aimeriez les emporter ailleurs, dans le train, en voiture ou en balade ? Le problème, c’est que Word lit le document pendant qu’il est ouvert, et c’est tout. Moi, je voulais un vrai fichier MP3, autonome, qu’on peut réécouter n’importe où. Et comme mes documents sont longs (très longs), j’ai automatisé la conversion avec un petit outil maison : WordToMp3.

Au programme : le fonctionnement de l’outil en quelques lignes, puis trois tests concrets, du dry run jusqu’à un document de 183 773 caractères transformé en plus de 3 heures d’audio.

1. Dictée, Lecture à voix haute, WordToMp3 : de quoi on parle ?

Premier réflexe à prendre : ne pas confondre les fonctionnalités. Word sait transformer la voix en texte, et le texte en voix. Mais aucune des deux ne correspond exactement à ce que je cherchais.

FonctionnalitéSensÀ quoi ça sert
Dicter (Word)Voix ➜ texteParler pour écrire un document.
Lecture à voix haute (Word)Texte ➜ lecture audioÉcouter un document dans Word.
WordToMp3Document ➜ texte extrait ➜ voix de synthèse ➜ MP3Produire un fichier audio autonome.

Mon point de départ, c’est donc la Lecture à voix haute, pas la Dictée. L’idée n’est pas d’enregistrer ce que Word lit :

WordToMp3 extrait le texte du document et demande une narration toute neuve à Azure Speech. La voix ne sera donc pas forcément celle que vous entendez dans Word.

2. Pourquoi un script pour un long document ?

Un script n’est pas la seule solution possible : une appli d’export audio ou un enregistrement de l’écran pourraient aussi faire l’affaire. Mais dès que le document dépasse quelques pages, les questions pratiques arrivent vite :

  • comment lire un vieux .doc sans toucher au fichier d’origine ?
  • comment éviter une seule requête de synthèse énorme ?
  • que se passe-t-il si le réseau coupe à la moitié ?
  • comment garder les passages dans le bon ordre ?
  • comment obtenir un seul MP3 plutôt qu’une centaine de petits fichiers ?
  • comment garder ma clé Azure et mes textes privés hors de GitHub ?

Ce qui m’intéresse ici, c’est d’avoir un traitement reproductible et capable de reprendre là où il s’est arrêté. La répartition des rôles est simple : Python orchestre, Word sert uniquement à extraire le texte, Azure Speech génère la voix et FFmpeg assemble le MP3 final.

3. Comment ça marche ?

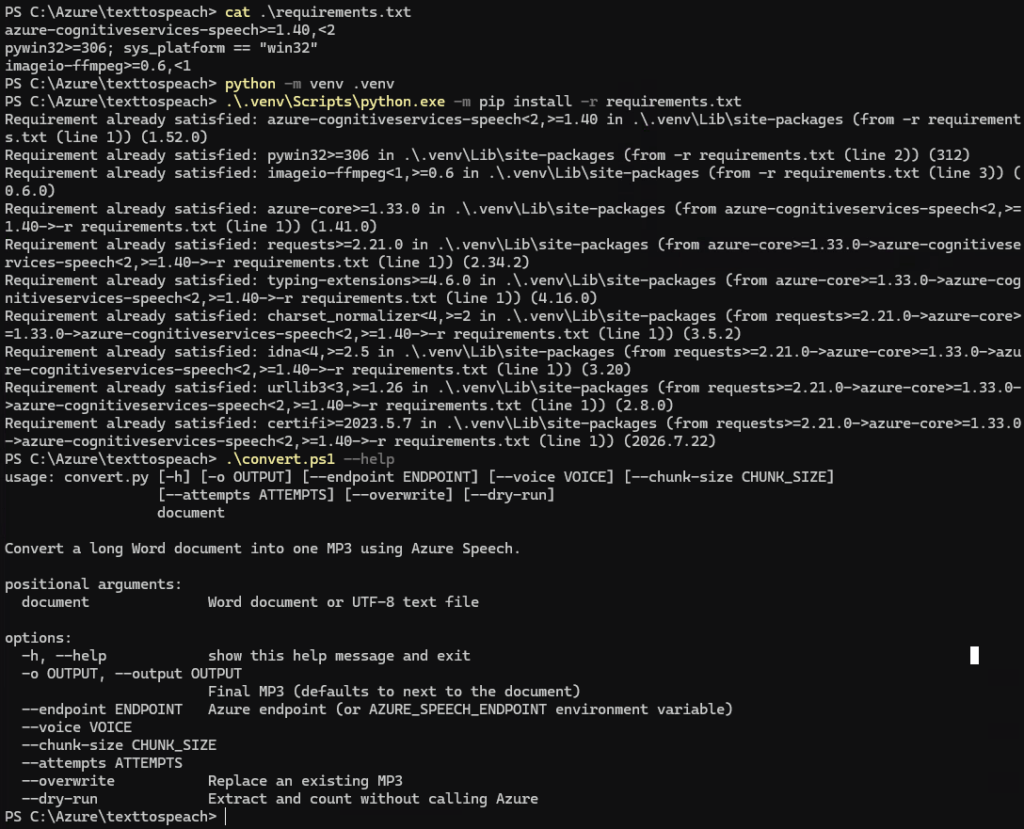
WordToMp3 est une application en ligne de commande pour Windows, qu’on lance depuis PowerShell. Pas d’interface graphique, pas de site web : un lanceur convert.ps1 qui appelle le script Python convert.py, et c’est tout :

Concrètement, ça donne quoi ? Le traitement se déroule en cinq temps :

  1. Extraction : pour un .doc ou un .docx, le script ouvre une instance Word séparée et invisible, en lecture seule, macros désactivées. Il récupère le corps du texte (tableaux compris), puis les notes de bas de page et de fin. Il referme ensuite sans enregistrer. Les fichiers .txt en UTF-8 sont lus directement, sans Word.
  2. Découpage : le texte est nettoyé puis coupé en segments de 2 000 caractères maximum, de préférence à la fin d’un paragraphe, sinon d’une phrase.
  3. Synthèse : chaque segment est envoyé à Azure Speech (voix fr-FR-DeniseNeural par défaut), un par un, et revient sous forme de fichier WAV.
  4. Cache : chaque WAV est vérifié puis conservé à côté du futur MP3. Si on relance, les segments valides sont réutilisés.
  5. Assemblage : FFmpeg encode tous les WAV en une seule passe (MP3 128 kbit/s, 24 kHz, mono), puis relit le MP3 en entier pour vérifier qu’il est lisible avant de le publier.

Pourquoi passer par des WAV plutôt que de coller directement des MP3 ? Parce qu’un WAV non compressé se vérifie et s’ordonne facilement. Et un seul encodage final évite de mettre bout à bout des dizaines de MP3 compressés séparément.

4. Installation et lancement

Côté prérequis, rien d’exotique :

ÉlémentDétail
SystèmeWindows, avec Microsoft Word installé (pour les fichiers .doc et .docx)
PythonUn environnement virtuel local (testé chez moi avec Python 3.11.9)
DépendancesAzure Speech SDK, pywin32 et imageio-ffmpeg (qui fournit FFmpeg, pas besoin de l’installer à part)
AzureUne ressource Speech avec son endpoint et sa clé
DisqueDe la place pour le cache WAV et le MP3 final

L’installation tient en trois lignes :

python -m venv .venv
.\.venv\Scripts\python.exe -m pip install -r requirements.txt
.\convert.ps1 --help

Ensuite, on renseigne l’endpoint de sa ressource Azure et on lance la conversion :

$env:AZURE_SPEECH_ENDPOINT = "https://your-resource.cognitiveservices.azure.com/"
.\convert.ps1 "C:\Documents\book.docx" -o "C:\Audio\book.mp3"

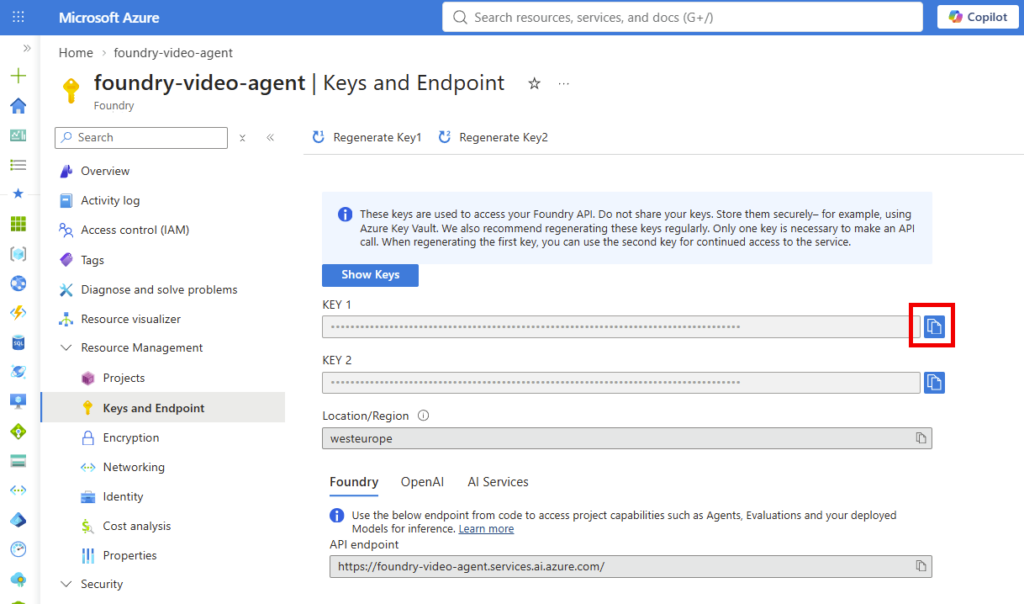
Si la variable AZURE_SPEECH_KEY n’est pas définie, le script demande la clé avec une saisie masquée :

Quelques options utiles : --voice pour changer de voix, --chunk-size pour la taille des segments (de 100 à 3 000 caractères), --attempts pour le nombre de tentatives par segment, et --overwrite pour remplacer un MP3 existant.

Attention : ne mettez jamais votre vraie clé dans une commande publiée, dans l’historique du terminal ou sur une capture. Masquez aussi le nom de votre ressource Azure dans vos captures. Le fichier .env.example du dépôt ne contient que des valeurs d’exemple, et le script ne charge pas les fichiers .env tout seul.

5. Trois tests concrets

Le moment de vérité. Trois tests, du plus prudent au plus costaud.

Test n°1 : le dry run, sans toucher à Azure

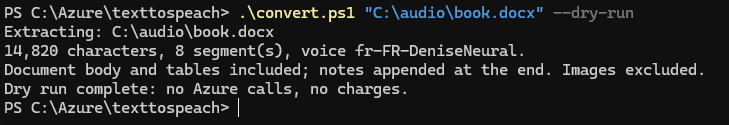
Avant de dépenser le moindre centime, on vérifie que l’extraction et le découpage se passent bien. Le mode --dry-run s’arrête juste avant la synthèse : pas de clé demandée, pas d’appel à Azure, pas de fichier audio.

.\convert.ps1 .\docs\article\sample-narration.txt --dry-run

Sur le texte de démonstration fourni dans le dépôt, résultat : 14820 caractères, un seul segment, aucun appel à Azure :

Attention, le dry run ne vérifie ni la clé, ni les quotas, ni la disponibilité de la voix, ni la qualité audio. Il valide juste la partie locale.

Test n°2 : un document Word de taille raisonnable

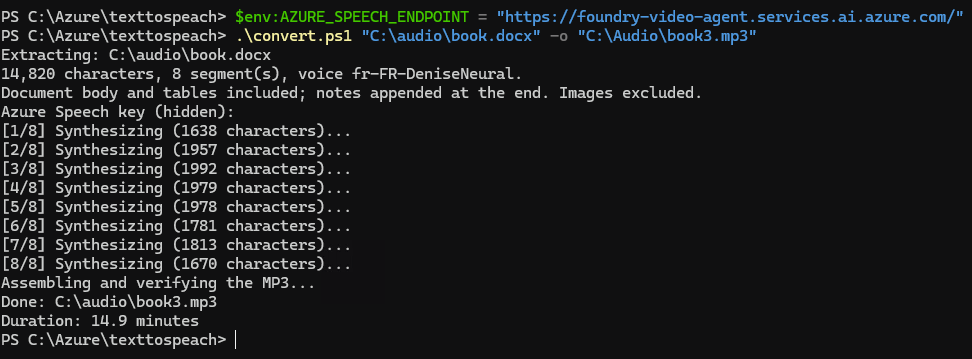
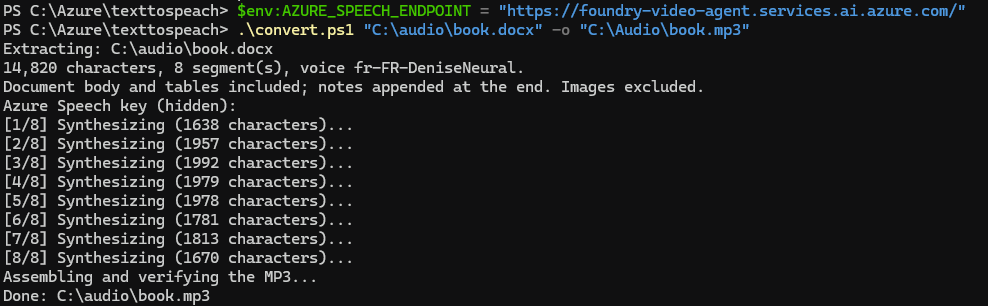
Premier vrai passage par Azure Speech avec un .docx : 14 820 caractères, découpés en 8 segments, voix fr-FR-DeniseNeural. Le script affiche l’avancement segment par segment, puis assemble et vérifie le MP3.

Extracting: C:\audio\book.docx
14,820 characters, 8 segment(s), voice fr-FR-DeniseNeural.
Document body and tables included; notes appended at the end. Images excluded.
Azure Speech key (hidden):
[1/8] Synthesizing (1638 characters)...
[2/8] Synthesizing (1957 characters)...
...
[8/8] Synthesizing (1670 characters)...
Assembling and verifying the MP3...
Done: C:\audio\book.mp3
Duration: 14.9 minutes

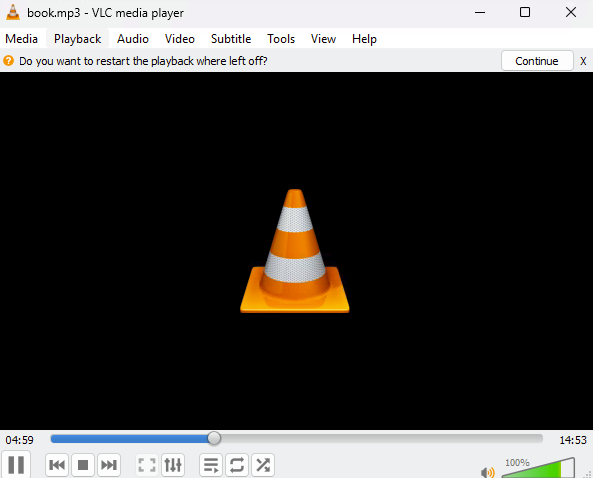
Et là, magie : un seul fichier MP3 de 14,9 minutes, prêt à être copié sur un téléphone :

Test n°3 : le gros morceau, un vieux .doc de plus de 180 000 caractères

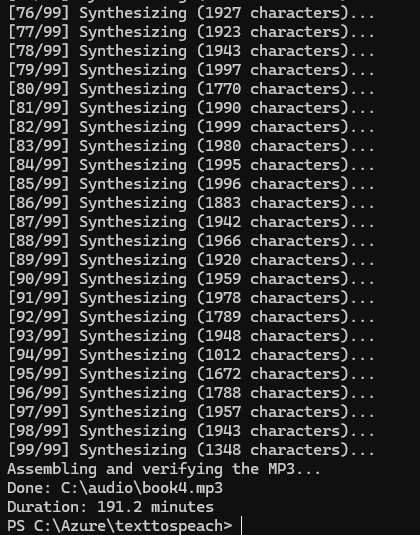
C’est pour ce cas-là que j’ai écrit l’outil. Un ancien document au format .doc, de 183 773 caractères, découpé en 99 segments d’environ 1 850 caractères en moyenne.

Extracting: C:\audio\book2.doc
183,773 characters, 99 segment(s), voice fr-FR-DeniseNeural.
Document body and tables included; notes appended at the end. Images excluded.
Azure Speech key (hidden):
[1/99] Synthesizing (1812 characters)...
[2/99] Synthesizing (1122 characters)...
...
[99/99] Synthesizing (1348 characters)...
Assembling and verifying the MP3...
Done: C:\audio\book2.mp3
Duration: 191.2 minutes

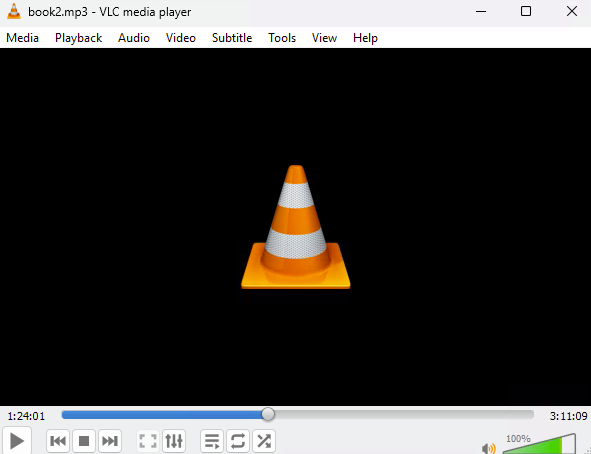
Résultat : 191,2 minutes d’audio, soit un peu plus de 3 heures de narration, produites en environ 2 minutes de traitement chez moi. Au passage, ce test confirme que l’extraction via Word fonctionne aussi sur l’ancien format .doc :

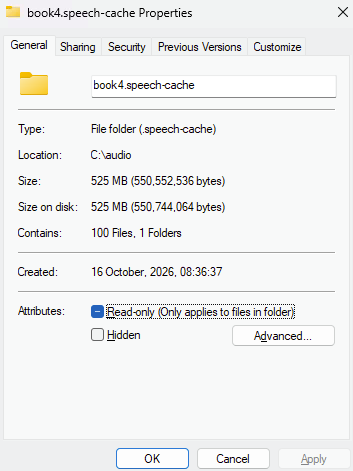
Côté taille, à 128 kbit/s, on peut estimer environ 184 Mo pour ce MP3 (c’est un calcul, pas une mesure). Prévoyez aussi de la place pour le cache WAV, nettement plus gros : de l’ordre de 500 Mo pour la même durée :

6. Le cache et la reprise

Sur un document de 99 segments, une coupure réseau au segment 70 serait rageante. C’est là que le cache entre en jeu. Les WAV sont rangés dans un dossier .speech-cache à côté du MP3, dans un sous-dossier identifié par une empreinte du texte découpé, de la voix et de l’endpoint.

book.mp3
book.speech-cache/
  <empreinte SHA-256>/
    00001.wav
    00002.wav
    ...

Si on relance la même commande, chaque WAV existant est vérifié : les segments valides sont réutilisés, les manquants ou abîmés sont régénérés. Un Ctrl+C en plein traitement affiche d’ailleurs la commande pour reprendre. En cas d’erreur passagère côté Azure (timeout, service indisponible, trop de requêtes), le script fait jusqu’à 4 tentatives par segment avant d’abandonner.

Le piège classique : changer le texte, la voix, l’endpoint ou l’emplacement du MP3 crée un nouveau cache, et donc une nouvelle synthèse complète. Pour reprendre, on relance exactement la même commande.

Attention : les segments déjà en cache ne repartent pas chez Azure, mais une relance n’est pas forcément gratuite pour autant. Tout segment manquant ou invalide sera de nouveau synthétisé et facturé. Et la reprise après coupure est couverte par des tests locaux simulés, pas encore par une vraie coupure en conditions réelles.

7. Pièges et vigilance

  • Le texte part chez Azure : chaque segment est envoyé à Azure Speech. Le fichier Word lui-même n’est pas envoyé, mais tout son contenu l’est. À éviter pour un document confidentiel sans avoir vérifié les règles de traitement des données.
  • Le cache n’est pas chiffré : les WAV et le MP3 contiennent l’intégralité du document, en audio. Supprimez le cache une fois le MP3 validé.
  • Tout n’est pas lu : pas d’OCR pour les images et pages scannées, pas d’extraction dédiée des en-têtes, pieds de page et zones de texte flottantes. Les notes sont lues à la fin, pas à leur emplacement d’origine.
  • Le coût : il dépend de la voix, de l’offre et de la région. Vérifiez la page de tarification Azure Speech avant de lancer un gros document. Le dry run compte les caractères, mais ne donne pas de devis.
  • L’écoute reste indispensable : FFmpeg vérifie que le MP3 est lisible techniquement, pas que les noms propres, les dates ou les tableaux sonnent bien.

8. Conclusion

Voilà, en cinq étapes (extraction, découpage, synthèse, cache, assemblage), un long document Word devient un seul MP3 qu’on emporte partout. Concrètement, ça donne quoi ? Chez moi, un .doc de 183 773 caractères transformé en 3 h 11 d’audio en environ 2 minutes, sans toucher au fichier d’origine.

Les trois pièges à retenir :

  1. le contenu du document part chez Azure Speech, et le cache local n’est pas chiffré ;
  2. une relance réutilise les segments valides, mais pas si vous changez le texte, la voix, l’endpoint ou l’emplacement du MP3 ;
  3. un MP3 lisible n’est pas forcément une bonne narration, écoutez avant de partager.

Côté pistes d’évolution, rien n’est encore livré, mais plusieurs idées sont sur la table : un découpage par chapitre, des réglages de vitesse et de pauses, de l’OCR pour les pages scannées ou un mode pour réassembler le MP3 depuis le cache sans repasser par Azure.

Le code est sur GitHub. Foncez tester, en commençant par un dry run sur un texte non sensible.

Déployez un serveur MCP dans Azure

Le Model Context Protocol (MCP) ouvre la voie à une nouvelle façon de faire dialoguer les modèles d’IA et leurs outils. Que ce soit pour tester un environnement local ou déployer une architecture prête à l’emploi dans Azure, MCP apporte une approche standardisée, simple à expérimenter mais suffisamment flexible pour être adaptée à des besoins complexes.

Dans cet article, je vous propose un tutoriel pas à pas pour mettre en place un serveur MCP, le tester avec MCP Inspector, puis le déployer dans Azure afin d’explorer tout son potentiel.

Qu’est-ce que MCP ?

Mon premier article est un bon point de départ pour vous informer sur le sujet :

Le protocole MCP (Model Context Protocol) est un protocole qui permet à différents modèles et outils d’IA de communiquer entre eux. Il fournit un moyen standardisé pour les modèles de partager des informations et de collaborer sur des tâches. Le serveur MCP sert de pont entre différents modèles et outils, leur permettant de fonctionner ensemble de manière transparente.

GitHub

Je peux également vous conseiller de voir cette vidéo, mais également de consulter la page officielle du protocole MCP :

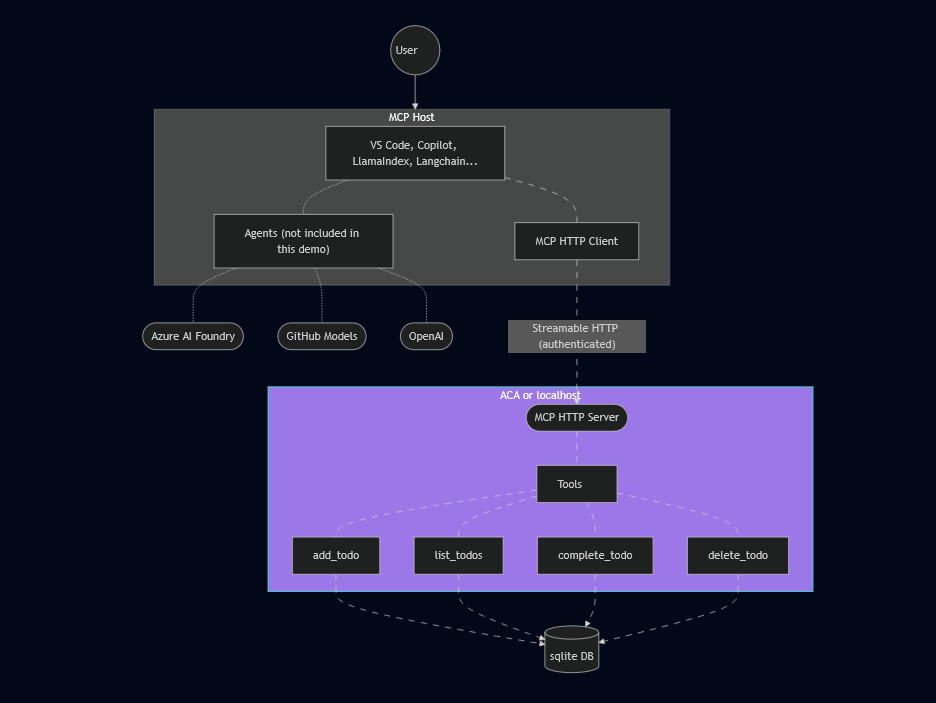
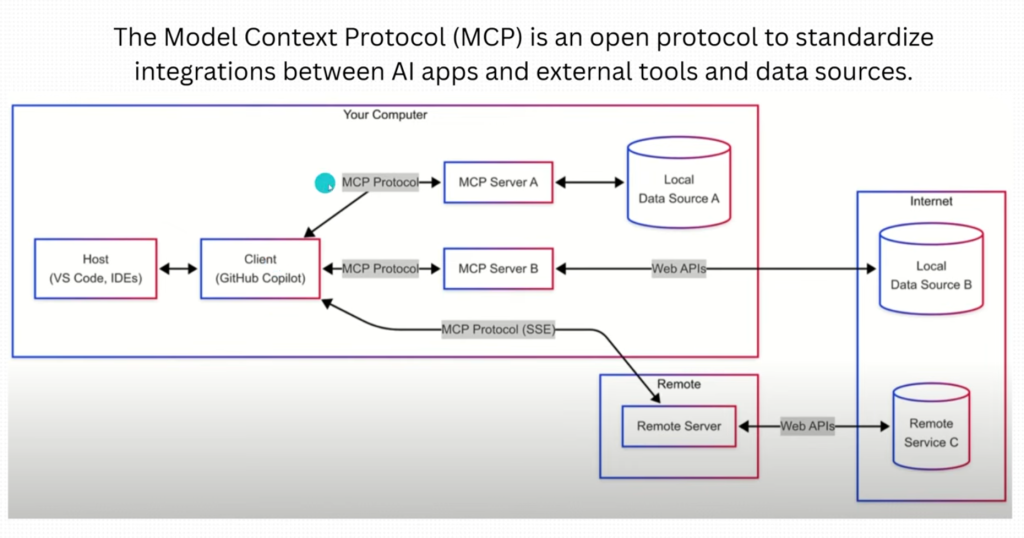
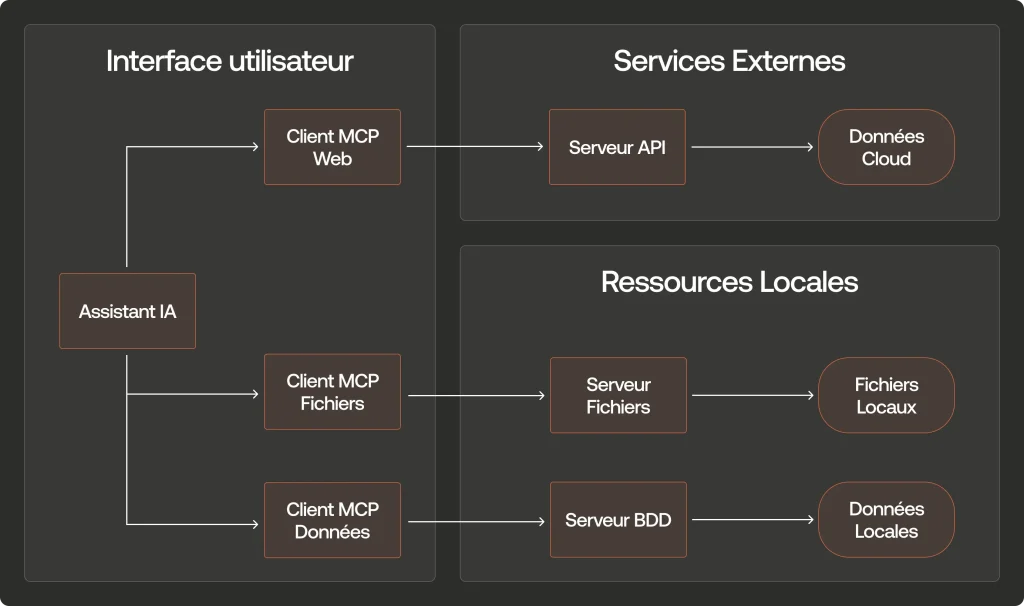
Vous trouverez ci-dessous le schéma d’architecture d’une configuration type de serveur MCP :

Enfin cette page rassemble une collection d’implémentations de serveurs MCP, qu’il s’agisse de versions officielles (références) ou proposées par la communauté. Elle sert de bibliothèque centrale pour explorer et découvrir des exemples de serveurs MCP capables de fournir aux modèles d’IA un accès contrôlé à des outils ou sources de données.

Qu’est-ce que MCP Inspector ?

MCP Inspector est un outil graphique fourni par l’équipe du Model Context Protocol qui sert à tester, déboguer et explorer un serveur MCP.

Il permet notamment de :

  • Se connecter à un serveur MCP local ou distant
  • Lister les outils (tools) que le serveur met à disposition.
  • Tester ces outils en leur envoyant des requêtes et en visualisant les réponses.
  • Explorer d’autres ressources exposées par le serveur, comme les prompts ou les files.
  • Vérifier en temps réel le statut de connexion et les échanges de données.

En résumé, c’est l’équivalent d’une console d’administration interactive qui te permet de voir comment ton serveur MCP réagit et d’expérimenter ses fonctionnalités sans devoir écrire du code côté client.

Envie de tester le déploiement d’un serveur MCP sur Azure ?

Cette page explique comment tester un serveur MCP en local ou hébergé sur Azure à l’aide de clients MCP sur desktop, comme Visual Studio Code ou MCP Inspector :

Ce guide constitue donc un point de départ idéal pour expérimenter la connexion et l’interaction avec un serveur MCP.

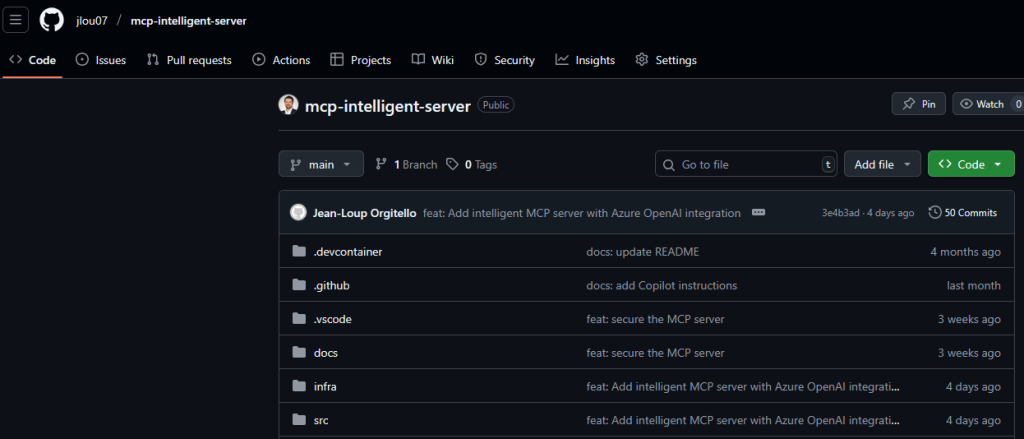
Afin de rendre la démonstration plus complète, j’y ai effectué quelques modifications, et j’ai publié le tout sur mon GitHub :

L’exercice consiste à configurer un serveur MCP, d’abord en local puis sur Azure, afin de comprendre son fonctionnement et tester ses outils :

  • Vous expérimentez ensuite les actions soit directement via ces outils, soit au travers de prompts, en observant le code généré à chaque étape.
  • La seconde partie de l’exercice consiste à déployer sur Azure Container Apps pour valider le bon fonctionnement du serveur MCP hébergé.

Maintenant, il ne nous reste plus qu’à tester tout cela 😎

Etape 0 – Rappel des prérequis :

Pour réaliser cet exercice, il vous faudra disposer de :

  • Un abonnement Azure valide
  • Un tenant Microsoft
  • Un modèle c’IA déployé sur Azure OpenAI

Commençons par tester la solution en local.

Etape I – Déploiement du serveur MCP en local :

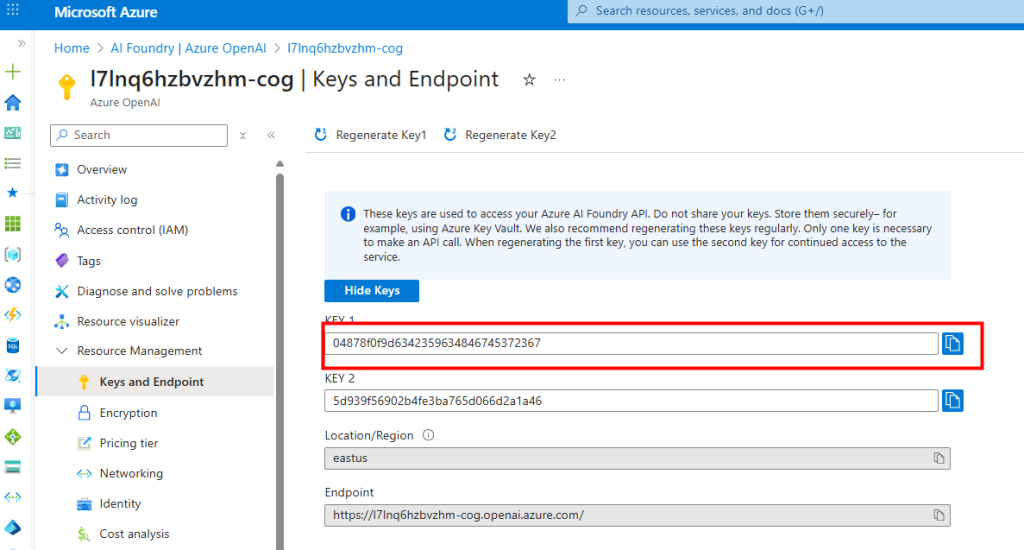
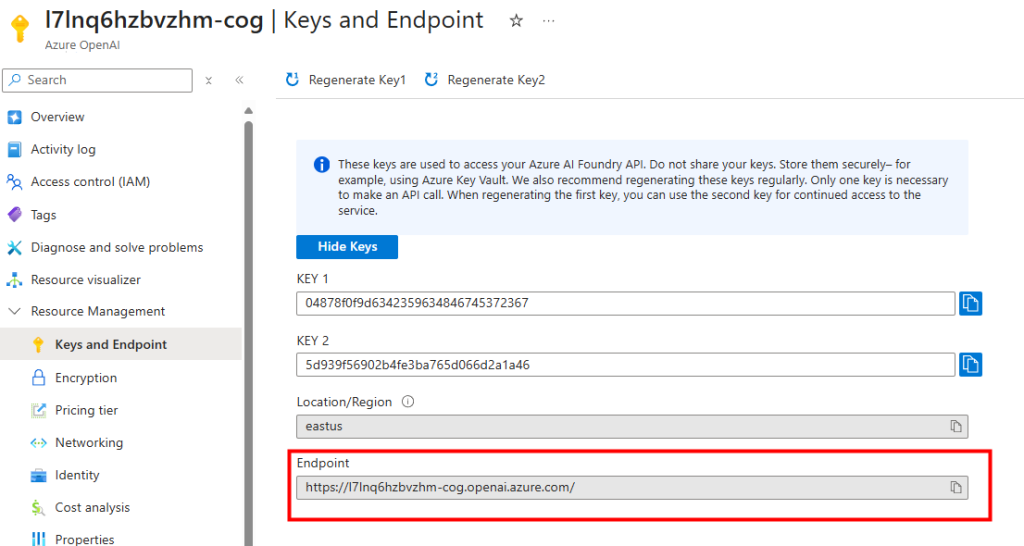
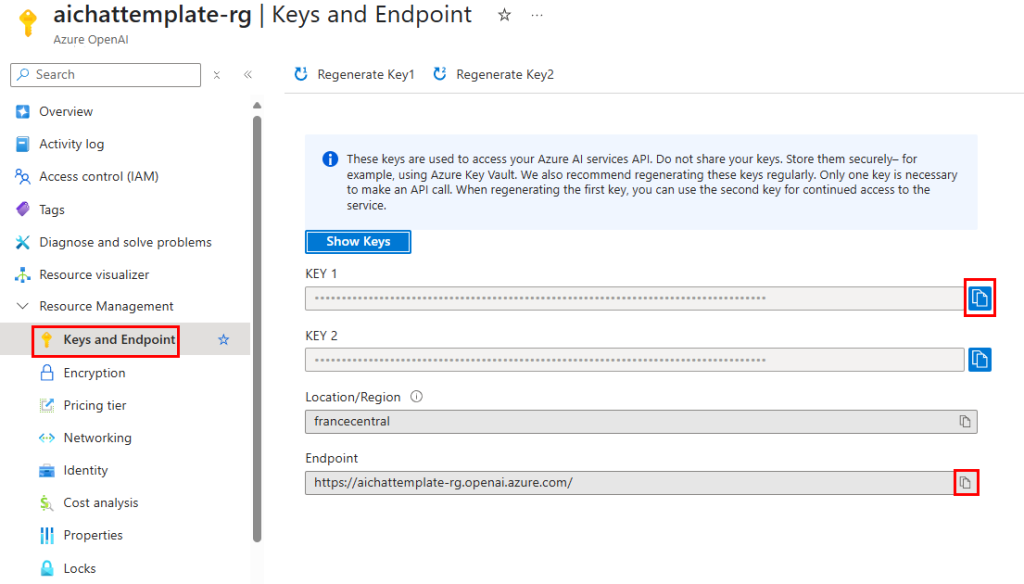
Avant cela, rendez-vous sur la page Azure OpenAI, puis copiez une des clés d’API :

Copiez également le point de terminaison depuis cette même page :

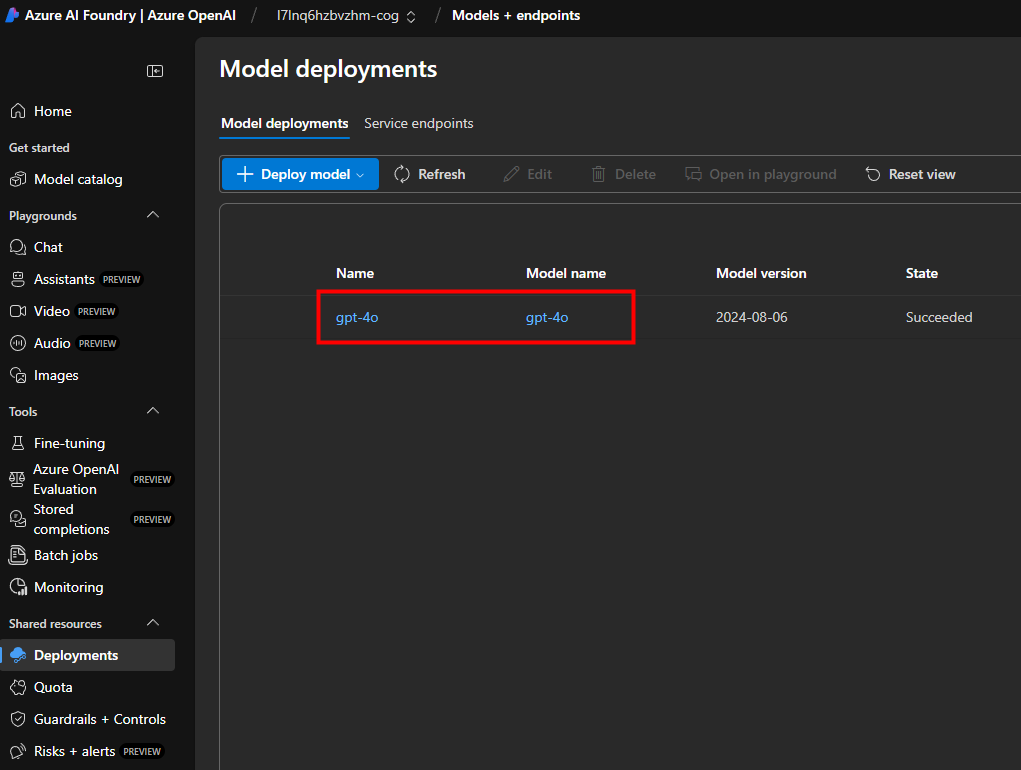
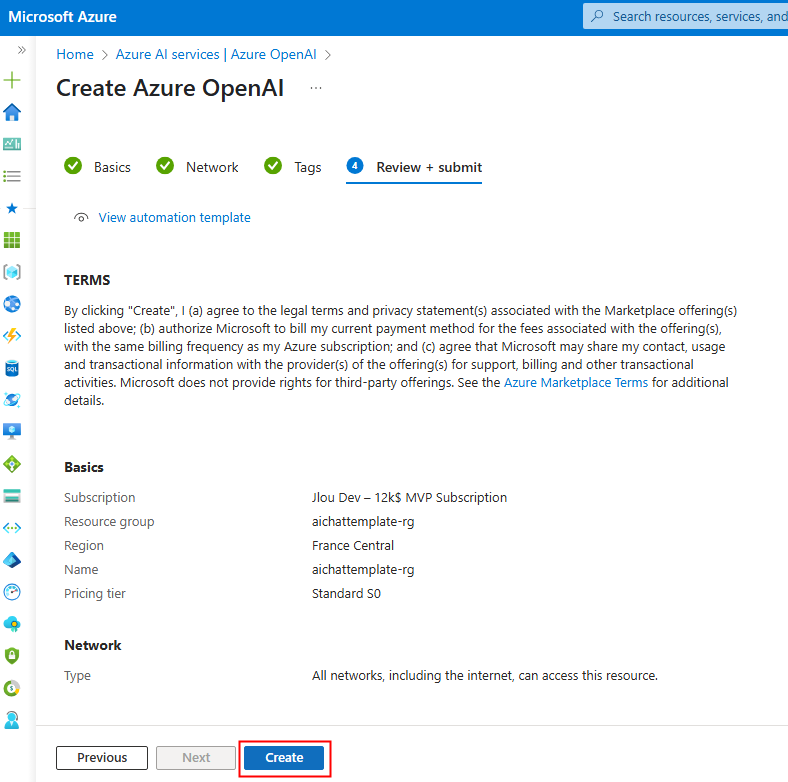
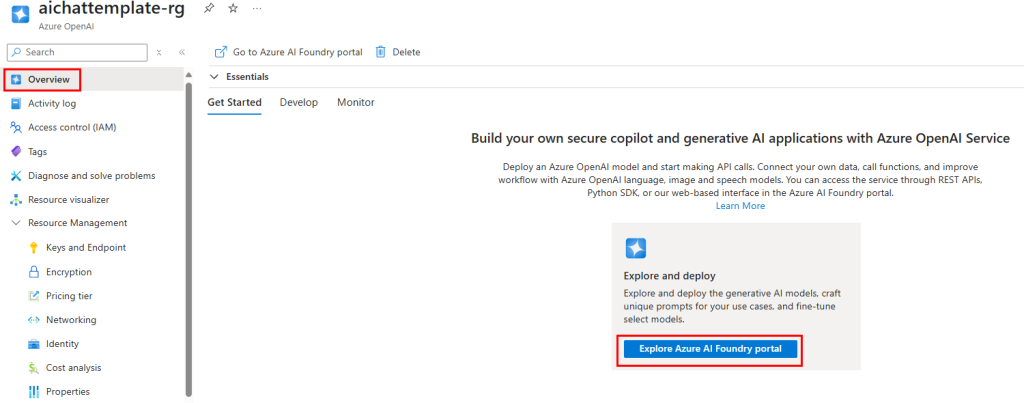
Accédez au portail Azure AI Foundry, créez un modèle, puis copiez son nom :

Sur votre poste, ouvrez une fenêtre Terminal :

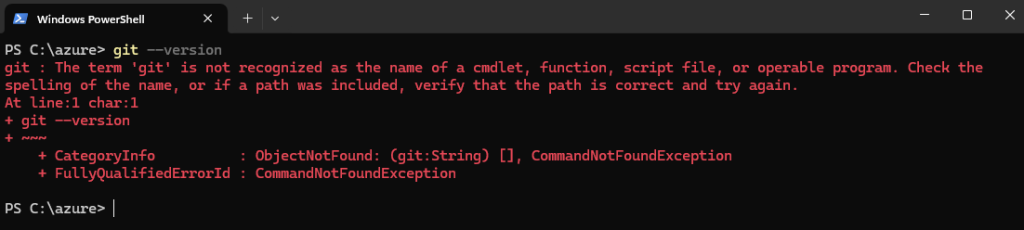
Lancez la commande suivante pour vérifier si Git est installé :

git --version

Si Git n’est pas encore installé, exécutez la commande suivante pour le faire :

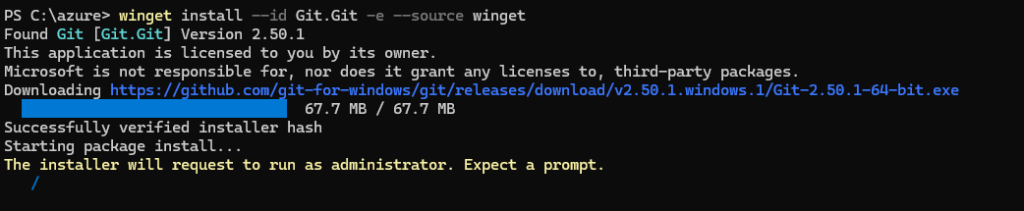
winget install --id Git.Git -e --source winget

Attendez la fin de l’installation de Git :

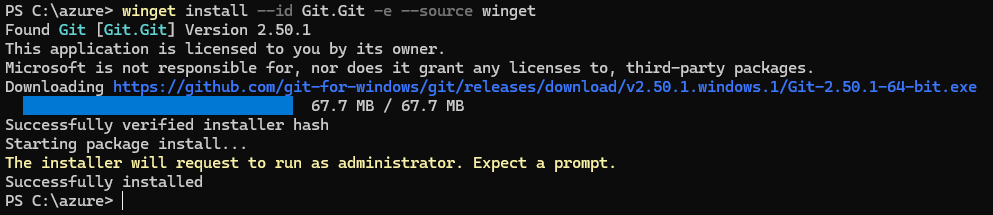
Vérifiez que l’installation de Git s’est bien effectuée :

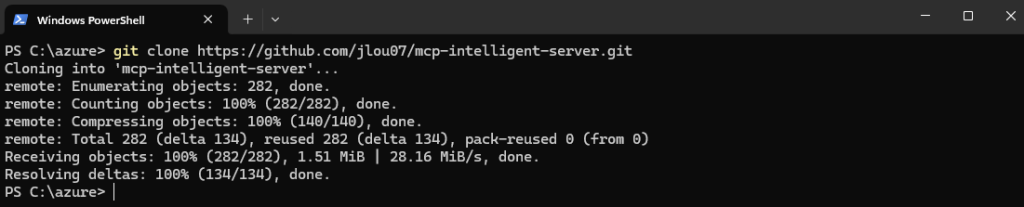
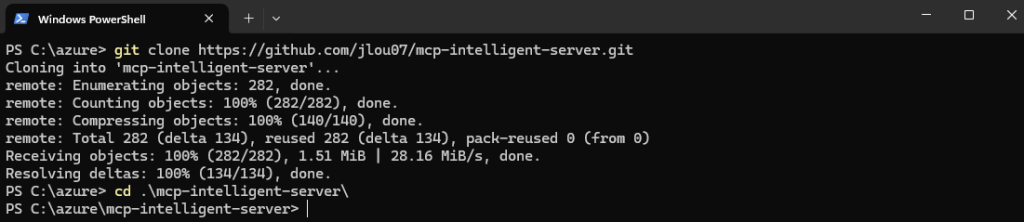
Lancez la commande suivante pour récupérer le package au format Git depuis mon dépôt GitHub :

git clone https://github.com/jlou07/mcp-intelligent-server.git

Accédez au dossier du package téléchargé :

cd .\mcp-intelligent-server\

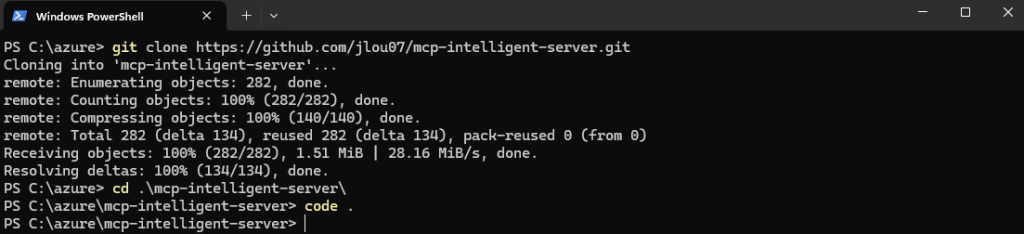
Ouvrez Visual Studio Code avec la commande suivante :

Code .

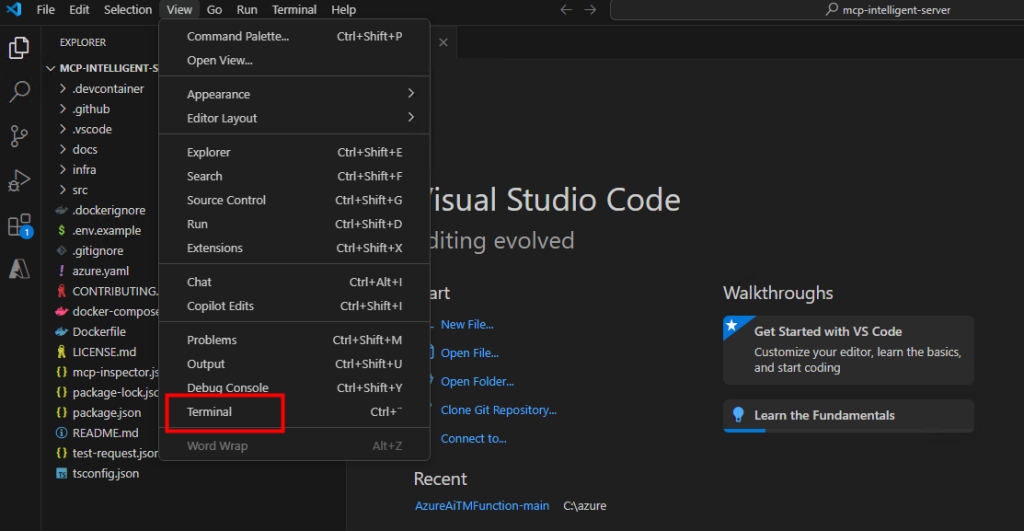
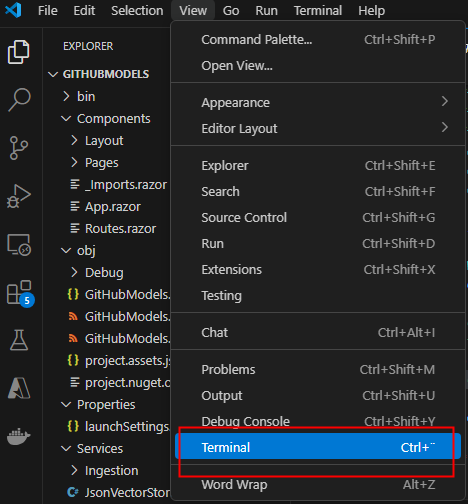
Dans Visual Studio Code, ouvrez le terminal intégré :

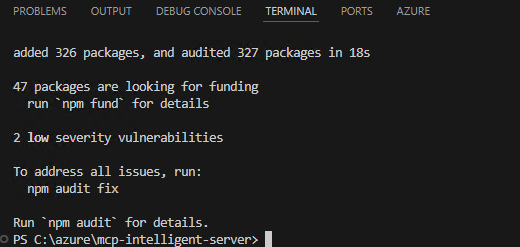
Exécutez la commande suivante pour installer NPM (gestionnaire de paquets Node.js) :

npm install

Attendez la fin de l’installation des différents packages NPM :

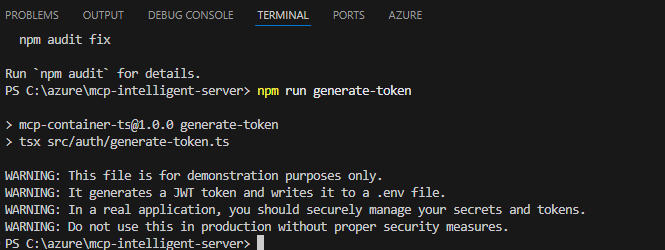
Lancez le script suivant pour générer un token sur le serveur MCP :

npm run generate-token

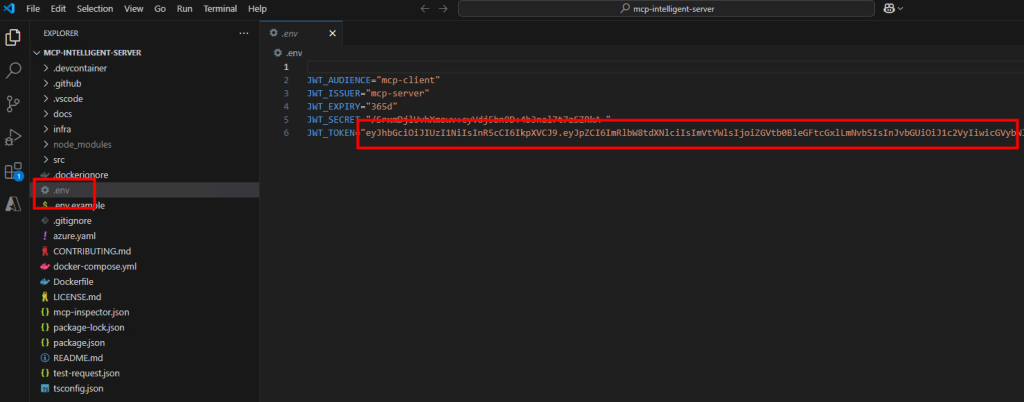
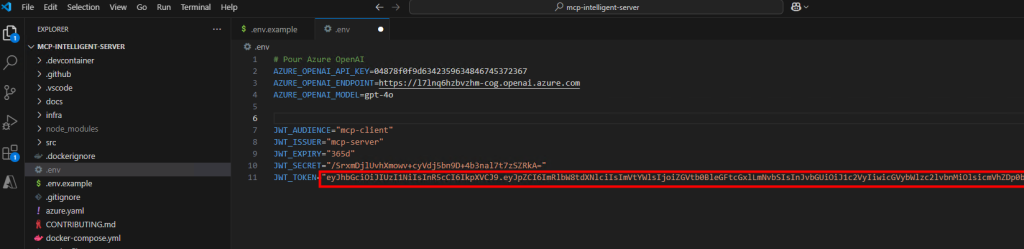
Vérifiez la création du fichier .env et copiez la valeur du token généré :

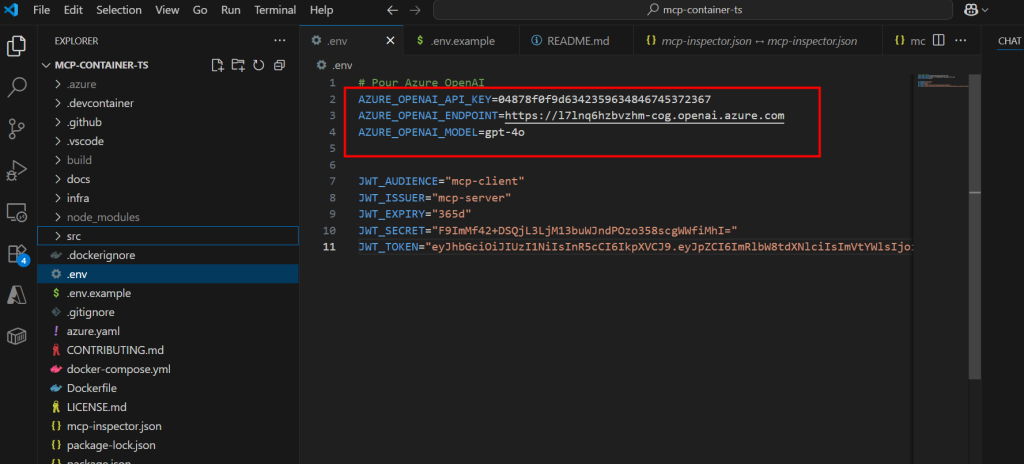
Ajoutez la ligne suivante pour renseigner le point de terminaison Azure OpenAI, puis sauvegardez :

# Azure OpenAI Configuration (optional but recommended for intelligent prompts)
AZURE_OPENAI_API_KEY=your-azure-openai-api-key-here
AZURE_OPENAI_ENDPOINT=https://your-resource-name.openai.azure.com
AZURE_OPENAI_MODEL=gpt-4o

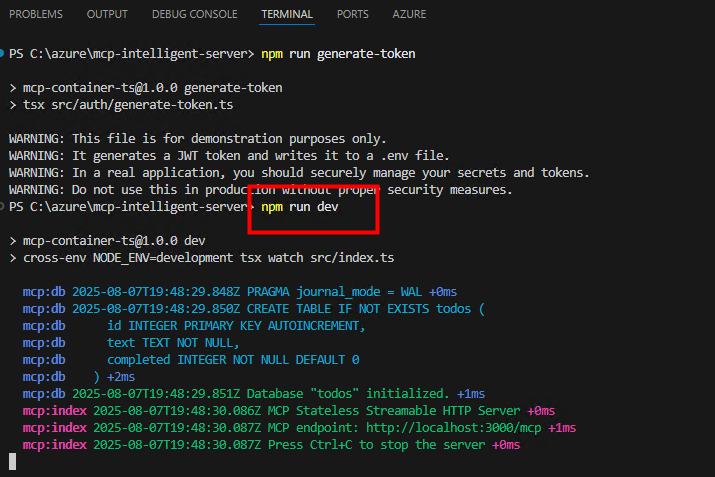
Lancez localement le serveur MCP avec la commande NPM suivante :

npm run dev

Vérifiez la création de la base de données SQLite en mémoire, ainsi que le lancement réussi du serveur MCP :

Notre environnement en local est maintenant déployé. Nous allons maintenant utiliser MCP Inspector pour explorer les fonctionnalités du serveur MCP.

Etape II – Tests du serveur MCP local :

Ouvrez une seconde fenêtre de Terminal :

Lancez l’outil MCP Inspector avec la commande suivante :

npm run inspect

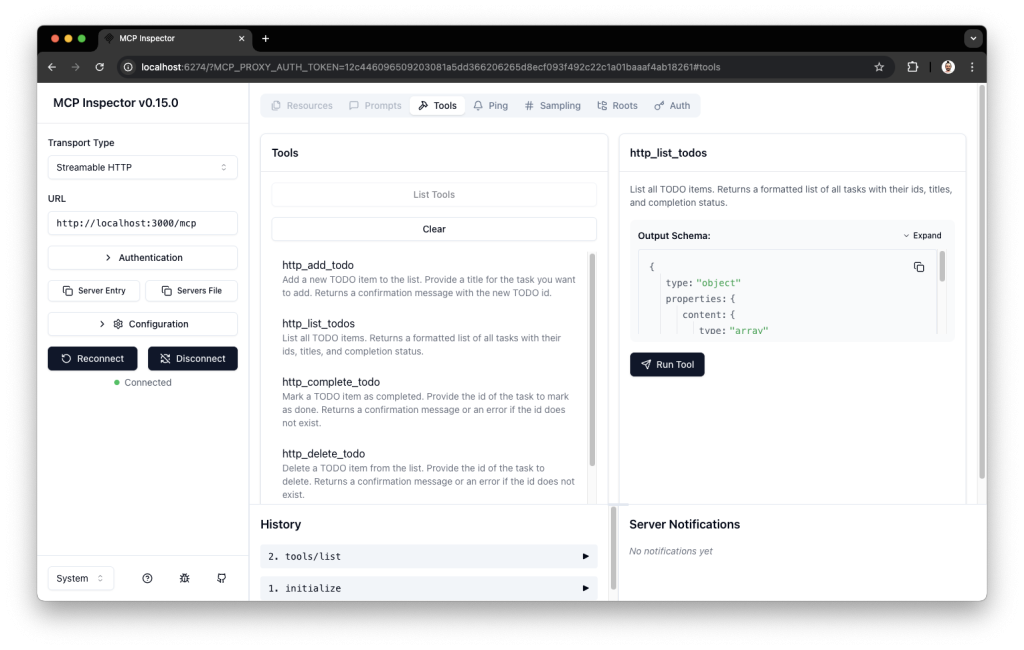
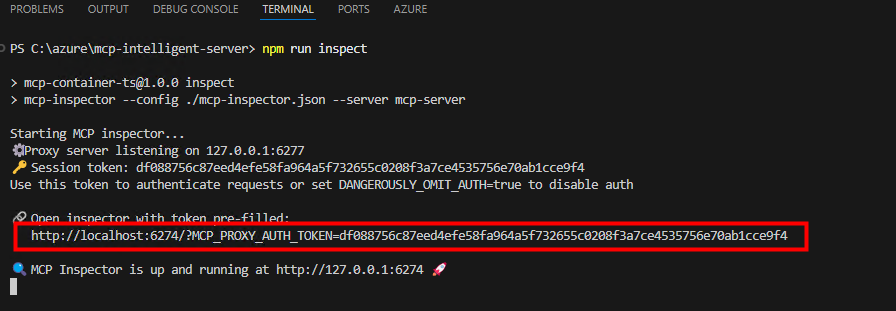
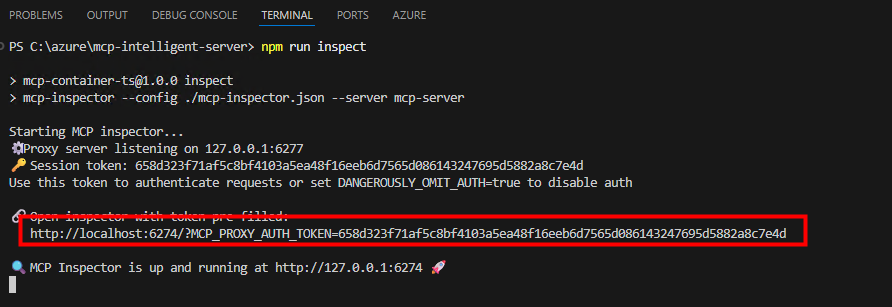
Récupérez l’URL du proxy MCP Inspector contenant son propre token d’accès :

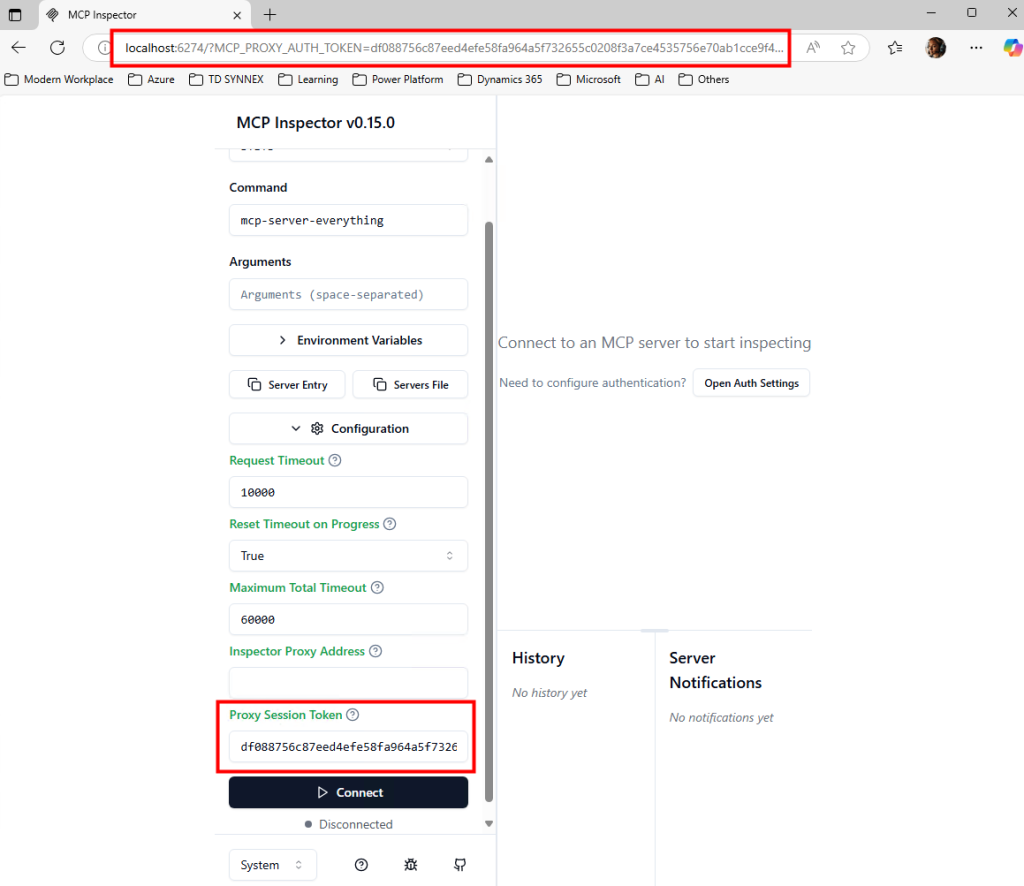
Ouvrez cette URL dans un navigateur et vérifiez la présence du token MCP Inspector :

Copiez ensuite la valeur du token du serveur MCP et ajoutez-la dans le fichier .env :

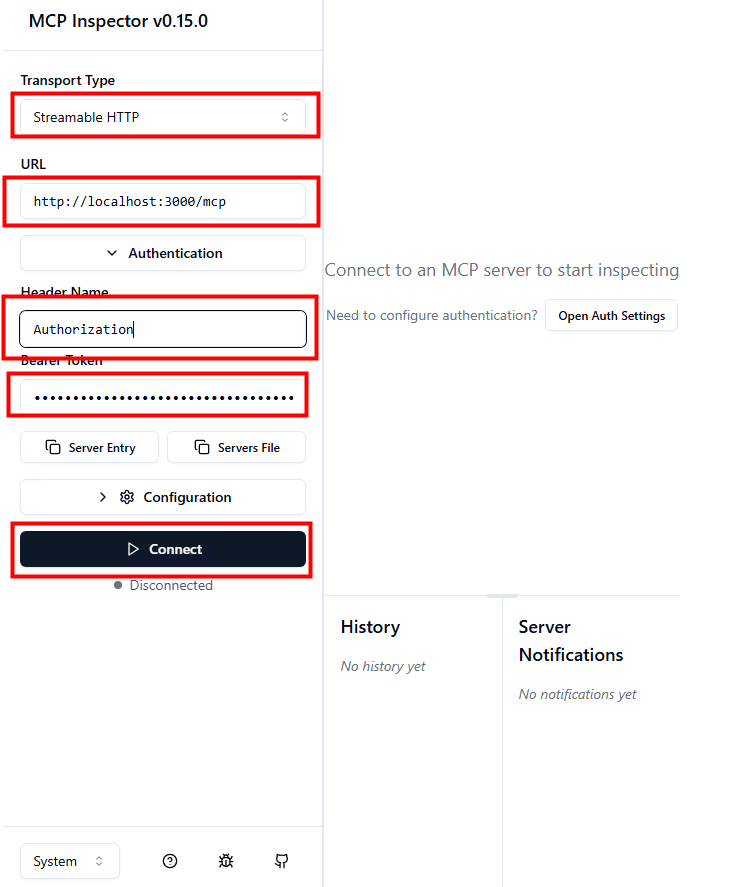
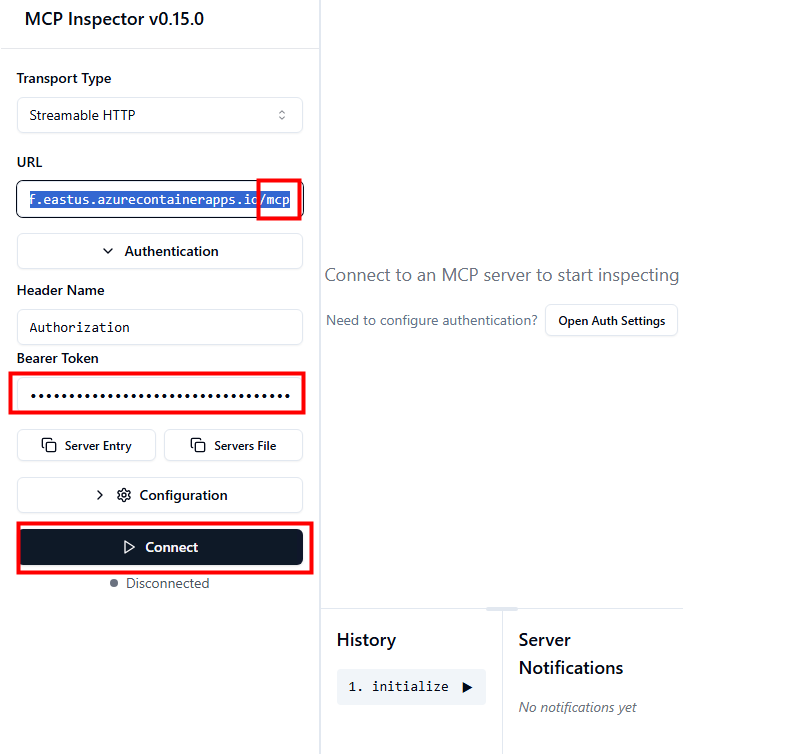
Complétez les champs requis pour la connexion au serveur MCP local, puis cliquez ici pour vous connecter :

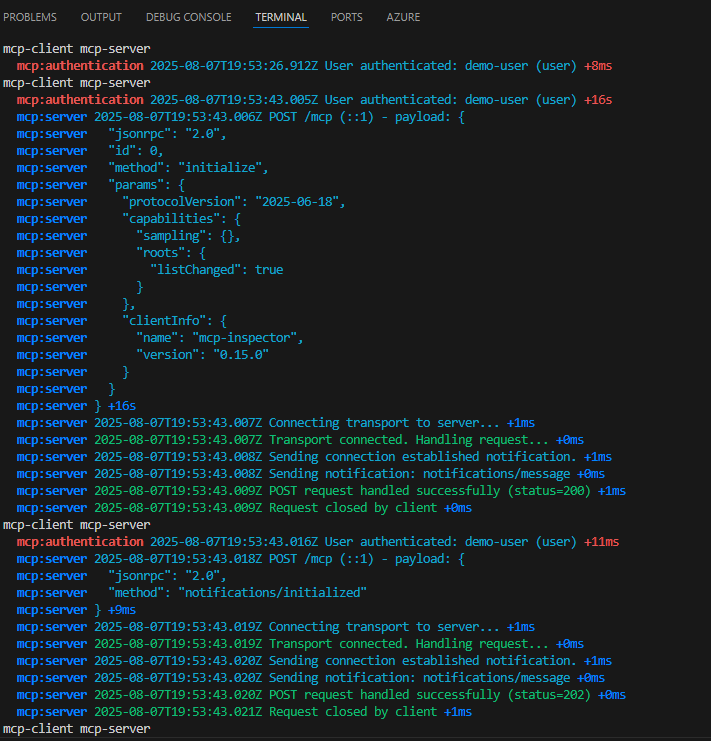
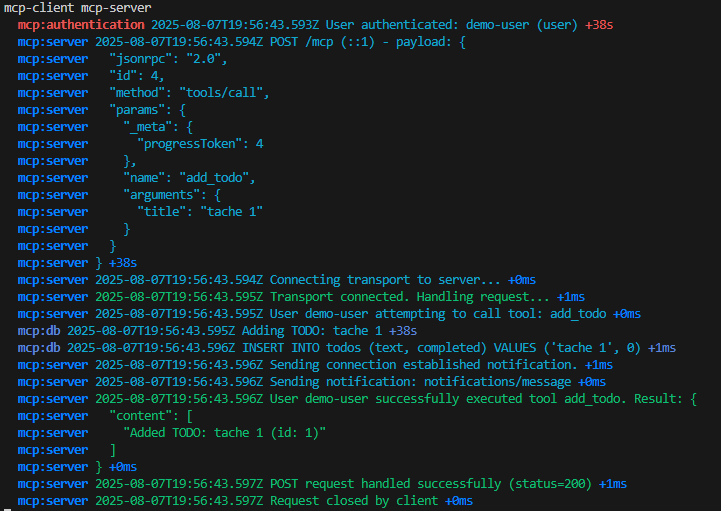
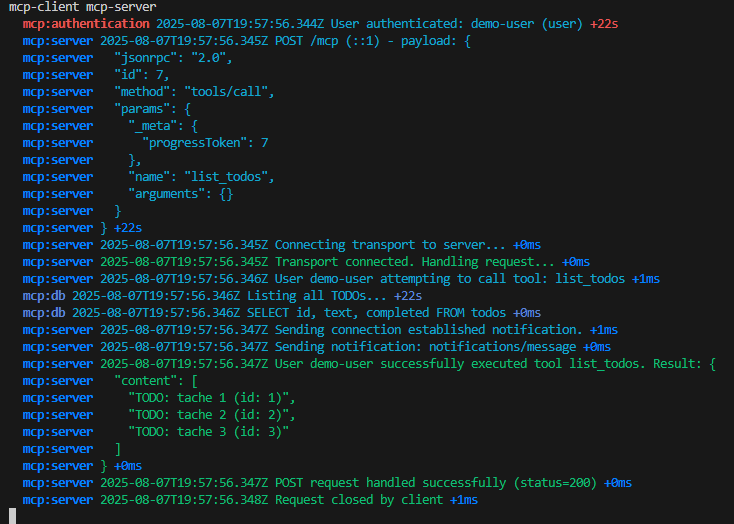
Vérifiez dans les logs l’authentification réussie du client vers le serveur MCP :

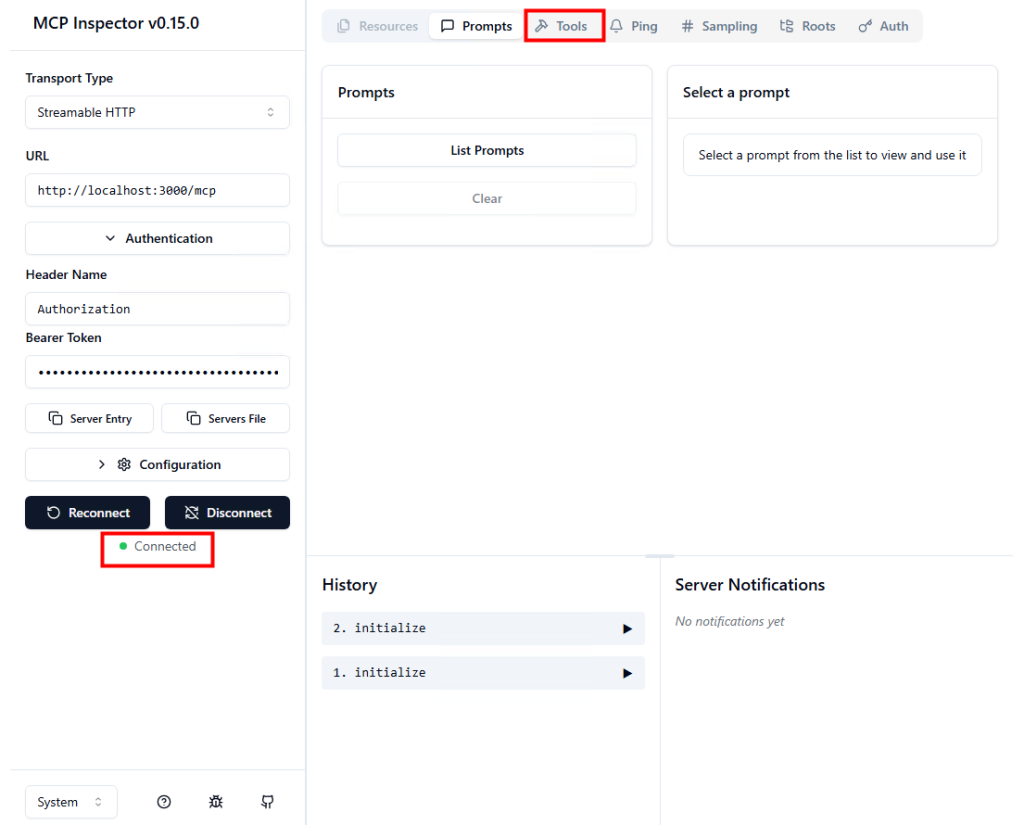
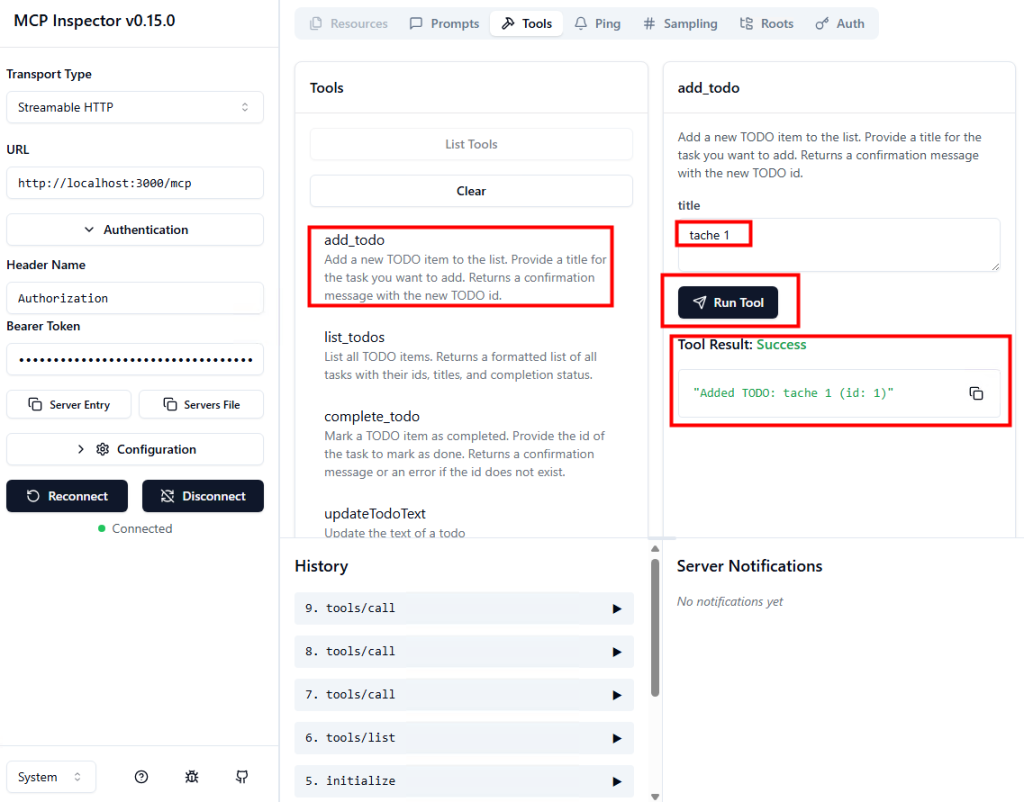
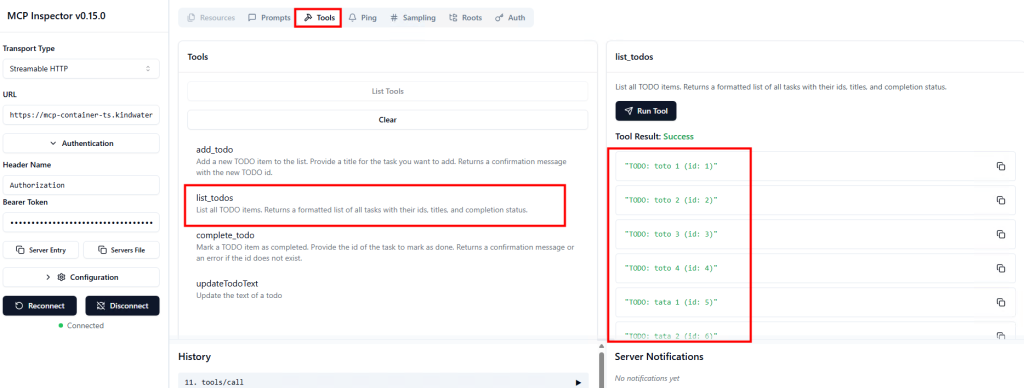
Dans MCP Inspector, vérifiez le statut Connected, puis cliquez sur l’onglet Tools :

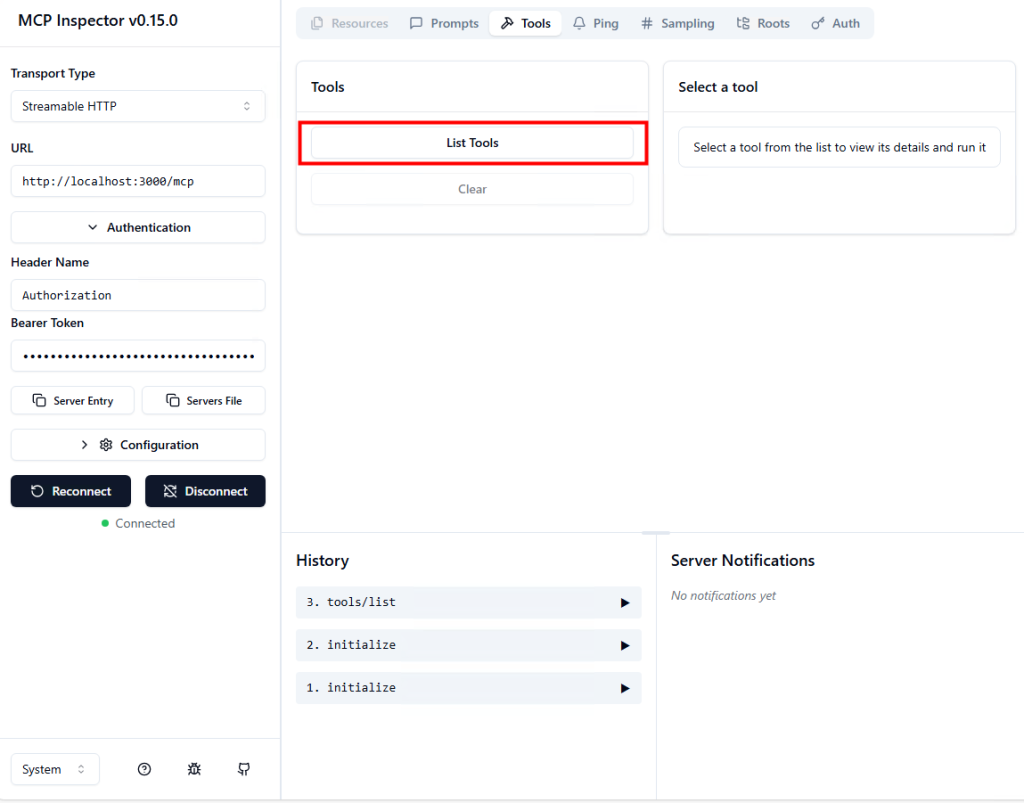
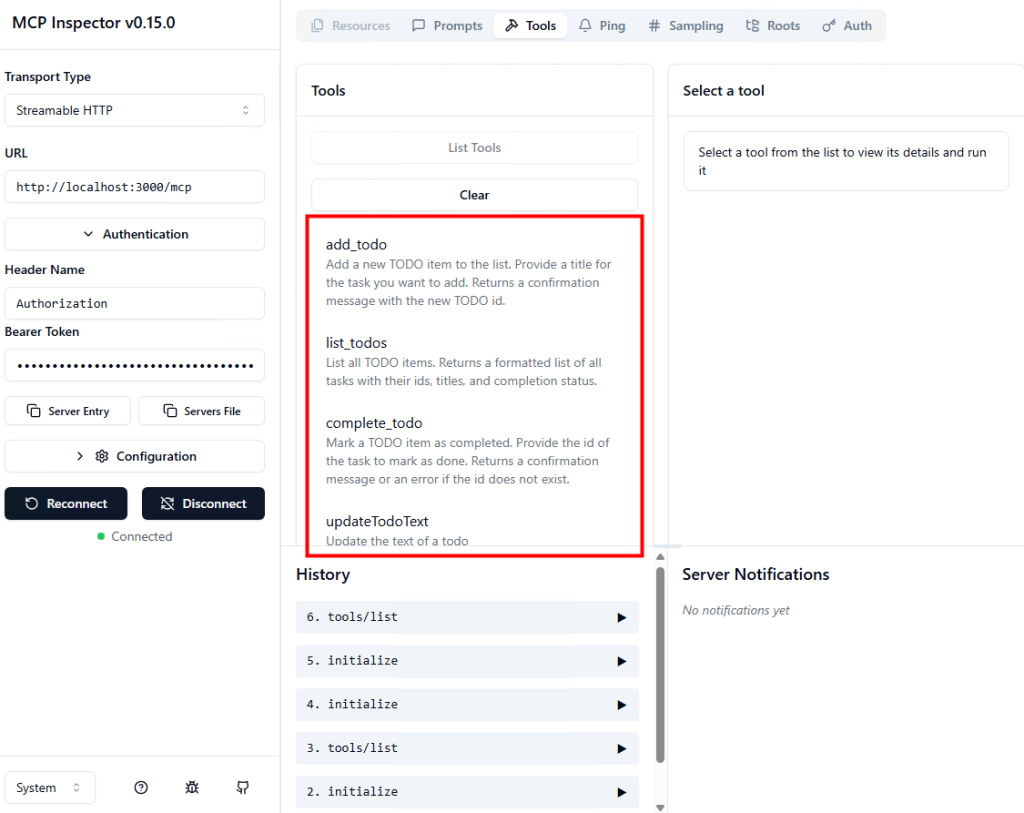
Cliquez sur Lister les Tools pour afficher les outils déclarés :

Constatez l’apparition de la liste des outils disponibles :

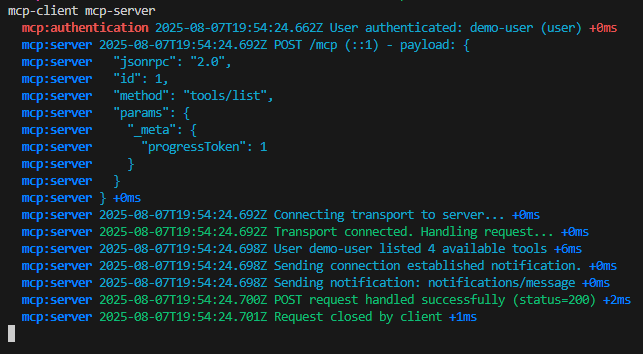
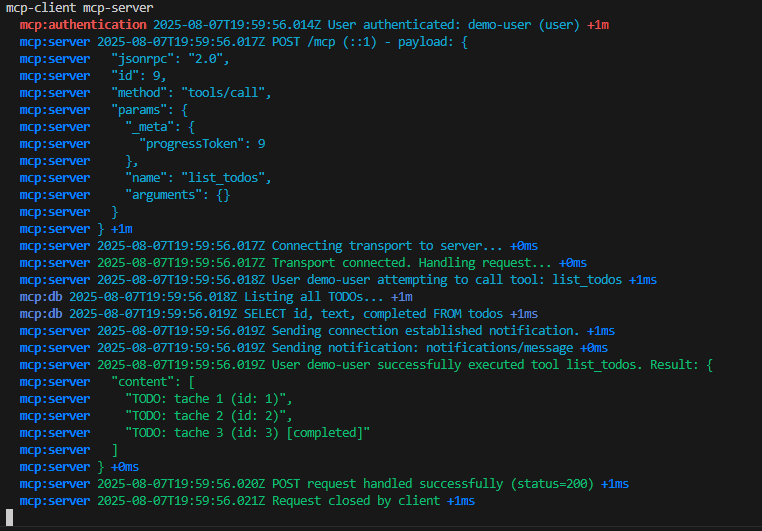
Observez les opérations effectuées du côté du serveur MCP :

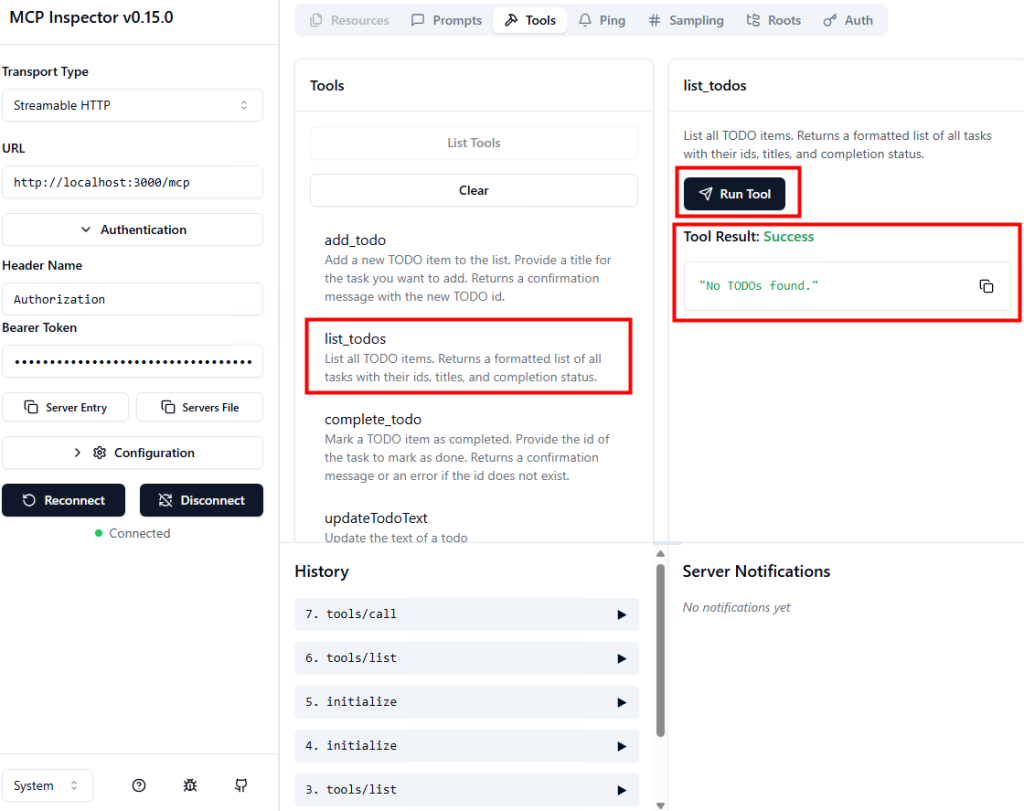
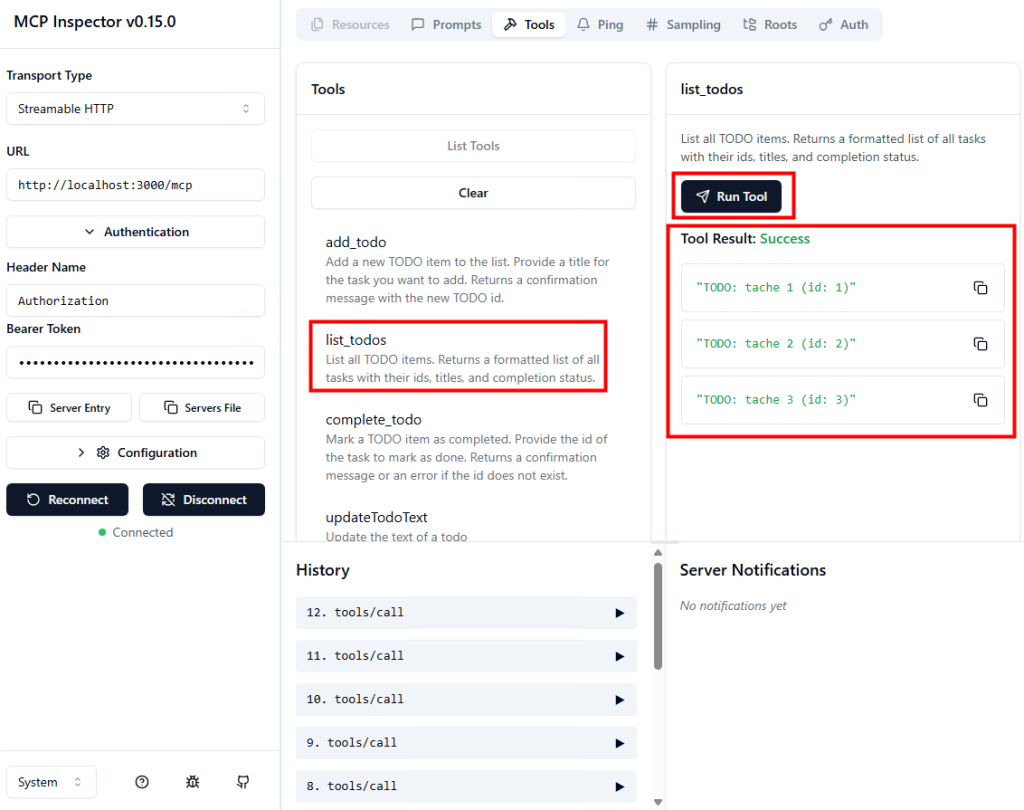
Utilisez l’outil List_ToDo, lancez-le et vérifiez le résultat obtenu :

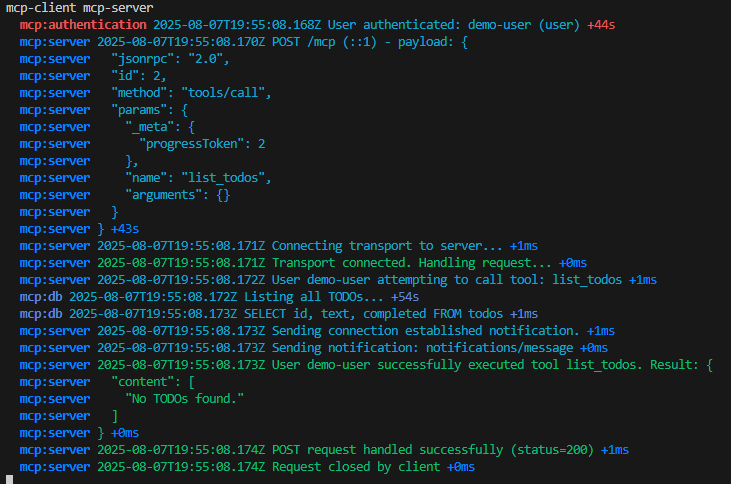
Analysez les logs générés par le serveur MCP pour cette opération :

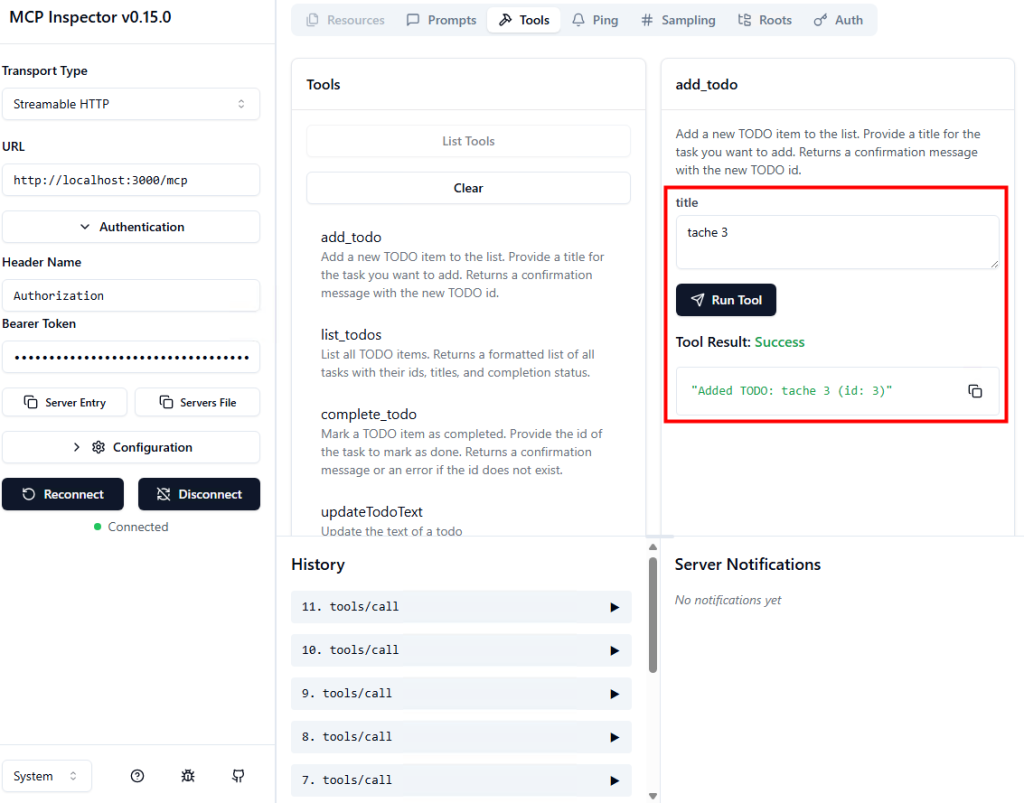
Utilisez l’outil Add _ToDo pour créer une nouvelle tâche, puis constatez l’opération :

Observez les logs correspondant à l’ajout de la nouvelle tâche dans la base SQLite :

Ajoutez plusieurs tâches supplémentaires :


Relancez List_ToDo :

Analysez les logs générés par le serveur MCP pour cette opération :

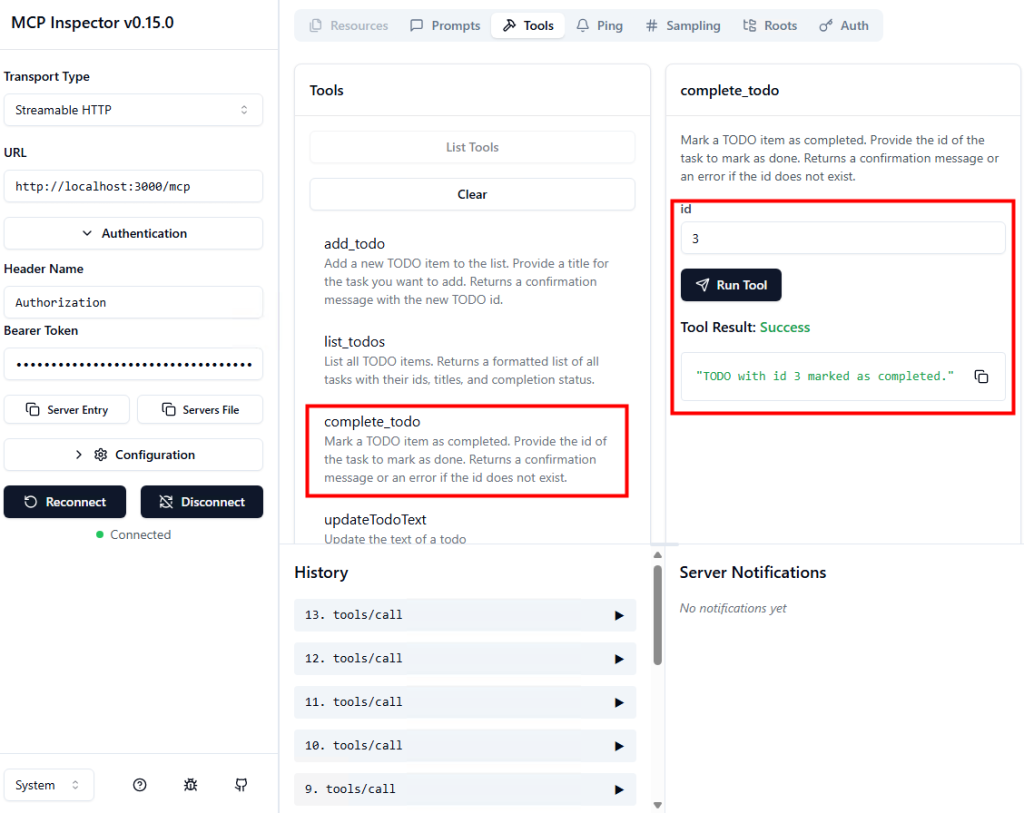
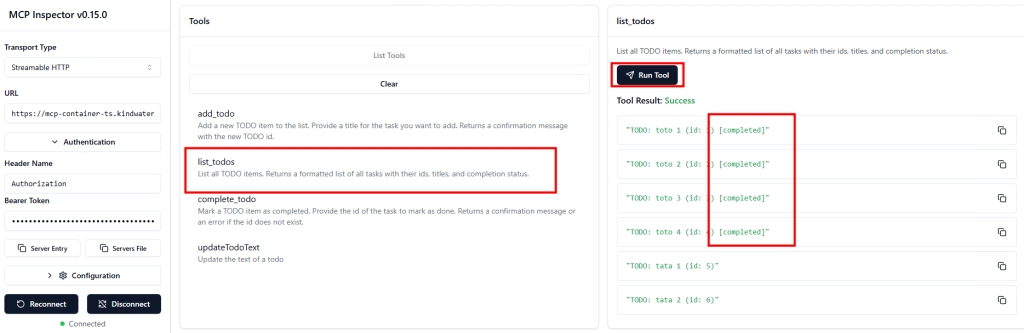
Utilisez Complete_ToDo pour marquer une tâche comme complétée :

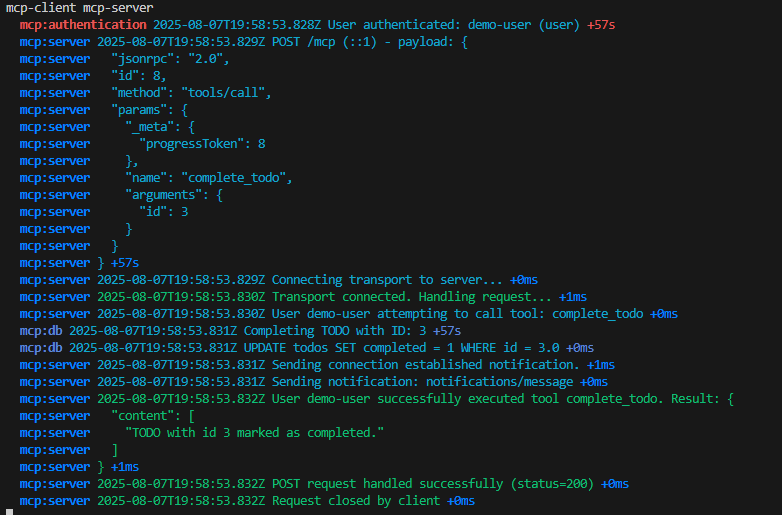
Vérifiez les logs correspondant à cette mise à jour :

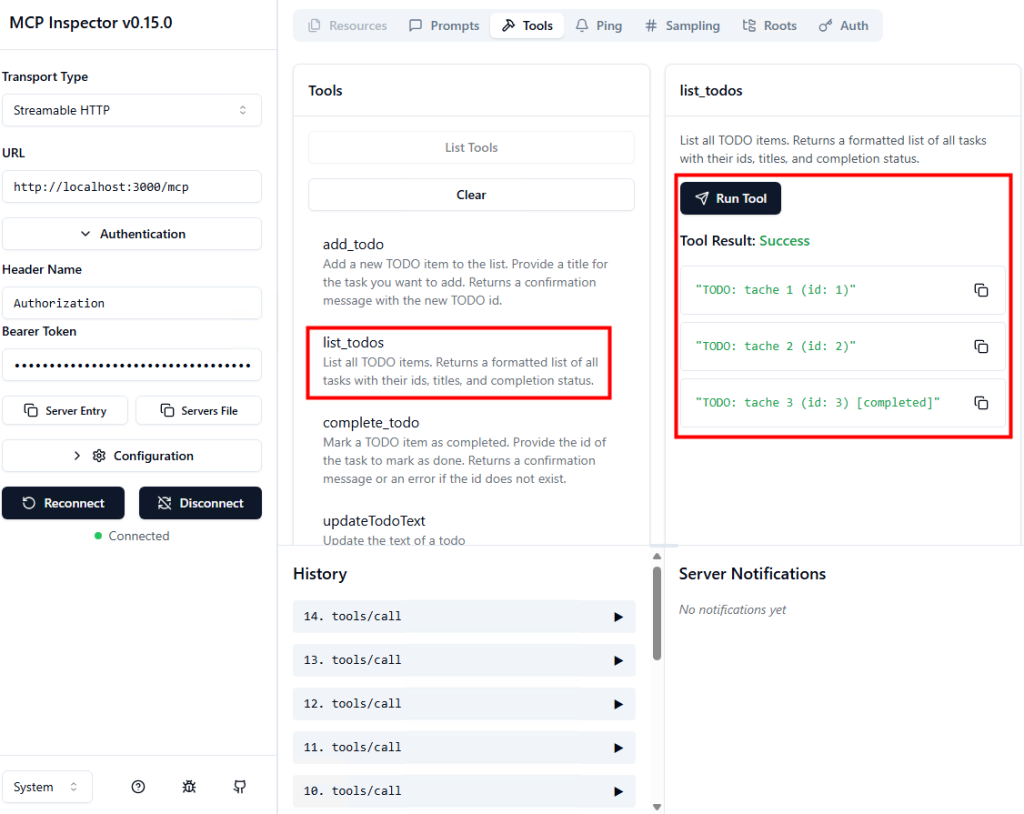
Relancez List_ToDo pour constater que la tâche est complétée :

Observez les logs correspondant à cette liste mise à jour :

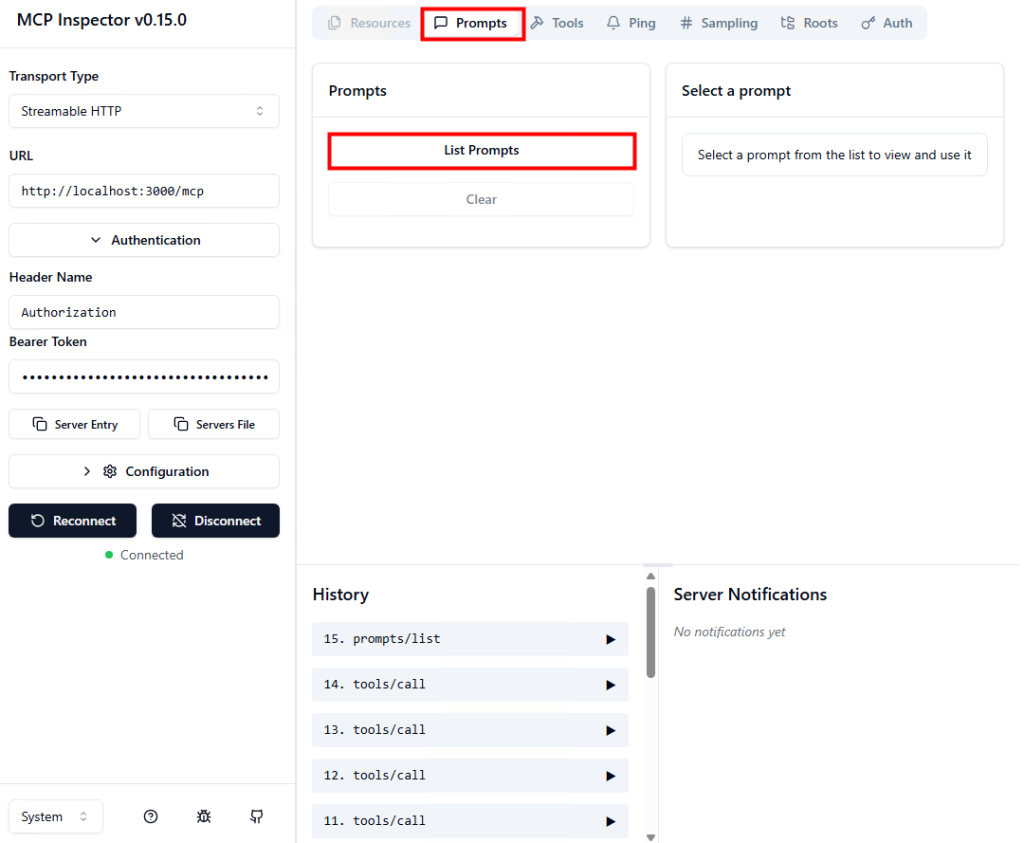
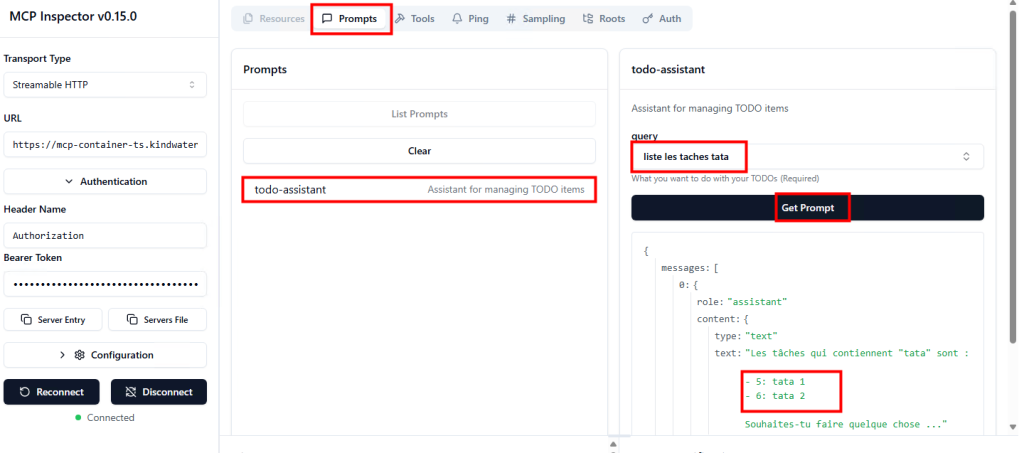
Passez à l’onglet Prompts, puis cliquez ici pour lister les assistants IA disponibles :

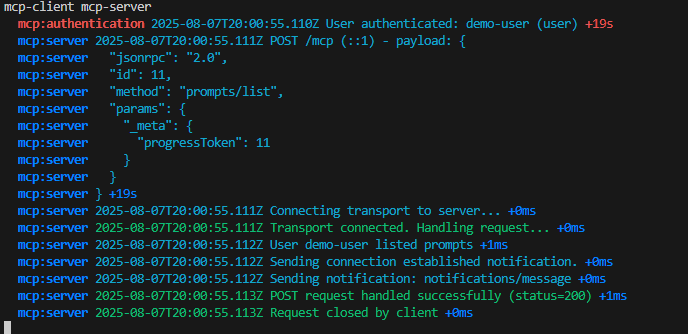
Vérifiez les logs générés par cette action :

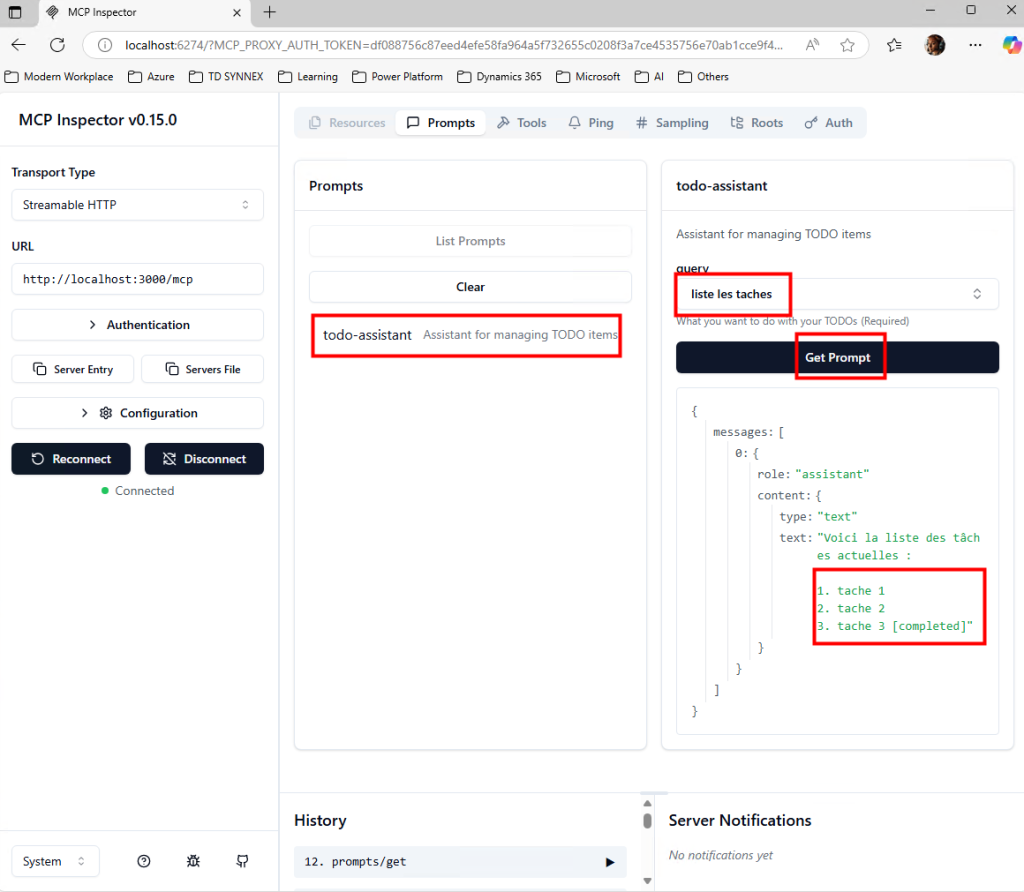
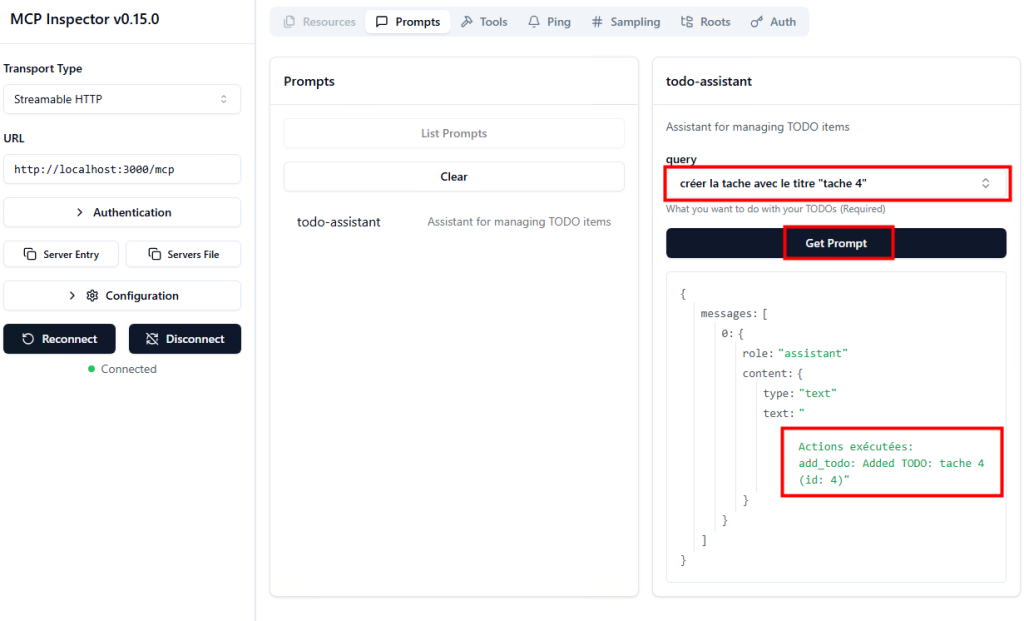
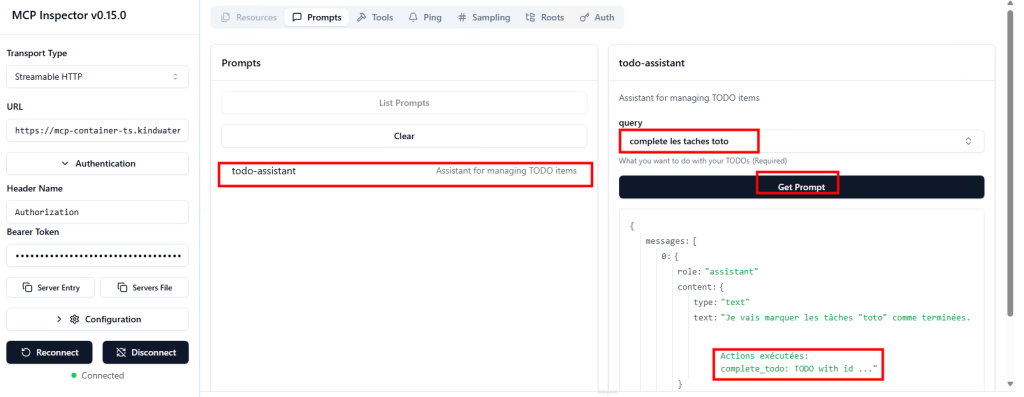
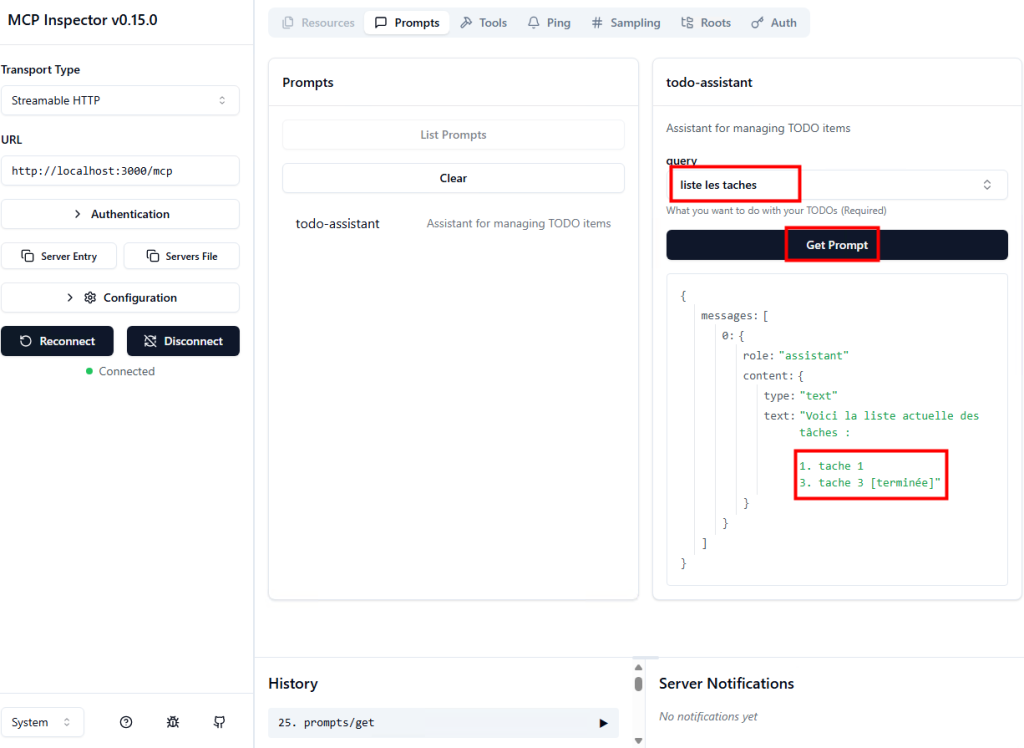
Cliquez sur ToDo Assistant, entrez un exemple de requête (ex. : lister les tâches), puis constatez la réponse générée :

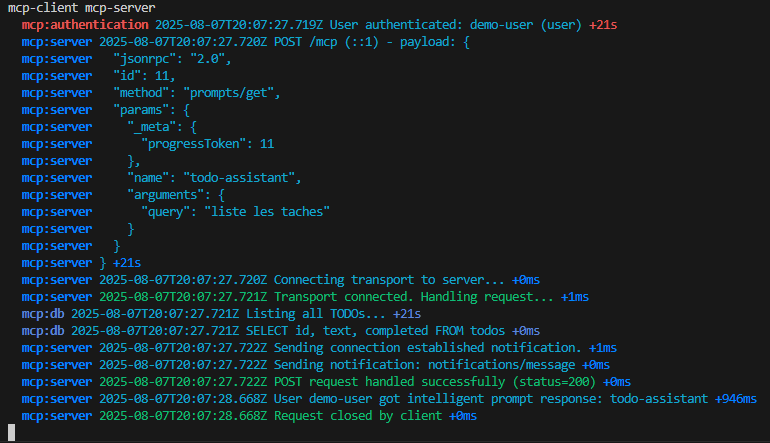
Observez les logs correspondant à ce prompt :

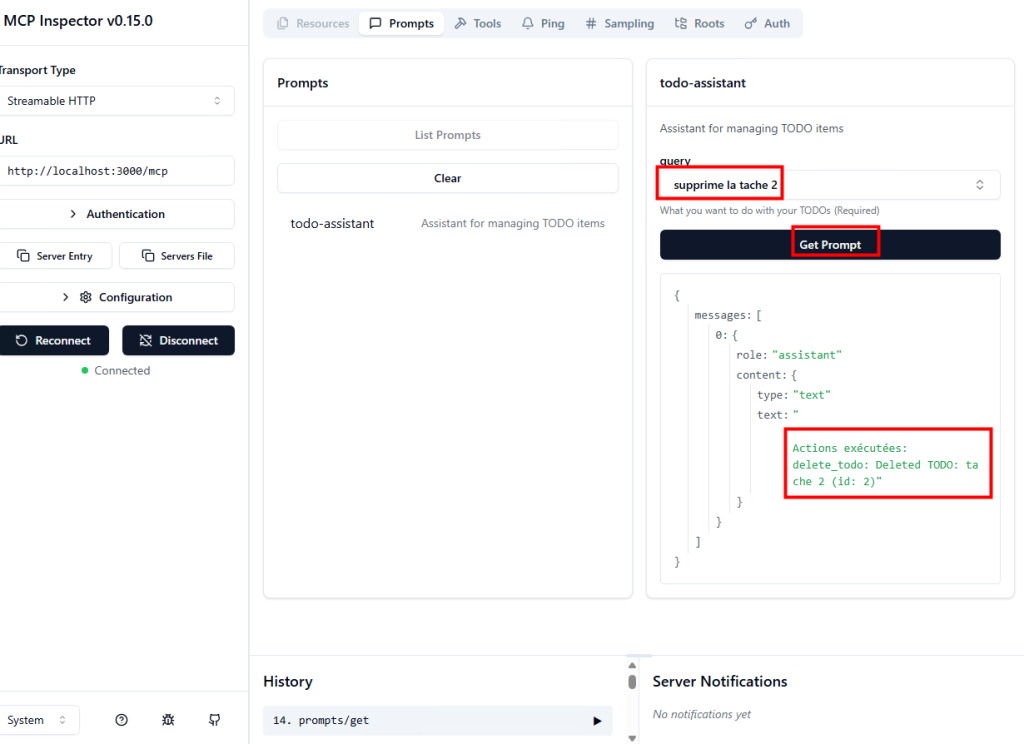
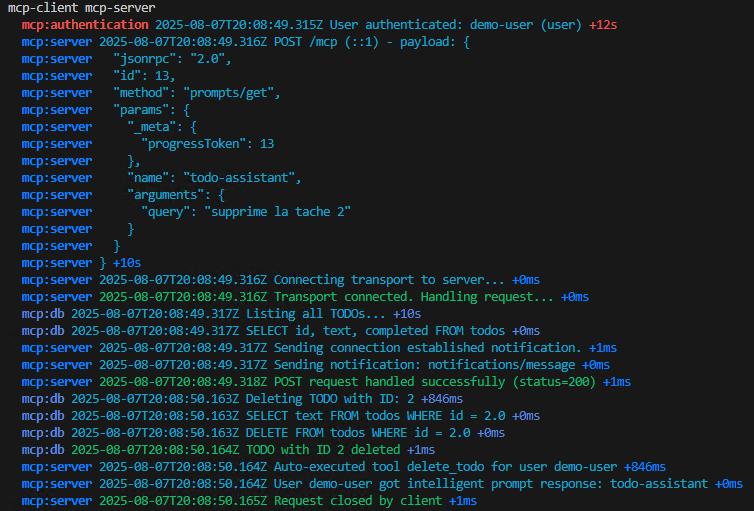
Testez un prompt de suppression d’une tâche, puis exécutez-le :

Vérifiez les logs générés et l’action effectuée sur la base SQLite :

Relancez List_ToDo pour constater que la tâche a bien été supprimée :

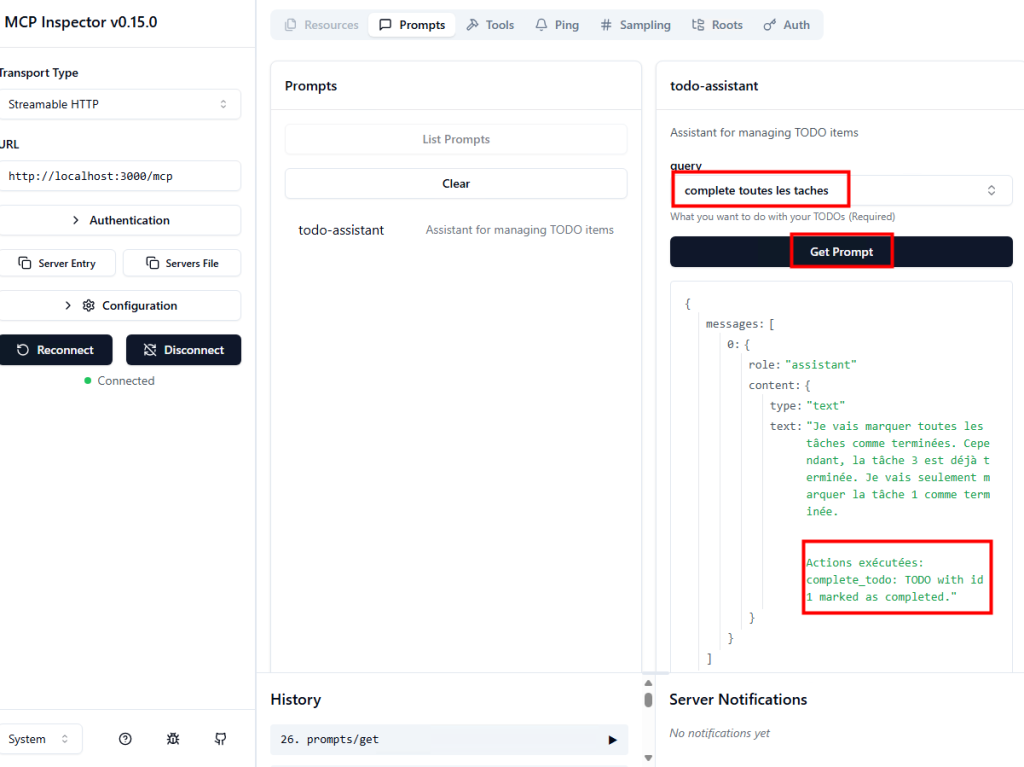
Testez un prompt de mise à jour de toutes les tâches :

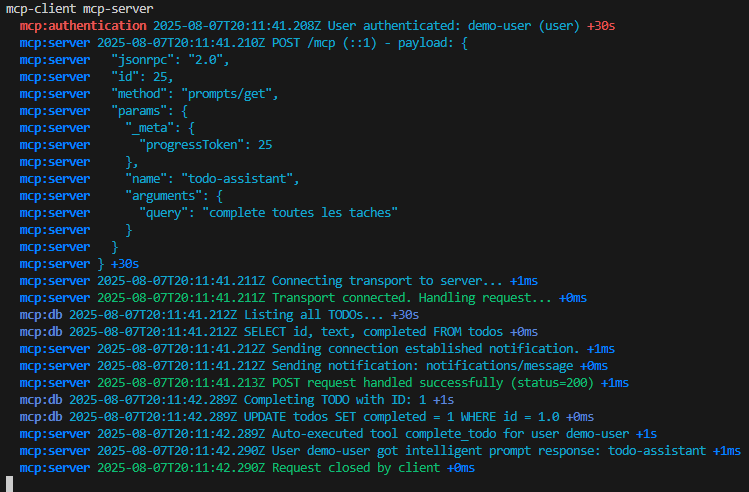
Constatez le résultat dans les logs :

Créez une nouvelle tâche via un prompt :

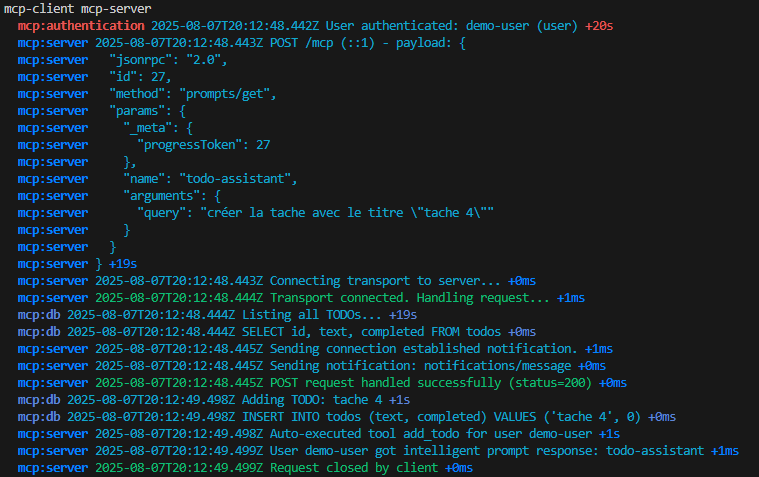
Observez les logs correspondant à l’ajout de cette nouvelle tâche :

La démonstration sur l’environnement local est terminée, passons maintenant au déploiement sur Azure.

Etape III – Déploiement du serveur MCP sur Azure :

Rendez-vous sur l’URL de téléchargement de Docker Desktop, puis téléchargez la version correspondant à votre OS :

Lancez l’exécutable compatible avec votre architecture :

Suivez l’installation :

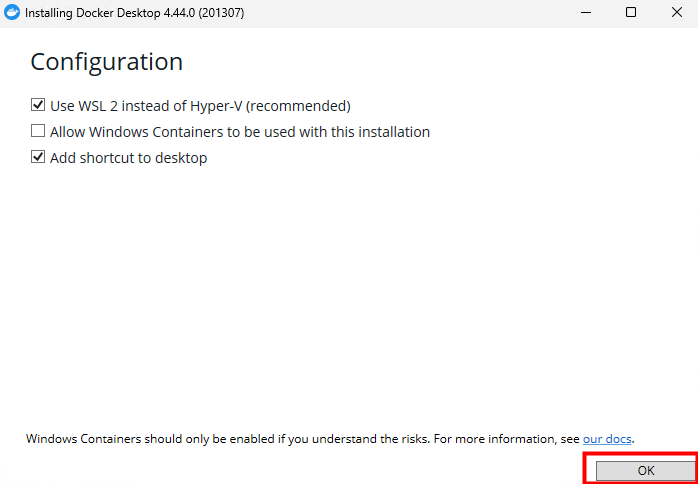
Cochez les options proposées puis cliquez sur OK :

Attendez la fin de l’installation (de 5 à 10 minutes) :

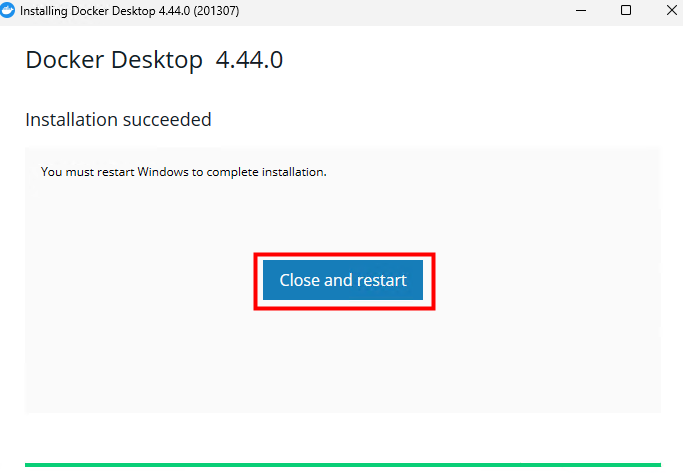
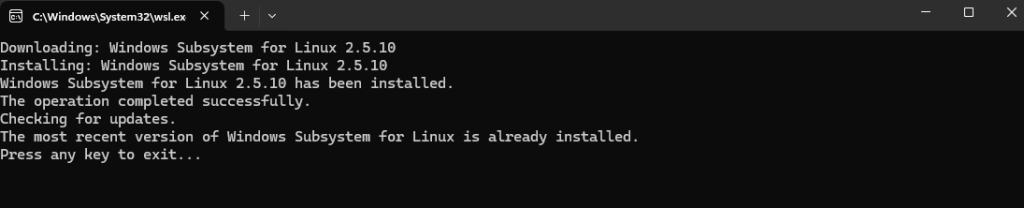
Cliquez sur Fermer, puis redémarrez l’ordinateur :

Après le redémarrage, ouvrez Docker Desktop, puis laissez le téléchargement des composants additionnels se terminer :

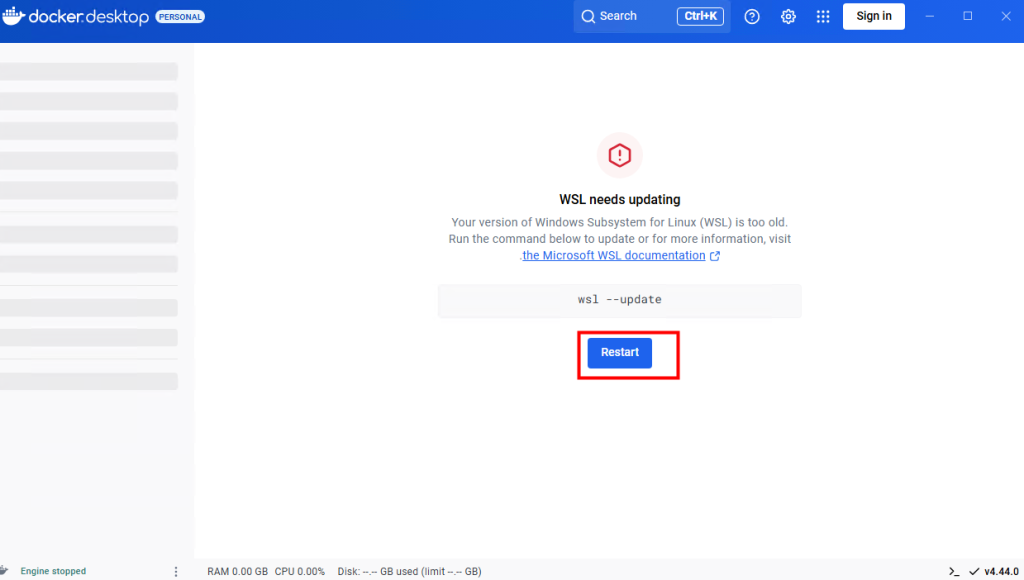
Patientez si des mises à jour sont nécessaires, puis redémarrez si demandé :

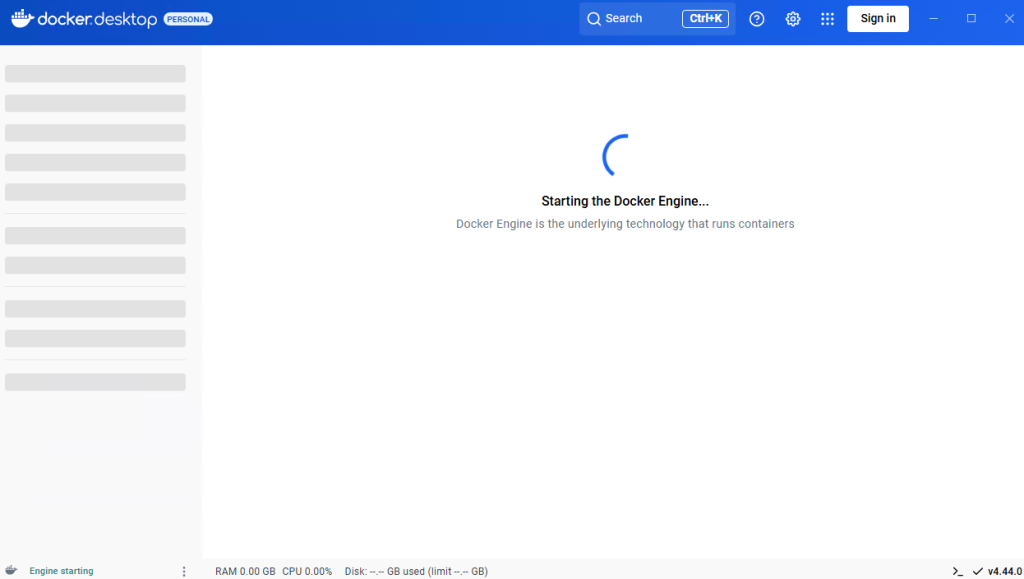
Attendez le démarrage complet de Docker Engine :

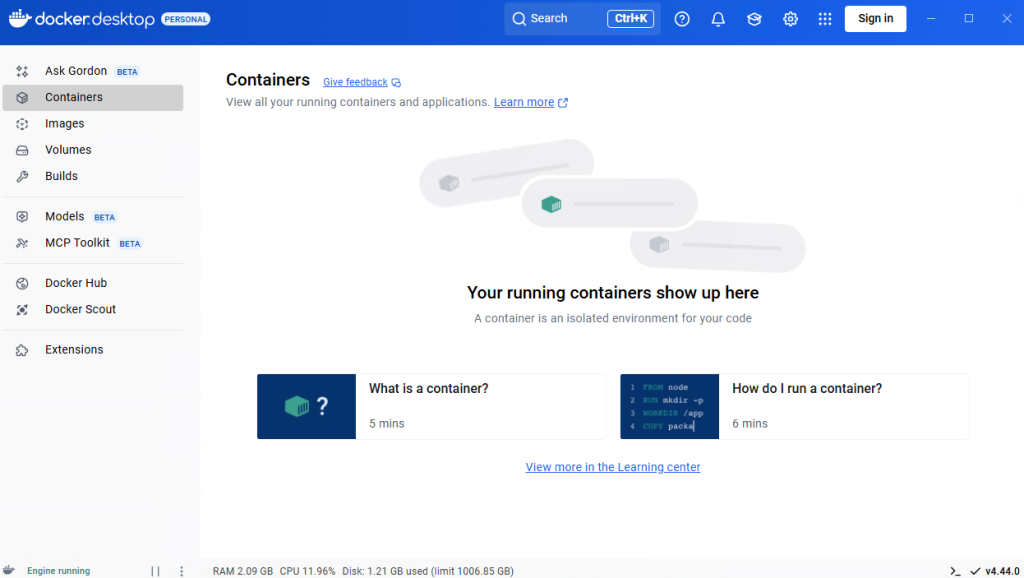
Vous devez voir l’écran principal de Docker Desktop avec un tableau de bord vide de conteneurs :

Ouvrez Visual Studio Code, puis ouvrez un nouveau terminal :

Lancez la commande azd pour vérifier si Azure Developer CLI est installé :

azd version

Si Azure Developer CLI n’est pas installé, exécutez la commande pour l’installer :

winget install microsoft.azd

Attendez la fin de l’installation :

Fermez puis rouvrez Visual Studio Code et vérifiez que azd est bien installé :

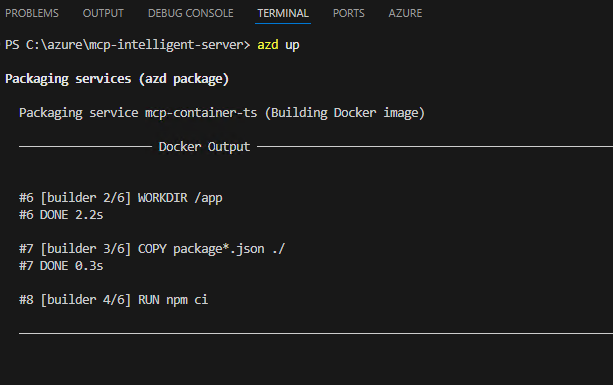
Depuis le dossier du serveur MCP, lancez la commande azd up pour déployer l’infrastructure sur Azure :

Connectez-vous avec votre compte Azure :

Patientez pendant la préparation de l’image du conteneur :

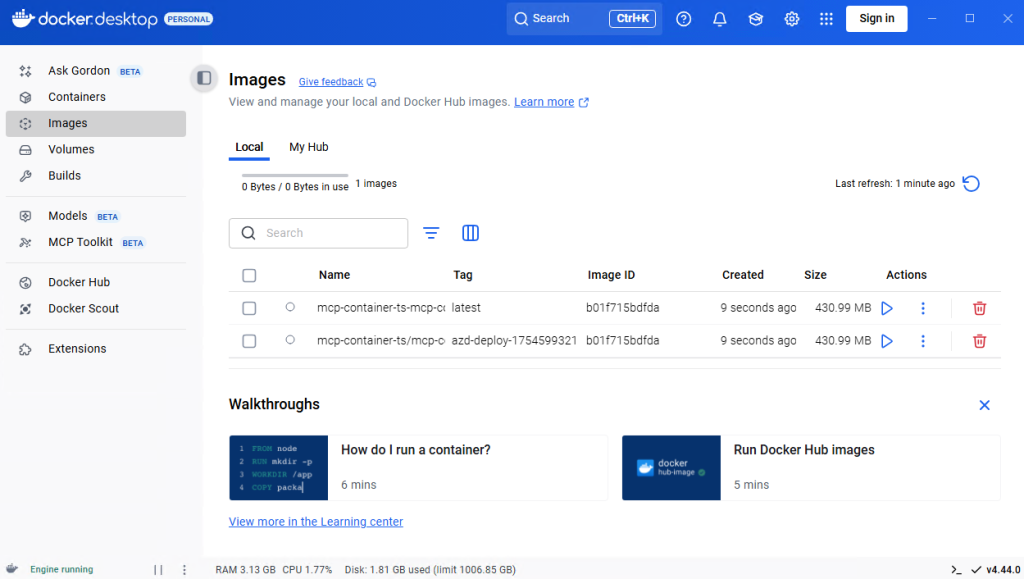
Constatez la création locale des images Docker dans Docker Desktop :

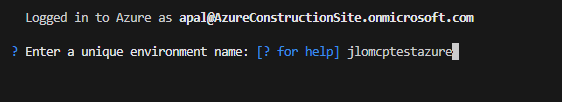
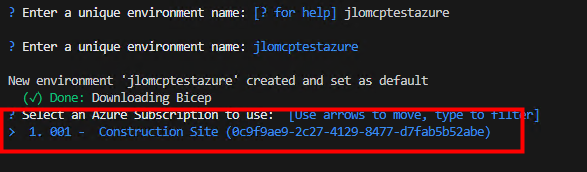
Donnez un nom à votre application unique sur Azure :

Choisissez votre souscription Azure :

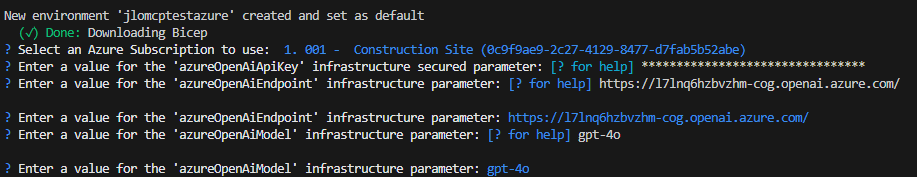
Saisissez les informations liées à Azure OpenAI :

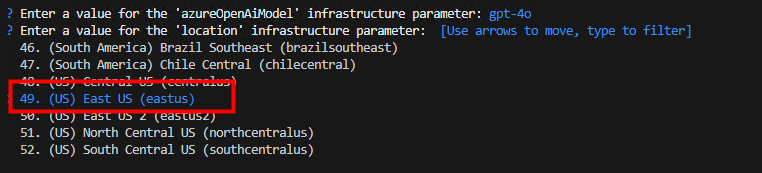
Sélectionnez la région Azure :

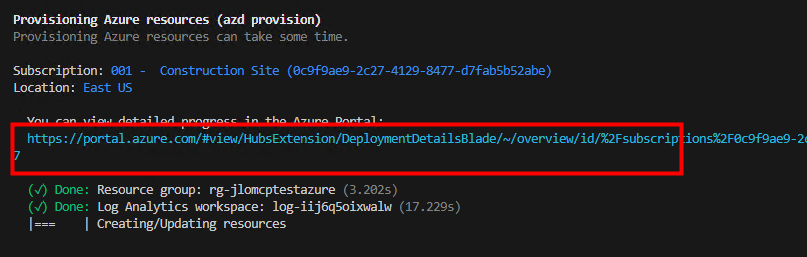
Attendez la fin du déploiement des ressources Azure :

Sur le portail Azure, vérifiez la création complète des ressources :

Quelques minutes plus tard :

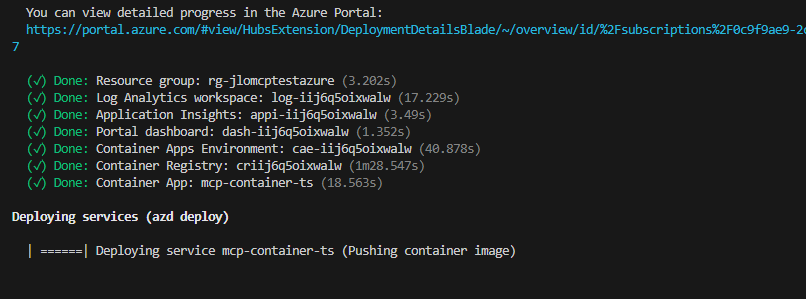
Attendez encore la fin du déploiement de l’image :

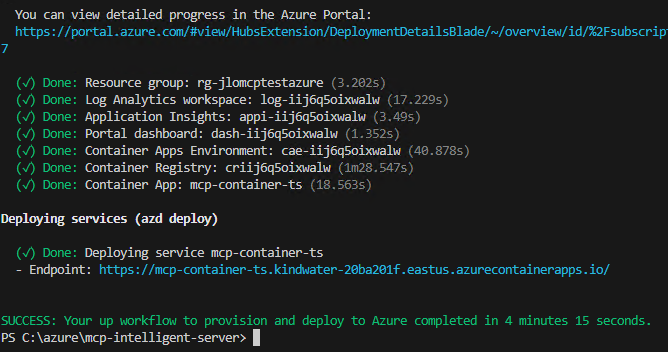
Constatez le déploiement terminé dans Visual Studio Code :

Retournez sur Azure et ouvrez la page de votre Azure Container App :

Copiez l’URL publique de votre application :

Dans la section Revisions and Replicas, vérifiez que le conteneur est démarré :

Dans Environment Variables, récupérez ou vérifiez la présence du token d’application :

Depuis Visual Studio Code, relancez MCP Inspector en local :

npm run inspect

Copiez l’URL avec le token de MCP Inspector :

Connectez MCP Inspector à votre Azure Container App avec l’URL et le token :

Effectuez à nouveau des opérations List_ToDo et créez de nouvelles tâches :

Testez différents prompts de listing et de complétion :

Testez également la partie prompting :

Vérifiez que la base temporaire SQLite est bien mise à jour :

Conclusion

Avec ce déploiement, vous disposez désormais d’un serveur MCP pleinement opérationnel, capable de dialoguer avec vos modèles d’IA et de gérer des outils de manière sécurisée, que ce soit en local ou dans le cloud Azure.

Et la suite ?

Si le sujet vous intéresse, je vous recommande vivement de consulter cette page, vous y trouverez d’autres serveurs MCP déjà mis à disposition, que vous pourrez tester pour découvrir leurs capacités, et dont la liste ne cesse de s’allonger.

Enfin, il peut également être intéressant d’explorer la création de serveurs MCP personnalisés dans l’environnement Microsoft 365, d’autant qu’une vidéo très pertinente sur le sujet est également disponible :

Ajoutez du MCP à votre IA !
Alex Wolf, de la chaîne YouTube The Code Wolf, continue de peaufiner son application DBChatPro version après version et dévoile la v6 ! Cette nouvelle version intègre maintenant un serveur MCP, exposant les fonctionnalités clés de DBChatPro à d’autres outils d’IA (GitHub Copilot, etc.) ou même à vos propres applications. Dans cet article, nous explorons les fondamentaux du MCP, puis nous détaillons l’installation du serveur MCP de DBChatPro.
Avant toute manipulation technique, et pour bien saisir l’intérêt d’une architecture MCP, je vous recommande la lecture de l’excellent billet disponible sur Digidop, écrit par Thibaut Legrand. Voici un extrait de ce billet qui illustre parfaitement l’avantage d’une architecture MCP :

Qu’est-ce que le Model Context Protocol (MCP) ?

Le Model Context Protocol (MCP) est un standard ouvert conçu par Anthropic (l’entreprise à l’origine de Claude) qui offre aux modèles d’IA un accès sécurisé à diverses sources de données et outils externes.

Il fonctionne comme un « USB-C universel » pour l’IA, facilitant la communication avec n’importe quel service ou base de données.

Pourquoi le MCP a été créé ?

Avant le MCP, relier un LLM à des sources externes était laborieux et non standardisé. Les grands modèles de langage (GPT, Claude, Gemini…) présentent deux limites majeures :

  1. Limite de contexte : Ils ne peuvent raisonner que sur les informations présentes dans leur contexte immédiat
  2. Impossibilité d’action : Ils peuvent générer du texte mais ne peuvent pas agir sur le monde extérieur

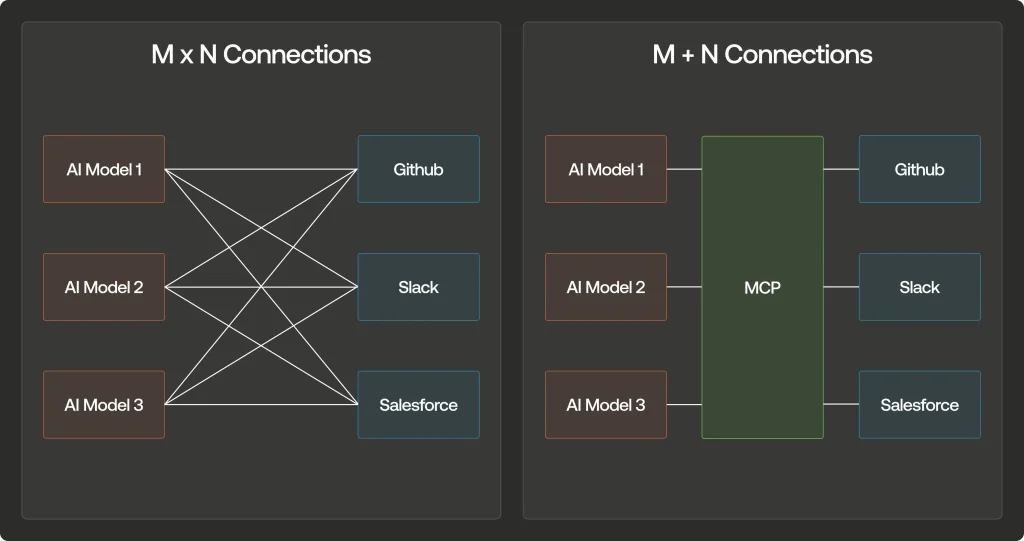
La métaphore du « problème M×N » illustre parfaitement cette situation : pour connecter un nombre M modèles d’IA à un nombre N outils externes, il fallait créer M×N intégrations différentes. Le MCP transforme cette équation en M+N, réduisant drastiquement la complexité d’intégration.

Prenons un exemple concret :

une entreprise utilisant 4 modèles d’IA différents (Claude, GPT-4, Gemini, Deepseek) qui souhaite les connecter à 5 services externes (GitHub, Slack, Google Drive, Salesforce, base de données interne).

Sans MCP, cela nécessiterait 4×5=20 intégrations personnalisées. Avec MCP, on passe à seulement 4+5=9 composants (4 clients MCP et 5 serveurs MCP), soit une réduction de 55% de la complexité et du temps de développement.

MCP vs API traditionnelles : quelles différences ?

Pour comprendre l’importance du MCP, comparons-le aux API REST traditionnelles :

CaractéristiqueMCPAPI REST traditionnelles
CommunicationBidirectionnelle et en temps réelGénéralement requête-réponse unidirectionnelle
Découverte d’outilsAutomatique et dynamiqueConfiguration manuelle nécessaire
Conscience du contexteIntégréeLimitée ou inexistante
ExtensibilitéPlug-and-playEffort d’intégration linéaire
StandardisationProtocole unifié pour tous les modèlesVariable selon les services
OrientationConçu spécifiquement pour les modèles d’IAUsage général

Cette standardisation représente un changement de paradigme pour quiconque souhaite développer des applications IA véritablement connectées.

Architecture et fonctionnement du MCP

L’architecture du MCP repose sur trois composants principaux qui interagissent de façon coordonnée :

Les composants clés du MCP

  1. Hôtes MCP : Ce sont les applications qui intègrent l’IA et ont besoin d’accéder à des données externes. Par exemple, Claude Desktop, un IDE comme Cursor, ou toute application intégrant un LLM.
  2. Clients MCP : Ce sont des intermédiaires qui maintiennent les connexions sécurisées entre l’hôte et les serveurs. Chaque client est dédié à un serveur spécifique pour garantir l’isolation.
  3. Serveurs MCP : Ce sont des programmes externes qui fournissent des fonctionnalités spécifiques et se connectent à diverses sources comme Google Drive, Slack, GitHub, ou des bases de données.

Le flux de communication MCP se déroule typiquement en quatre étapes bien définies :

  1. Découverte : L’hôte (comme Claude Desktop) identifie les serveurs MCP disponibles dans son environnement
  2. Inventaire des capacités : Les serveurs MCP déclarent leurs fonctionnalités disponibles (outils, ressources, prompts)
  3. Sélection et utilisation : Quand l’utilisateur pose une question nécessitant des données externes, l’IA demande l’autorisation d’utiliser un outil spécifique
  4. Exécution et retour : Le serveur MCP exécute l’action demandée (recherche web, accès à un fichier, etc.) et renvoie les résultats à l’IA qui peut alors formuler une réponse complète

Ce processus standardisé permet une communication fluide entre l’IA et les sources de données externes, tout en maintenant un contrôle transparent pour l’utilisateur.

Serveurs MCP existants

Plutôt que de développer vos propres serveurs MCP depuis zéro, vous pouvez exploiter l’écosystème grandissant de serveurs préexistants. Ces solutions prêtes à l’emploi vous permettent d’intégrer rapidement des fonctionnalités avancées dans vos projets IA :

Serveurs officiels et communautaires

  • GitHub : Ce serveur MCP vous permet d’interagir avec des dépôts de code directement depuis votre application IA. Vous pouvez rechercher des fichiers, créer des issues, analyser des pull requests, ou même générer des commits et du code. Idéal pour les assistants de développement qui nécessitent une compréhension du contexte du code.
  • Google Drive : Offre un accès complet aux documents stockés sur Google Drive. Votre modèle d’IA peut ainsi lire, créer, modifier ou organiser des documents, présentations et feuilles de calcul, en conservant le contexte des informations partagées.
  • Slack : Permet à vos modèles d’IA d’interagir avec les canaux et conversations Slack. Ils peuvent envoyer des messages, surveiller des chaînes spécifiques, ou même répondre automatiquement à certains types de requêtes, créant ainsi une intégration transparente dans les flux de communication d’équipe.
  • Puppeteer : Un puissant serveur MCP qui apporte la capacité de naviguer sur le web. Vos modèles d’IA peuvent visiter des sites, remplir des formulaires, capturer des captures d’écran et extraire des données, ouvrant la voie à l’automatisation avancée des tâches web.
  • Brave Search : Donne à vos modèles d’IA la capacité d’effectuer des recherches web en temps réel via le moteur Brave. Cela permet de répondre à des questions sur l’actualité récente ou d’accéder à des informations au-delà de la date limite de formation du modèle.
  • PostgreSQL : Connecte vos modèles d’IA directement à vos bases de données PostgreSQL. Les modèles peuvent effectuer des requêtes SQL, analyser des données et même assister à la conception de schémas de base de données.
  • SQLite : Variante plus légère pour les bases de données locales, particulièrement utile pour les applications de bureau ou les projets avec des exigences de stockage plus modestes.
  • Qdrant : Serveur spécialisé pour les bases de données vectorielles, essentiel pour les applications IA nécessitant une recherche sémantique ou par similarité.

Afin de voir comment cela marche, voici les différentes étapes que nous allons suivre sur un environnement de test :

Maintenant, il nous reste plus qu’à tester tout cela 😎

Etape 0 – Rappel des prérequis :

Pour réaliser cet exercice, il vous faudra disposer de :

  • Un tenant Microsoft
  • Une souscription Azure valide

Commençons par créer quelques ressources (IA et DB) sur Azure et Entra.

Etape I – Création des ressources Azure :

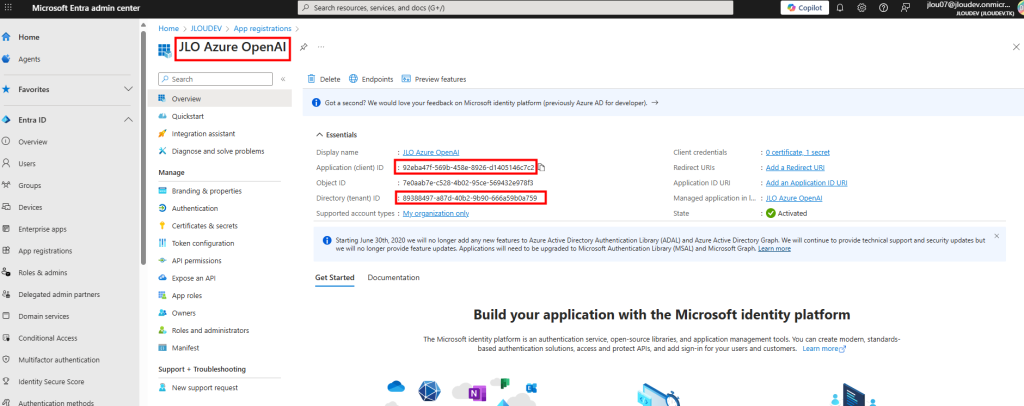
Connectez-vous au portail Entra Admin Center pour enregistrer une nouvelle application, puis récupérez ensuite l’Application ID et le Tenant ID :

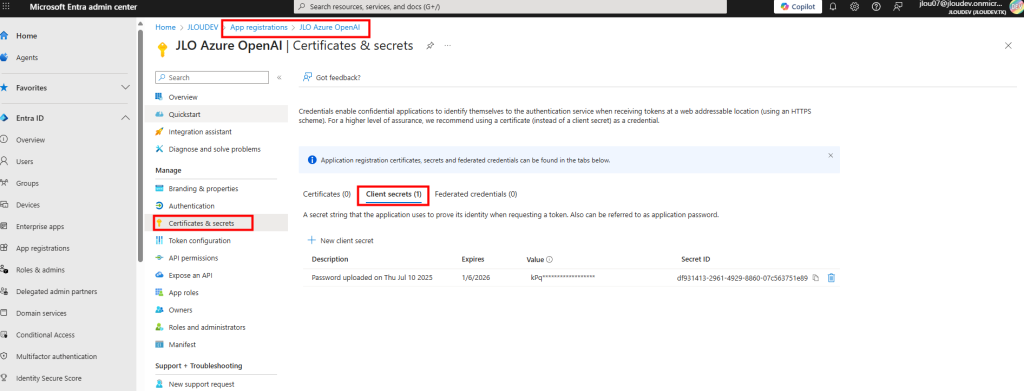
Créez un secret client puis copiez immédiatement sa valeur car elle ne sera plus visible par la suite :

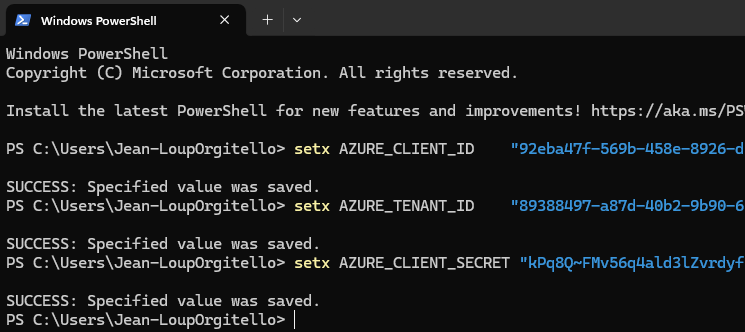
Ouvrez une session Windows PowerShell, puis définissez trois variables d’environnement pour l’App ID, le Directory ID et le Client Secret :

setx AZURE_CLIENT_ID    "xxx"
setx AZURE_TENANT_ID    "yyy"
setx AZURE_CLIENT_SECRET "zzz"

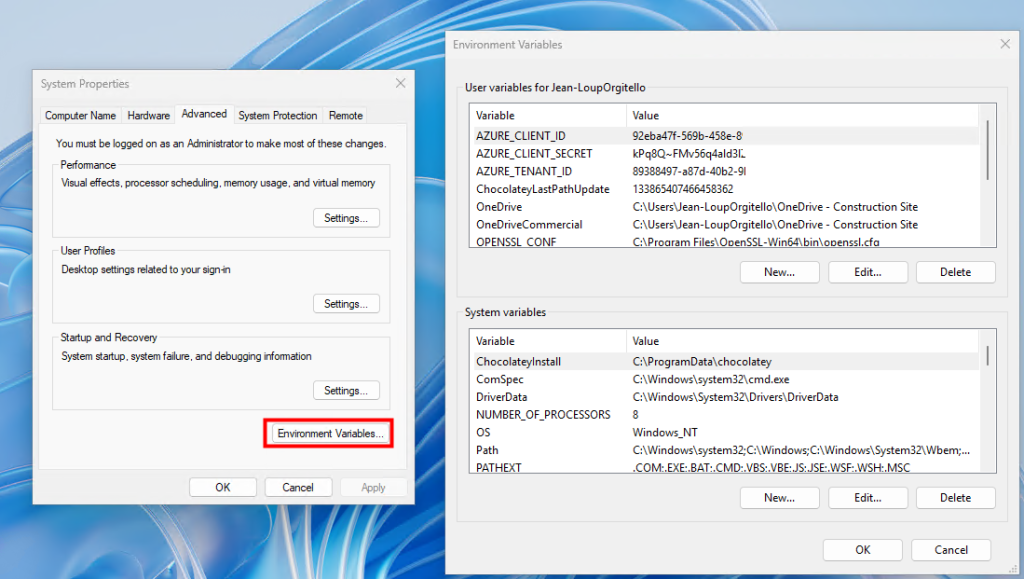
Vérifiez ces variables dans les Propriétés système de Windows, section « Variables d’environnement », afin de confirmer leur bonne configuration :

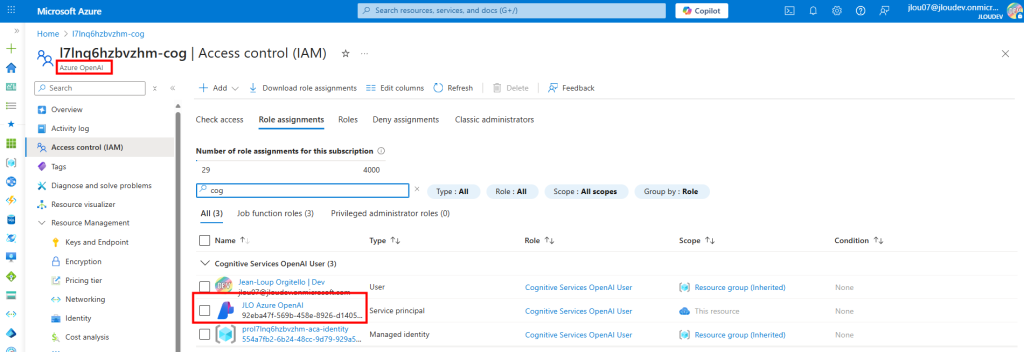
Créez un service Azure OpenAI depuis le portail Azure, puis ajoutez votre application en tant que « Cognitive Services OpenAI User » dans « Contrôle d’accès (IAM) » :

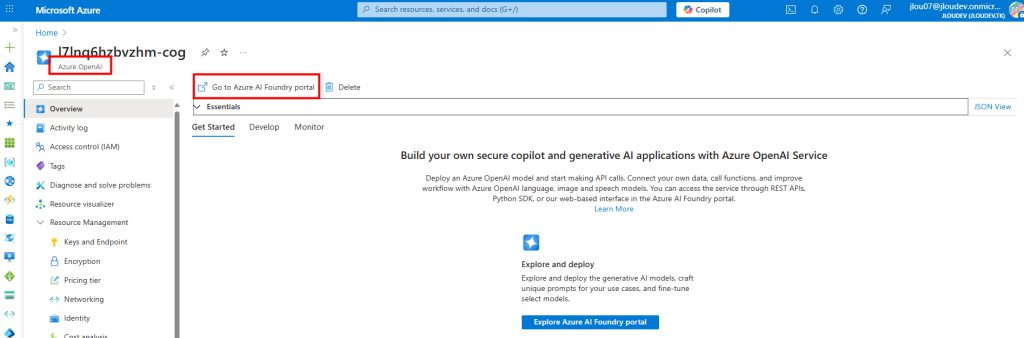
Revenez à la page principale de votre service Azure OpenAI, puis cliquez sur Ouvrir dans la Fonderie pour accéder à l’interface de déploiement :

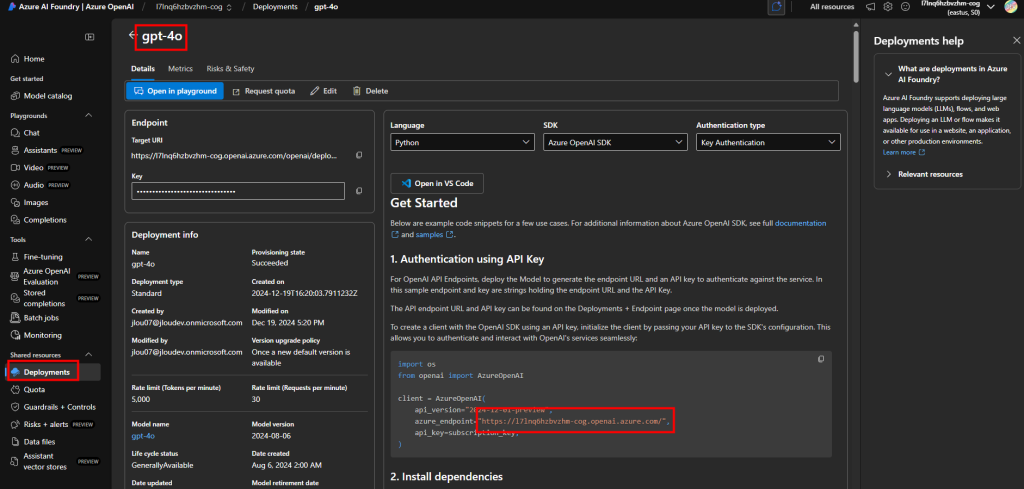
Dans la Fonderie, ouvrez l’onglet Déploiements et cliquez sur Nouveau déploiement, puis nommez-le (par ex : gpt-4o) et copiez l’URL de l’endpoint :

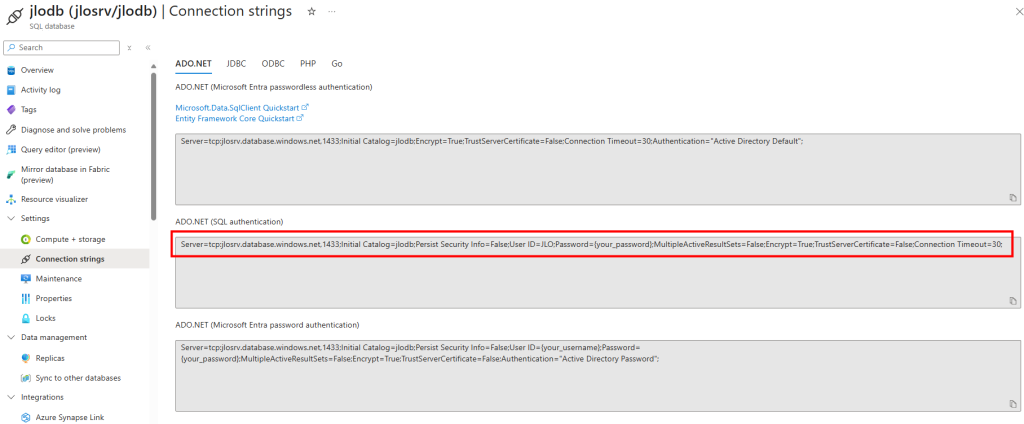
Créez une base de données Azure SQL Database avec des données en exemple, puis copiez la chaîne de connexion complète pour la réutiliser plus tard :

Notre environnement Azure est prêt. Nous allons maintenant pouvoir déployer l’application DBChatPro sur notre poste en local.

Etape II – Déploiement et test de l’application DBChatPro :

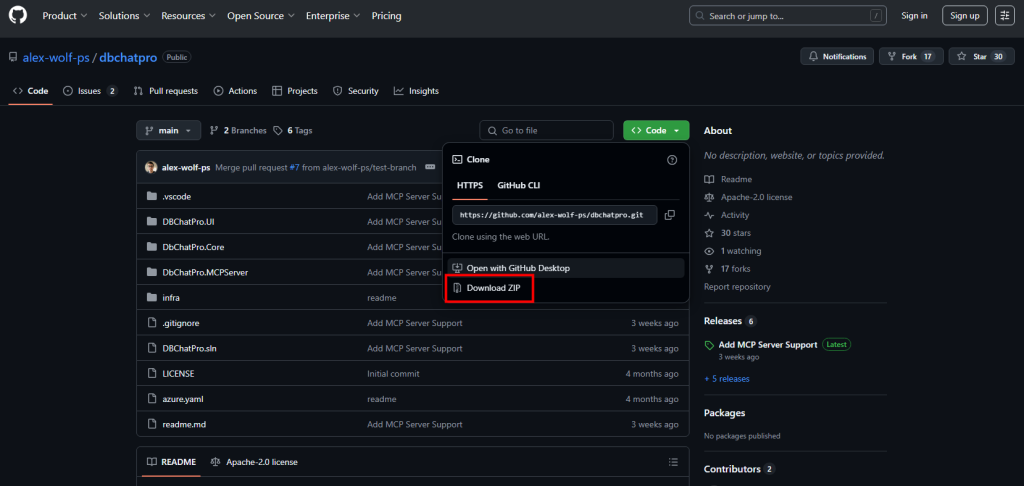
Accédez au dépôt GitHub de l’application via le lien, puis téléchargez l’archive ZIP sur votre poste :

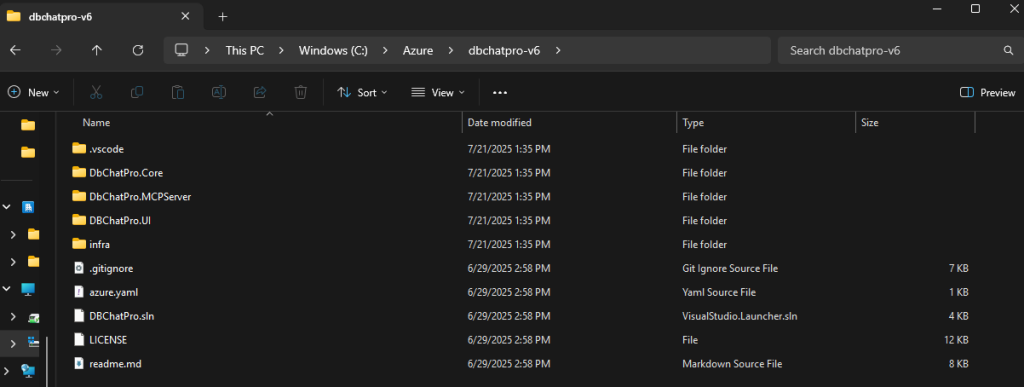
Extrayez l’archive ZIP, puis placez-vous dans le dossier extrait pour préparer l’ouverture du projet :

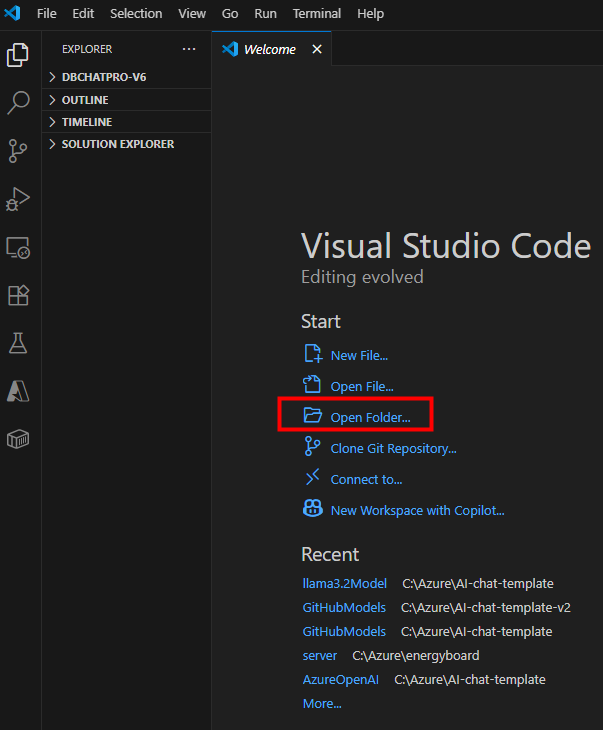
Lancez Visual Studio Code, puis cliquez ici pour sélectionner le dossier du projet :

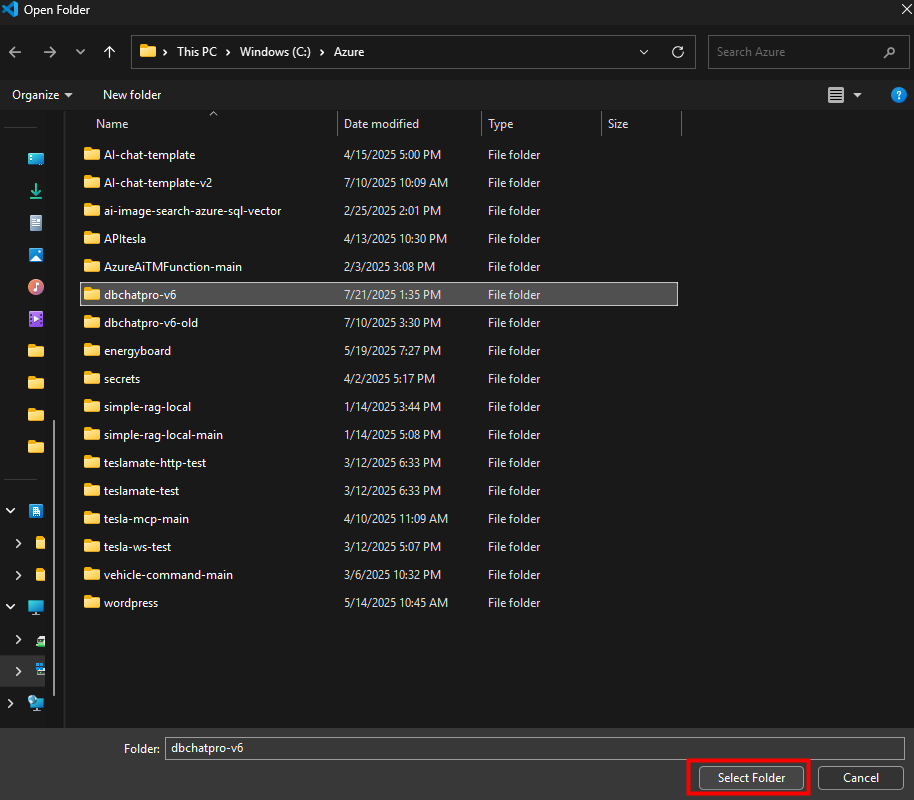
Sélectionnez le dossier extrait contenant le projet, puis validez pour l’ouvrir dans VS Code :

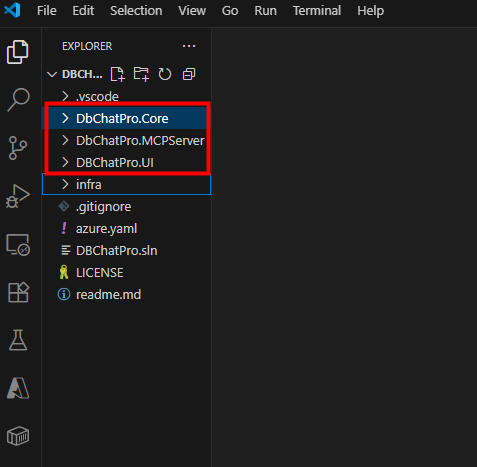
Observez la nouvelle architecture de DBChatPro avec la partie MCP distincte de l’interface graphique, puis passez à la configuration UI :

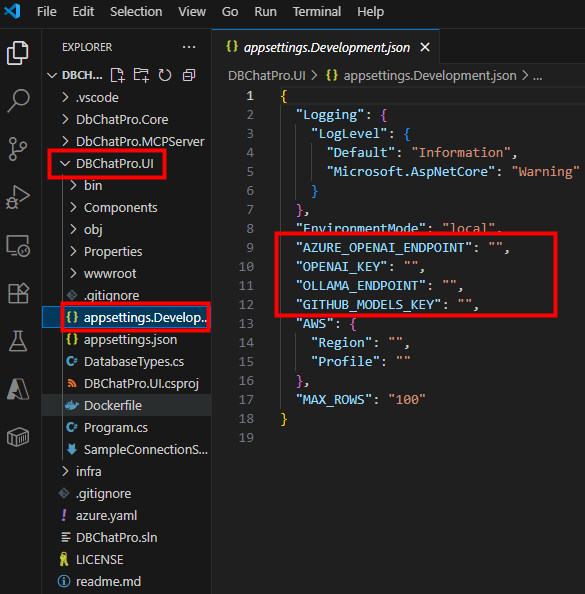
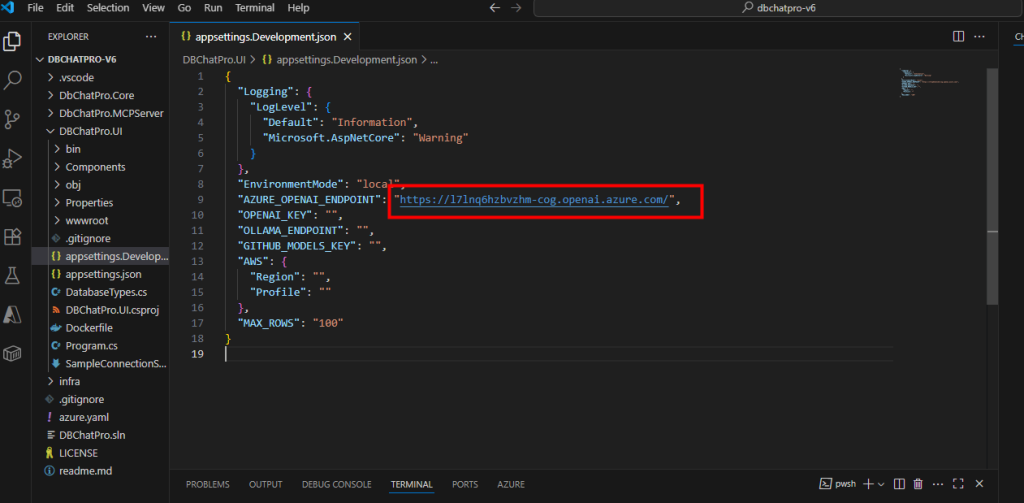
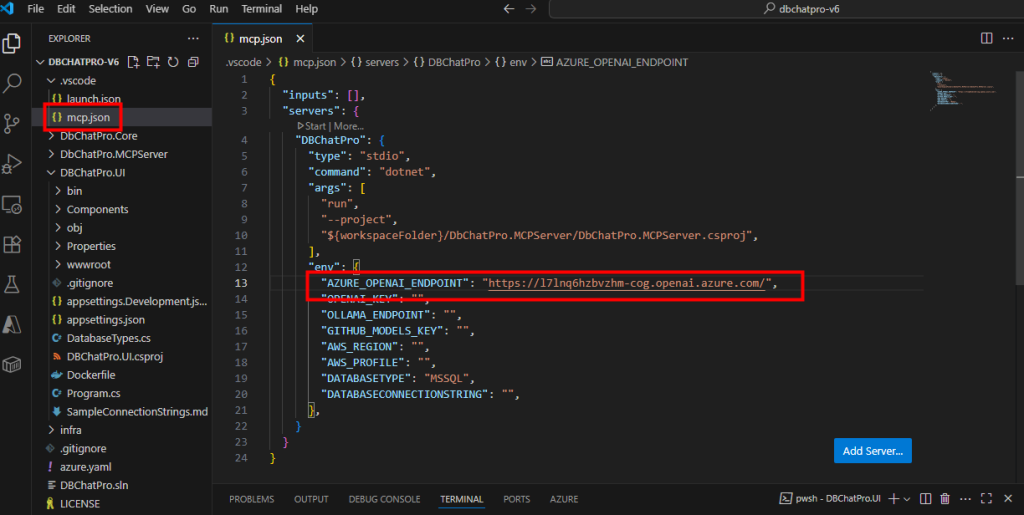
Commencez par l’interface graphique en renseignant les endpoints de votre choix dans le fichier de configuration, puis sauvegardez vos modifications :

Dans mon cas, j’ai utilisé le modèle Azure OpenAI :

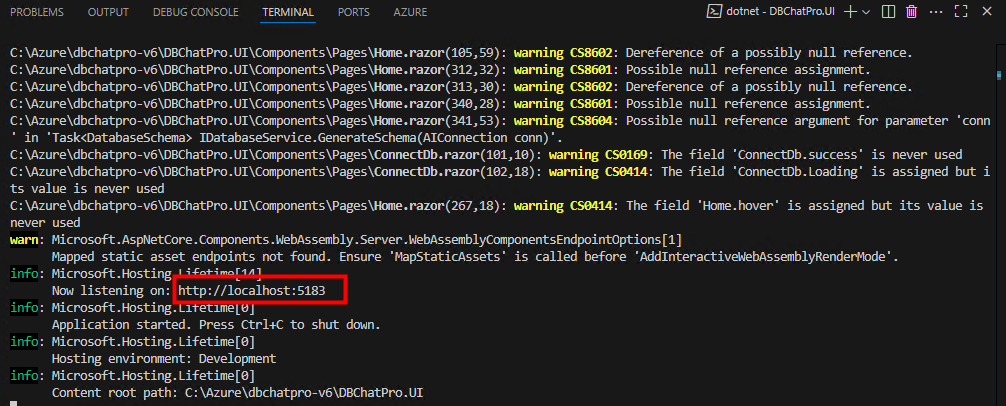
Ouvrez la console intégrée Terminal de VS Code, positionnez-vous dans le dossier racine de l’application, lancez l’application, puis patientez quelques secondes pour que le serveur local démarre :

Copiez l’URL locale générée par l’application, puis ouvrez-la dans votre navigateur préféré :

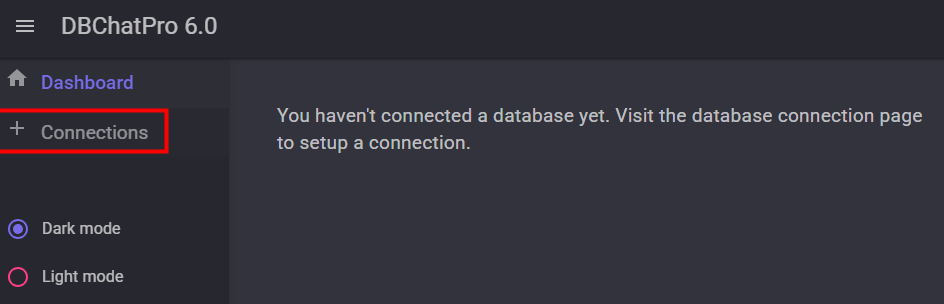
Dans le navigateur, constatez que la base de données n’est pas encore configurée, puis cliquez sur Connexion :

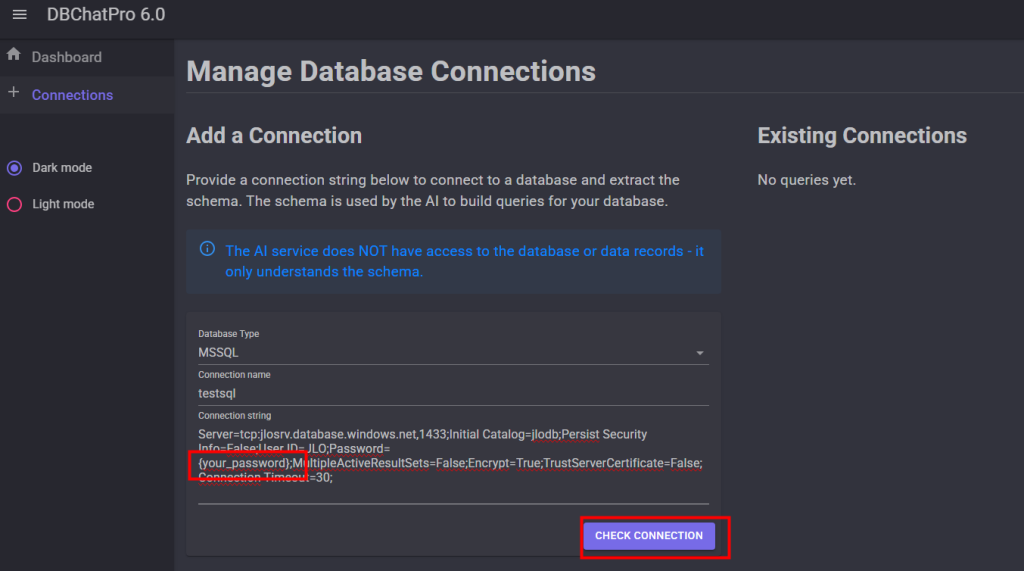
Collez votre chaîne de connexion SQL en modifiant le mot de passe, puis cliquez sur Check Connection pour tester la liaison :

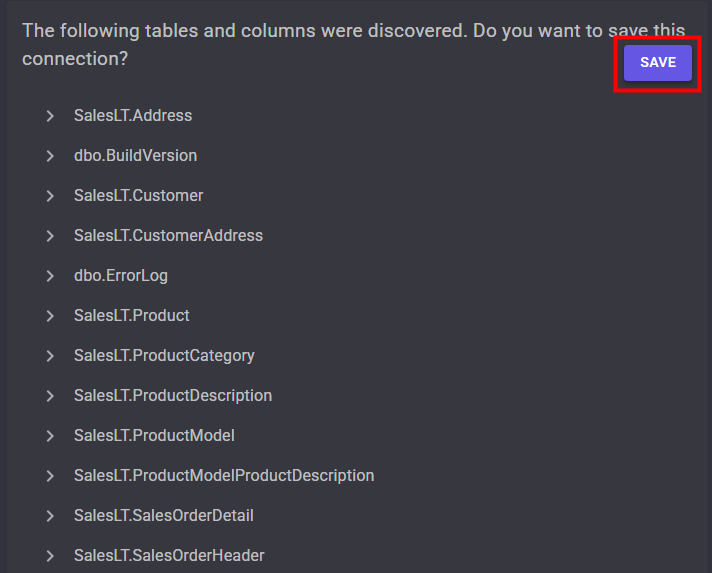
Vérifiez la découverte automatique du schéma de la base de données, puis cliquez ici pour sauvegarder pour valider l’import :

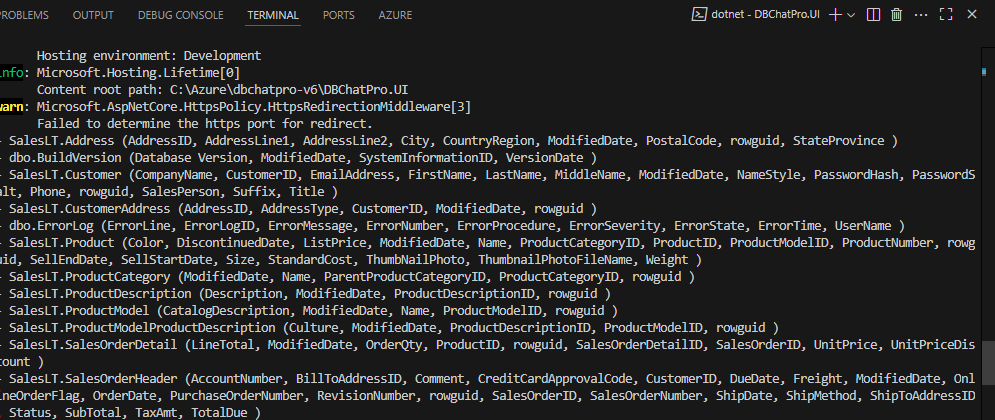
Dans le terminal, observez également l’import du plan et du schéma de votre base SQL :

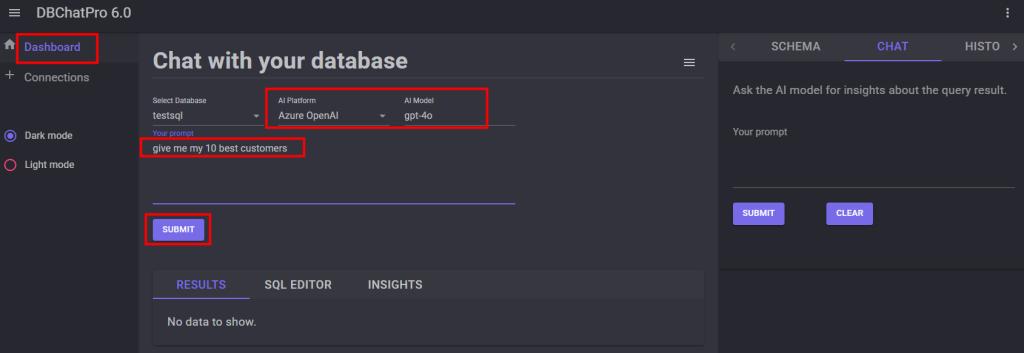
Sur la page principale de l’application, sélectionnez le modèle et la plateforme d’IA, puis saisissez votre prompt :

Patientez quelques secondes pour afficher le résultat généré par le modèle :

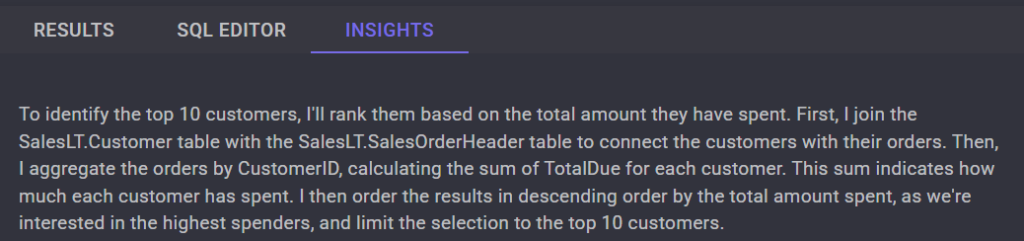
Consultez l’onglet Insight pour obtenir des informations complémentaires sur la réponse, puis analysez les données fournies :

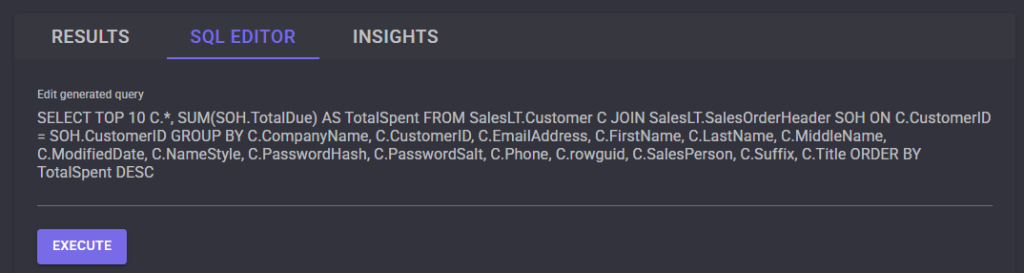
Sur l’onglet SQL Editor, constatez la transformation de votre requête en SQL :

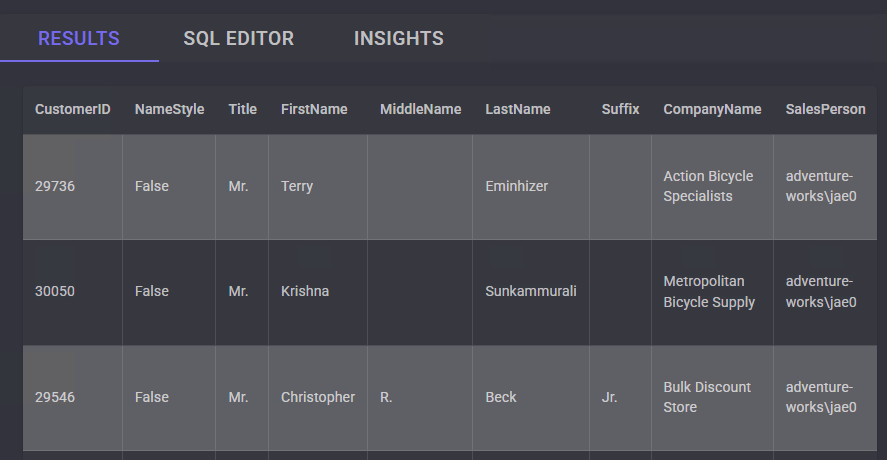
Observez les résultats sous forme de tableau retournés par la requête SQL :

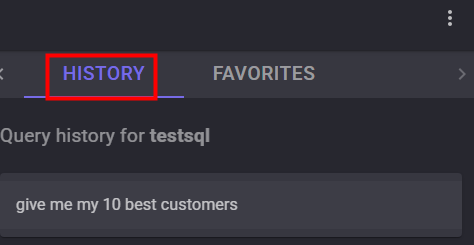
Accédez à l’historique des requêtes exécutées, puis identifiez celles que vous souhaitez réutiliser :

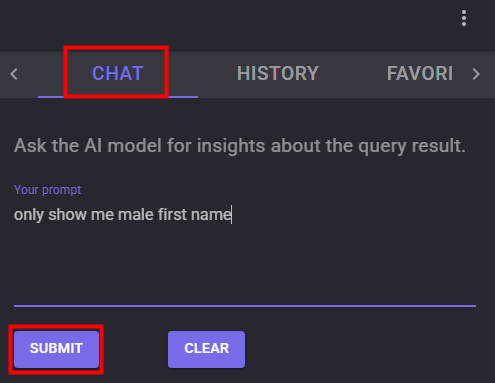
La fonction Chat vous permet de relancez une seconde requête basée sur les résultats de la première :

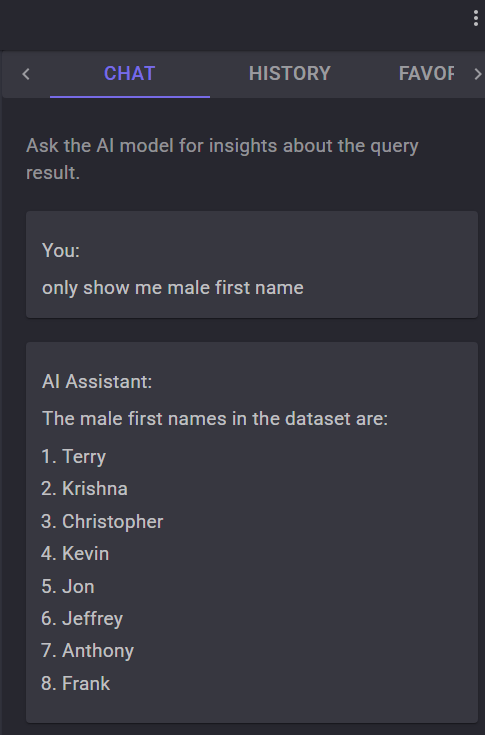
Testez cette seconde requête et constatez les résultats :

Au final, on constate que l’interface graphique de DBChatPro ne cesse d’évoluer pour offrir plus de facilité et une meilleure gestion des bases de données.

Passons maintenant à la partie MCP qui nous intéresse également.

Etape III – Déploiement du serveur MCP :

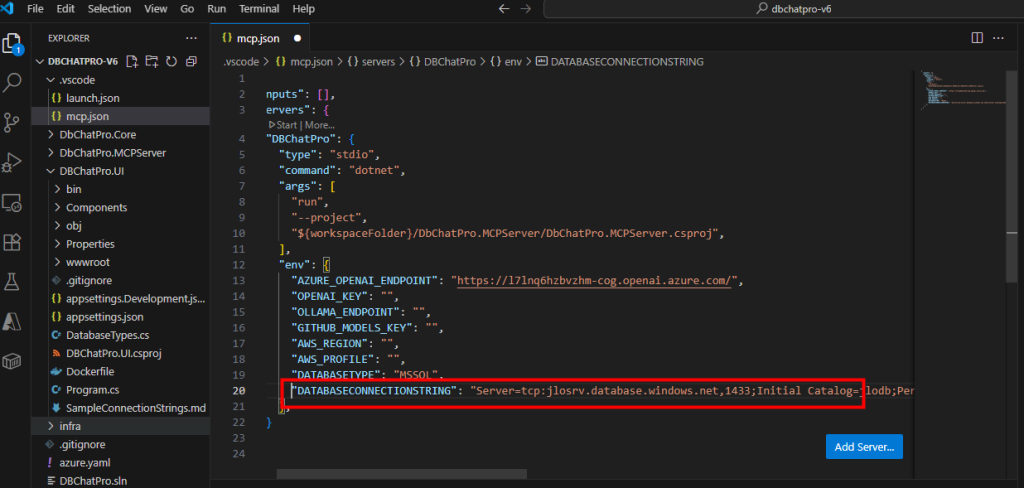
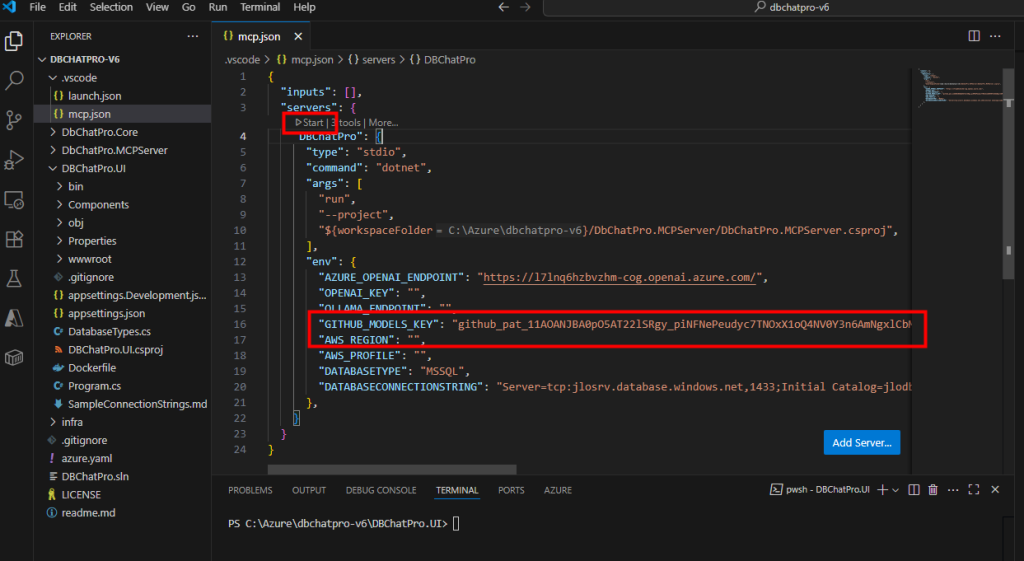
Revenez sur Visual Studio Code dans le programme MCP afin de paramétrer l’endpoint Azure OpenAI :

Collez également votre connexion SQL complète :

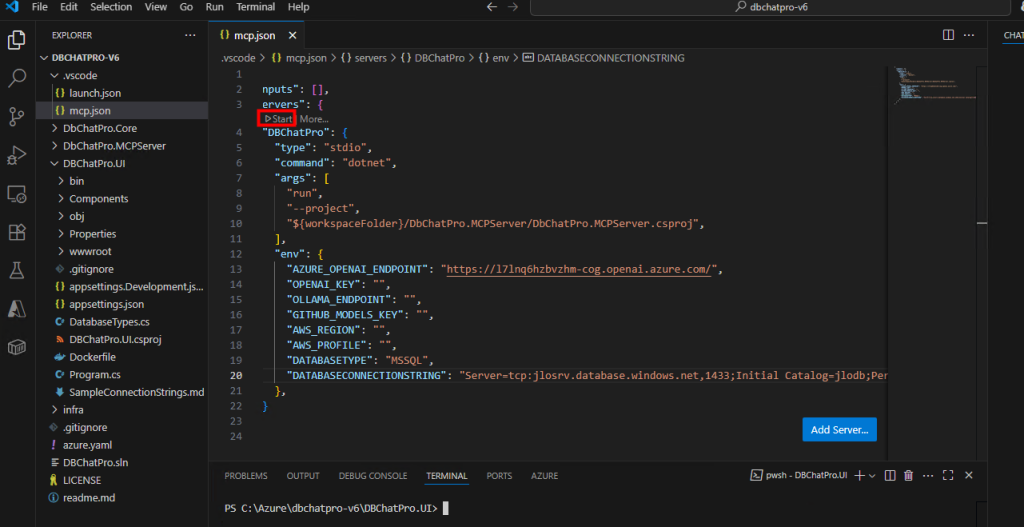
Cliquez sur le bouton Démarrer pour lancer le serveur MCP, puis patientez quelques instants :

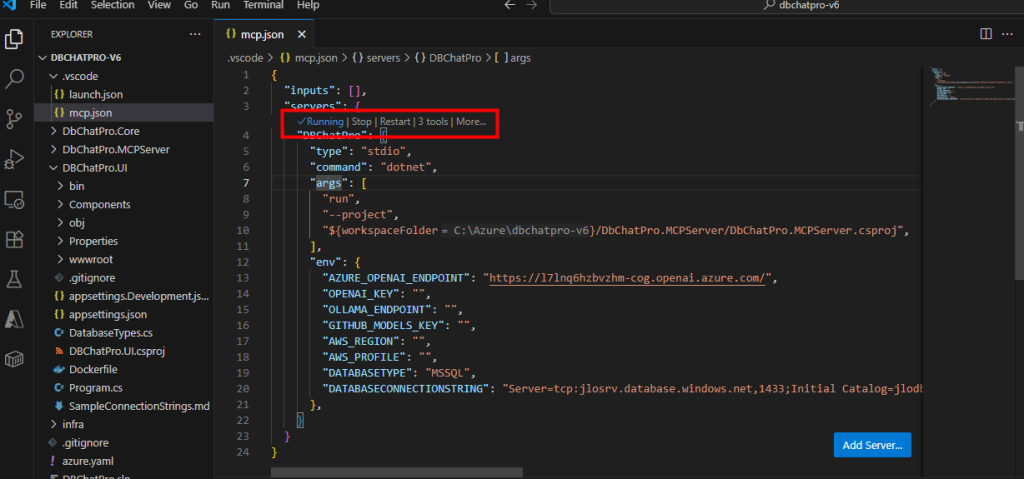
Vérifiez que le serveur est démarré et affiche l’état Running :

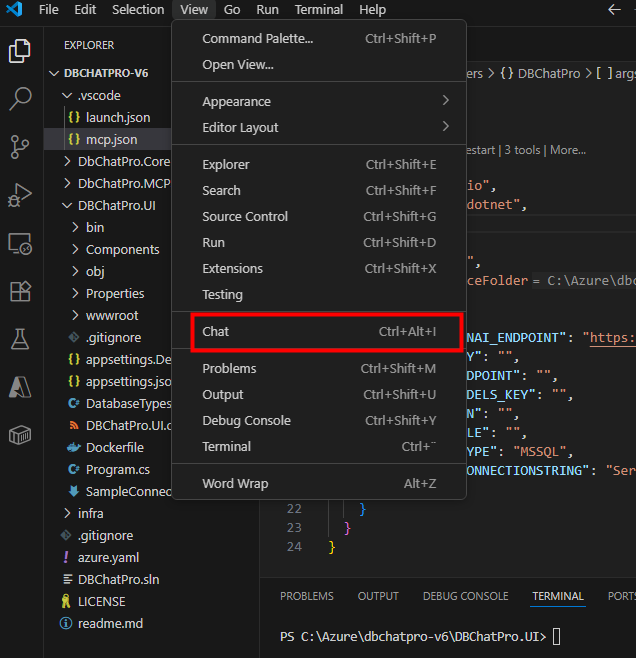
Ouvrez la fenêtre Chat dans Visual Studio Code :

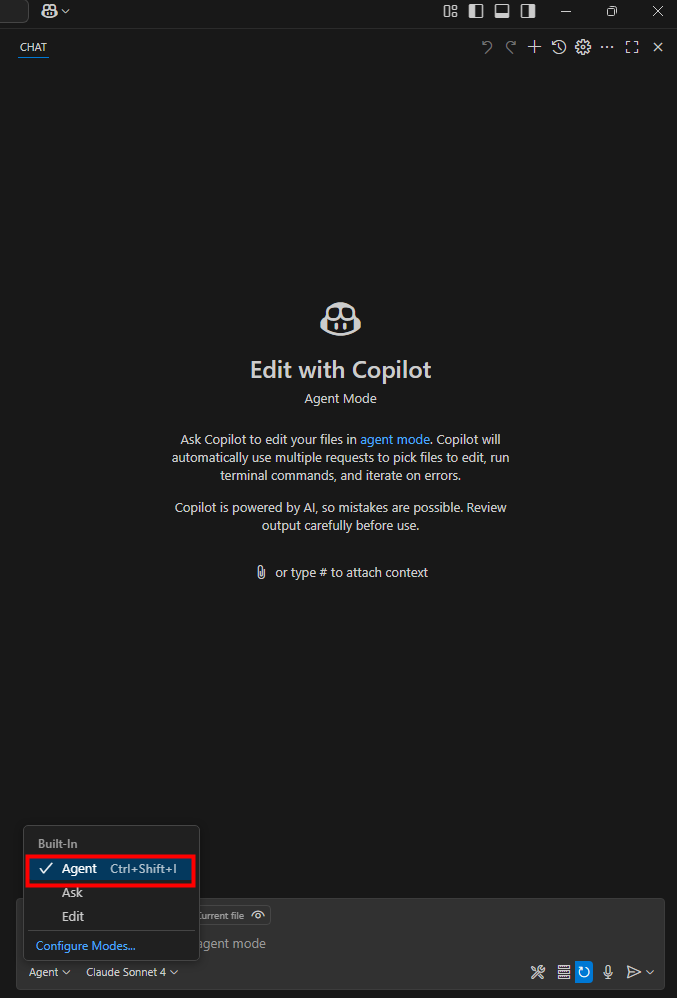
Assurez-vous que vous êtes en mode agent pour l’intelligence artificielle :

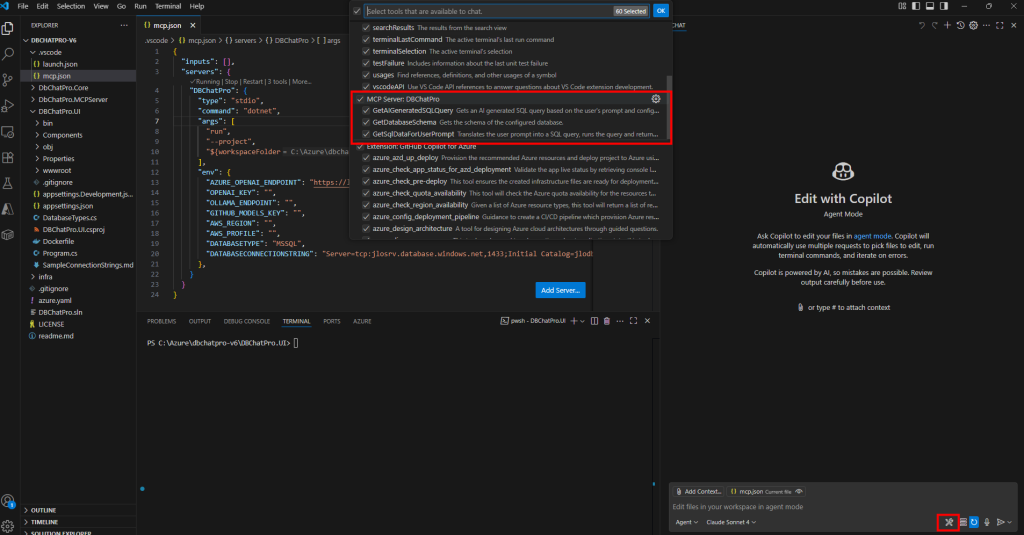
Dans la boîte à outils, confirmez que le serveur MCP et ses sous-modules sont actifs, puis refermez le panneau :

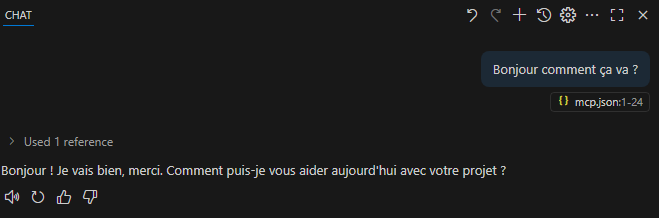
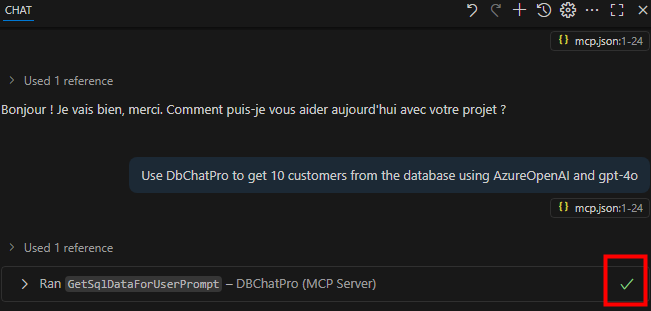
Effectuez un test de base pour vérifier que l’IA vous répond :

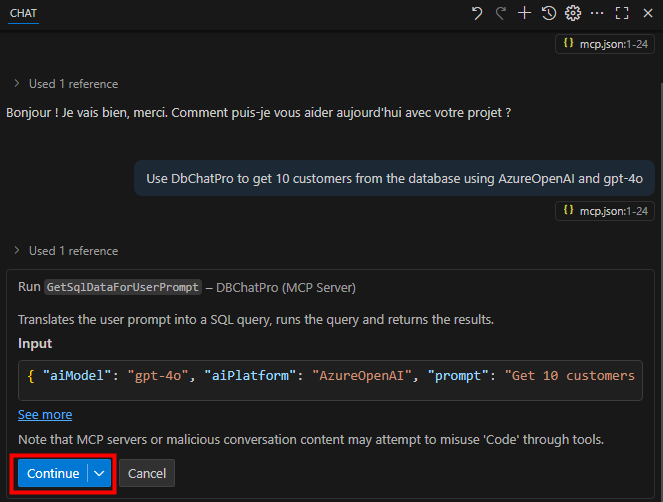
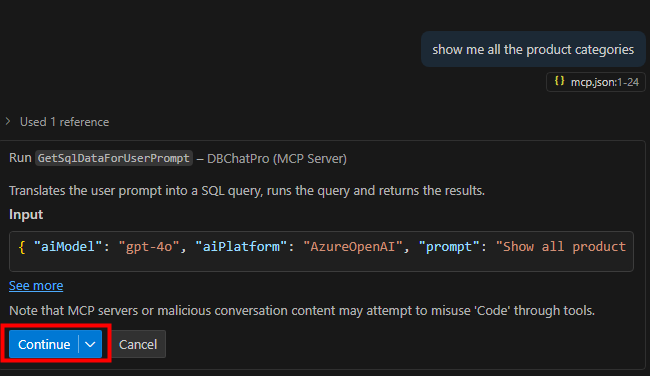
Lancez un prompt en spécifiant l’utilisation de DBChatPro avec un modèle et une plateforme AI, puis validez l’alerte :

use DbChatPro to get 10 customers from the database using AzureOpenAI and gpt-4o

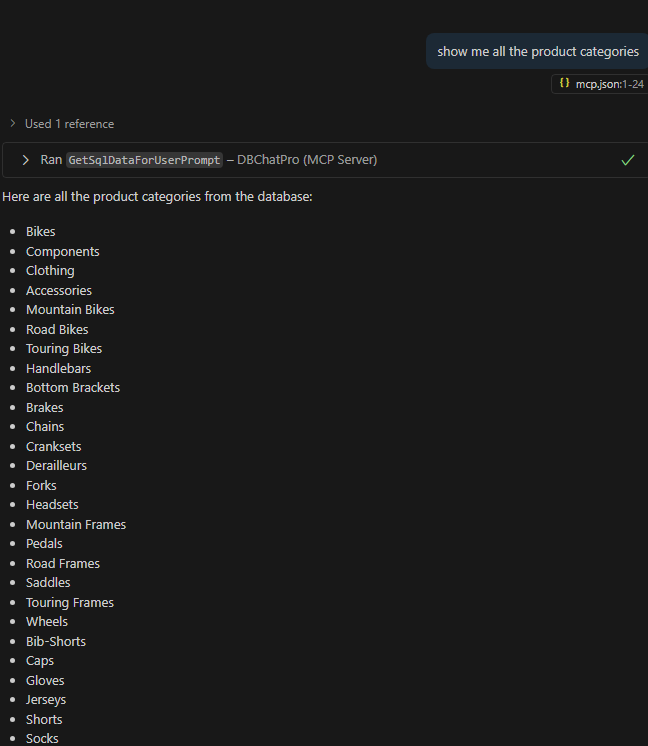
Constatez que la connexion à la base de données et au modèle a bien fonctionné :

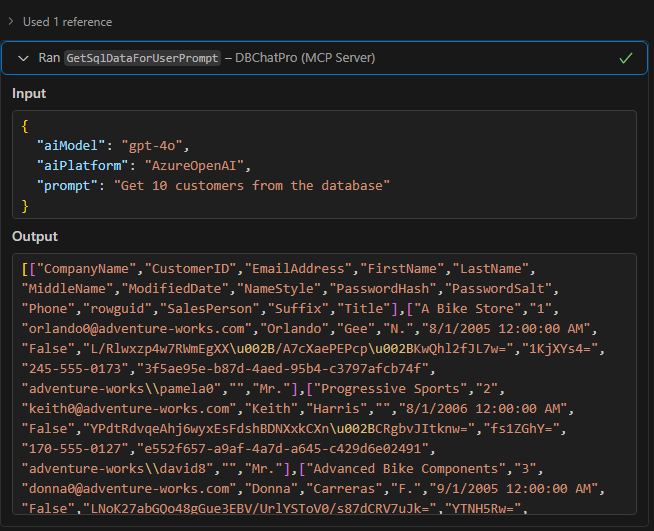
Observez en chat l’input et l’output de la requête :

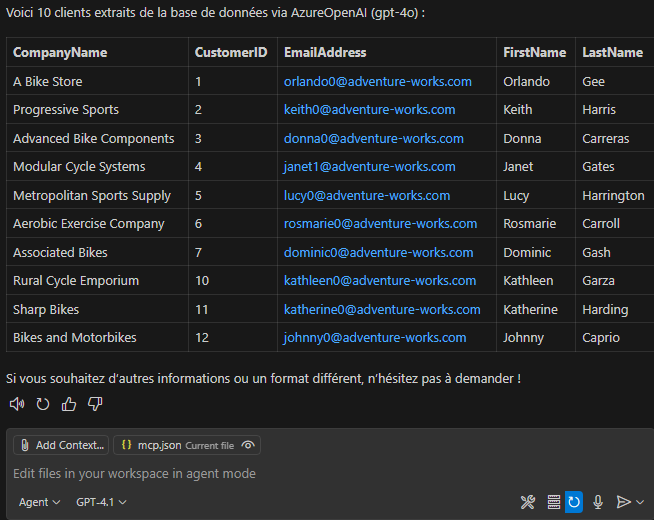
Visualisez le résultat sous forme de tableau retourné par l’IA :

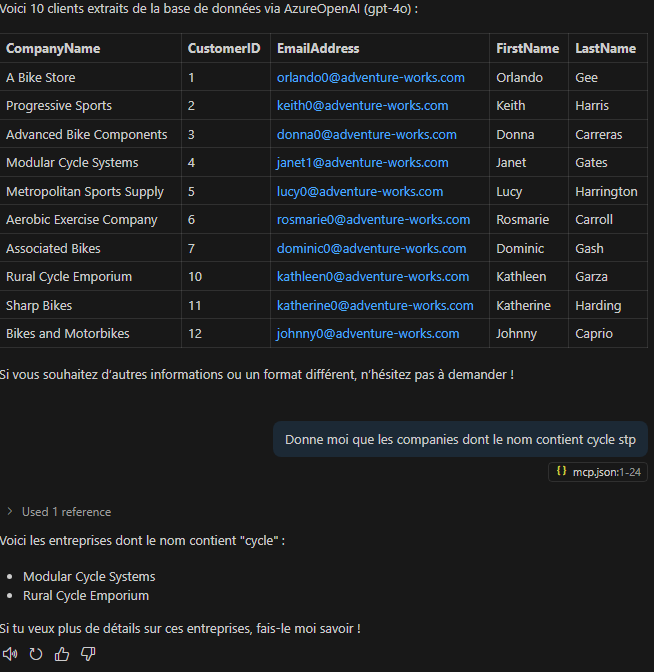
Lancez un second prompt sans redéfinir les paramètres du modèle, puis constatez que la réponse est tout de même générée :

Effectuez un autre test avec un prompt différent sur la même base :

Observez le résultat structuré cette fois en liste :

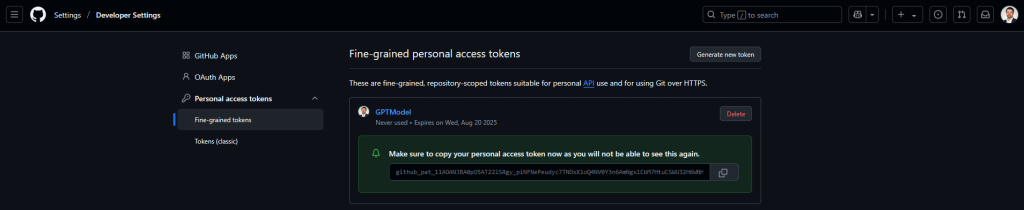
Si vous le souhaitez, testez la plateforme IA de GitHub en paramétrant un token d’accès sur cette page, puis copiez-le :

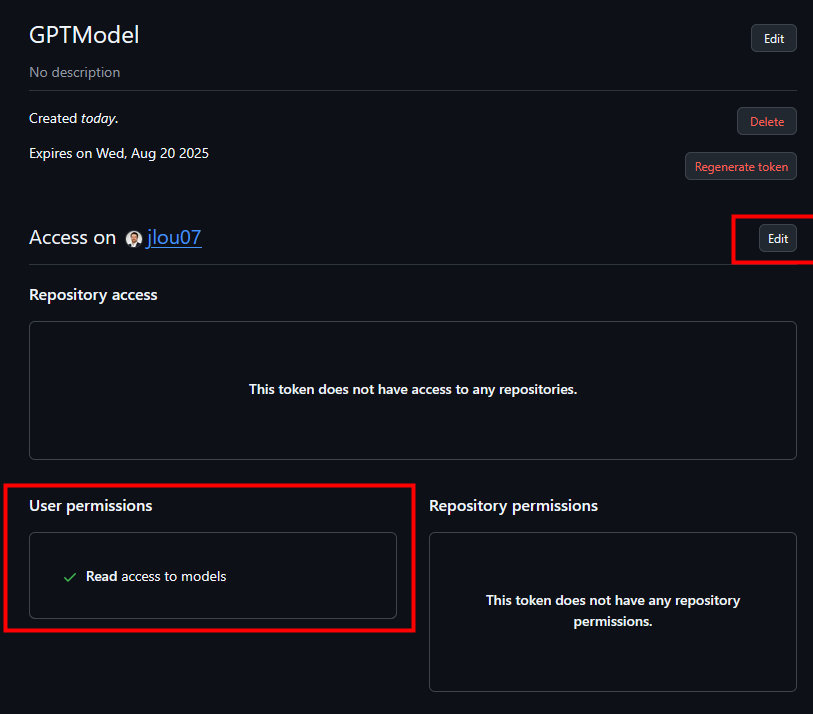
Sur ce token, autorisez l’accès en lecture pour interroger les modèles GitHub Copilot, puis confirmez cette permission :

Renseignez le modèle GitHub dans la configuration MCP et redémarrez le serveur, puis patientez quelques instants :

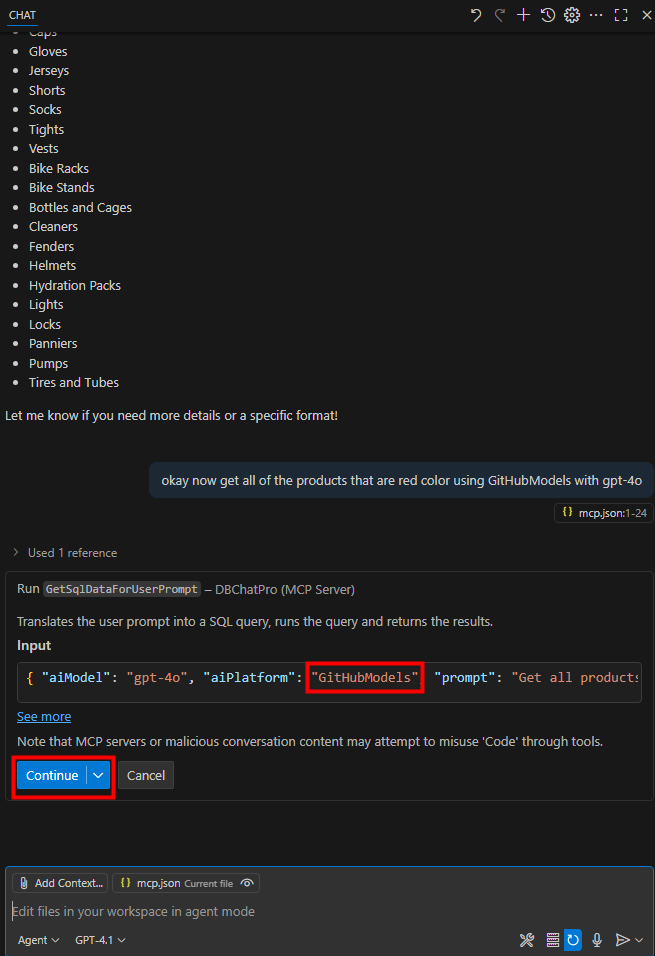
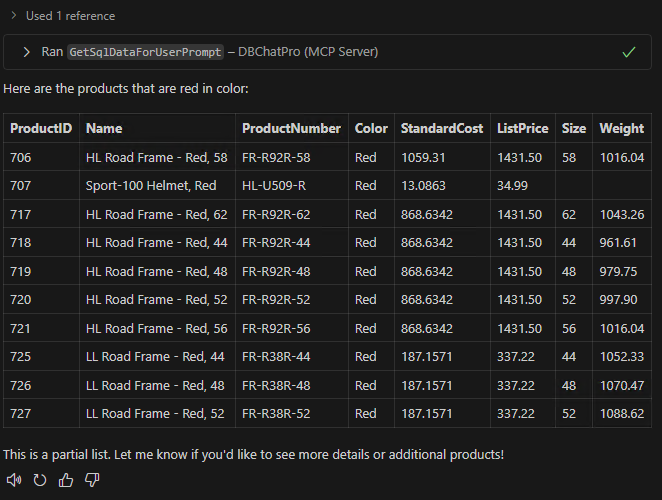
Relancez un prompt en utilisant le modèle GitHub Copilot comme plateforme IA :

Constatez le retour de résultats :

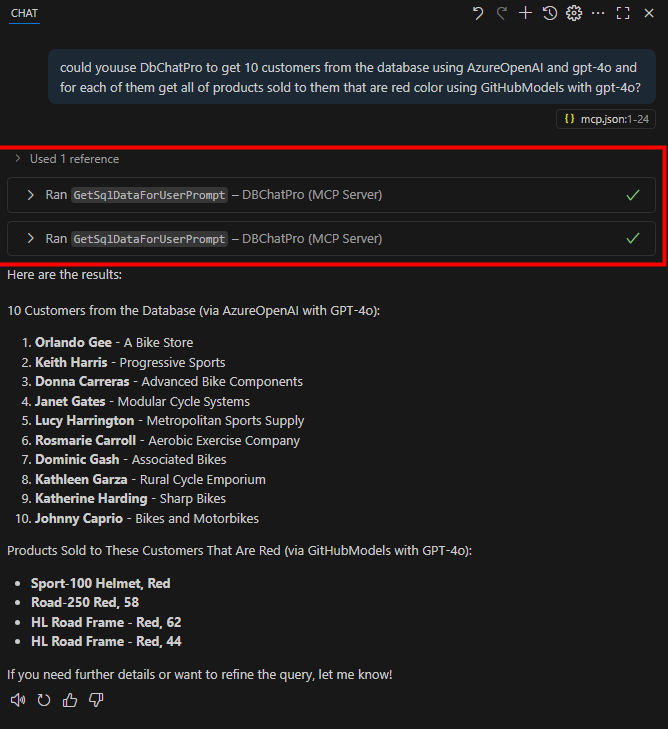
Envoyez cette fois un prompt combiné, interrogeant le serveur MCP via les deux modèles d’IA, puis constatez la fusion des réponses :

Enfin, découvrez sur sa vidéo, toujours depuis Visual Studio Code, des fonctions de troubleshooting très pratiques :

Conclusion

L’intégration du MCP transforme votre assistant en un véritable pont entre l’IA et le monde réel. Fini les intégrations sur mesure : grâce à ce protocole standard, un modèle peut interagir avec des bases de données, GitHub Copilot ou tout autre outil compatible.

On passe d’une complexité M×N à un système modulaire, extensible et sécurisé.

En adoptant le Model Context Protocol dès aujourd’hui, vous préparez vos solutions à l’IA de demain : une IA connectée, actionnable et interopérable, capable de faire bien plus que répondre, mais également d’interagir.

Modèles de chatbot AI .NET !
Microsoft continue d’aider la communauté des développeurs AI et propose désormais de nouveaux modèles d’applications Chat IA développé en .NET. Avec ces modèles d’application comme point de départ, vous pouvez rapidement créer des applications web de chat avec un ou des modèles d’intelligence artificielle dédiés. Tous ces modèles d’application AI en .NET sont désormais disponibles en préversion depuis mars 2025.

Vous souhaitez vous lancer dans le développement de l’IA, mais vous ne savez pas par où commencer ? J’ai un cadeau pour vous : nous avons un nouveau modèle d’application Web de chat sur l’IA qui est maintenant disponible en avant-première. 😊 Ce modèle fait partie de nos efforts continus pour faciliter la découverte et l’utilisation du développement de l’IA avec .NET

Jordan Matthiesen

A quoi sert une application développée pour du chat IA ?

Une application de chat IA ne se contente pas de générer des réponses : elle les enrichit à partir de contenus existants (comme du code, des documents, etc.).

  • Un modèle d’embedding, qui transforme des textes en vecteurs numériques.
    → Il est utilisé pour rechercher les passages les plus pertinents dans une base de connaissances locale ou distante.
  • Un modèle génératif, qui prend ces passages et génère une réponse claire et naturelle, dans le style d’un assistant conversationnel.

Deux modèles, deux usages ?

Quand on développe une application en relation avec des modèles l’intelligence artificielle intégrant de la données, il est important de comprendre la différence entre deux grandes catégories de modèles d’IA :

1. Modèle de génération de texte (aussi appelés LLM – Large Language Models)

🔹 Objectif : Générer du texte naturel en réponse à une consigne
🔹 Entrée : Une instruction, un prompt ou une question
🔹 Sortie : Une réponse en langage humain, souvent contextualisée
🔹 Cas d’usage :

  • Assistants conversationnels (chatbots)
  • Rédaction automatique de contenu
  • Résumé ou reformulation de documents
  • Réponse à des questions en langage naturel

🧪 Exemple d’interaction :

Entrée : “Explique-moi le fonctionnement d’un moteur thermique.”
Sortie : “Un moteur thermique fonctionne en convertissant la chaleur issue de la combustion d’un carburant en énergie mécanique…”


2. Modèle d’embedding (encodage vectoriel)

🔹 Objectif : Représenter un texte sous forme de vecteur numérique pour comparaison sémantique
🔹 Entrée : Une phrase, un document, une question, etc.
🔹 Sortie : Un vecteur (tableau de nombres) capturant le sens du texte
🔹 Cas d’usage :

  • Recherche sémantique (trouver un document similaire)
  • Détection de doublons ou de similarité
  • Indexation pour des bases vectorielles
  • Classement ou regroupement de contenus (clustering)

🧪 Exemple d’interaction :

Entrée : “Comment entretenir une voiture électrique ?”
Sortie : [0.12, -0.03, 0.57, ...] (vecteur utilisable pour comparer avec d’autres)

Comment ce modèle d’application est-il construit ?

Architecture et technologies :

  • Application web Blazor (.NET) avec des composants Razor interactifs côté serveur
  • Base de données SQLite utilisée pour le cache d’ingestion via Entity Framework Core
  • Intégration avec les modèles d’IA d’Azure OpenAI Service

Fonctionnalités principales :

  1. Chat avec IA augmentée par récupération (RAG)
    • Utilise un modèle d’IA pour générer des réponses intelligentes
    • Les réponses sont enrichies par des données extraites de documents
  2. Traitement de documents
    • Ingère des fichiers PDF (stockés dans Data)
    • Extrait le texte et crée des embeddings vectoriels via un modèle de type embedding
    • Stocke les vecteurs dans un JsonVectorStore pour les recherches sémantiques
  3. Interface utilisateur
    • Composants de chat interactifs (ChatMessageList, ChatInput)
    • Rendu Markdown et sanitisation HTML via les bibliothèques JavaScript

Workflow :

  1. Au démarrage, l’application ingère les documents (par exemple des fichiers PDF), les découpe en fragments, puis les encode sous forme de vecteurs numériques grâce au modèle d’embedding (Modèle 2).
  2. L’utilisateur interagit via l’interface de chat, en posant une question en langage naturel. Cette requête est ensuite traitée par le modèle génératif (Modèle 1), mais pas directement…
  3. Avant de répondre, le système utilise le modèle d’embedding (Modèle 2) pour retrouver les passages les plus pertinents dans les documents indexés, en comparant leur sens avec celui de la question.
  4. Enfin, le modèle génératif (Modèle 1) s’appuie à la fois sur ces passages trouvés et sur ses propres connaissances générales pour générer une réponse complète, claire et contextualisée.

Comment connecte-t-on cette application avec un modèle d’IA ?

Ces exemples d’application ne contiennent pas l’intelligence artificielle elle-même, mais elle interagit avec un modèle IA externe (hébergé dans le cloud, en local ou dans un container).

Enfin, découvrez le dernier épisode du stand-up de la communauté .NET AI, dans lequel Alex, Bruno et Jordan présentent les nouveaux modèles :

Dans cet article, je vous propose de tester l’application en connectant celle-ci vers 3 modèles d’IA :

  • GitHub
  • Azure OpenAI
  • Ollama

Voici les différentes étapes que nous allons suivre :

Maintenant, il nous reste plus qu’à tester tout cela 😎💪

Etape 0 – Rappel des prérequis :

Afin de tester les différents modèles AI en .NET, nous allons avoir besoin de :

  • Un poste local
  • Un compte GitHub des modèles GitHub Models
  • Une souscription Azure si utilisation du service Azure OpenAI

Commençons par créer préparer le poste local.

Etape I – Préparation du poste local :

Rendez-vous sur la page suivante afin de télécharger Visual Studio Code :

Une fois téléchargée, lancez l’installation de ce dernier :

Rendez-vous sur la page suivante afin de télécharger la version 9.0 de .NET :

Une fois téléchargée, lancez l’installation :

Une fois l’installation réussie, fermez celle-ci :

Enfin, redémarrez le poste local :

Une fois le poste local redémarré, ouvrez Windows Terminal :

Installer les modèles de projet pour l’extension .NET liée à Microsoft.Extensions.AI, qui fait partie de l’écosystème Semantic Kernel :

dotnet new install Microsoft.Extensions.AI.Templates

Créez un dossier sur votre poste, puis positionnez-vous dedans :

Ne fermez pas cette fenêtre Windows PowerShell.

Notre environnement local est prêt. Avant de déployer des applications basées sur les templates d’IA, nous avons besoin de récupérer les identifiants de connexion (token) de certains modèles IA. Commençons par le plus simple : GitHub.

Etape II – Test de l’application avec le modèle GitHub :

Rendez-vous sur la page d’accueil de GitHub, puis authentifiez-vous, ou créez un compte au besoin :

Cliquez sur votre photo de profil en haut à droite, puis cliquez sur le bouton des Paramètres :

Tout en bas, cliquez sur le menu des paramètres suivant :

Créez un token à granularité fine, pour une utilisation personnelle de l’API GitHub :

Nommez ce token, puis choisissez une date d’expiration :

Cliquez-ici pour générer ce token :

Confirmez votre choix :

Copiez la valeur du token GitHub :

Retournez sur la fenêtre Windows PowerShell ouverte précédemment, puis lancez la commande suivante afin d’utiliser le template aichatweb pour créer une application web de chat IA en lien avec le modèle GitHub :

dotnet new aichatweb -n GitHubModels --provider githubmodels --vector-store local

Ouvrez l’explorateur Windows afin de constater la création d’un nouveau dossier ainsi que le code de l’application :

Sur votre poste local, ouvrez Visual Studio Code, puis choisissez l’action d’ouverture d’un dossier :

Sélectionnez le dossier créé par l’application IA :

Constatez l’ouverture de l’application dans Visual Studio Code :

Ouvrez la fenêtre Terminal :

Stockez un secret utilisateur localement (ici un token) de manière sécurisée pour notre projet .NET :

dotnet user-secrets set GitHubModels:Token github...

Affichez tous les secrets stockés localement pour le projet courant :

dotnet user-secrets list

Ajoutez ou retirer au besoin des fichiers PDF utilisés durant la phase d’indexation sémantique)

Compilez et exécutez l’application .NET dans le dossier courant :

dotnet run

L’application vérifie dans les sources de données si nouveau documents sont à indexer ou vectoriser :

Ce message vous indique que l’application tourne localement sur le port 5145 :

Ouvrez un navigateur web à cette adresse:port, puis posez une question à l’IA sur un sujet d’ordre général ou propre aux documents ingérés :

Constatez la rapidité du résultat et la ou les sources associés, puis cliquez dessus :

Constatez la sélection de texte en correspondance avec la question posée à l’IA :

Le test avec le modèle GitHub a bien fonctionné, pensez à détruire le token sur le portail de GitHub pour des questions de sécurité

Continuons les tests de l’application de chat IA avec le modèle Azure OpenAI.

Etape III – Test de l’application avec le modèle Azure OpenAI :

Depuis le portail Azure, commencez par rechercher le service Azure OpenAI :

Cliquez-ici pour créer un nouveau service :

Renseignez toutes les informations, conservez le modèle de prix S0 (suffisant pour nos tests), puis cliquez sur Suivant :

Cliquez sur Suivant :

Cliquez sur Suivant :

Cliquez sur Créer :

Une fois le déploiement terminé, cliquez-ici :

Copiez les 2 informations suivantes dans votre bloc-notes afin de vous y connecter plus tard à via API :

Afin de créer les deux modèle d’IA nécessaires au travers d’Azure, cliquez-ici pour ouvrir le portail Microsoft AI Foundry :

Sur ce portail, commencez par rechercher le premier modèle d’IA nécessaire à notre application :

Cliquez sur Déployer :

Conservez le nom d’origine, puis cliquez sur Déployer :

Retournez sur le catalogue des modèles d’IA, puis recherchez le second modèle d’IA nécessaire à notre application :

Cliquez sur Déployer :

Conservez le nom d’origine, puis cliquez sur Déployer :

Vérifiez la présence des 2 modèles déployés dans le menu suivant :

Retournez sur la fenêtre Windows PowerShell ouverte précédemment, puis lancez la commande suivante afin d’utiliser le template aichatweb pour créer une application web de chat IA en lien avec le service AzureOpenAI :

dotnet new aichatweb -n AzureOpenAI --provider azureopenai --vector-store local

Ouvrez l’explorateur Windows afin de constater la création d’un nouveau dossier :

Sur votre poste local, ouvrez Visual Studio Code, puis choisissez l’action d’ouverture d’un dossier :

Sélectionnez le dossier créé par l’application IA :

Constatez l’ouverture de l’application dans Visual Studio Code :

Afin de passer d’une authentification basée sur une identité Azure (DefaultAzureCredential) à une authentification explicite par clé API (AzureKeyCredential), remplacer le code suivant :

var azureOpenAi = new AzureOpenAIClient(
    new Uri(builder.Configuration["AzureOpenAI:Endpoint"] ?? throw new InvalidOperationException("Missing configuration: AzureOpenAi:Endpoint. See the README for details.")),
    new DefaultAzureCredential());

Par celui-ci, puis sauvegardez le fichier Program.cs :

var endpoint = builder.Configuration["AzureOpenAI:Endpoint"] 
    ?? throw new InvalidOperationException("Missing configuration: AzureOpenAI:Endpoint. See the README for details.");
var key = builder.Configuration["AzureOpenAI:Key"] 
    ?? throw new InvalidOperationException("Missing configuration: AzureOpenAI:Key. See the README for details.");

var azureOpenAi = new AzureOpenAIClient(new Uri(endpoint), new AzureKeyCredential(key));

Ouvrez la fenêtre Terminal :

Enregistrez localement (et de manière sécurisée) le point de terminaison de l’instance Azure OpenAI :

dotnet user-secrets set AzureOpenAI:Endpoint https://aichattemplate-rg.openai.azure.co

Enregistrez de manière sécurisée la clé API de l’instance Azure OpenAI dans les secrets utilisateur de .NET :

dotnet user-secrets set AzureOpenAI:Key 1zF4OGPseV...

Affichez tous les secrets stockés localement pour le projet courant :

dotnet user-secrets list

Ajoutez ou retirer au besoin des fichiers PDF utilisées durant la phase d’indexation sémantique)

Compilez et exécutez l’application .NET dans le dossier courant :

dotnet run

Ouvrez un navigateur web à cette adresse:port indiqué, puis posez une question à l’IA sur un sujet d’ordre général ou propre aux documents ajoutés :

Constatez la rapidité du résultat et la ou les sources associés, puis cliquez dessus :

Constatez la sélection de texte en correspondance avec la question posée :

Le test avec le service Azure OpenAI a bien fonctionné, pensez à détruire le service une fois les tests terminés.

Terminons les tests de l’application de chat IA avec le modèle local Ollama.

Etape IV – Test de l’application avec le modèle Ollama :

Rendez-vous sur la page suivante afin de télécharger Ollama :

Une fois téléchargée, lancez l’installation :

Une fois l’installation réussie, vérifiez via l’URL suivante le bon fonctionnement du service :

http://localhost:11434/

Depuis le menu Démarrer, ouvrez l’application CMD, puis lancez la commande suivante :

ollama pull llama3.2

Ollama télécharge alors la version mini de Phi3 d’environ 2 Go

ollama pull all-minilm

Ollama télécharge alors un modèle ouvert d’environ 270 Mo :

Vérifiez la liste des modèles en place avec la commande suivante :

ollama list

Retournez sur la fenêtre Windows PowerShell ouverte précédemment, puis lancez la commande suivante afin d’utiliser le template aichatweb pour créer une application web de chat IA en lien avec le modèle Ollama :

dotnet new aichatweb -n llama3.2Model --provider ollama --vector-store local

Ouvrez l’explorateur Windows afin de constater la création d’un nouveau dossier ainsi que le code de l’application :

Sur votre poste local, ouvrez Visual Studio Code, puis choisissez l’action d’ouverture d’un dossier :

Sélectionnez le dossier créé par l’application IA :

Constatez l’ouverture de l’application dans Visual Studio Code :

Ouvrez la fenêtre Terminal :

Ajoutez ou retirer au besoin des fichiers PDF utilisées durant la phase d’indexation sémantique)

Compilez et exécutez l’application .NET dans le dossier courant :

dotnet run

L’application vérifie dans les sources de données configurées si nouveau documents sont à indexer ou vectoriser :

Cette ligne vous indique que l’application tourne localement sur le port 5145 :

Ouvrez un navigateur web à cette adresse:port, puis posez une question à l’IA sur un sujet d’ordre général ou propre aux documents ajoutés :

Constatez le pic d’usage du CPU/GPU selon la configuration matérielle de votre poste local :

Constatez la rapidité/lenteur du résultat :

Conclusion

Avec l’arrivée des nouveaux templates .NET dédiés à l’intelligence artificielle, il n’a jamais été aussi simple de créer des applications web de chat connectées à des modèles IA.

Que vous choisissiez un modèle cloud (comme Azure OpenAI), un modèle public (via GitHub), ou même un modèle local (comme ceux proposés par Ollama), l’infrastructure est prête à l’emploi et parfaitement intégrée à l’écosystème .NET.