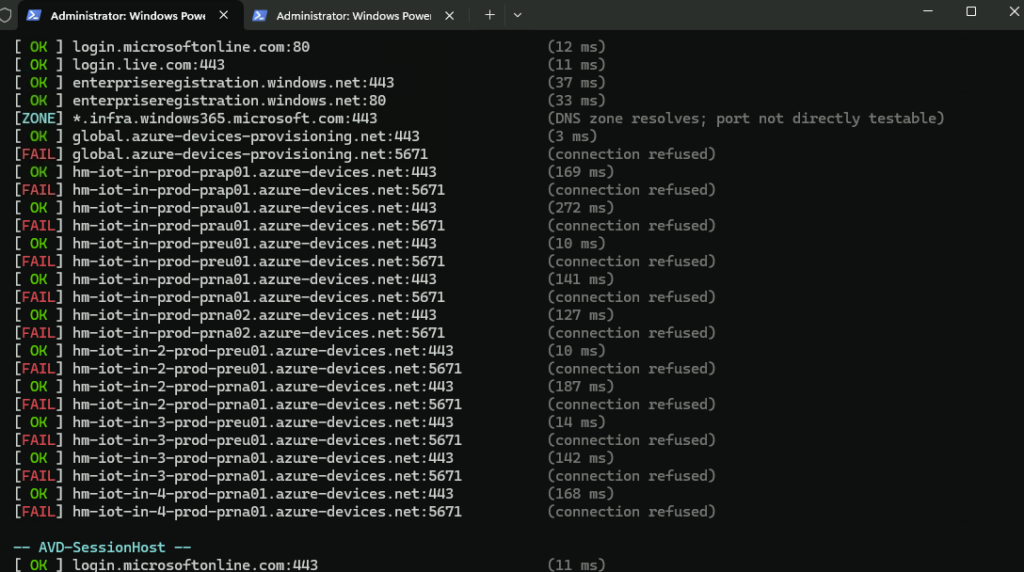
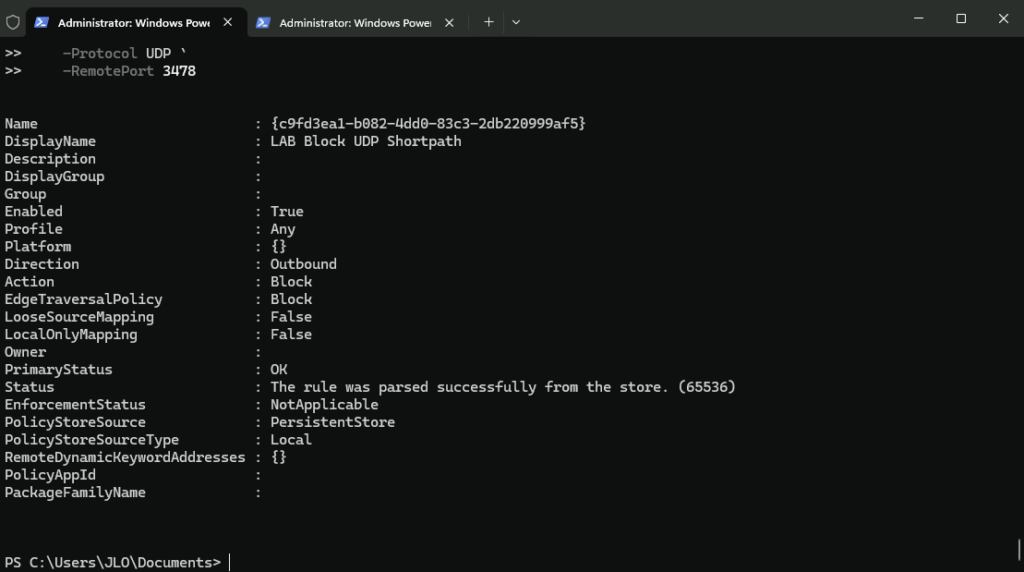
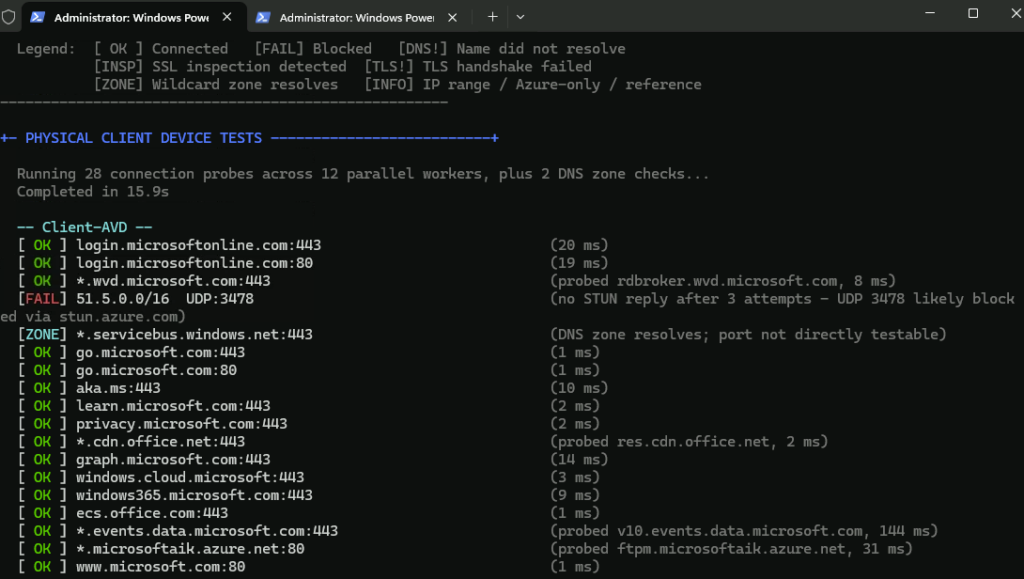
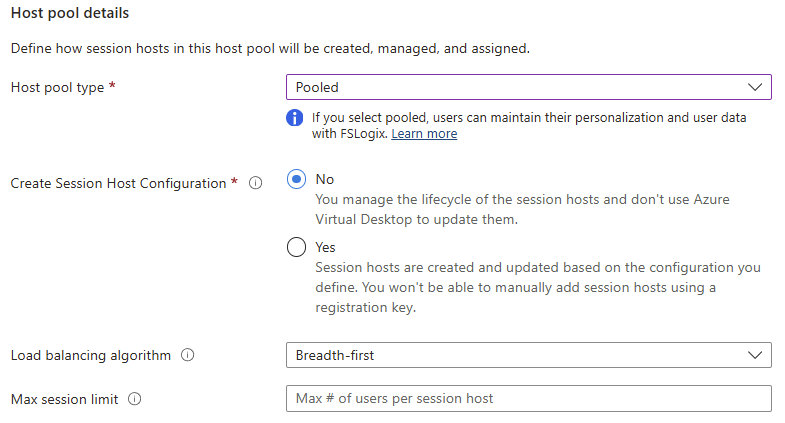
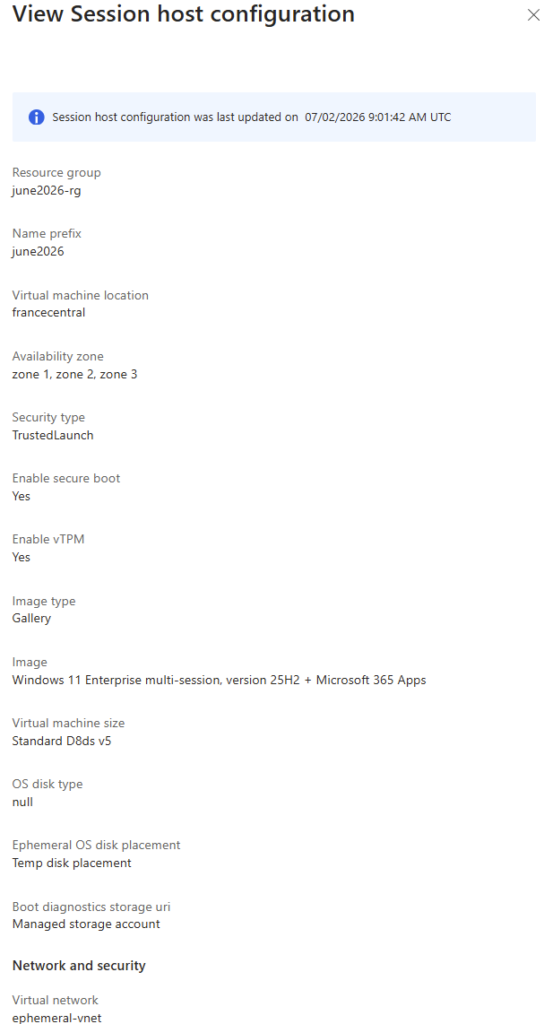
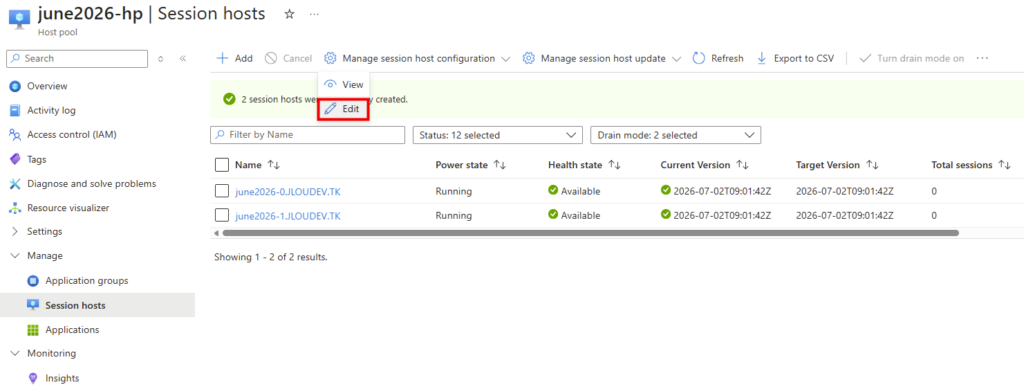
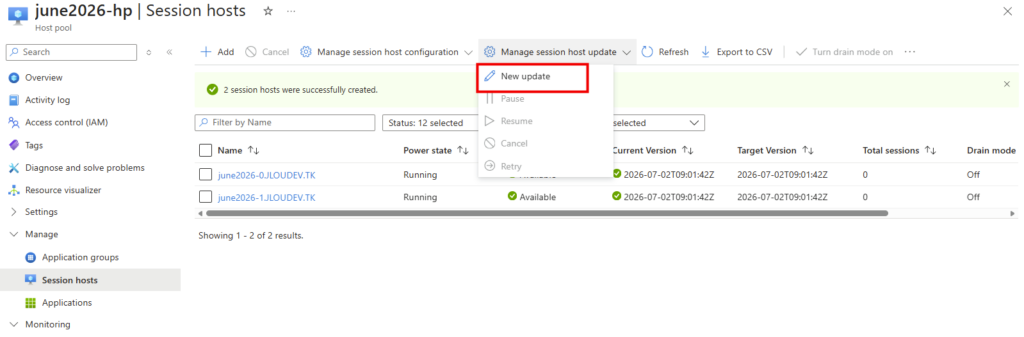
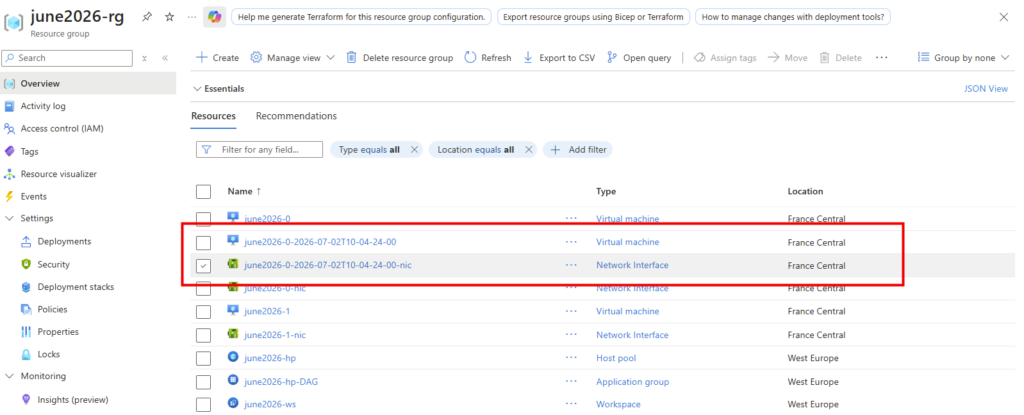
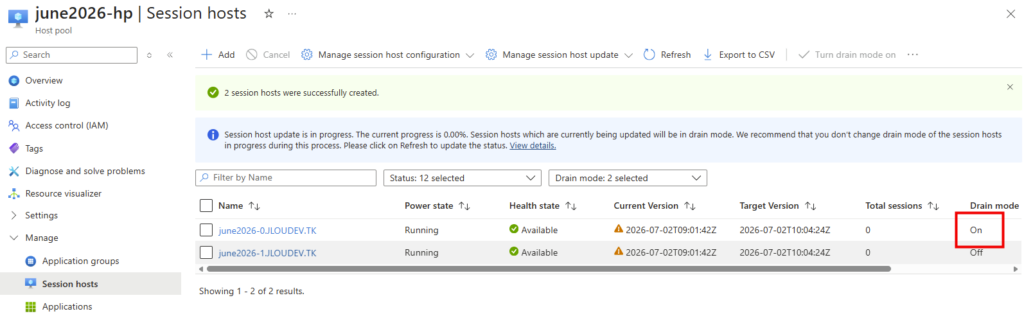
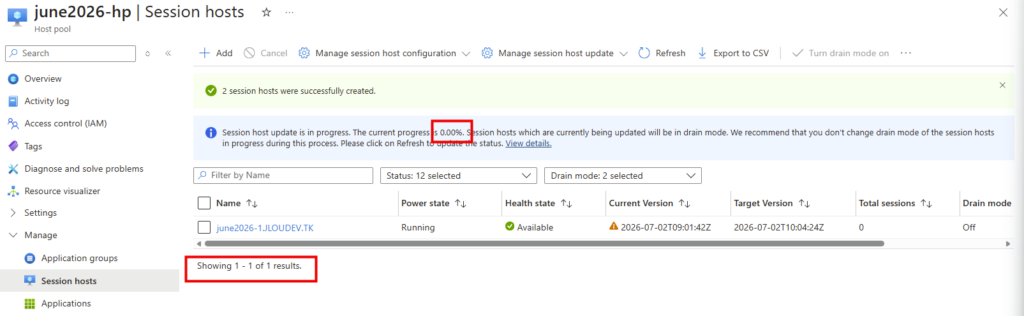
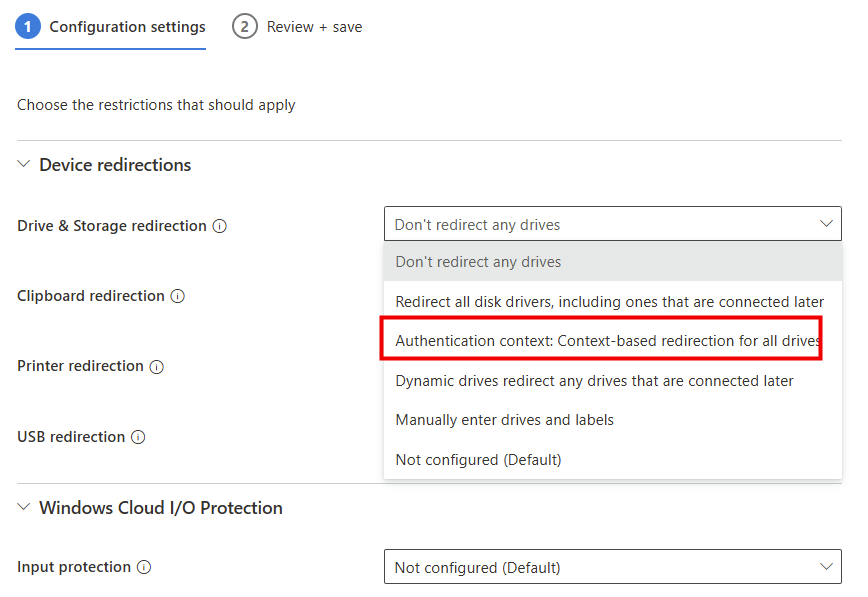
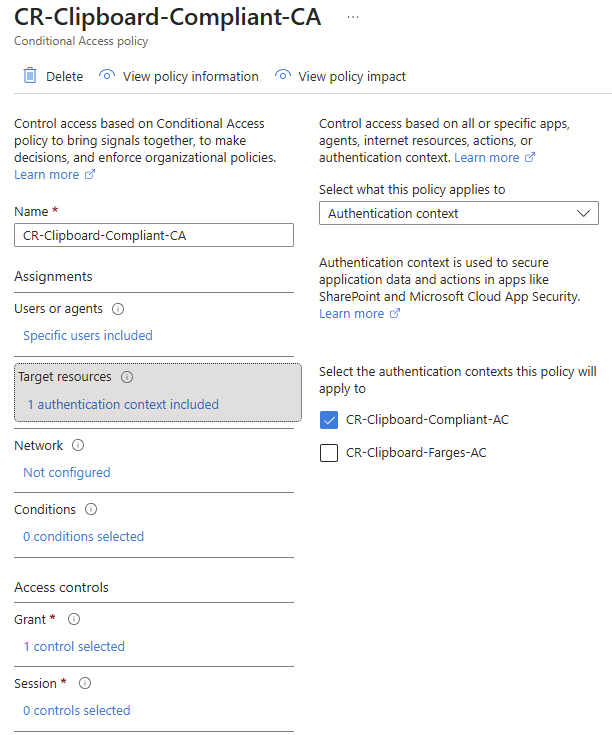
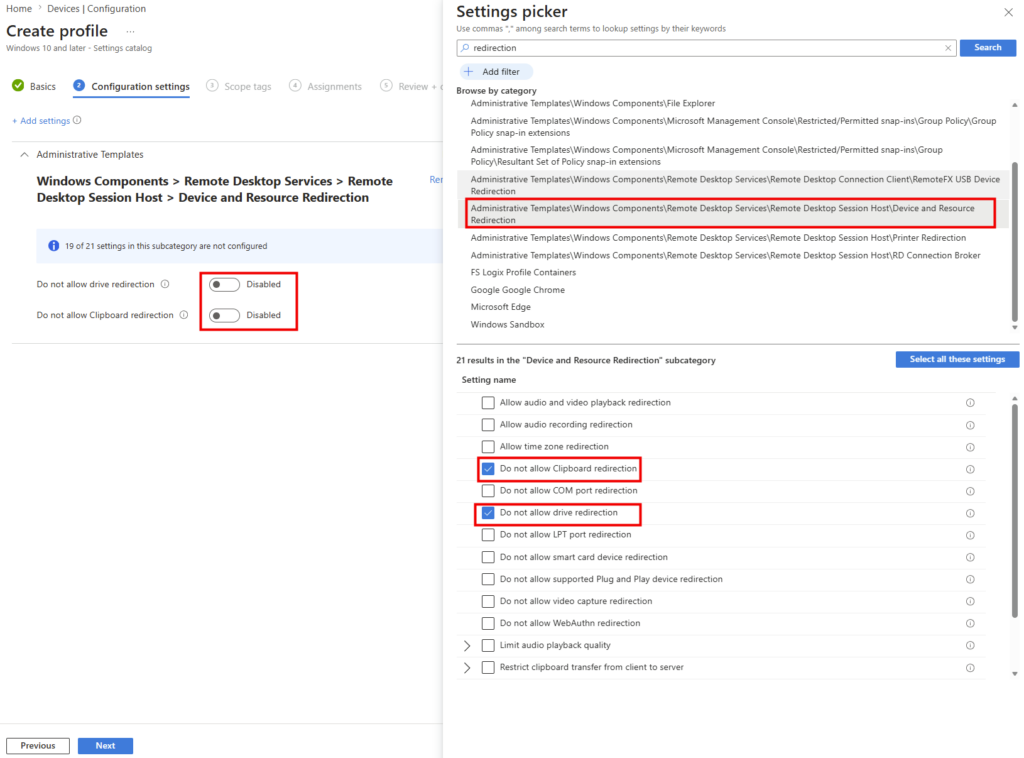
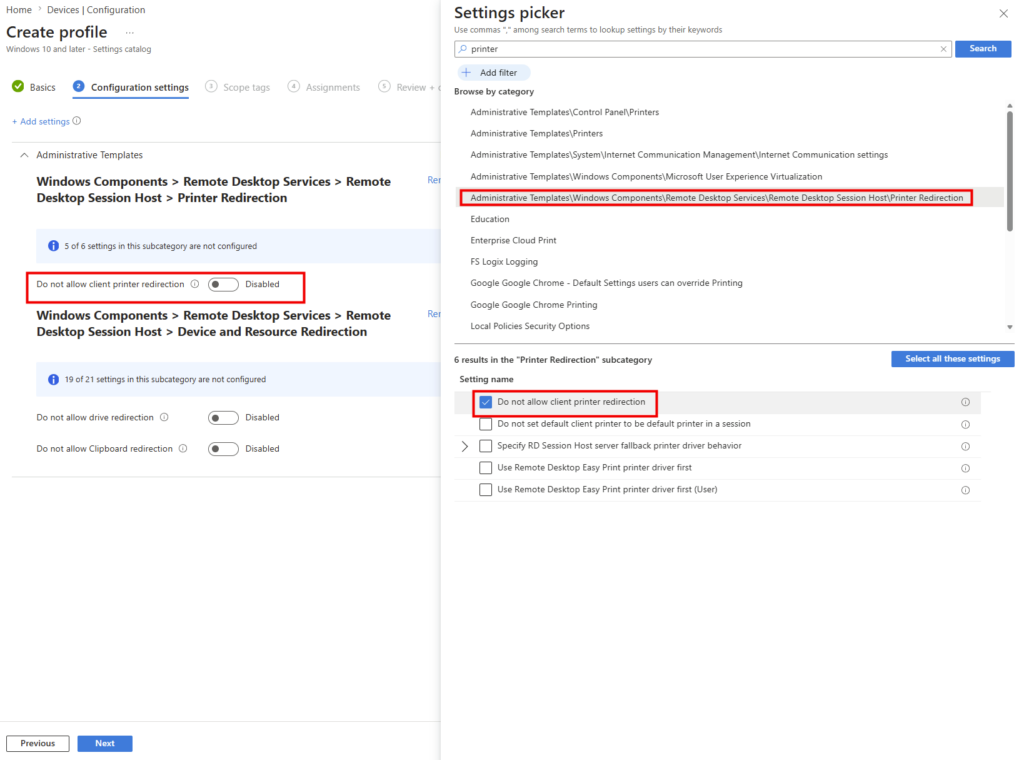
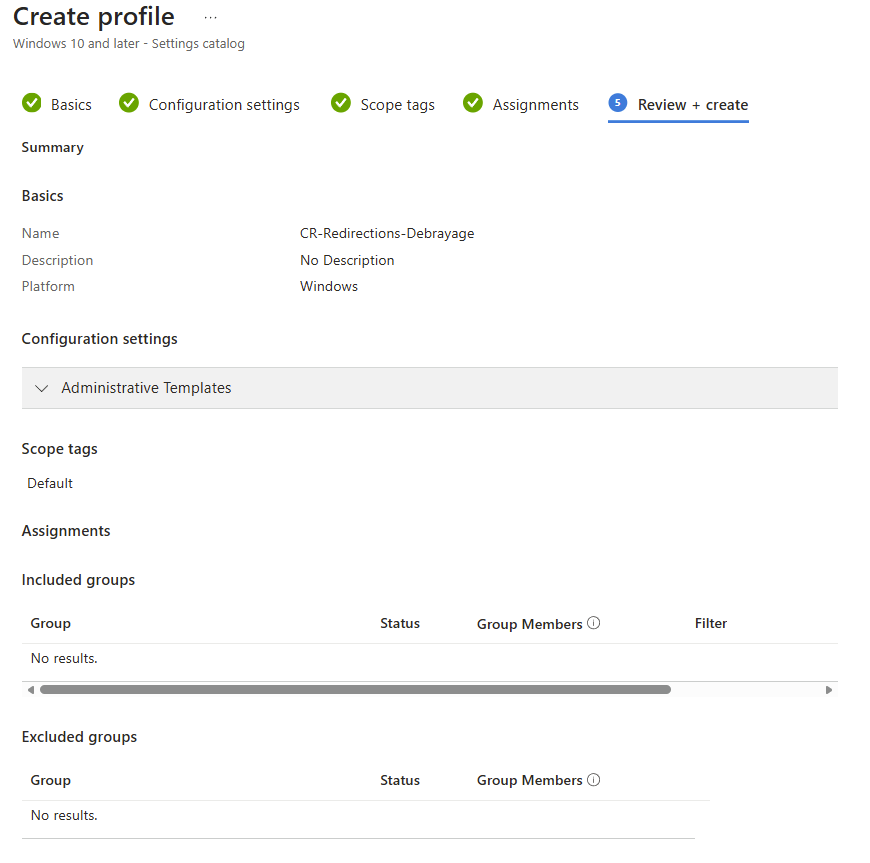
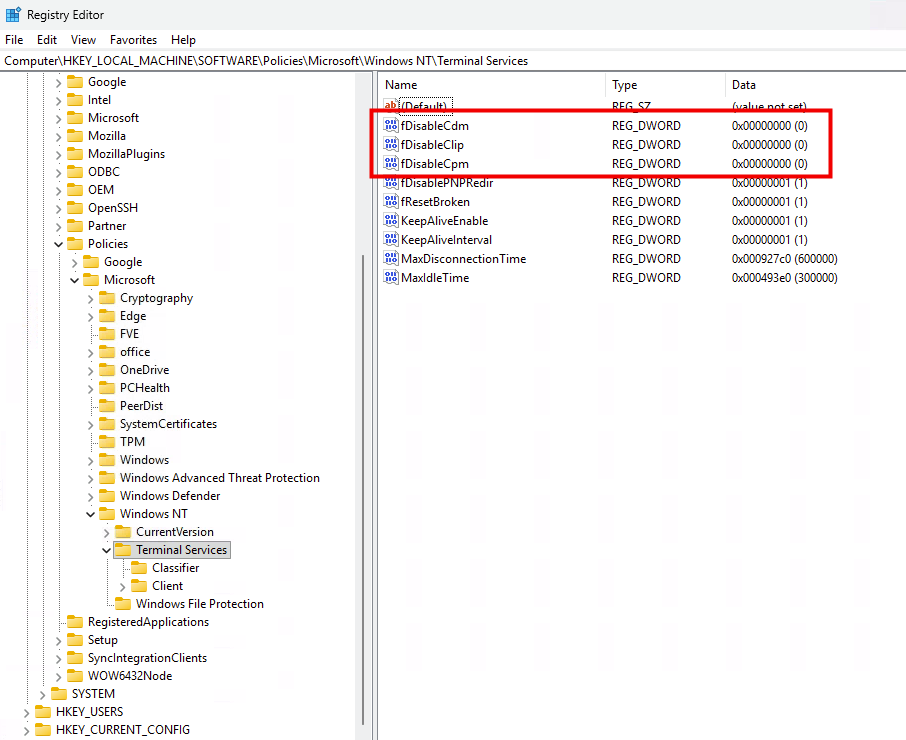
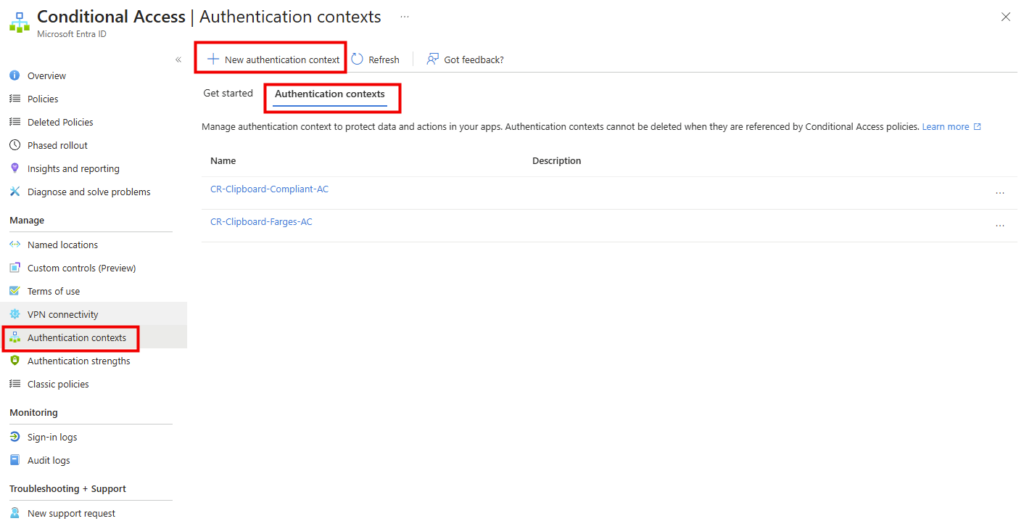
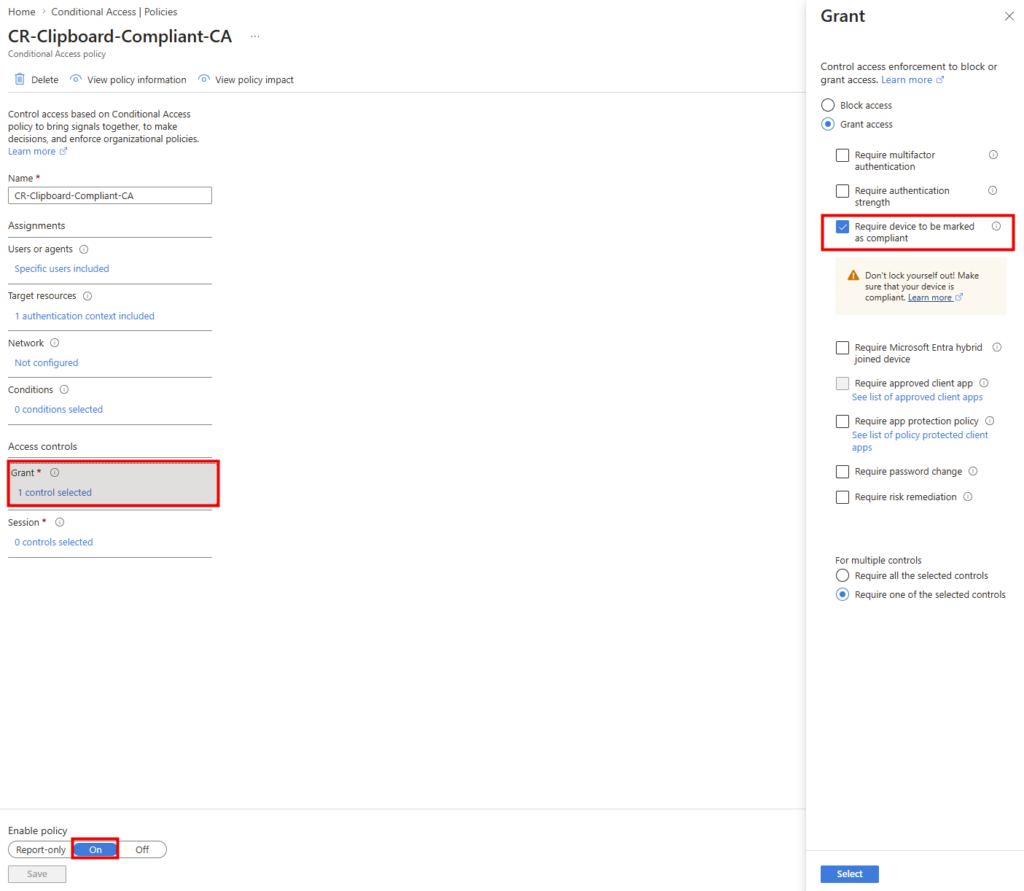
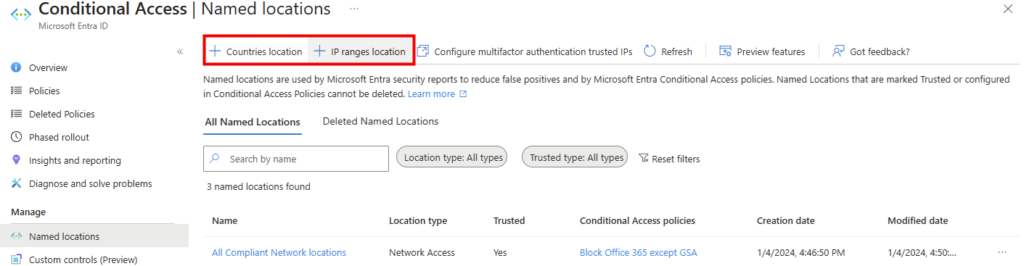
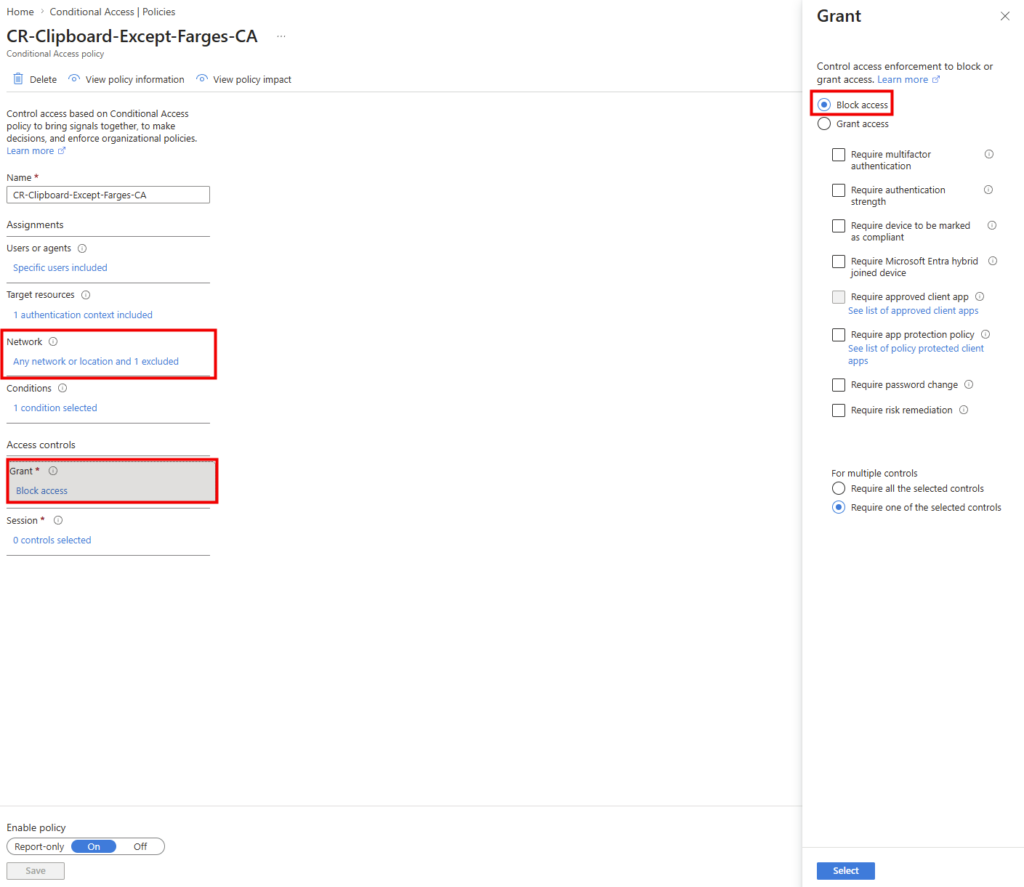
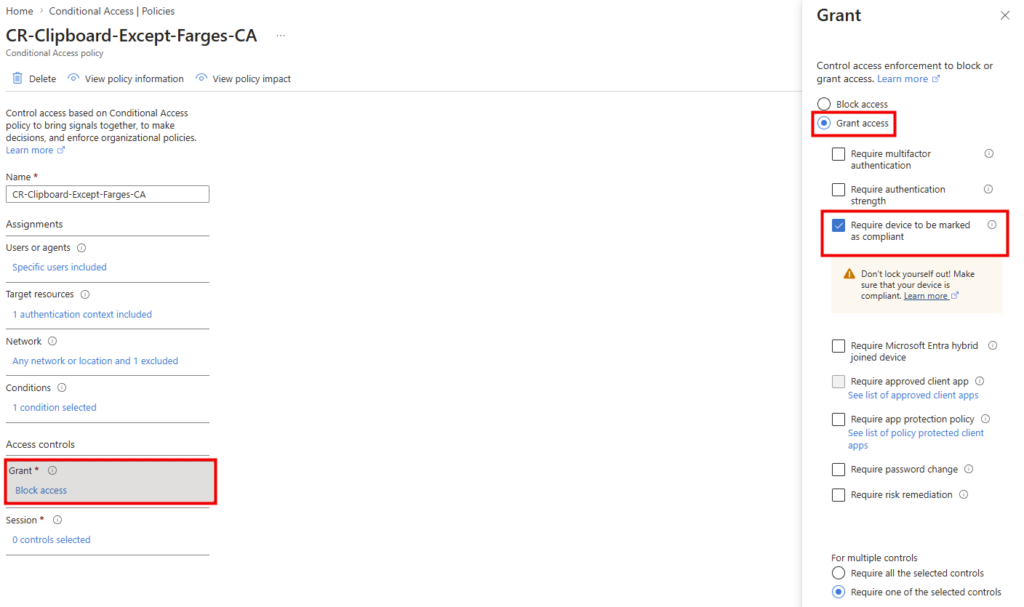
Deux petites actus Microsoft à regarder cette semaine : les connexions Remote PC passent en disponibilité générale dans Windows App sur Windows, et Azure Virtual Desktop fait évoluer ses host pools avec le modèle Regional. On commence par Windows App, puis on passe à AVD, avec quelques manipulations simples pour voir concrètement de quoi il retourne.
Pas besoin de refaire tout votre lab pour découvrir ces évolutions. Pour Windows App, on regarde l’ajout d’un PC et le presse-papier. Pour AVD, on vérifie le nouveau choix de scope sur un pool de test, sans déployer de VM.
Petit article aujourd’hui, donc petit sommaire qui va avec :
Remote PC dans Windows App sur Windows passe en GA : connexions enregistrées et favoris, sans compte professionnel ou scolaire dans l’application, avec authentification sur la cible. C’est l’annonce de Remote PC connections in Windows App on Windows is now generally available, sur Microsoft Tech Community.
L’intérêt est facile à voir : garder sous la main les connexions vers les machines que vous utilisez souvent dans une seule unique application que vous utilisez déjà pour vos accès Windows 365 et Azure Virtual Desktop :
On va commencer par une seule cible, puis regarder un réglage qui mérite toujours un contrôle : le presse-papier.
Ce que cela change pour vos connexions
Le scénario est celui d’une machine que vous connaissez déjà et à laquelle vous avez le droit de vous connecter. Le nom saisi dans Windows App désigne cette cible : ce n’est pas une recherche automatique de tous les PC du réseau.
Préparez donc le nom réel de l’ordinateur, ou son adresse IP, avant de commencer :
Un nom convivial pour la carte vous aidera ensuite à retrouver le lab sans confondre plusieurs machines :
Autre détail important : ne pas ajouter de compte professionnel dans Windows App ne dispense pas de fournir les identifiants acceptés par le PC distant. Pour isoler ce point, vous pouvez utiliser un profil Windows de lab non connecté à votre compte d’entreprise, puis un compte de test autorisé sur la cible. Il n’est pas nécessaire de retirer les comptes de votre poste de travail habituel.
Test n°1 : ajouter un PC et ouvrir une session
Pour cet essai, prévoyez Windows App à jour, un PC Windows 11 Pro ou Windows Serveur avec le Bureau à distance activé, un compte autorisé sur cette machine et un accès réseau de confiance. Conservez NLA et le pare-feu. Les prérequis côté PC sont détaillés dans Enable Remote Desktop on your PC.
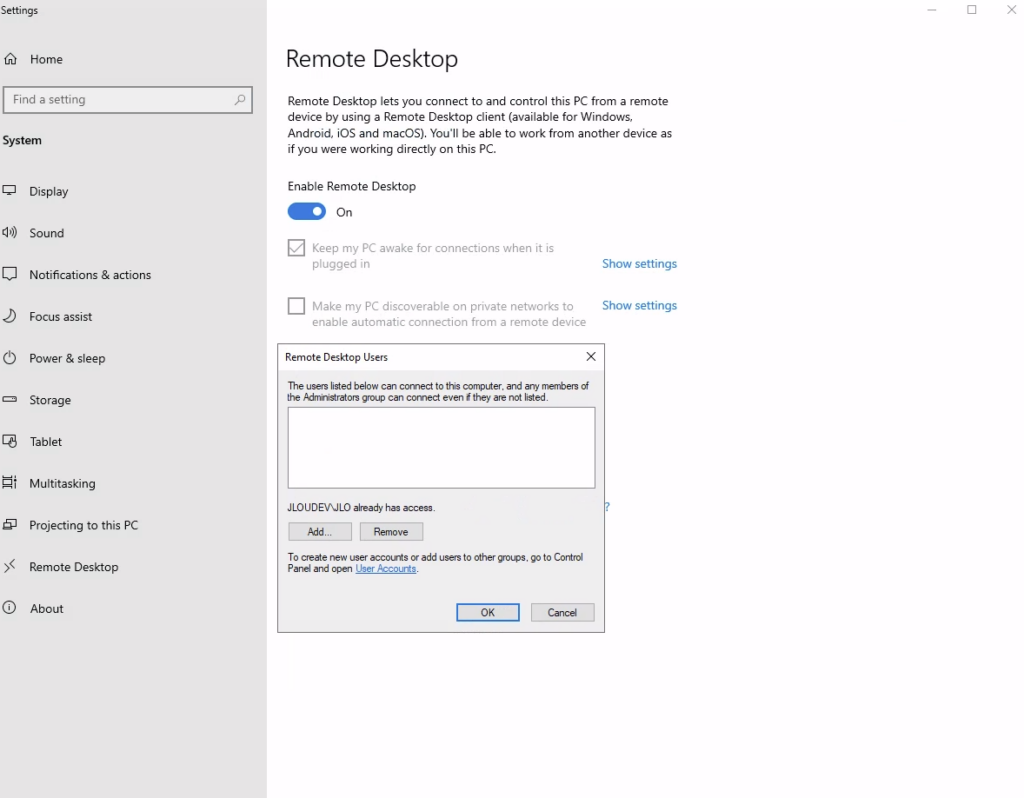
Sur le PC distant, ouvrez Paramètres, puis Système et Bureau à distance. Vérifiez que l’accès est activé et que le compte choisi est autorisé. La machine doit être allumée et joignable.
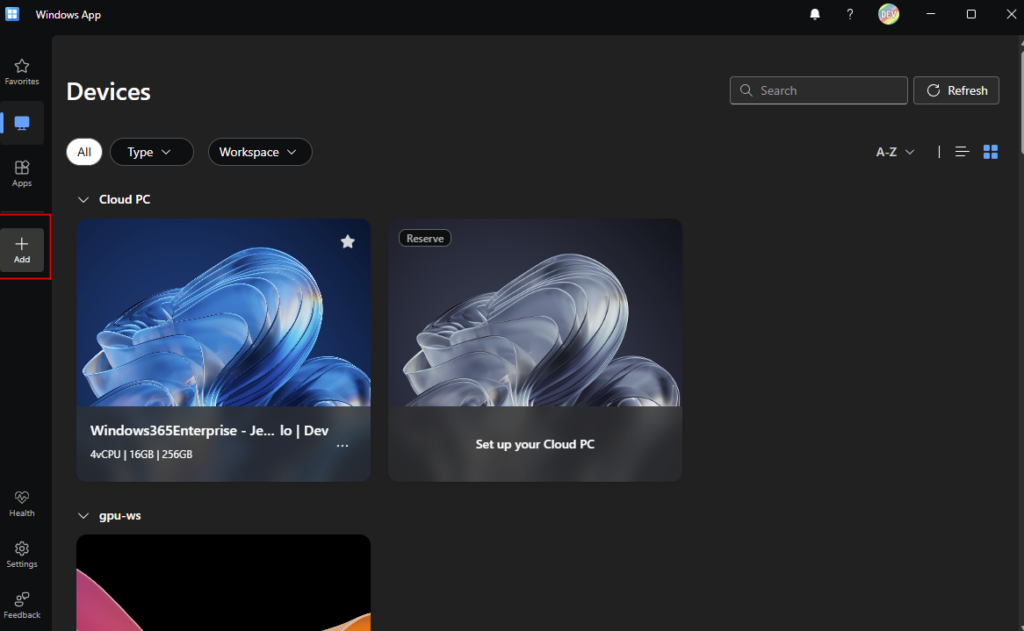
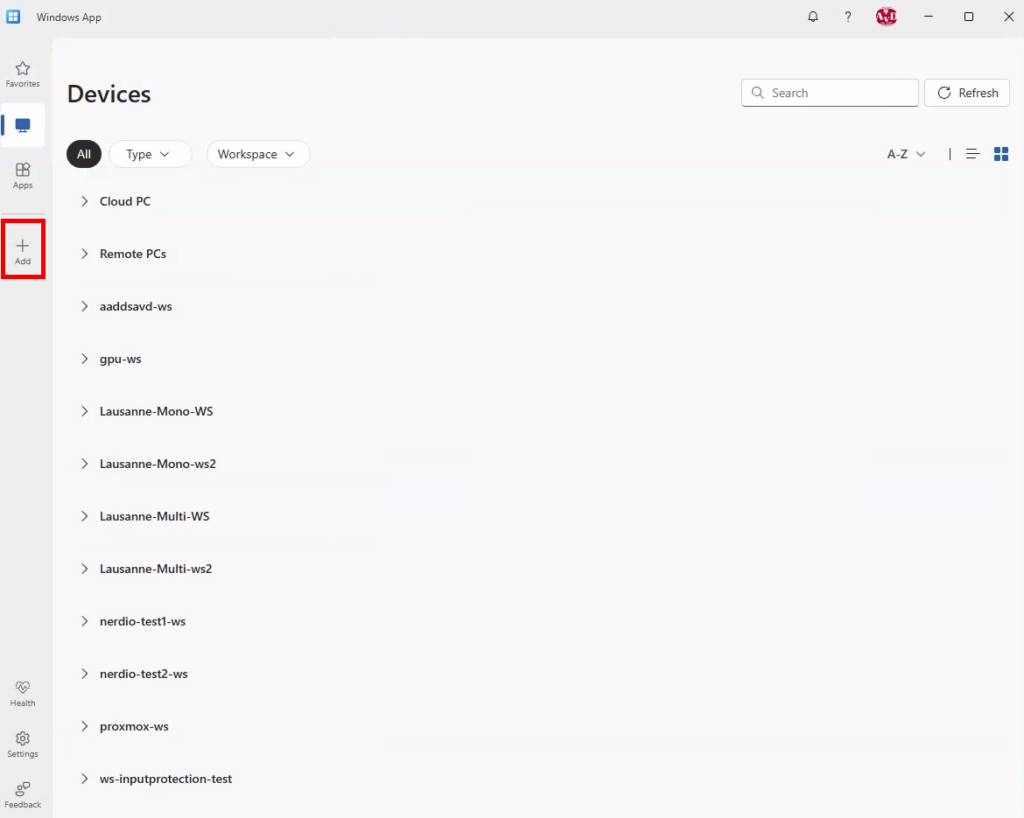
Sur le poste client, ouvrez Windows App à jour et choisissez Add a remote PC, ou le bouton d’ajout si vous êtes déjà dans l’application.
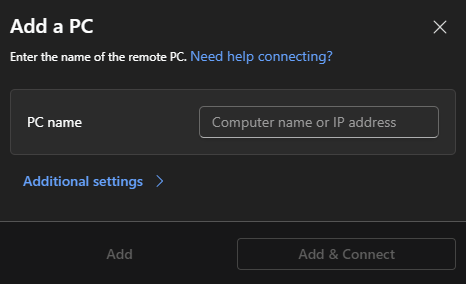
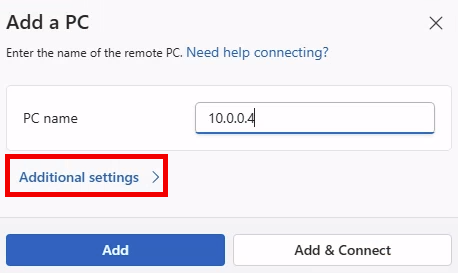
Dans PC Name, saisissez le nom exact ou l’adresse IP de votre PC de lab, puis cliquez ici :
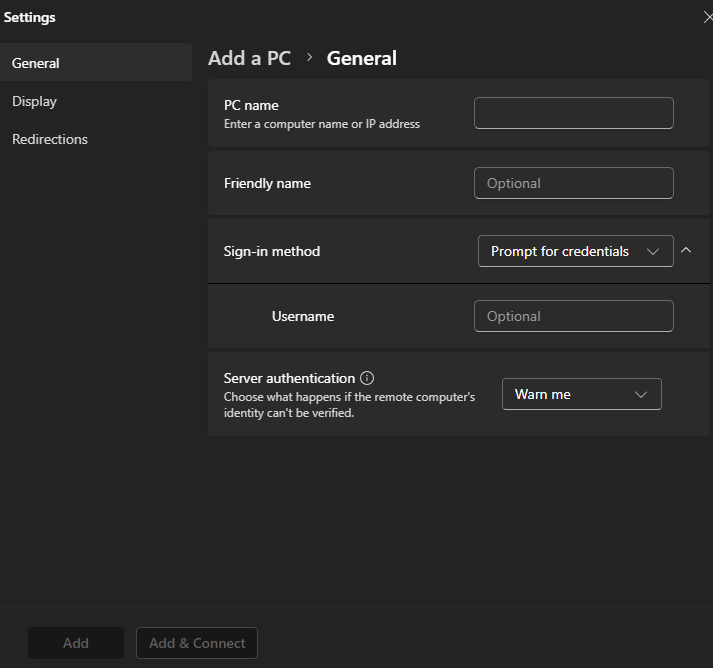
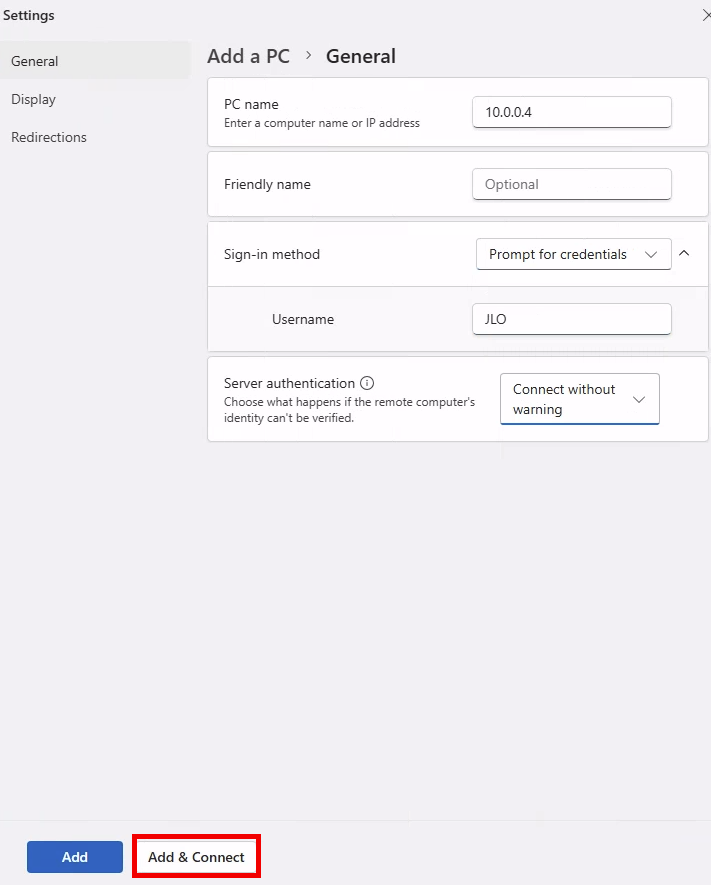
Dans Additional settings, donnez un nom convivial à la carte, par exemple PC de lab. Conservez les autres réglages pour le premier essai et notez leur état.
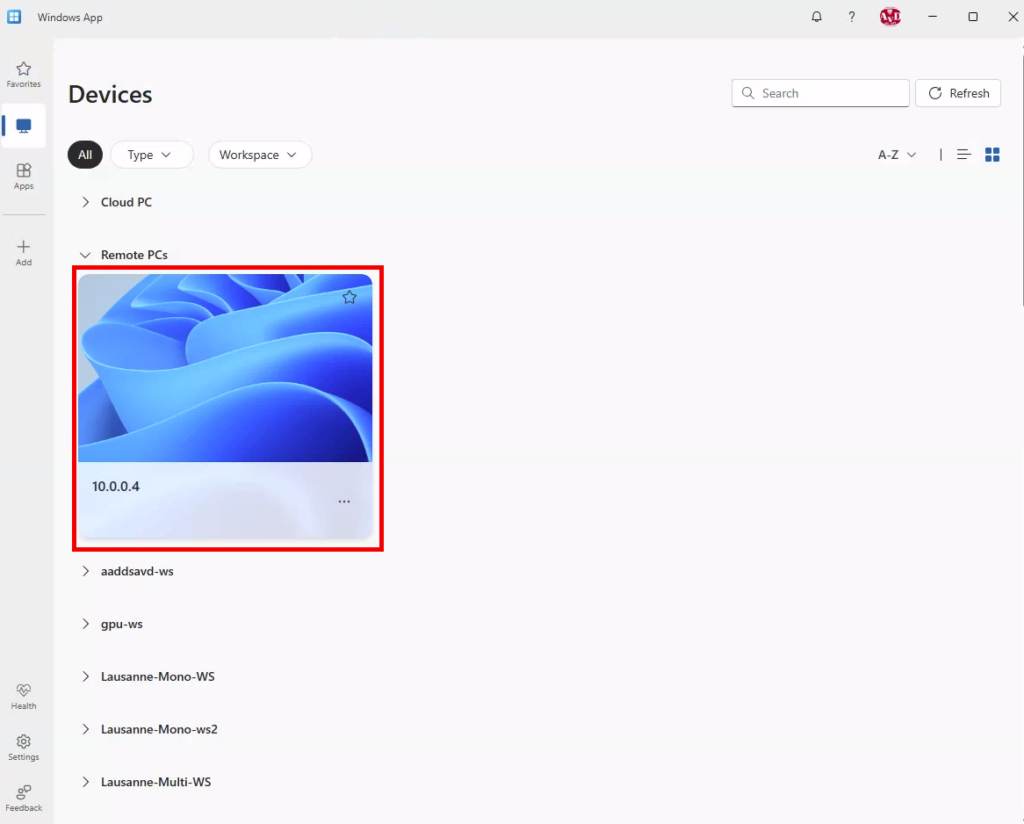
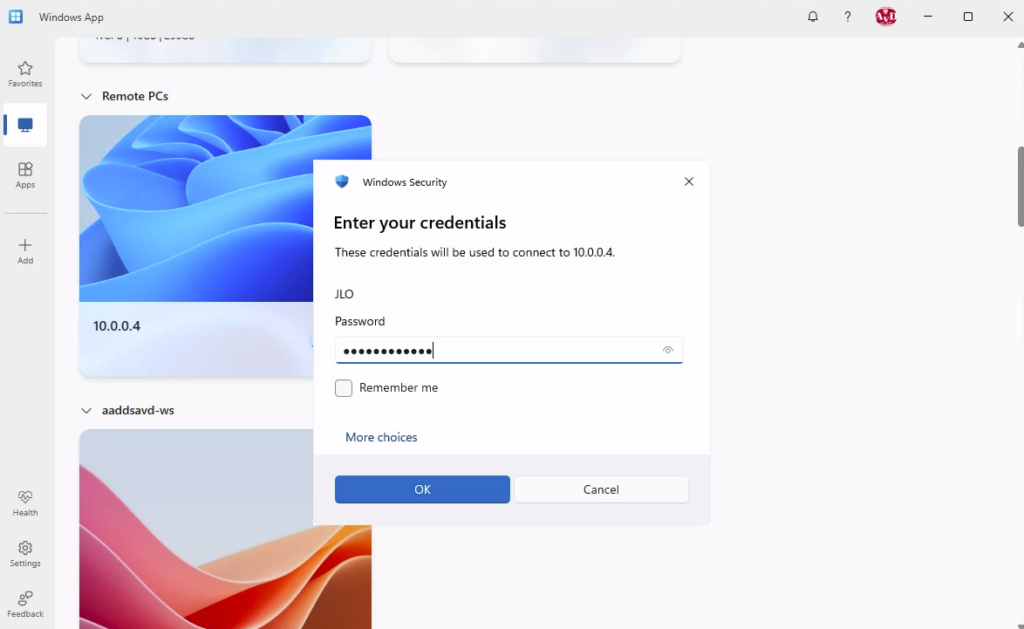
Choisissez Add & Connect, puis authentifiez-vous avec le compte autorisé sur le PC :
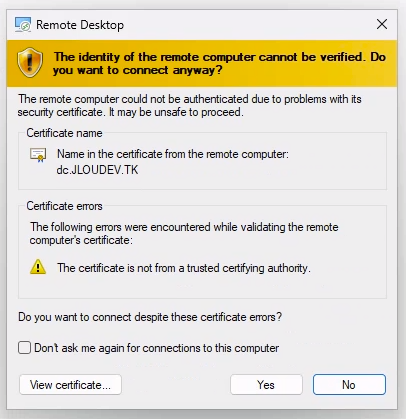
Si une alerte de certificat apparaît, vérifiez la cible et le certificat avant de poursuivre :
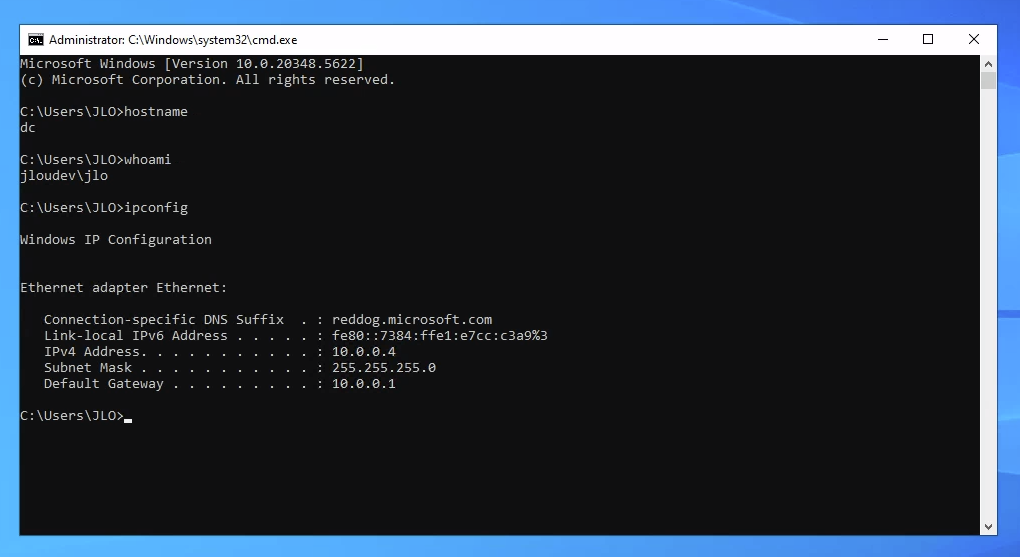
Dans un terminal de la session distante, lancez les commandes ci-dessous. Le nom de machine et l’identité doivent correspondre à ce que vous aviez prévu :
hostname
whoami
ipconfig
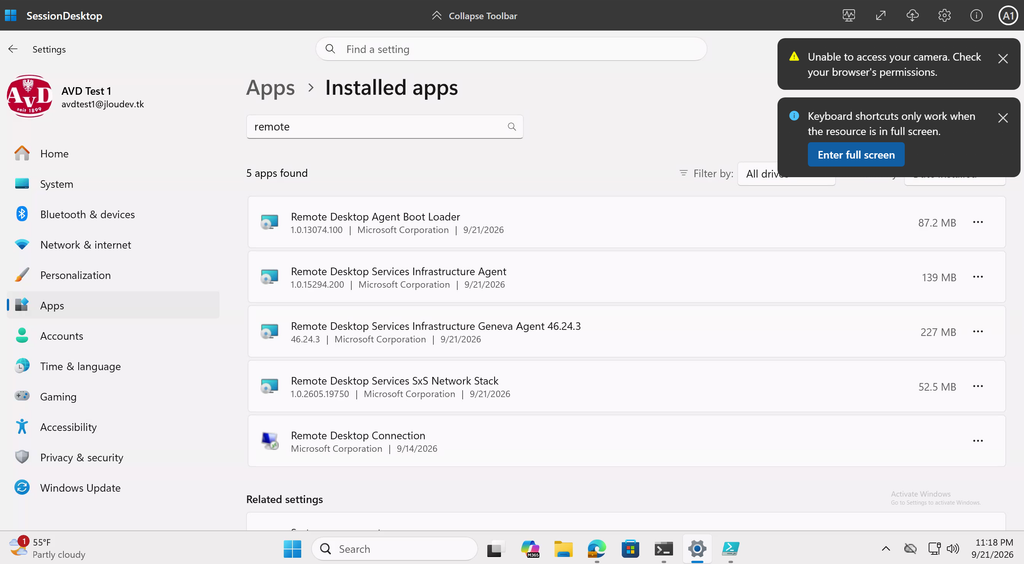
Déconnectez la session, fermez puis rouvrez Windows App et relancez la carte enregistrée. Notez si une nouvelle demande d’identifiants apparaît et si la connexion aboutit :
Ce qu’on cherche à vérifier : la bonne machine, le bon compte, puis une reconnexion depuis l’entrée sauvegardée. Les commandes de l’interface sont décrites dans « Connect to a remote PC », onglet Windows, de Get started with Windows App to connect to devices and apps.
Si la connexion ne s’ouvre pas
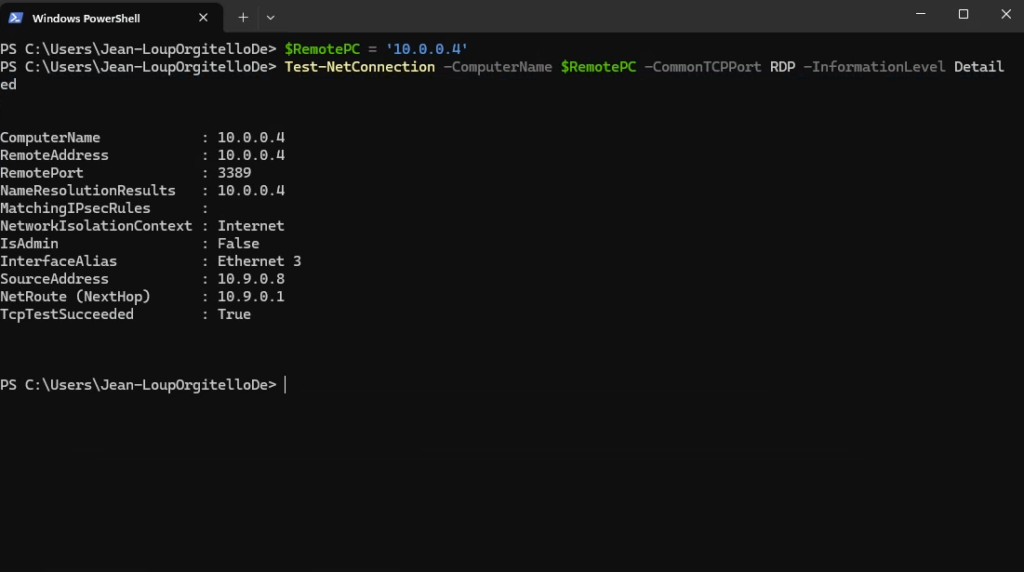
Commencez par vérifier le réseau, sans toucher aux mots de passe ni désactiver les protections. Depuis Windows PowerShell sur le poste client, la commande suivante contrôle le port RDP standard de la machine que vous indiquez. Si votre lab utilise un port personnalisé, remplacez -CommonTCPPort RDP par -Port suivi du port configuré.
$RemotePC = 'Nom ou adresse IP du PC de lab'
Test-NetConnection -ComputerName $RemotePC -CommonTCPPort RDP -InformationLevel Detailed
TcpTestSucceeded : True confirme que le test TCP aboutit. Cela ne prouve pas que vos identifiants sont valides ou que votre compte a le droit d’ouvrir une session. Si le test échoue, vérifiez la cible, son état, le chemin réseau ou le VPN et les règles autorisées. Un échec ne désigne pas automatiquement le pare-feu. La commande est documentée dans Test-NetConnection (NetTCPIP).
Test n°2 : vérifier le copier-coller
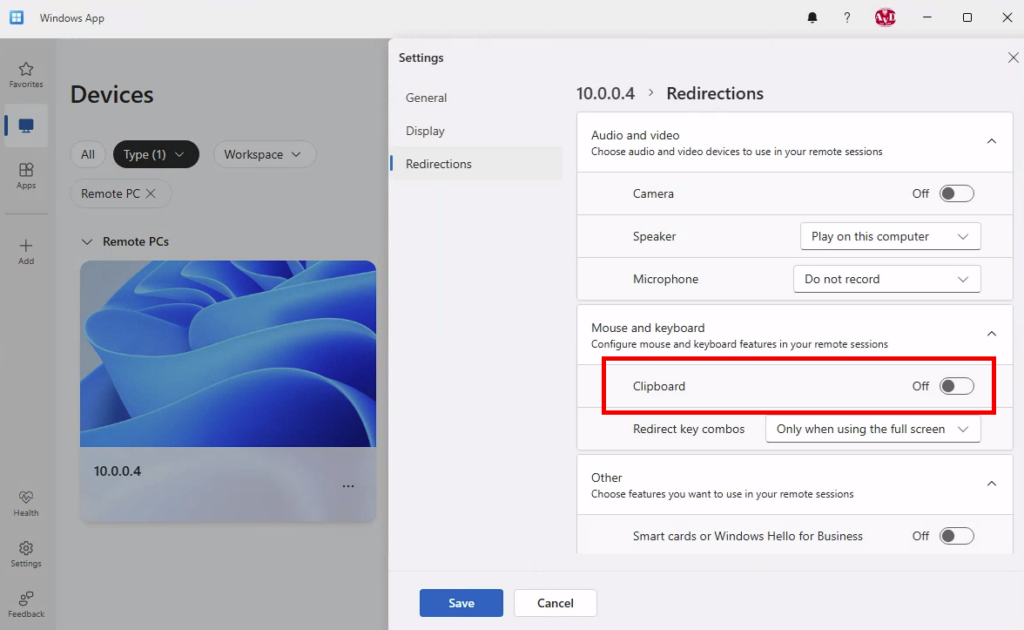
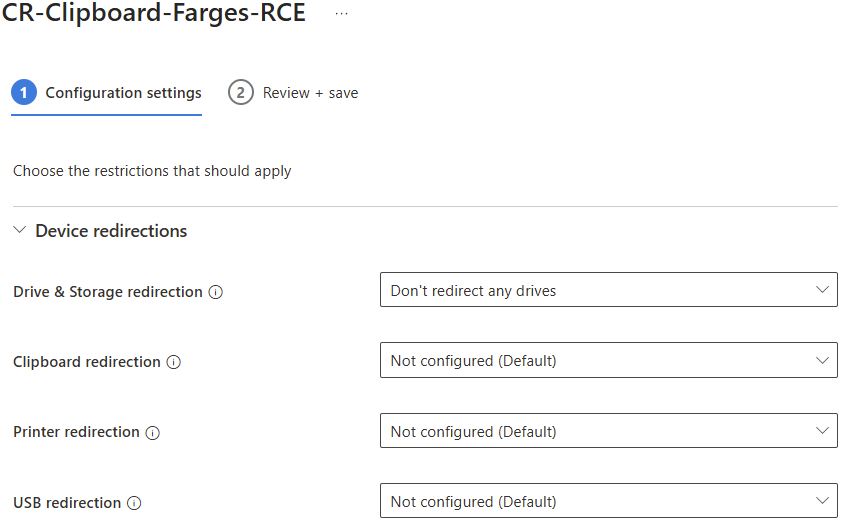
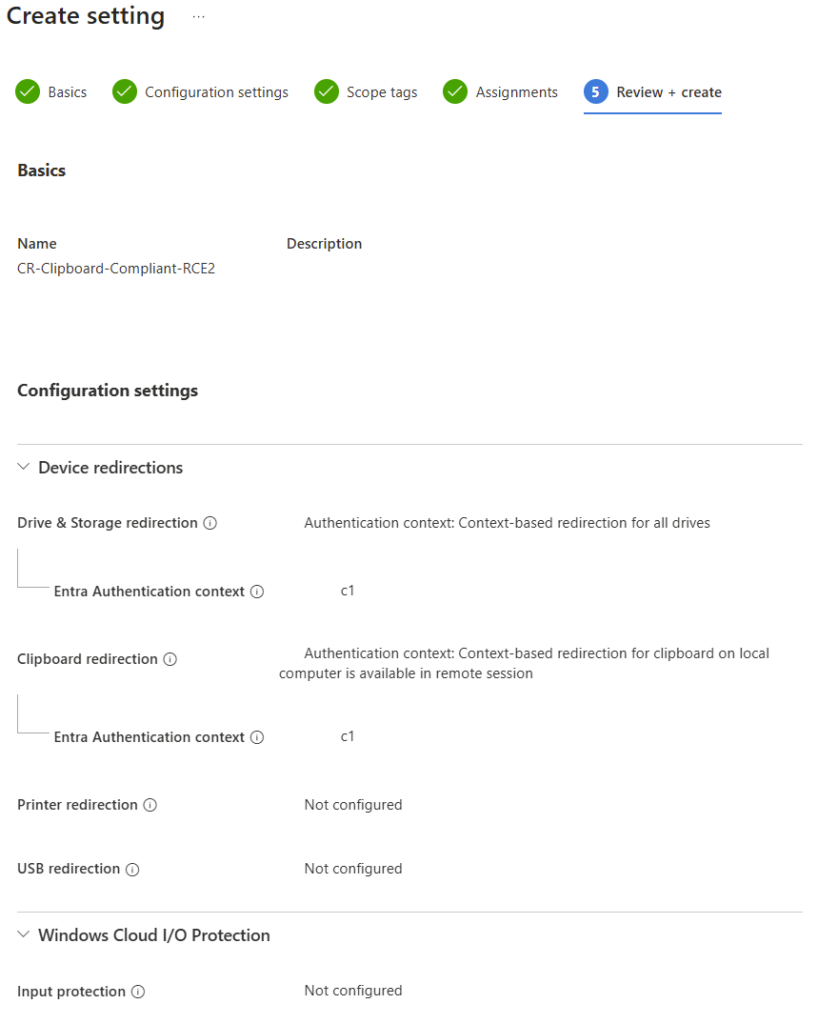
La procédure Remote PC de Microsoft indique que les redirections sont désactivées par défaut sur une nouvelle connexion :
Dans les paramètres de la carte, retrouvez l’accès aux ressources locales et activez uniquement le presse-papier si l’option est disponible et autorisée. Enregistrez, puis reconnectez-vous.
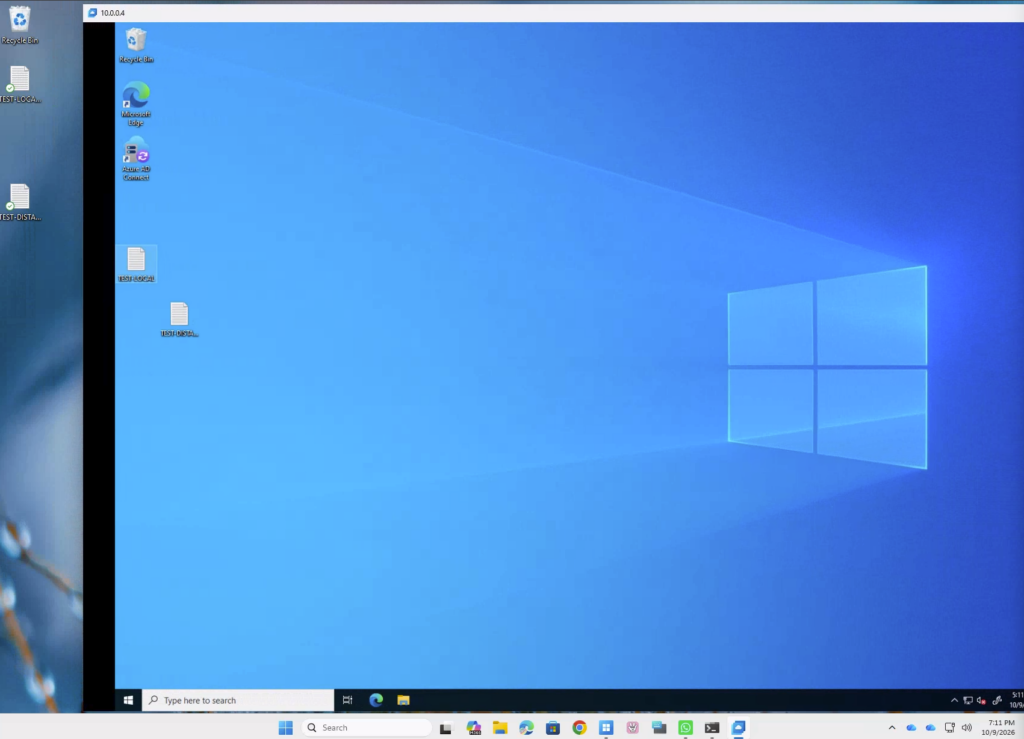
Faites les essais avec des fichiers locaux et distants. Ces nouveaux marqueurs permettent d’éviter de prendre un ancien contenu du presse-papier pour le résultat du nouvel essai :
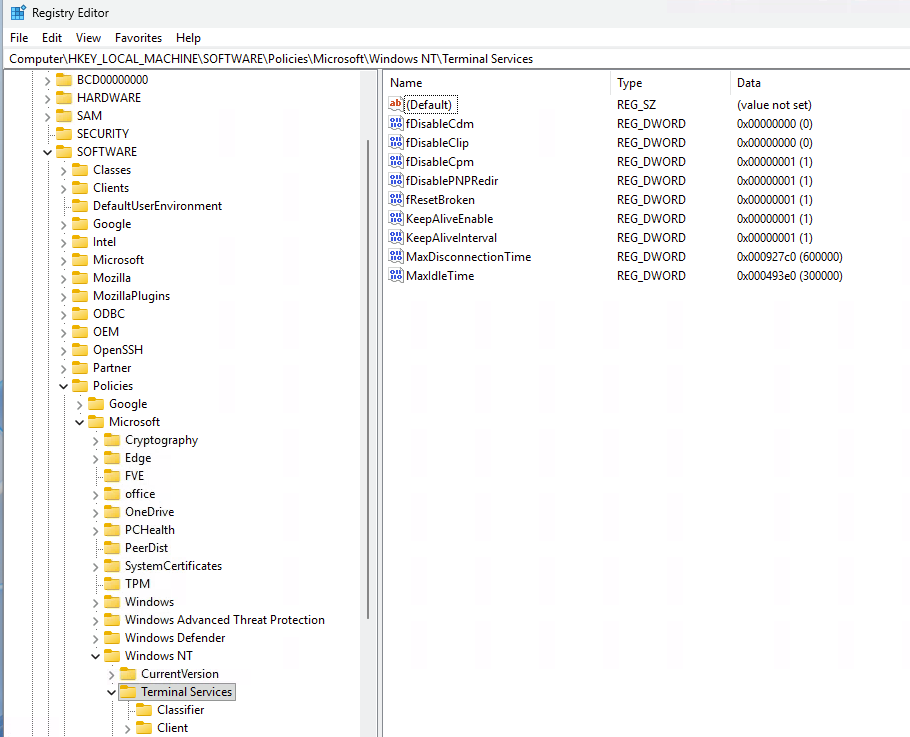
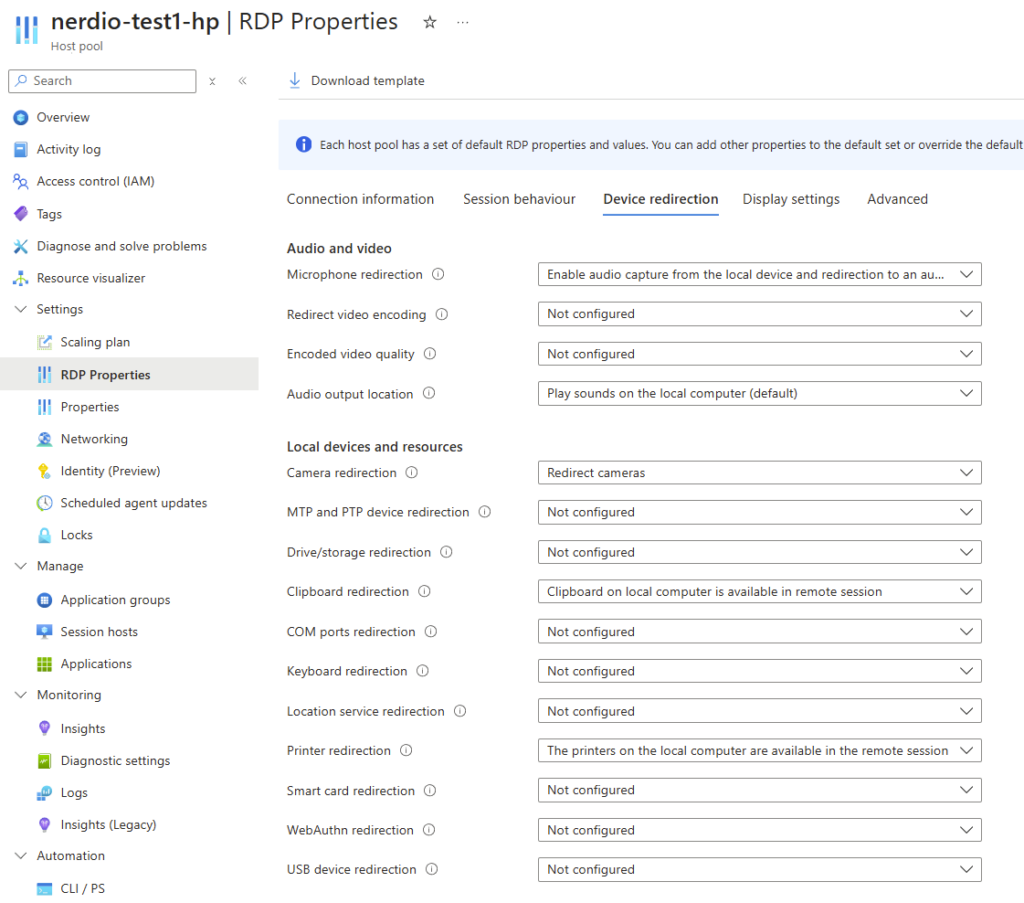
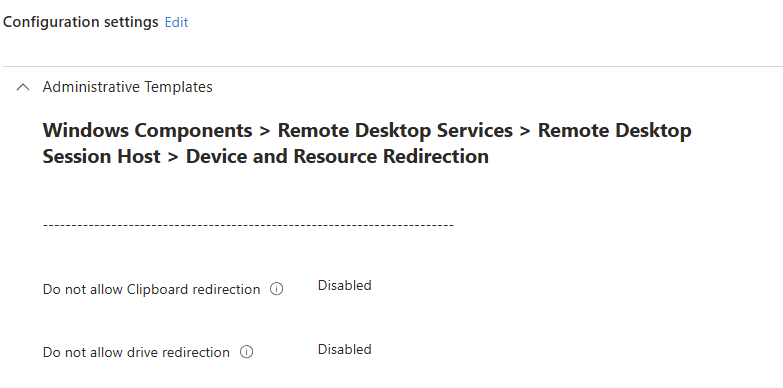
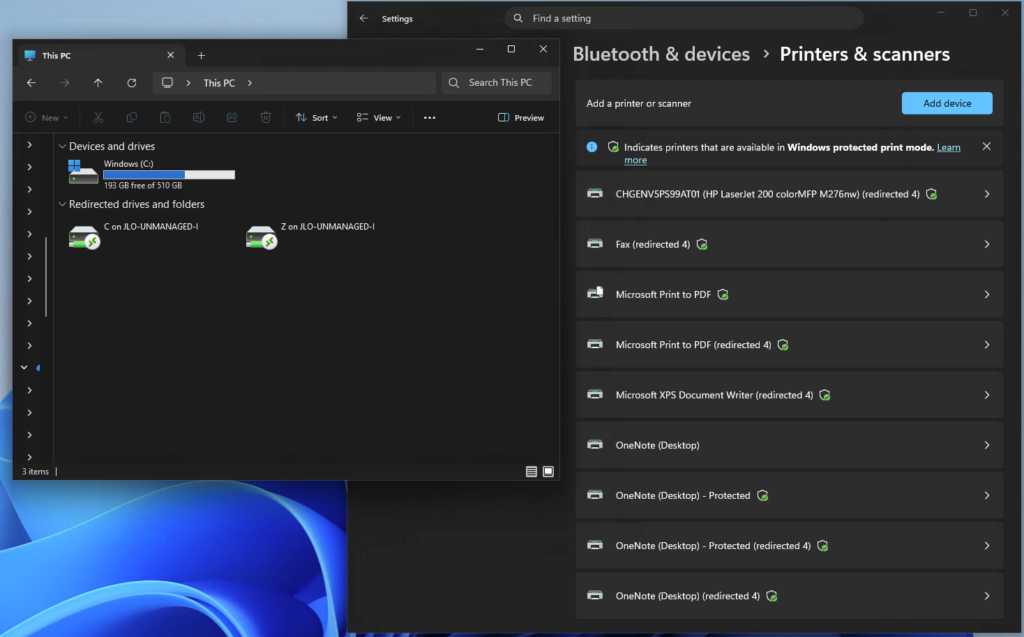
Attention : activer une option côté client ne contourne pas une restriction d’administration. Si le collage reste bloqué, vérifiez les stratégies plutôt que de tout désactiver. La page Redirect local devices, audio, and folders in Windows App explique la priorité des réglages les plus restrictifs.
2. Azure Virtual Desktop : découvrir les Regional Host Pools
Autre actualité, cette fois dans Azure Virtual Desktop. Les Regional Host Pools sont GA depuis septembre 2026 ; leurs métadonnées sont régionalisées pour améliorer la résilience en réduisant les dépendances interrégionales. Le statut est confirmé dans What’s new in Azure Virtual Desktop ?, rubrique « September 2026 ».
Au lancement, seules East US 2 et Central US sont disponibles ; une réplication vers une région jumelée reste possible. Voir Now generally available : Regional resiliency for Azure Virtual Desktop, publié le 30 septembre 2026. Pour notre essai, on retient East US 2 avec des données de lab, pas comme recommandation d’hébergement pour vos données européennes.
Le réglage à repérer est Deployment scope. La région des métadonnées et celle des VM restent des choix distincts : sélectionner Regional n’est pas une opération de déplacement de vos session hosts. Pour un administrateur, la première vérification utile est donc le type d’objets créé et leur compatibilité.
Ce que signifie Regional pour un host pool
La page Regional Host Pools décrit une infrastructure de service dédiée aux objets régionaux. Le sujet concerne notamment la manière dont les métadonnées sont stockées et les dépendances de cette infrastructure. Ce n’est pas une option qui recrée automatiquement les VM, déplace les profils FSLogix ou modifie vos applications.
Pour votre lab, gardez donc deux vérifications simples : la région retenue doit proposer le scope Regional, et les objets que vous associerez au pool doivent être compatibles avec ce nouveau scope. Un groupe de ressources commun ne suffit pas à rendre une association valide.
La GA ne signifie pas non plus que toutes les régions Azure proposent immédiatement le nouveau modèle. Vérifiez la disponibilité au moment du test. Si le champ n’est pas visible dans la région choisie, ne continuez pas avec les valeurs par défaut en pensant avoir créé un pool régional.
Test n°3 : créer un pool Regional, sans VM
Utilisez une subscription et un groupe de ressources de lab, avec les permissions de création nécessaires. Ce test crée des objets AVD, pas un environnement complet : aucune ouverture de bureau n’est attendue puisqu’on n’ajoute pas de session host.
La procédure de référence est « Create a host pool with standard management » dans Deploy Azure Virtual Desktop.
Dans le portail Azure, ouvrez Azure Virtual Desktop, puis Host pools et Create. Utilisez uniquement le groupe de ressources réservé au lab.
Sur Basics, choisissez votre subscription et le groupe de ressources. Donnez un nom identifiable au pool de test pour le retrouver facilement après déploiement.
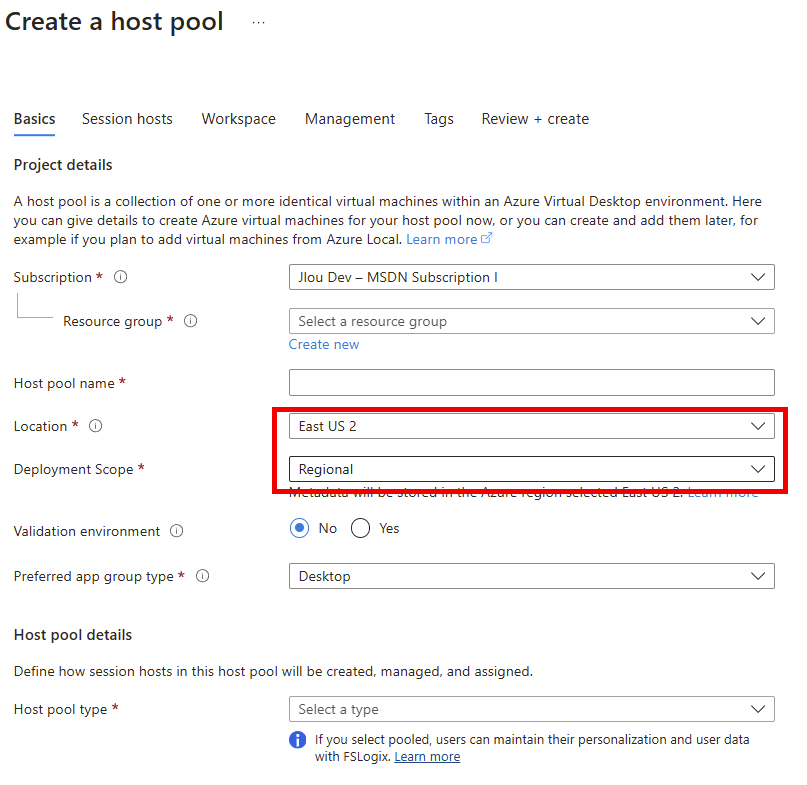
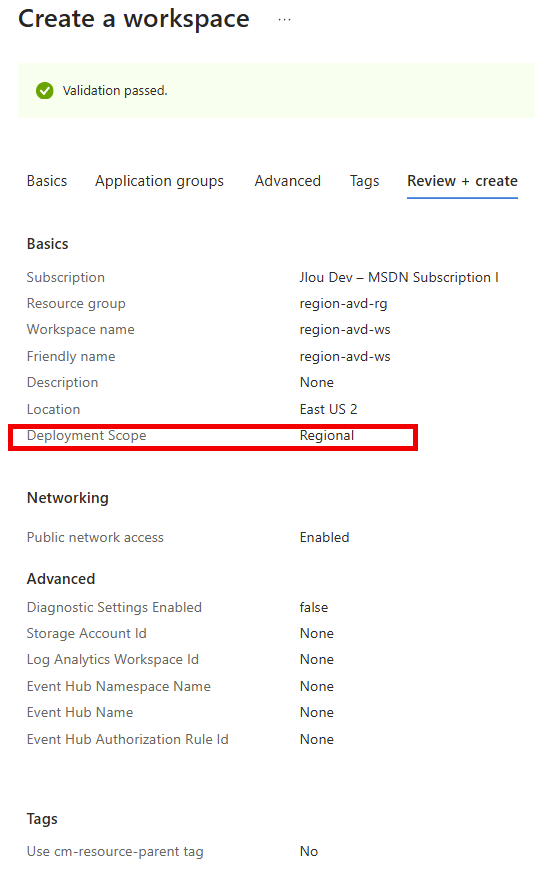
Dans Location, choisissez East US 2 pour cet exemple. Dans Deployment scope, sélectionnez explicitement Regional. Si le champ n’apparaît pas, arrêtez l’essai et vérifiez la disponibilité.
Choisissez Pooled pour le type de pool, Desktop pour le type de groupe préféré et la gestion standard. Ne configurez pas de session host configuration pour cet essai.
Ne créez aucune VM et ne rattachez pas le groupe d’applications à un workspace existant. Le test porte sur la création des objets, pas sur une session utilisateur.
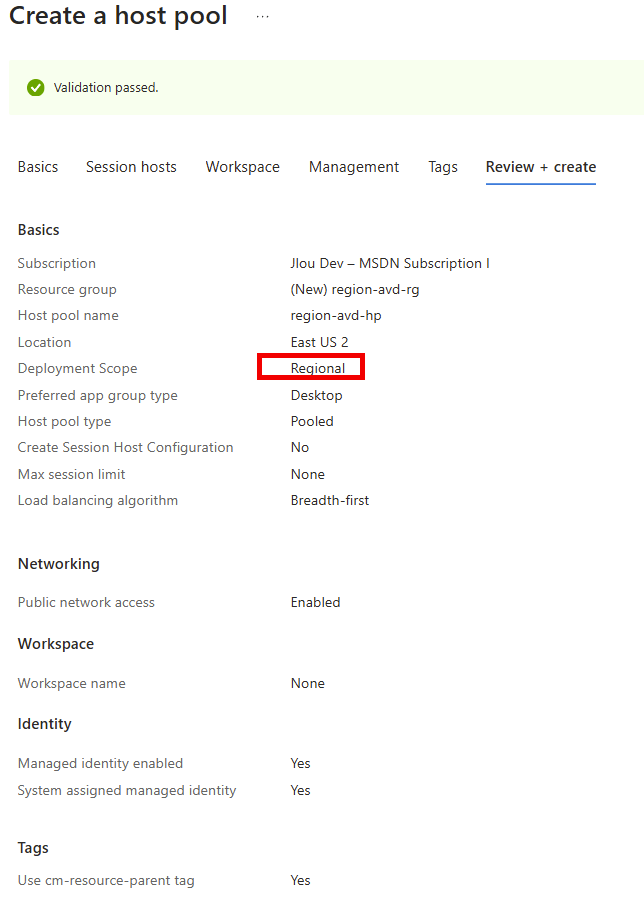
Dans Review + create, relisez la région, le scope et les ressources annoncées. Le portail crée également le groupe d’applications Desktop par défaut. Lancez la création seulement si le résumé correspond au périmètre prévu.
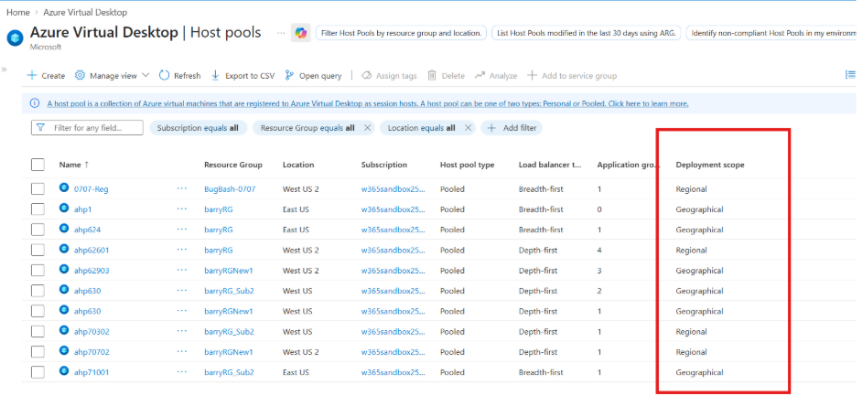
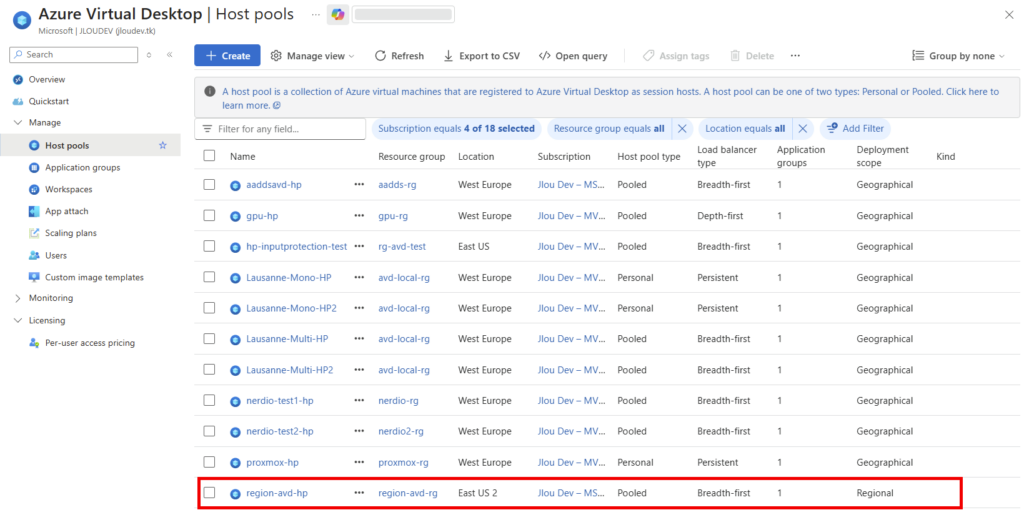
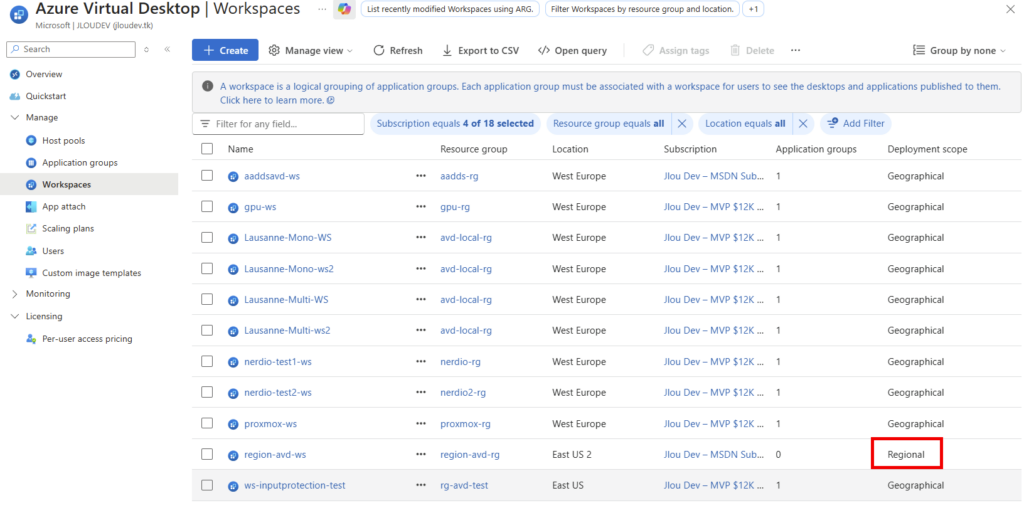
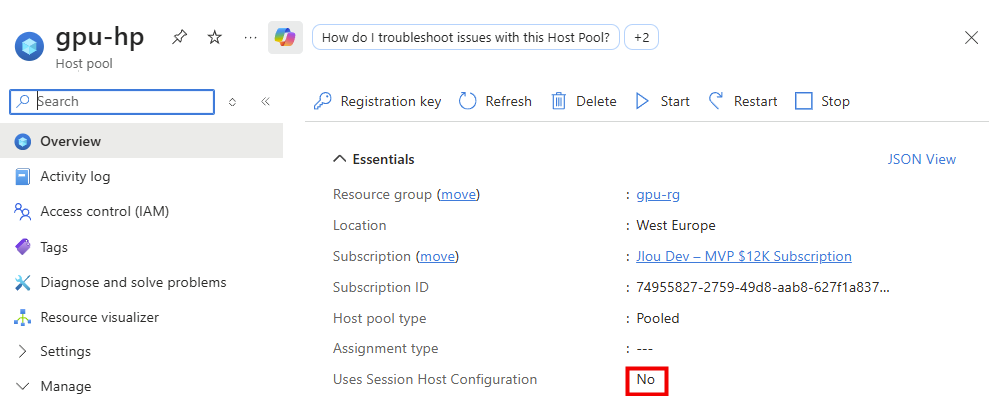
Après déploiement, contrôlez le scope dans les propriétés du pool ou la colonne Deployment scope de la liste. La valeur attendue est Regional :
Voici d’ailleurs la commande PowerShell pour créer un pool d’hôtes régional :
Si vous poursuivez le lab avec un workspace, gardez une chaîne homogène. Le groupe d’applications hérite du scope de son host pool et ne peut être enregistré que dans un workspace du même scope. Les règles sont détaillées dans « Deployment scope and object relationships » du guide de déploiement.
Pour prolonger ce même test, vous pouvez créer un workspace Regional dans le lab :
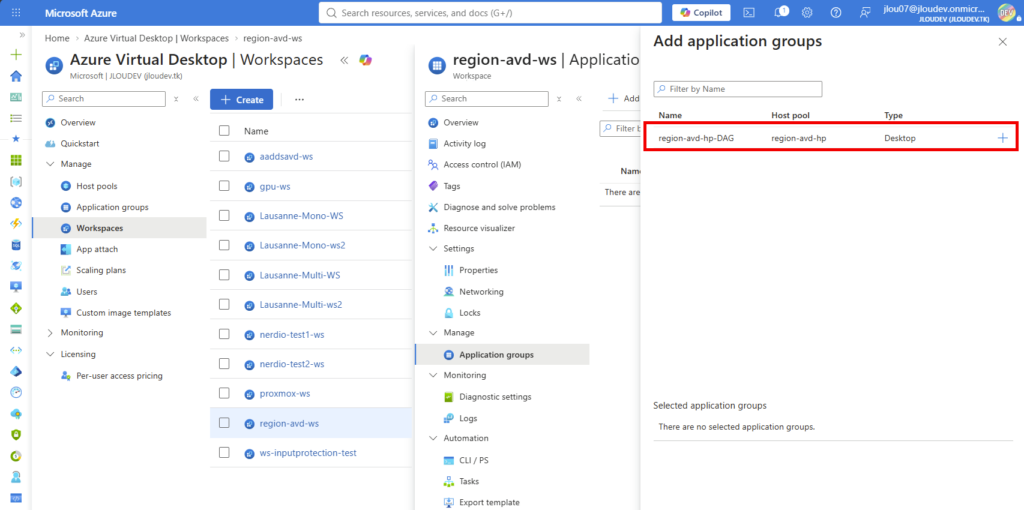
Vérifiez le scope du workspace avant l’association :
Si le groupe n’est pas proposé ou reste grisé, contrôlez son scope et une éventuelle association existante avant de toucher aux permissions.
Cette association valide la configuration des objets ; sans session host, elle ne fournit toujours pas un bureau utilisable.
Attention : le scope n’est pas modifiable après création. Par ailleurs, Regional Host Pools contient encore des mentions de preview : pour le statut actuel, retenez l’annonce GA et le journal des nouveautés, pas ces anciens libellés.
Avant d’envisager un déploiement plus large
Gardez le nom du pool, la région choisie et une capture du scope obtenu avec vos notes de test. Ce contrôle ne démontre pas un basculement en cas de panne régionale. Pour une utilisation en production, examinez séparément les VM, les profils, les applications et la supervision : la page Regional Host Pools signale encore une limitation sur la remontée des erreurs et checkpoints dans Log Analytics, à confirmer pour votre déploiement GA.
🤖
Contenu assisté par IACet article a été rédigé avec l’assistance d’une intelligence artificielle et relu par l’auteur.
À la fin de mon article sur Azure Virtual Desktop Hybride, je terminais par une question ouverte : et si quelqu’un testait sur un hyperviseur que je n’avais pas couvert, du Proxmox par exemple ? Personne ne m’a répondu. Alors je l’ai fait moi-même. Le résultat tient en une phrase : ça marche, et exactement de la même façon que sur Hyper-V ou vSphere. La VM Windows 11 montée dans le premier article Proxmox sur Azure, jointe à Entra ID, devient un session host Azure Virtual Desktop à part entière. On se connecte dessus depuis la Windows App, et le bureau qui s’affiche tourne dans Proxmox.
Ce qui rend ce lab amusant, c’est l’empilement : un service AVD dans Azure, qui pilote un session host qui tourne dans Proxmox VE, lui-même hébergé dans une machine virtuelle Azure. Trois couches, et tout le monde s’en accommode.
Si vous débarquez ici sans contexte, lisez peut-être d’abord l’article Azure Virtual Desktop Hybride, qui explique ce qu’est cette préversion, ce qu’elle apporte et ses limites. Celui-ci se concentre sur un seul point : le cas Proxmox, et les deux ou trois choses qui diffèrent quand l’hyperviseur n’est pas dans la liste officielle.
Pour vous guider plus facilement dans cet article, voici des liens rapides :
La question mérite une réponse honnête, parce qu’elle a deux niveaux.
Dans son annonce, Microsoft cite nommément Hyper-V, Nutanix AHV, VMware vSphere et les serveurs Windows physiques. Proxmox n’y figure pas. Si vous cherchez une ligne de documentation qui écrit le mot Proxmox, vous ne la trouverez pas, et un support Microsoft pourra légitimement vous le rappeler.
Mais la page d’aperçu de la fonctionnalité est nettement plus large, et c’est elle qui décrit la règle réelle.
You can run Azure Virtual Desktop session hosts on your preferred on-premises hypervisor that supports Windows virtual machines.
Autrement dit, l’hyperviseur n’est pas un participant de la mécanique, il est juste le meuble sur lequel la VM est posée. Azure Arc parle à un Windows, pas à un hyperviseur. Tant que ce Windows est éligible, qu’il sort en TCP 443 et que l’agent Connected Machine s’installe, le reste suit. C’est très exactement ce que j’avais constaté entre mes trois cas Hyper-V et vSphere : la procédure est rigoureusement identique.
Attention : supporté et fonctionnel ne sont pas synonymes. Proxmox fonctionne, je l’ai vérifié de bout en bout, mais il n’est pas nommé dans la matrice Microsoft. Pour un lab, une démonstration ou un PoC, aucun problème. Pour un déploiement de production, gardez en tête que vous sortez de la liste explicitement citée, ce qui s’ajoute au fait que la fonctionnalité est déjà en préversion.
2. Le point qui mérite d’être posé clairement : Arc dans une VM imbriquée
Il y a une bizarrerie dans ce lab, et je préfère la traiter tout de suite plutôt que de laisser quelqu’un la relever en commentaire.
Azure Arc sert à gérer des machines qui ne sont pas dans Azure. Or mon nœud Proxmox est, lui, une machine virtuelle Azure. On pourrait croire qu’on essaie d’enrôler une VM Azure dans Arc, ce qui n’a pas de sens et n’est pas pris en charge :
Ce n’est pas ce qui se passe. Ce que j’enrôle, c’est la VM Windows 11 qui tourne dans Proxmox, et cette machine n’a rien d’une ressource Azure : elle n’apparaît dans aucun groupe de ressources, elle n’a pas d’identité managée, elle n’atteint pas le service de métadonnées d’instance, et son adresse est une 10.10.10.x distribuée par le dnsmasq du nœud, derrière le NAT nftables mis en place dans le premier article. Du point de vue d’Azure Arc, c’est une machine anonyme quelque part sur Internet qui sort en 443. Exactement le profil d’un serveur de datacenter.
Mon retour terrain : cette nuance n’est pas un détail de présentation, c’est ce qui fait que le lab est représentatif. Si vous refaites l’exercice sur un Proxmox posé sur une vraie machine dans votre garage ou votre salle serveur, vous obtiendrez le même résultat par le même chemin. Azure n’est ici qu’un moyen commode de disposer d’un hyperviseur.
3. Étape 0 : l’état de départ et les pré-requis
Je repars de la machine construite dans les deux articles précédents, sans rien y changer d’autre que l’identité.
Élément
Ce que j’ai
Hyperviseur
Proxmox VE 9, nœud proxmox-ve, dans une VM Azure Standard_D16s_v3
Réseau des invités
Bridge vmbr0 en 10.10.10.0/24, NAT nftables, DHCP et DNS par dnsmasq
Session host
VM Windows 11 Entreprise mono-session, 2 cœurs, 8 Gio, disque de 64 Gio
Identité
Microsoft Entra Join pur, aucun contrôleur de domaine
Licence utilisateur
Microsoft 365, éligible AVD
Abonnement
Un abonnement Azure actif, rôles Azure Connected Machine Onboarding et Desktop Virtualization Contributor
Les pré-requis côté Azure restent ceux de l’article Azure Virtual Desktop Hybride dans leurs grandes lignes, mais la documentation a évolué depuis que je l’ai écrit, et deux points ont changé. Je les signale au fil des étapes.
Azure Connected Machine Onboarding, et Desktop Virtualization Contributor
Identité du session host
Entra Join, jointure AD, ou jointure hybride pour un Windows client
Réseau
Sortie TCP 443 vers les URL requises par AVD et vers les endpoints Azure Arc
Agent Arc
Azure Connected Machine agent installé sur chaque session host
Identité managée
À assigner au host pool, avec le rôle Reader sur le groupe de ressources des machines Arc
Attention : un point d’identité que je n’avais pas détaillé dans mon article de mai et que la documentation précise désormais : un session host Windows Server ne peut pas être en Entra Join pur, à cause de la dépendance au serveur de licences Bureau à distance. Il lui faut une jointure AD ou hybride. C’est seulement sur un Windows client, comme le Windows 11 de ce lab, que l’Entra Join seul est accepté.
Attention : un rappel qui vaut pour tous les hyperviseurs et que je répète ici parce qu’il coûte cher : l’identité doit être fixée avant l’enrôlement Arc. Si vous faites l’Entra Join après avoir posé l’agent, il faut désinstaller l’agent et recommencer. Sur une VM neuve, faites l’Entra Join d’abord, Arc ensuite, extension AVD en dernier.
4. Étape 1 : vérifier l’Entra Join du session host
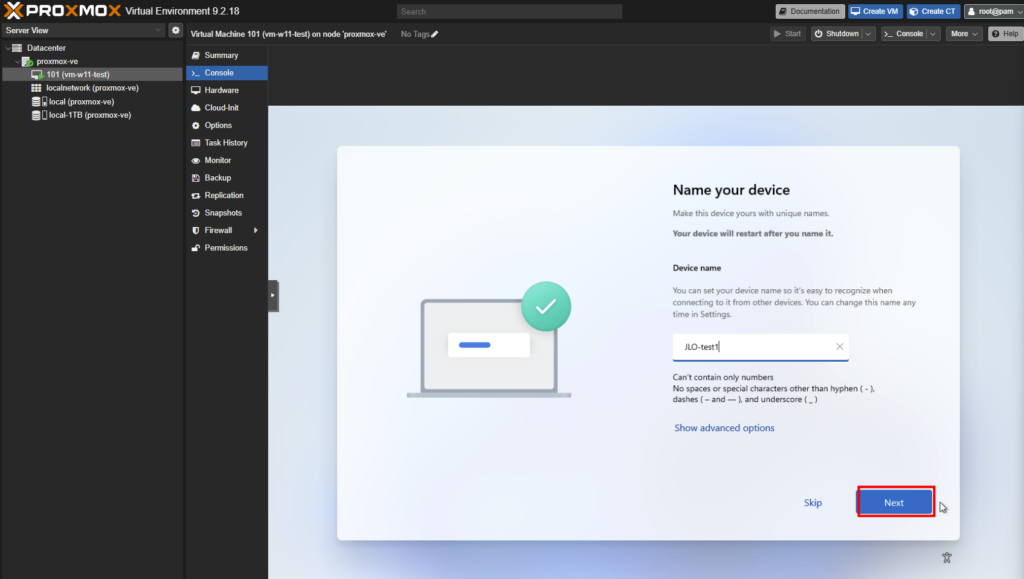
Ma VM Windows 11 a été jointe au tenant pendant l’OOBE, avec l’option Set up for work or school. Si la vôtre est en compte local, faites-le maintenant par Paramètres, Comptes, Accès Professionnel ou Scolaire, puis Connecter et l’option de jointure à Microsoft Entra.
La vérification se fait en une commande, dans une invite en administrateur.
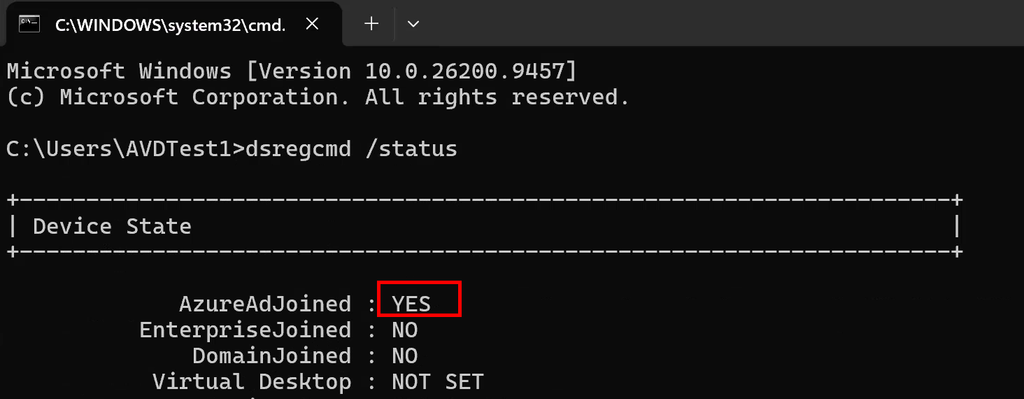
dsregcmd /status
Dans la section Device State, il faut lire AzureAdJoined : YES et DomainJoined : NO. C’est la signature d’un Entra Join pur :
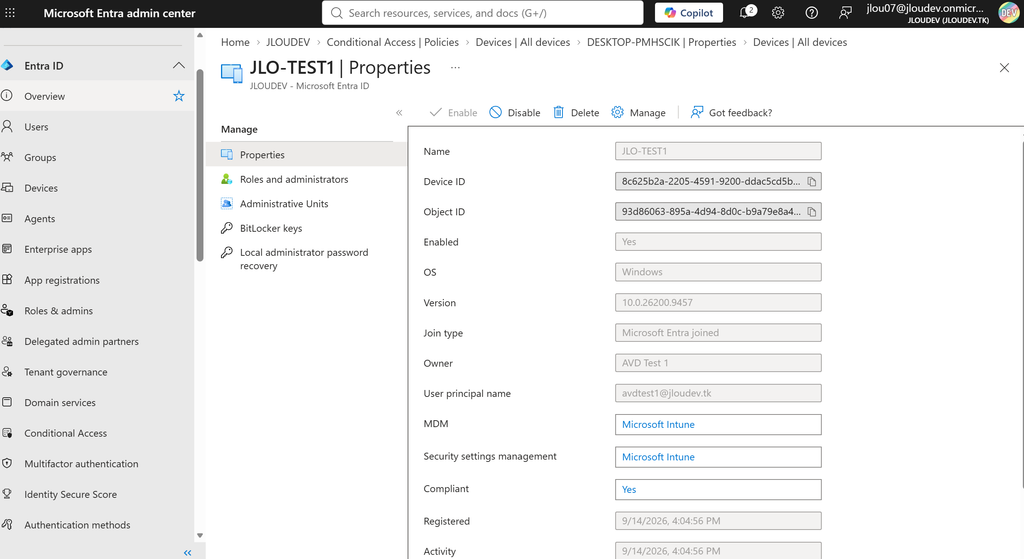
Vérifiez au passage dans le centre d’administration Entra que l’appareil est bien apparu dans la liste, avec son nom d’hôte :
Mon retour terrain : c’est le scénario que je préférais déjà dans mon article AVD hybride, et Proxmox ne change rien à cette préférence. Pas de contrôleur de domaine à rendre joignable depuis le réseau interne de l’hyperviseur, pas de Kerberos, pas de GPO. Avec un bridge NAT comme le nôtre, où les invités sont derrière une translation d’adresses, c’est même un vrai confort : un DC aurait demandé du routage supplémentaire. Gardez juste en tête que ce raccourci n’est ouvert qu’aux Windows client, un Windows Server exigeant une jointure AD ou hybride.
5. Étape 2 : vérifier la sortie réseau du session host
C’est le seul point où la configuration Proxmox de notre lab demande une attention particulière. Les invités sont derrière le NAT nftables du nœud, et l’agent Arc comme les composants AVD ont besoin de sortir en TCP 443.
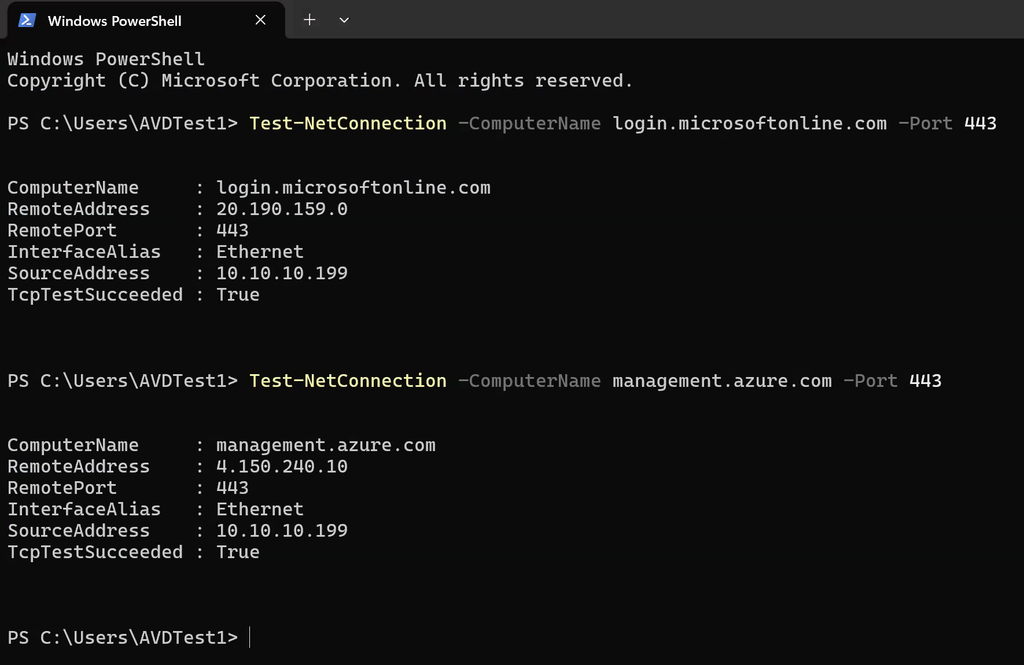
Un test simple depuis la VM Windows, en PowerShell.
Si ces tests échouent, reprenez la configuration réseau du premier article : le routage IPv4 activé, la règle de masquerade dans la table nat, et la chaîne forward qui accepte les flux de 10.10.10.0/24 vers eth0. Côté nœud, une vérification rapide.
sudo nft list ruleset
sysctl net.ipv4.ip_forward
Attention : l’agent Arc et AVD ont besoin d’un flux sortant uniquement. Vous n’avez rien à ouvrir en entrée sur le NSG Azure, et surtout pas de RDP : la connexion utilisateur passe par le service AVD via une passerelle inversée, pas par une exposition directe du port 3389. C’est l’un des vrais bénéfices de la mécanique, et il tombe particulièrement bien dans notre montage où les invités n’ont de toute façon aucune adresse publique.
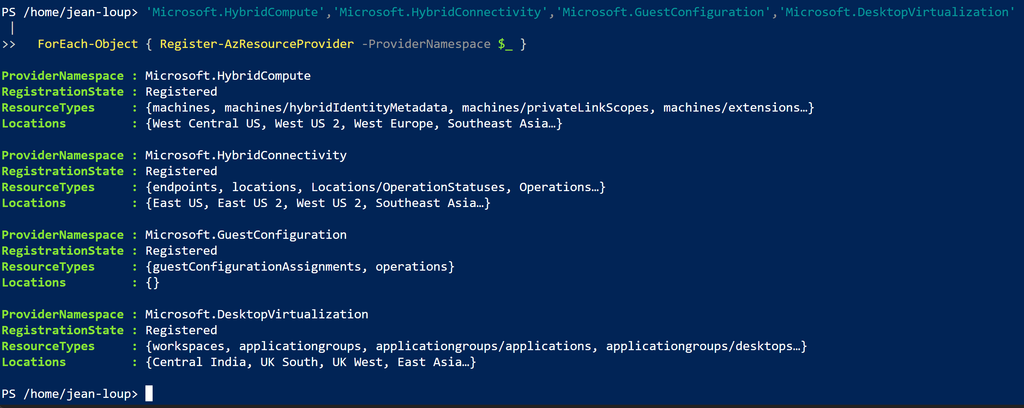
6. Étape 3 : enregistrer les resource providers
Rien de spécifique à Proxmox ici, mais c’est le préalable à tout le reste. Sur l’abonnement cible.
N’oubliez pas Microsoft.HybridConnectivity, qui porte la connectivité via Arc. Son absence laisse l’enrôlement réussir tout en faisant échouer silencieusement des opérations plus loin.
7. Étape 4 : créer le host pool et son identité managée
Ici, deux choses ont bougé depuis mon article de mai, et la seconde est un vrai piège si vous travaillez de mémoire.
Le host pool, désormais standard
Au lancement de la préversion, seul un host pool marqué comme environnement de validation acceptait un session host hybride. Ce n’est plus ce que dit la documentation, qui demande simplement de créer un host pool ordinaire sans y ajouter de machines.
Follow the Deploy Azure Virtual Desktop instructions to deploy a standard host pool without adding session hosts. Do not add virtual machines to this host pool.
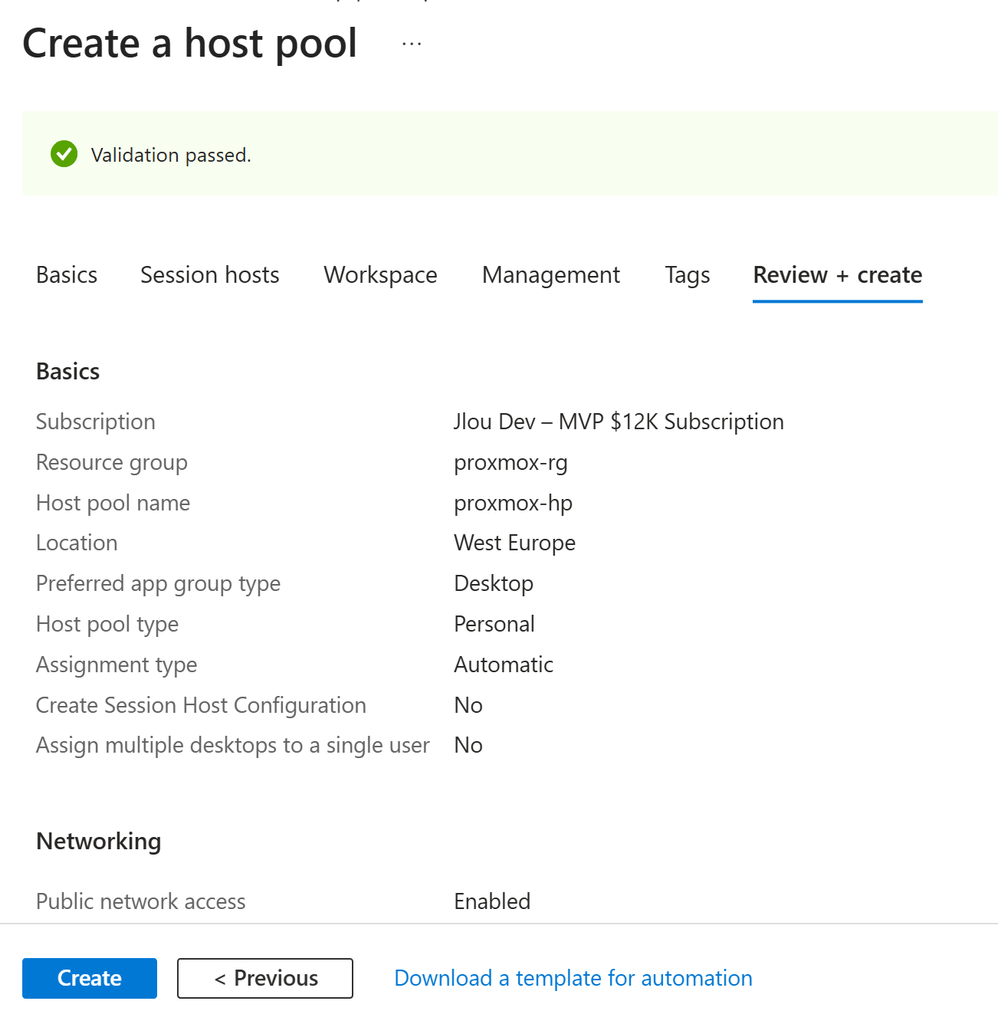
Dans le portail, cherchez Azure Virtual Desktop, puis Host pools et Create.
Dans Basics, nommez le pool, choisissez la région des métadonnées et le type Pooled ou Personal.
Dans Virtual machines, choisissez No, I’ll add VMs later. La machine arrivera par Arc, pas par l’assistant.
Dans Workspace, créez ou rattachez un workspace, puis validez.
Dans Identity, assignez une identité managée. Ne sautez pas cet onglet, la suite en dépend.
L’identité managée et son rôle Reader
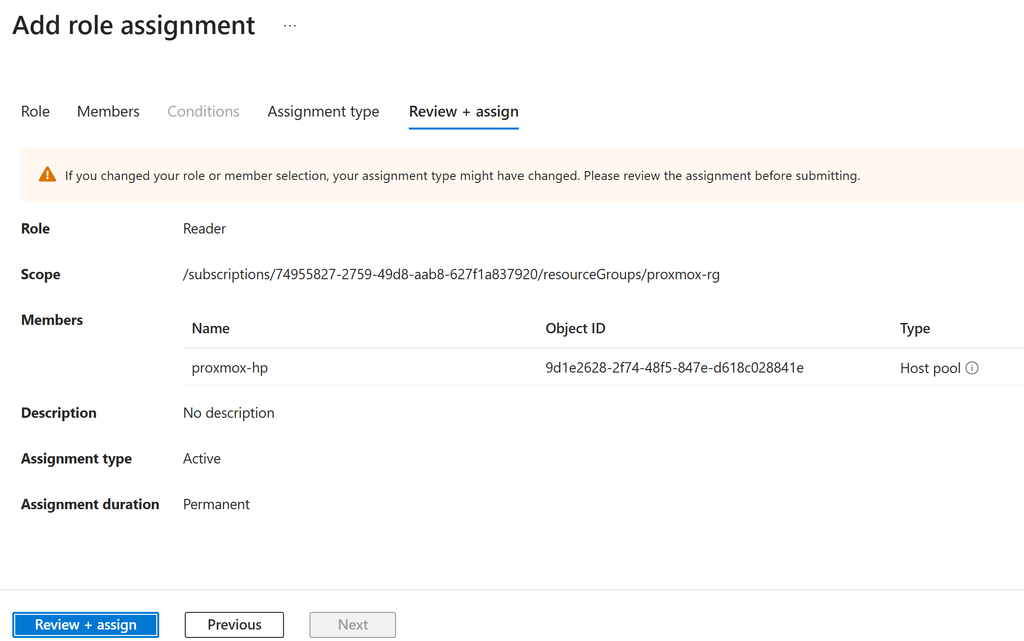
C’est la nouveauté qui coûte le plus cher à ignorer. L’identité managée du host pool doit disposer du rôle Reader sur le groupe de ressources qui contient vos machines Azure Arc. La documentation est explicite sur les conséquences.
If the managed identity doesn’t have Reader access to the Arc resource group, a future release will prevent session hosts from becoming available.
Ouvrez le groupe de ressources qui contient vos serveurs Arc.
Allez dans Access control (IAM), puis Add et Add role assignment.
Cherchez Reader, sélectionnez-le, puis Next.
Dans Assign access to, choisissez Managed identity, puis Select members.
Choisissez votre abonnement, le type Host pool, sélectionnez l’identité de votre host pool, et validez.
Attention : cette exigence n’existait pas au lancement de la préversion et n’apparaît donc pas dans mon article de mai. Si vous rejouez une procédure notée il y a quelques mois, c’est très précisément l’étape qui vous manquera, avec un symptôme différé et peu explicite : un session host qui ne devient jamais disponible.
8. Étape 5 : enrôler la VM Proxmox dans Azure Arc
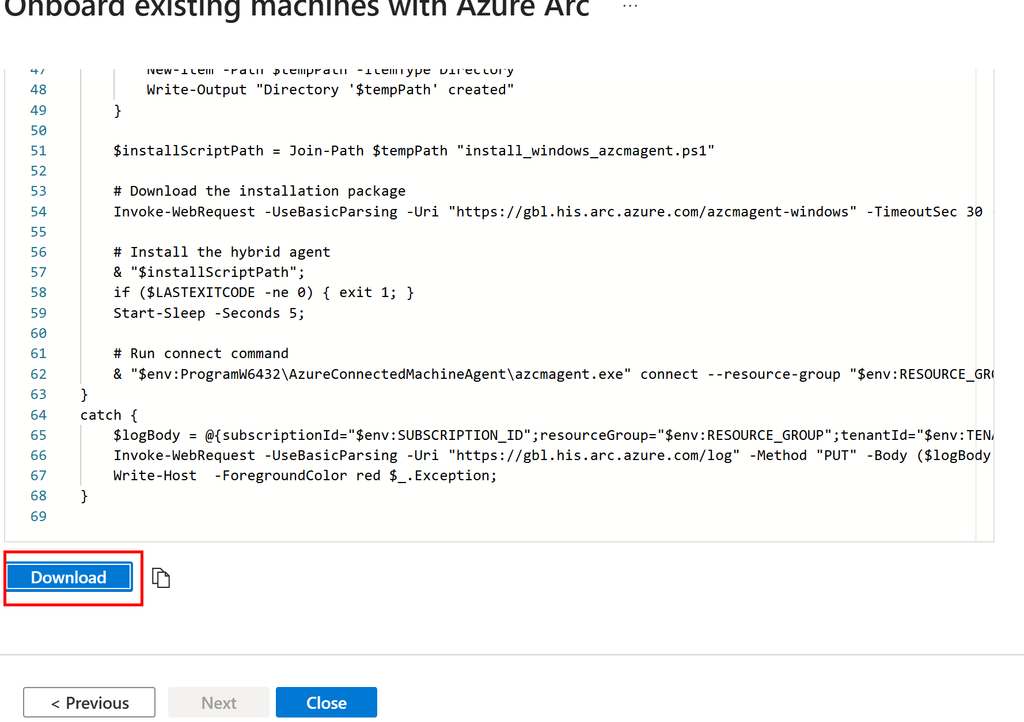
On y est. Dans le portail, allez dans Azure Arc, Machines, Add, puis Add a single server. Renseignez l’abonnement, le groupe de ressources et la région, et téléchargez le script PowerShell d’onboarding généré :
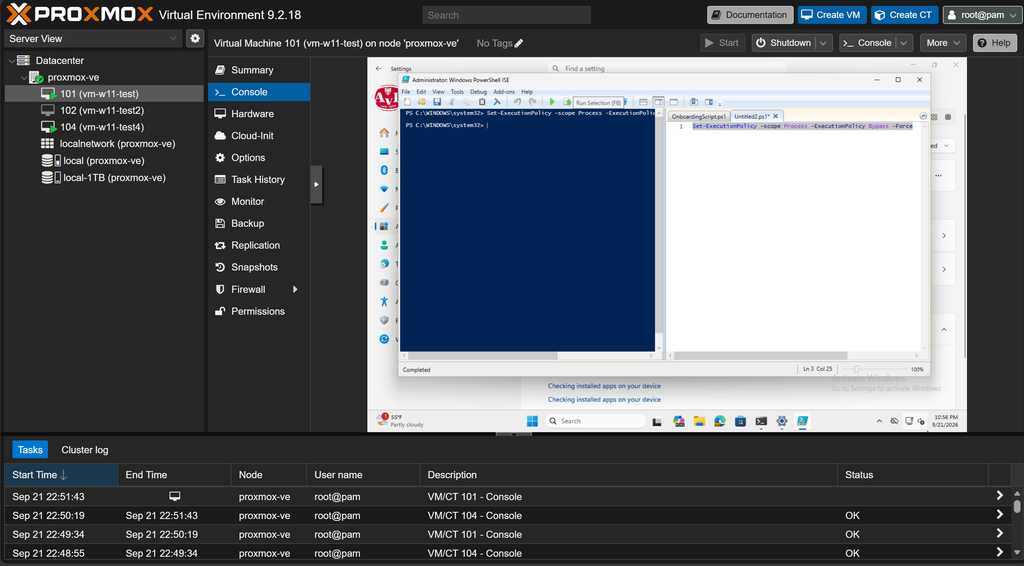
Ouvrez PowerShell ISE puis lancez la commande suivante :
Set-ExecutionPolicy -Scope Process -ExecutionPolicy Bypass -Force
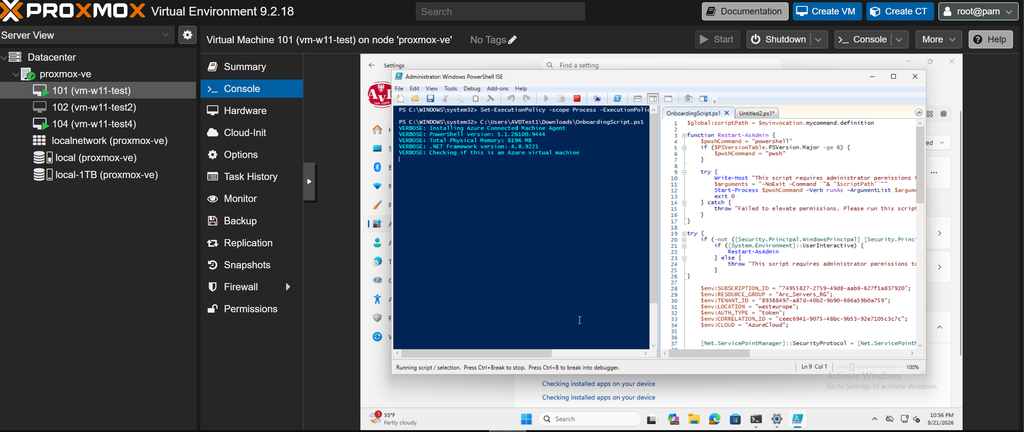
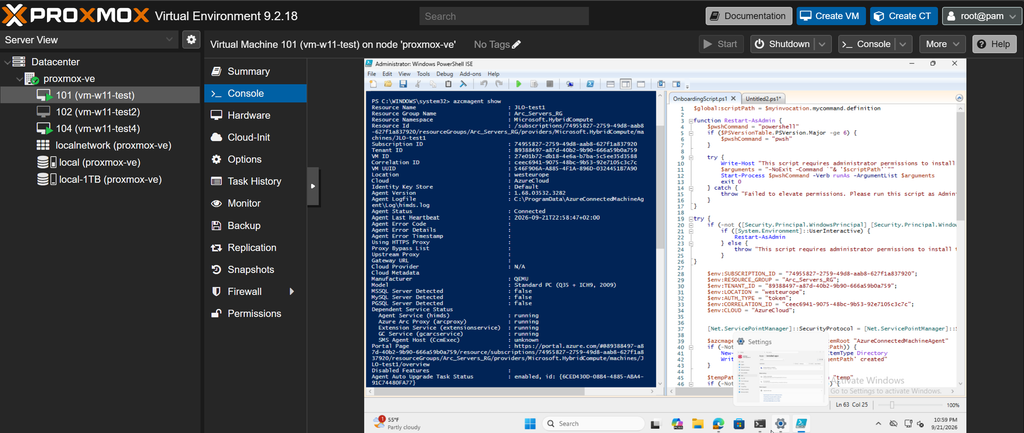
Collez le script d’Azure ARC dans la VM Windows 11 et exécutez-le. Il télécharge AzureConnectedMachineAgent.msi, l’installe, puis lance azcmagent connect avec les paramètres de votre tenant :
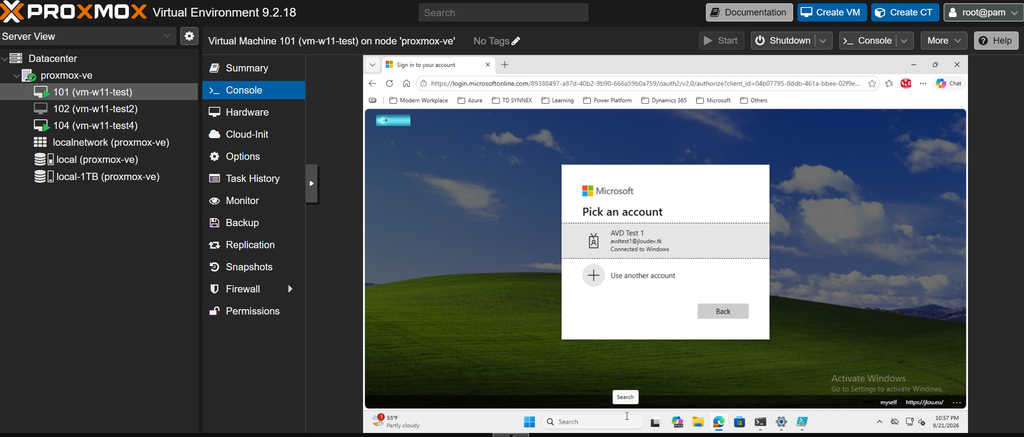
Une fenêtre d’authentification s’ouvre pour valider :
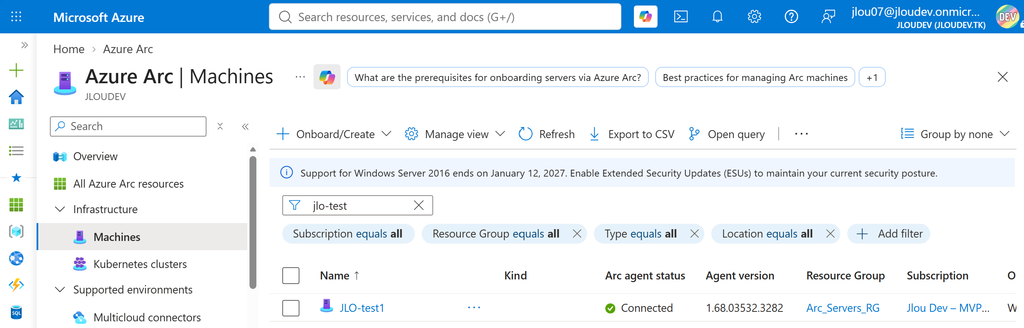
Au bout de deux à cinq minutes, la machine apparaît dans Azure Arc, Machines, avec le statut Connected :
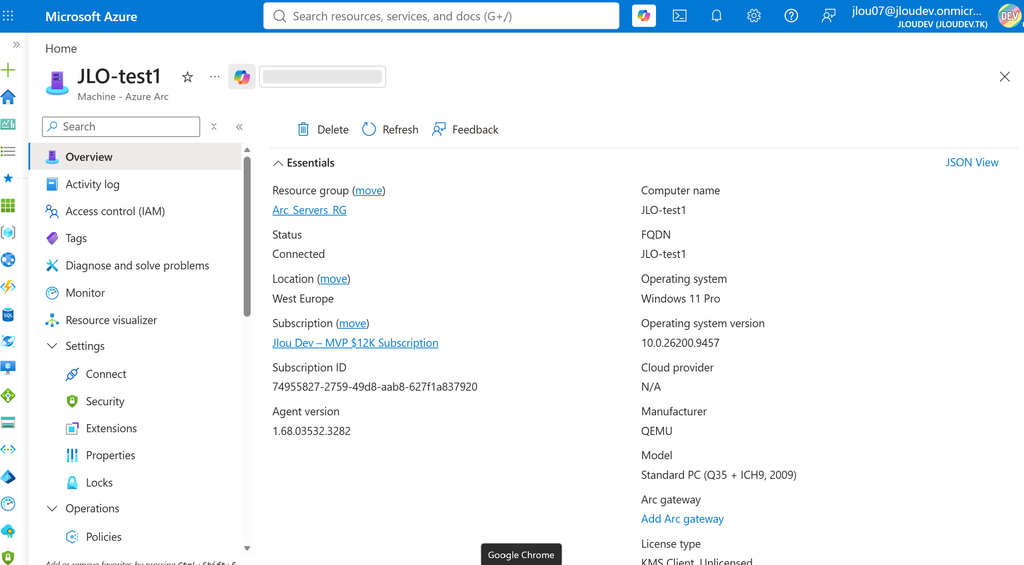
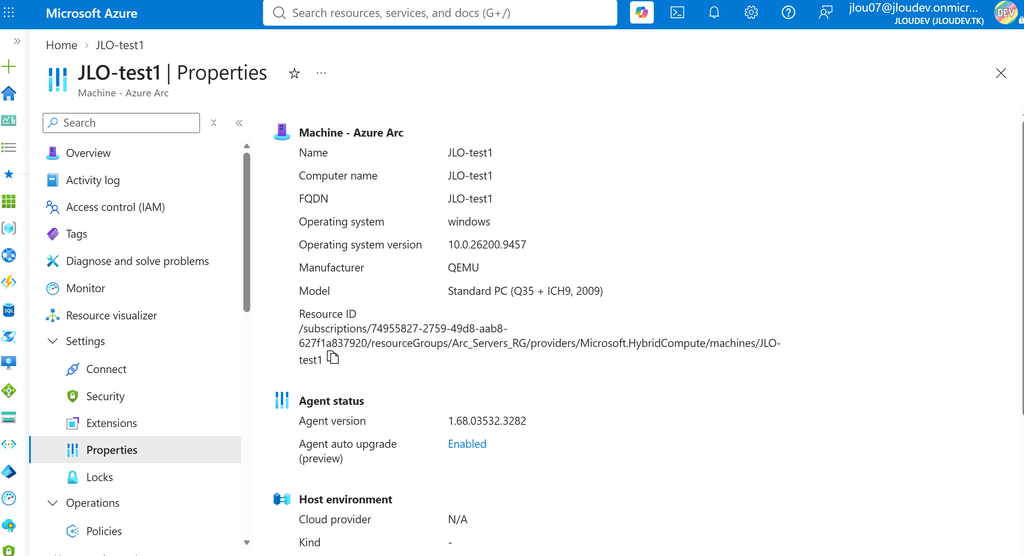
Ouvrez la ressource et regardez ses propriétés. C’est l’écran le plus intéressant de tout l’article :
Mon retour terrain : vérifiez la valeur d’azcmagent plutôt que de vous fier au portail seul. Sur la machine, azcmagent show vous donne l’état de l’agent, le statut de la connexion et les endpoints atteints. C’est le premier endroit où regarder si quelque chose coince, et c’est beaucoup plus parlant qu’un statut dans une liste.
azcmagent show
9. Étape 6 : poser l’extension AVD
C’est l’extension Azure Arc qui installe les composants AVD sur la machine et l’enregistre auprès du host pool. La documentation précise au passage ce qu’elle fait selon le système : sur Windows Server, elle active le rôle Hôte de session Bureau à distance, et sur Windows 11, elle active la connexion en RDP.
Attention : sur un Windows Server, l’activation du rôle entraîne un redémarrage de la machine. La documentation conseille d’installer le rôle avant de déployer l’extension pour éviter un redémarrage au milieu de la configuration. Sur notre Windows 11, la question ne se pose pas.
Bonne nouvelle par rapport à mon article de mai : il existe maintenant un chemin portail, sans génération de clé d’enregistrement à la main.
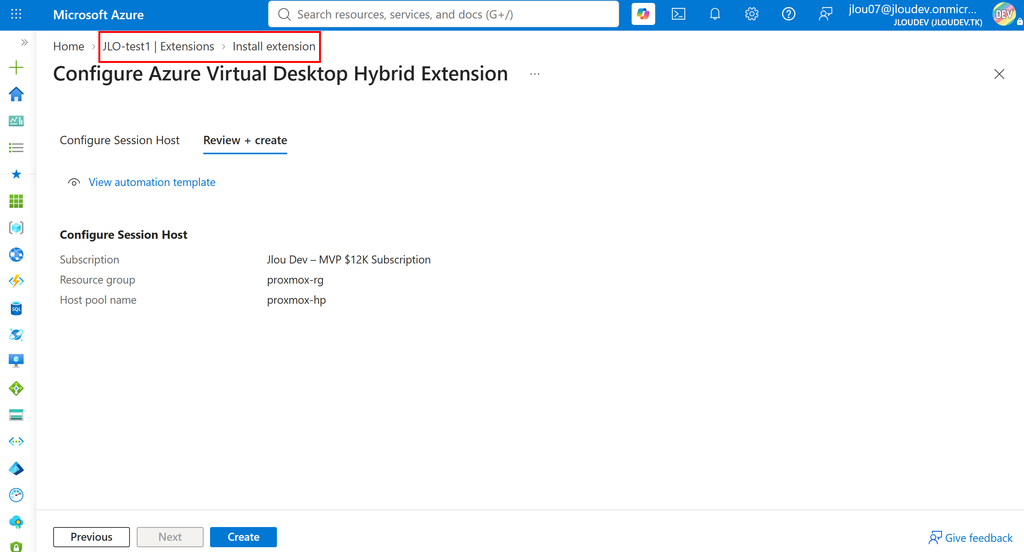
Option 1 : depuis le portail
Dans le portail, cherchez Azure Arc, dépliez Infrastructure et sélectionnez Machines.
Cliquez sur le nom de votre machine, puis dans le menu de gauche dépliez Settings et choisissez Extensions.
Cliquez sur Add, sélectionnez l’extension Azure Virtual Desktop Hybrid, puis Next.
Choisissez l’abonnement, le groupe de ressources et le host pool auquel rattacher le session host.
Validez par Review + Create puis Create.
Option 2 : en PowerShell
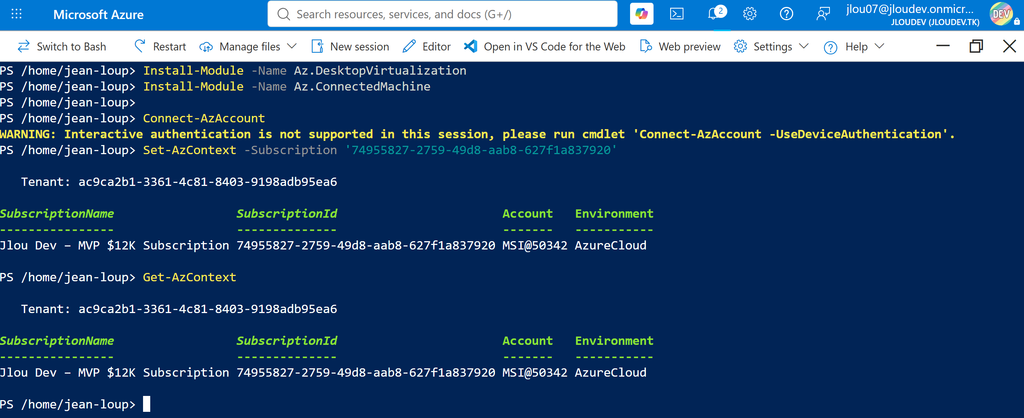
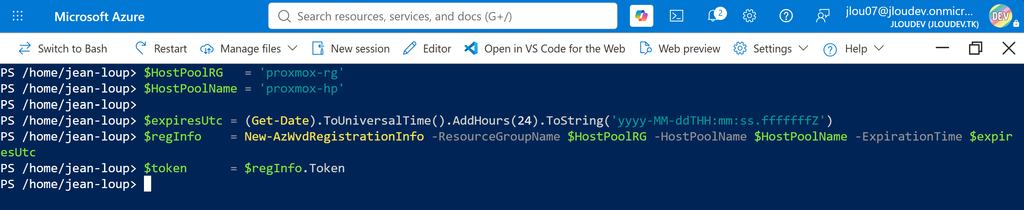
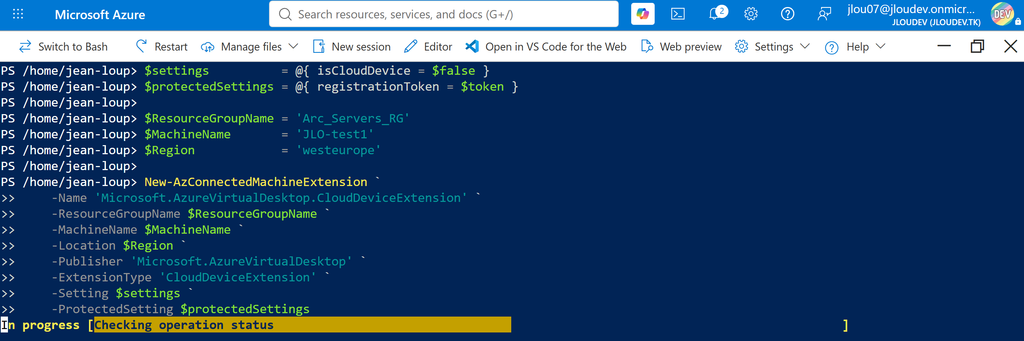
Le chemin script reste parfaitement valable, et c’est celui qu’on garde pour industrialiser. Installez les modules, puis connectez-vous en fixant explicitement l’abonnement :
isCloudDevice = $false est le drapeau qui indique le mode hybride. Sans lui, rien ne fonctionne.
MachineName est le nom de la ressource dans Azure Arc, pas forcément le nom d’hôte Windows brut.
Location est la région du groupe de ressources Arc, pas l’endroit où tourne physiquement la machine.
La clé d’enregistrement a une durée de vie limitée, générez-la juste avant de jouer le script.
Vérifier le résultat
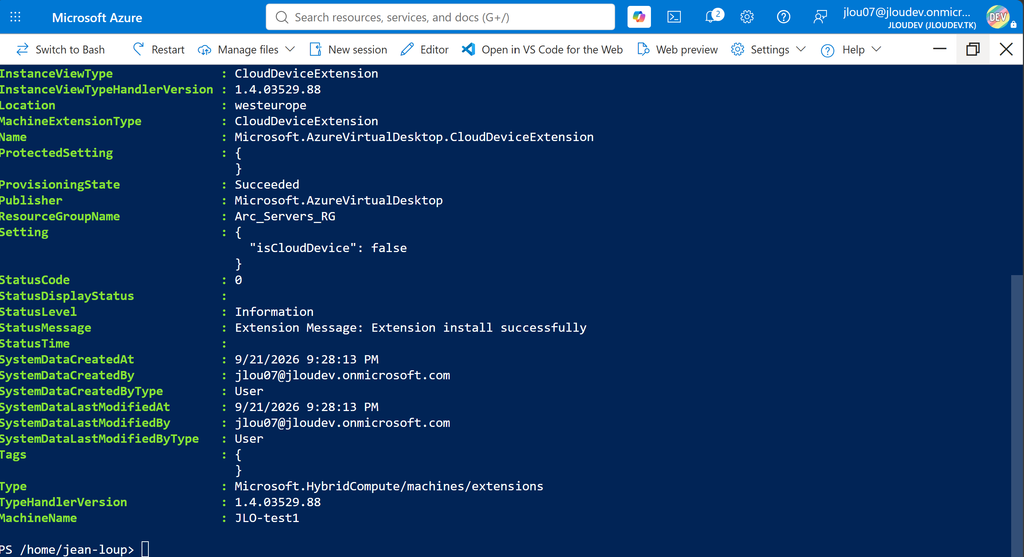
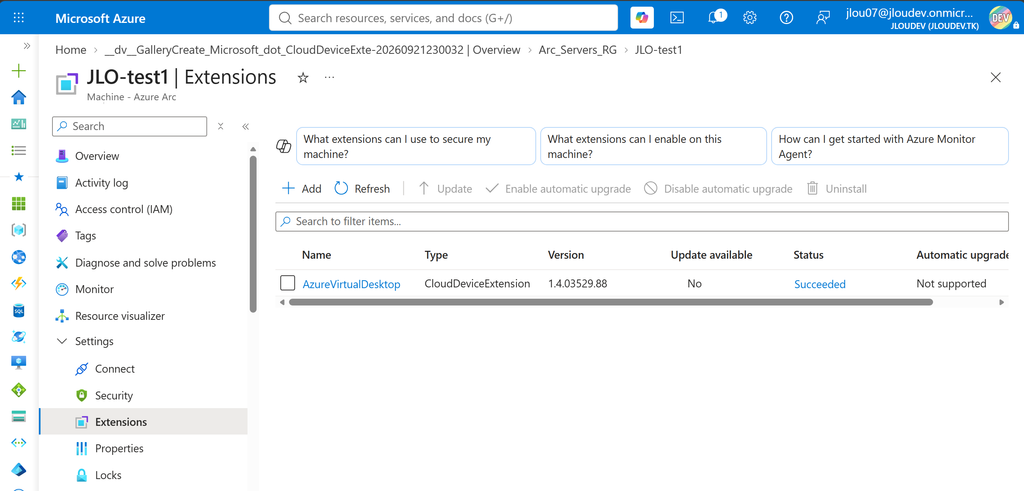
Dans la vue Extensions de la machine Arc, la colonne de statut de Microsoft.AzureVirtualDesktop.CloudDeviceExtension doit afficher Succeeded.
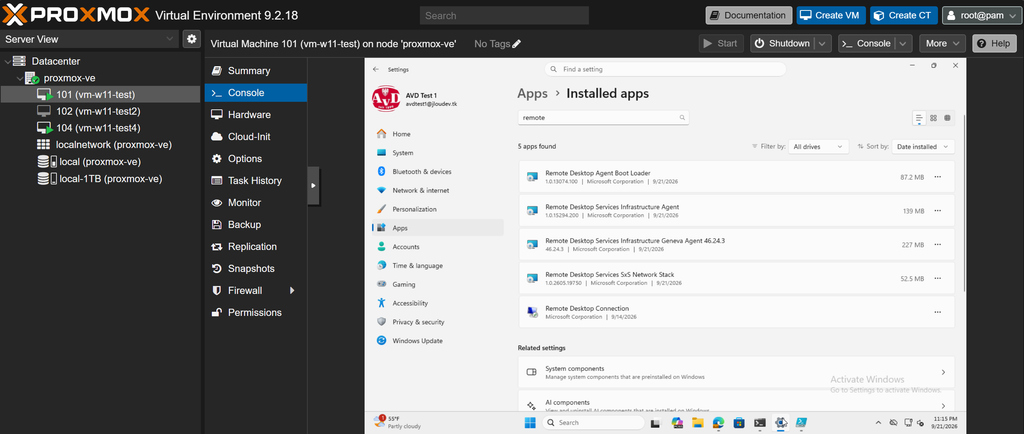
Les différentes applications commencent à faire leur apparition dans le gestionnaire des programmes Windows :
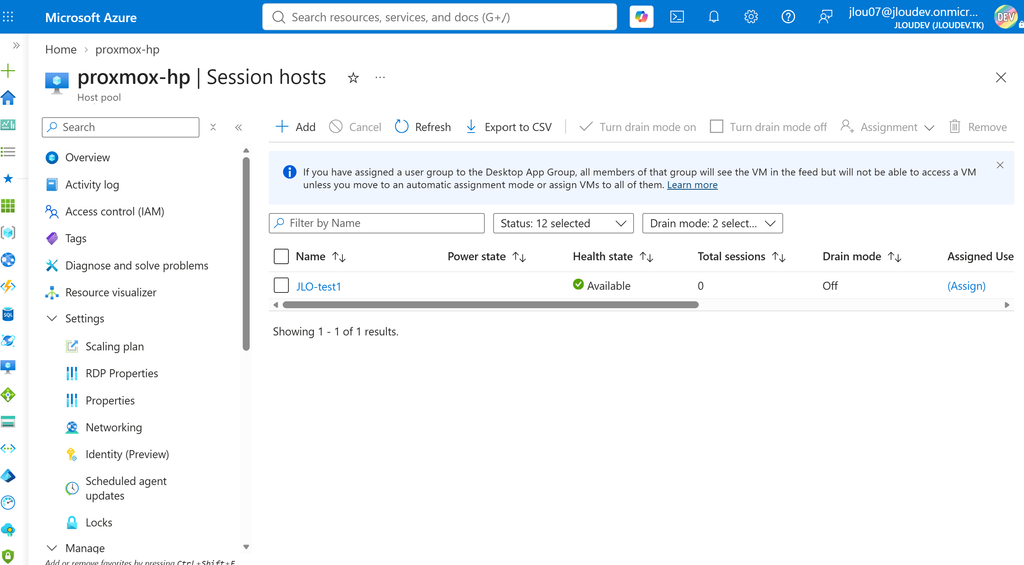
Puis, dans le host pool, la machine apparaît dans la liste Session hosts avec le statut Available :
Mon retour terrain : ne paniquez pas si le session host n’apparaît pas immédiatement après le Succeeded de l’extension. La documentation annonce jusqu’à quinze minutes de délai entre les deux, et c’est exactement le genre d’attente pendant laquelle on relance inutilement un script qui avait très bien fonctionné.
Attention : si vous partez sur le chemin PowerShell et obtenez une erreur du type machine introuvable, vérifiez Get-AzContext. Avec plusieurs abonnements rattachés au compte, l’applet va chercher la ressource Arc au mauvais endroit et le message d’erreur n’aide pas beaucoup. C’est le piège sur lequel j’avais déjà perdu du temps lors de mes premiers tests.
10. Étape 7 : assigner les utilisateurs et se connecter
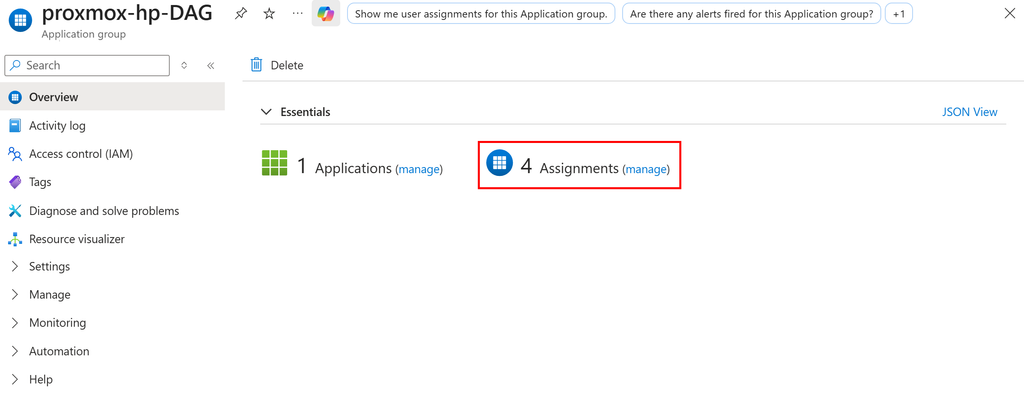
Dernière ligne droite. Ouvrez l’application group, allez dans Assignments et ajoutez l’utilisateur ou le groupe Entra qui doit pouvoir se connecter :
Puis, côté utilisateur, ouvrez la Windows App et connectez-vous avec ce compte. Le bureau publié par le host pool apparaît :
Cliquez, et le bureau s’ouvre :
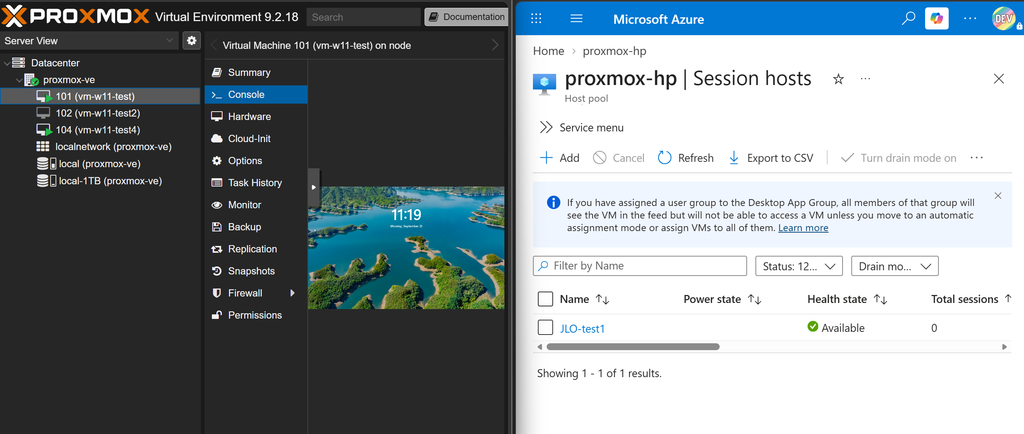
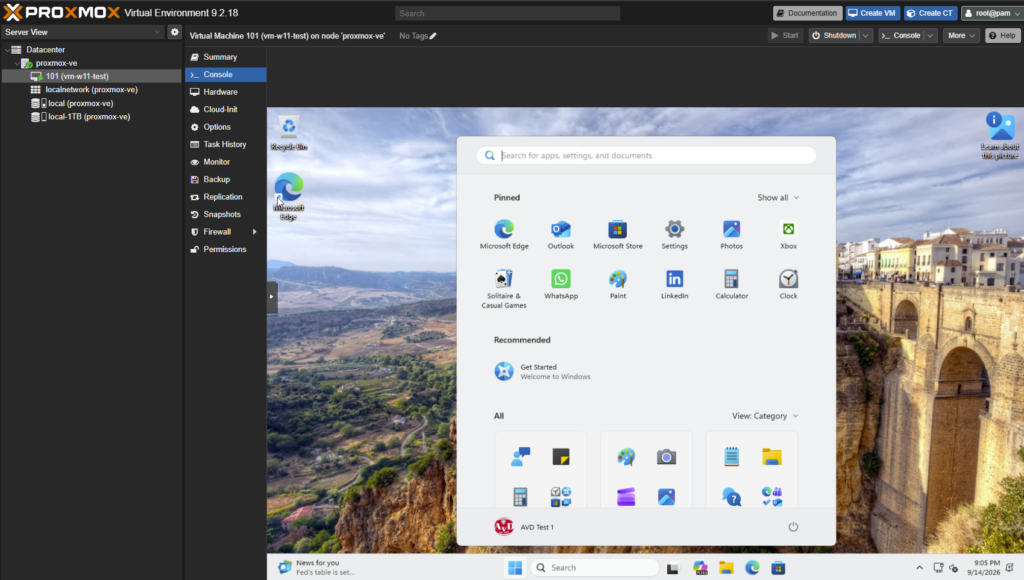
Pour le plaisir de la démonstration, ouvrez côté Proxmox la console de la même VM et regardez les deux écrans côte à côte. C’est la capture que je trouve la plus parlante de tout ce lab : le même Windows, vu par son hyperviseur et vu par le service AVD :
11. Ce qui change vraiment avec Proxmox
Après ce test, la réponse honnête est : presque rien du côté d’AVD, et un peu plus du côté de l’exploitation.
Sujet
Sur Hyper-V ou vSphere
Sur Proxmox
Enrôlement Arc
Script d’onboarding standard
Identique, l’agent ignore l’hyperviseur
Extension AVD
Depuis le portail, ou CloudDeviceExtension en PowerShell
Identique
Identité
Entra Join ou jointure de domaine
Identique, Entra Join testé ici
Connexion utilisateur
Windows App
Identique
Support Microsoft
Hyperviseurs nommés dans l’annonce
Non nommé, couvert par la formulation générale de l’aperçu
Les deux dernières lignes sont les seules qui demandent un vrai effort d’adaptation, et elles découlent toutes les deux d’une limite de la préversion : AVD hybride ne pilote ni l’alimentation ni le cycle de vie des machines. Ce n’est pas propre à Proxmox, c’est documenté.
Azure Virtual Desktop Hybrid doesn’t provision or manage virtual machine state, so the following capabilities aren’t supported: Power management, Autoscale, Start VM on Connect, Session Host Configuration.
Concrètement, si vous vouliez industrialiser, c’est du côté de Proxmox que se ferait le travail : un modèle de VM Windows préparé et généralisé, un clone par session host, et un script qui enchaîne l’enrôlement Arc et la pose de l’extension. La bonne nouvelle est que l’API de Proxmox se prête bien à l’exercice, la moins bonne est qu’aucun des partenaires cités au lancement de la préversion ne couvre Proxmox aujourd’hui.
Mon retour terrain : n’oubliez pas le QEMU guest agent sur vos session hosts, dont je parle dans le second article sur les pilotes VirtIO. Sans lui, l’ordre d’arrêt envoyé depuis Proxmox n’est pas relayé proprement au Windows, et vous finissez par couper l’alimentation d’une machine qui avait des sessions utilisateurs ouvertes. Sur un hôte AVD, c’est exactement ce qu’on ne veut pas.
12. Les pièges à retenir
Le piège
Le symptôme
La parade
Entra Join après l’enrôlement Arc
Session host qui ne s’enregistre pas correctement
Fixer l’identité avant de poser l’agent Arc, sinon désinstaller et recommencer
Microsoft.HybridConnectivity oublié
Enrôlement réussi mais échecs silencieux ensuite
Enregistrer les quatre resource providers avant de commencer
Identité managée sans rôle Reader
Session host qui ne devient jamais disponible
Assigner une identité managée au host pool et lui donner Reader sur le groupe de ressources Arc
Windows Server en Entra Join pur
Non supporté, dépendance au serveur de licences RDS
Jointure AD ou hybride pour un Windows Server, Entra Join réservé au client
Impatience après le Succeeded
On relance un script qui avait marché
Attendre jusqu’à quinze minutes avant de conclure à un échec
isCloudDevice absent ou à $true
L’extension se pose mais n’enregistre rien
Passer explicitement isCloudDevice = $false
Mauvais abonnement dans le contexte
Erreur de machine introuvable
Vérifier Get-AzContext après le Set-AzContext
Sortie 443 bloquée par le NAT
L’agent Arc n’arrive pas à se connecter
Vérifier la chaîne forward nftables et le routage IPv4 sur le nœud
Windows 11 multi-session
Non éligible hors Azure
Mono-session, ou Windows Server avec le rôle RDS
Pas de guest agent sur le session host
Arrêts brutaux depuis Proxmox
Installer le QEMU guest agent sur chaque session host
Clé d’enregistrement expirée
L’extension échoue à enregistrer la machine
Générer le token juste avant de lancer le script
Conclusion
Voilà, en sept étapes, une machine Windows 11 qui tourne dans Proxmox et qui se comporte comme un session host Azure Virtual Desktop à part entière, avec sa Windows App, son identité Entra et son host pool dans le portail.
Concrètement, ça donne quoi ? Ça confirme ce que je pressentais en écrivant mon article sur AVD hybride : la mécanique ne s’intéresse pas à votre hyperviseur. Azure Arc parle à un Windows, l’extension AVD parle à Azure Arc, et ce qu’il y a en dessous est votre affaire. Microsoft a nommé quatre plateformes dans son annonce, mais la formulation de l’aperçu est délibérément plus large, et le test le vérifie.
Les trois points que je retiens : la procédure est strictement celle des autres hyperviseurs, sans le moindre ajustement ; l’Entra Join pur reste le chemin le plus court, surtout derrière un réseau NAT où un contrôleur de domaine aurait compliqué les choses ; et l’absence de gestion d’alimentation, qui est une limite de la préversion et pas de Proxmox, est ce qui demanderait le plus de travail si on voulait industrialiser.
Foncez tester, et dites-moi en commentaire si vous l’avez fait sur un hyperviseur encore différent. La dernière fois que j’ai posé la question, personne n’avait essayé Proxmox, alors j’ai fini par m’en charger.
🤖
Contenu assisté par IACet article a été rédigé avec l’assistance d’une intelligence artificielle et relu par l’auteur. Conformément à l’AI Act (UE) en vigueur depuis le 2 août 2026.
Proxmox, vous en entendez parler partout depuis quelques mois, vous savez vaguement que c’est un hyperviseur open source qui monte, mais vous n’avez jamais mis les mains dedans ? Cet article est fait pour vous. On part d’un abonnement Azure et d’un portail vide, et on va dérouler, capture après capture, jusqu’à un bureau Windows 11 qui tourne dans Proxmox VE, lui-même hébergé dans une machine virtuelle Azure.
Je suis MVP Microsoft depuis 2024, je passe mes journées dans Azure, AVD/Windows 365 ou Copilot, mais regarder ce que fait le reste du monde m’a jamais fait de mal. Azure est d’ailleurs le lab le plus rapide à monter pour ça : pas de serveur à acheter, pas de clé USB à graver, pas de machine à démonter dans le garage. Une VM, une soirée devant vous, et vous supprimez le groupe de ressources à la fin.
Il existe déjà beaucoup de vidéos YouTube qui vous montrent Proxmox :
Ce que je voulais avoir pour tester de mon côté, c’était un premier-à-pas complet sur Azure, avec les vrais pièges du réseau imbriqué et les écrans que vous allez réellement voir. C’est ce que vous trouverez ci-dessous, avec en prime les concepts Proxmox expliqués avec des mots d’admin Azure.
Windows 11 tourne dans Proxmox VE, qui tourne lui-même dans une machine virtuelle Azure.
Pour vous guider plus facilement dans cet article, voici des liens rapides :
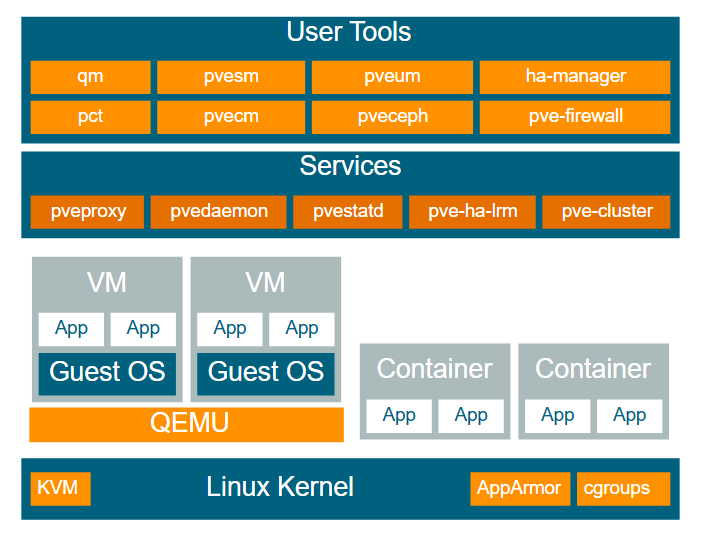
Proxmox VE, c’est une distribution Debian sur laquelle l’éditeur autrichien Proxmox Server Solutions a posé trois choses : KVM pour les machines virtuelles complètes, LXC pour les conteneurs système, et une interface web qui pilote le tout sur le port 8006. Pas d’agent à installer sur un poste d’administration, pas de console lourde : un navigateur suffit.
Le vocabulaire est la première marche à franchir, parce qu’il ressemble à celui que vous connaissez sans vouloir dire exactement la même chose.
Le nœud est un serveur qui exécute Proxmox VE. Dans cet article, il s’appelle proxmox-ve et il n’y en a qu’un.
Le datacenter n’est pas un bâtiment, c’est le niveau logique au-dessus des nœuds. C’est là que l’on déclare les stockages, les utilisateurs, les permissions, les sauvegardes et les règles de pare-feu communes.
Le cluster réunit plusieurs nœuds qui partagent leur configuration à travers un système de fichiers répliqué, pmxcfs, monté sur /etc/pve. Sur un nœud isolé comme ici, le service tourne quand même : c’est pour ça que pve-cluster doit être actif même sans cluster.
Le stockage se déclare au niveau du datacenter, avec un type (Directory, LVM, ZFS, NFS, Ceph, et d’autres) et une liste de contenus autorisés (ISO, disques de VM, sauvegardes, modèles de conteneurs).
Le bridge, nommé vmbr0, vmbr1 et ainsi de suite, est un commutateur Linux auquel on raccorde les cartes réseau des invités.
Enfi, si vous venez du monde Microsoft, la table de correspondance suivante vous évitera de traduire mentalement à chaque écran :
Objet Proxmox
Ce que c’est
L’équivalent que vous connaissez
Datacenter
Le niveau logique qui regroupe nœuds, stockages et utilisateurs
La console de gestion, le périmètre d’administration
Nœud
Un serveur qui exécute Proxmox VE
Un hôte Hyper-V
Cluster
Plusieurs nœuds qui partagent leur configuration
Un cluster de basculement
Stockage
Un emplacement déclaré, avec des types de contenus autorisés
Un volume partagé de cluster, un partage SMB
vmbr0
Un commutateur Linux pour les cartes des invités
Un commutateur virtuel Hyper-V
QEMU / KVM
Une machine virtuelle complète, avec son BIOS ou son UEFI
Une VM Hyper-V de génération 1 ou 2
LXC
Un conteneur système qui partage le noyau de l’hôte
Un conteneur Windows en mode process
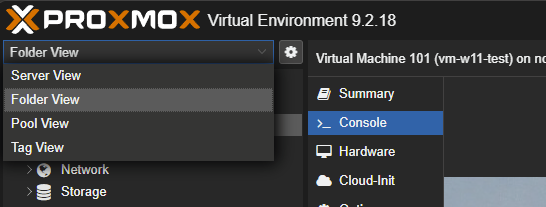
Mon retour terrain : ne cherchez pas l’équivalent d’un groupe de ressources ou d’une souscription dans Proxmox : il n’y en a pas. La séparation se fait avec les pools de ressources et les permissions, pas avec une hiérarchie de conteneurs de facturation. Au mieux, il existe différentes vues possibles
2. Pourquoi le tester sur Azure, et ce que ça implique
Pour faire tourner Proxmox, il faut un processeur qui expose ses extensions de virtualisation. Dans une VM Azure, cela s’appelle la virtualisation imbriquée, et toutes les tailles ne la proposent pas. La série que j’ai utilisée ici, la Dsv3, la prend en charge, tout comme le stockage Premium dont on a besoin pour le disque de données.
La même page documente la taille que j’ai prise, Standard_D16s_v3, avec ses 16 processeurs virtuels et ses 64 Gio de mémoire. C’est confortable, et c’est surtout ce qui permet de donner 8 Gio et 2 cœurs à une VM Windows 11 sans que la machine hôte ne s’écroule.
Pour rappel, jusqu’ici, monter un lab Proxmox voulait dire trouver une machine physique. Là, il vous faut un abonnement, une taille de VM correcte, et une heure.
Attention : cette taille n’est pas gratuite. Le portail affichait 700,80 $ par mois sur ma capture, ce qui fait à peu près 1 $ de l’heure. Arrêtez et désallouez la VM dès que vous avez fini de jouer, et supprimez le groupe de ressources quand le lab ne sert plus. La facture d’un lab oublié est le pire souvenir que l’on puisse ramener d’un article de blog.
Trois limites à connaître avant de commencer, pour ne pas les découvrir en cours de route : le réseau des invités ne pourra pas être ponté directement sur la carte Azure, il faudra passer par du NAT, on y revient en détail plus bas ; les performances resteront celles d’un hyperviseur dans un hyperviseur, donc correctes pour un lab et pas pour de la production ; et un cluster Proxmox multi-nœuds sur Azure demanderait un travail supplémentaire, la découverte du cluster reposant sur des mécanismes réseau que le cloud n’aime pas beaucoup.
3. Étape 0 : les pré-requis
Avant de continuer les étapes de cet article, assurez-vous que vous disposez bien d’une souscription Azure active.
4. Étape 1 : créer la machine virtuelle Azure
Rien d’exotique dans cet assistant, mais quatre champs méritent votre attention.
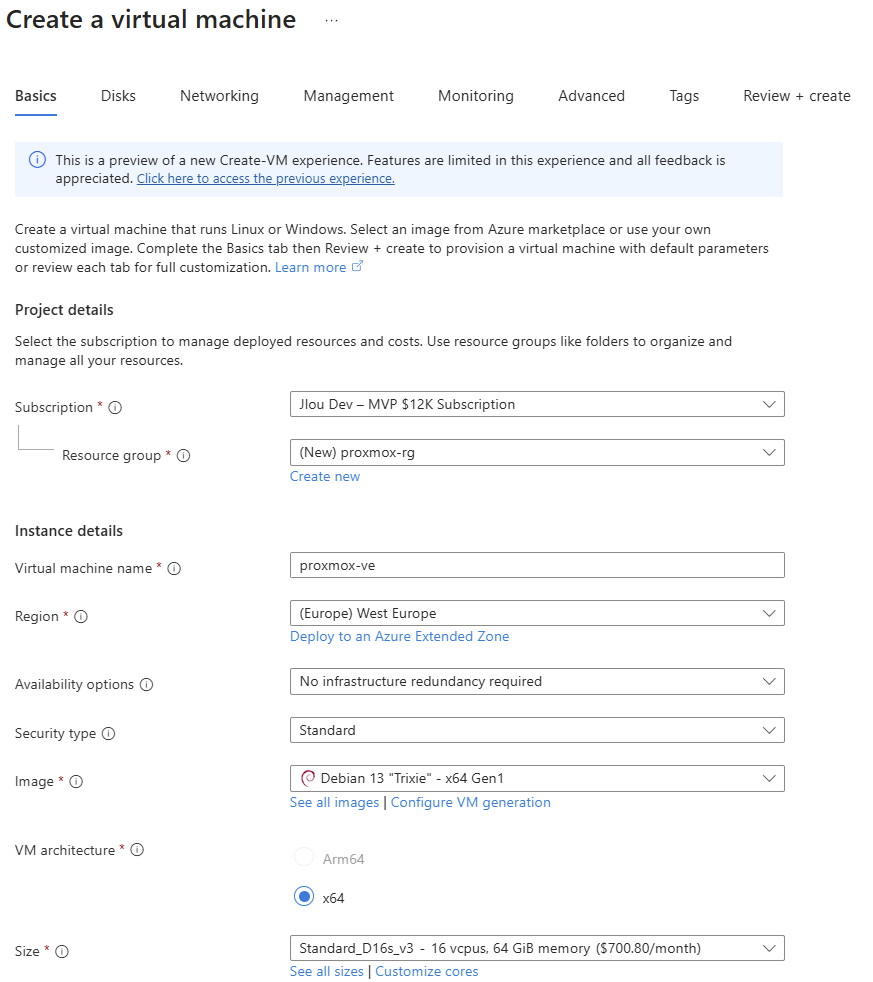
Dans Project details, créez un groupe de ressources dédié. Le mien s’appelle proxmox-rg : tout sera dedans, donc tout partira en une seule suppression.
Dans Instance details, nommez la VM proxmox-ve, choisissez votre région, laissez Security type sur Standard et prenez l’image Debian 13 « Trixie » x64 Gen1.
Dans Size, sélectionnez Standard_D16s_v3. C’est le champ le plus important de tout l’assistant.
La taille Standard_D16s_v3 et son étiquette de prix mensuelle. C’est elle qui conditionne tout le reste.
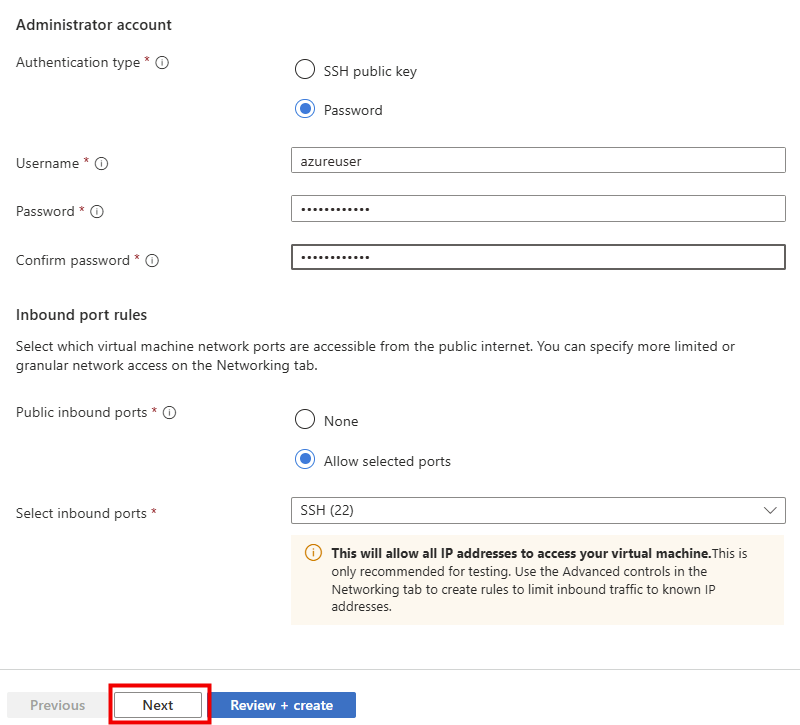
Dans Administrator account, j’ai gardé l’authentification par mot de passe avec l’utilisateur. La clé SSH reste évidemment le bon choix si vous comptez garder la machine.
Dans Public inbound ports, choisissez Allow selected ports puis SSH (22). Le portail vous prévient que la règle sera ouverte à tout Internet : on la resserrera à l’étape suivante.
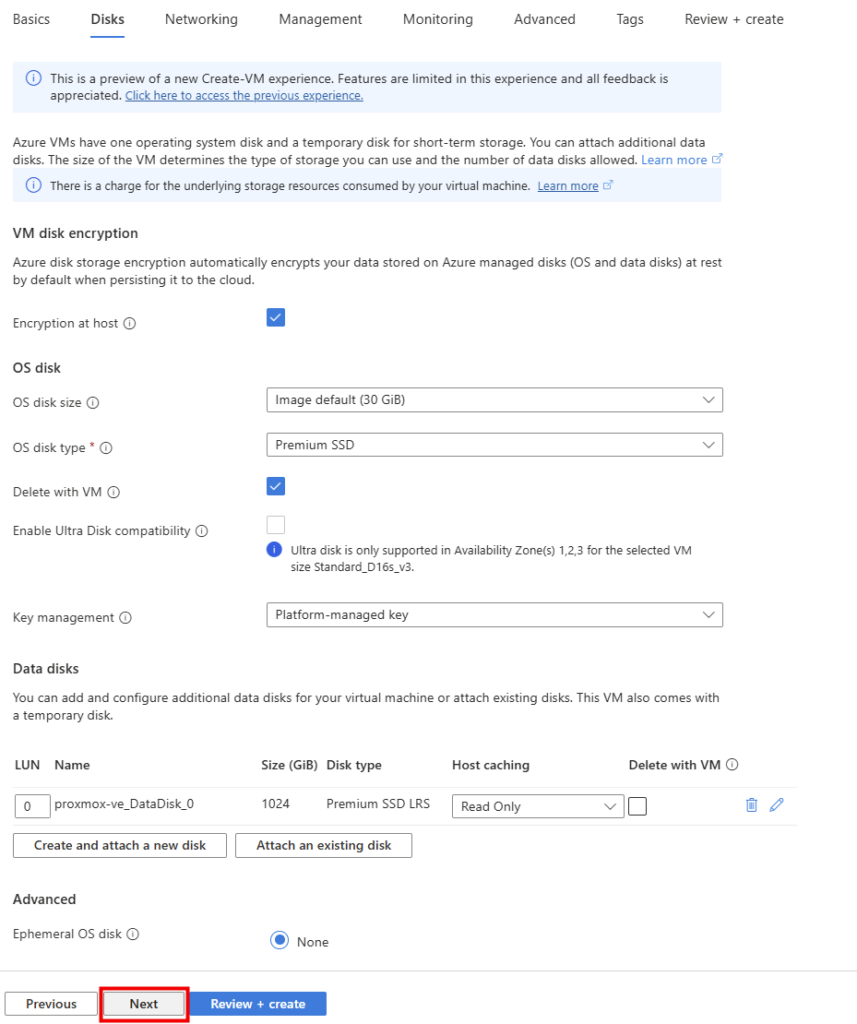
L’onglet Disks est celui qui prépare le stockage des futures VM. Le disque système de 30 Gio suffit largement pour Debian et les paquets Proxmox, mais il ne suffira pas pour les disques des invités.
Laissez le disque OS à Image default (30 GiB) en Premium SSD.
Cliquez sur Create and attach a new disk et créez un disque de 1024 Gio en Premium SSD LRS. C’est lui qui deviendra local-1TB dans Proxmox.
Le disque de données de 1 To deviendra le stockage local-1TB de Proxmox.
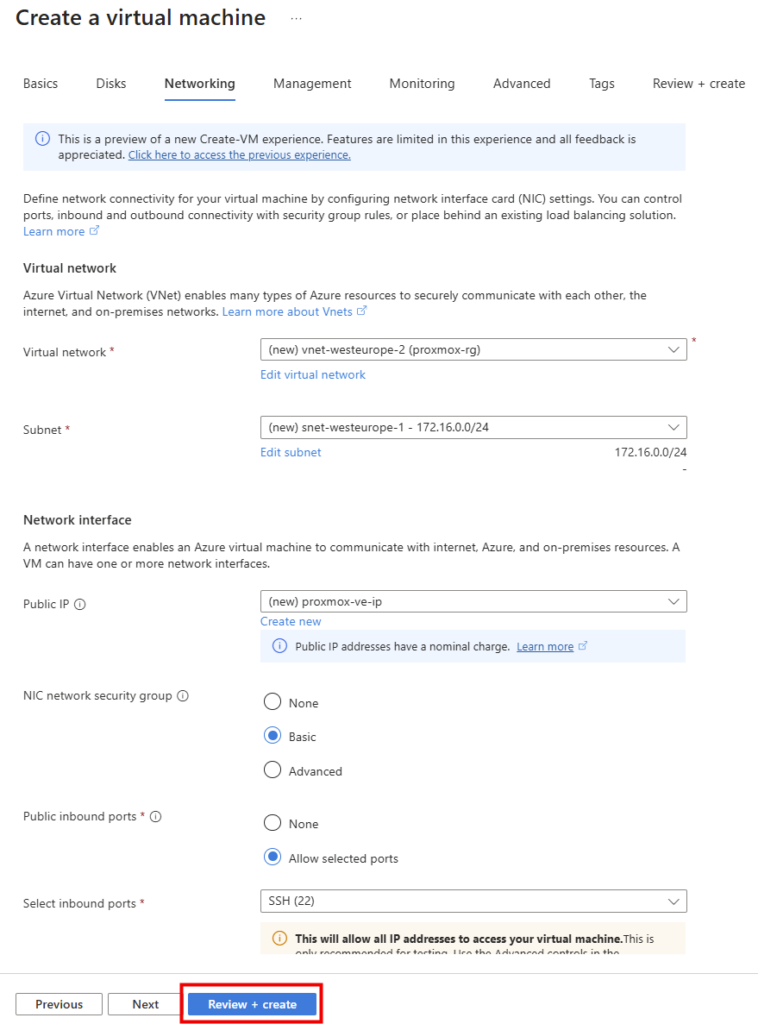
L’onglet Networking se contente des valeurs par défaut : un réseau virtuel neuf, un sous-réseau en 172.16.0.0/24, une adresse IP publique et un groupe de sécurité réseau en mode Basic. Retenez bien le plan d’adressage du sous-réseau, il ne devra surtout pas chevaucher le réseau interne que l’on créera dans Proxmox.
Lancez la création, prenez un café, et récupérez l’adresse IP publique dans la vue d’ensemble de la VM.
5. Étape 2 : ouvrir le port 8006 dans le NSG
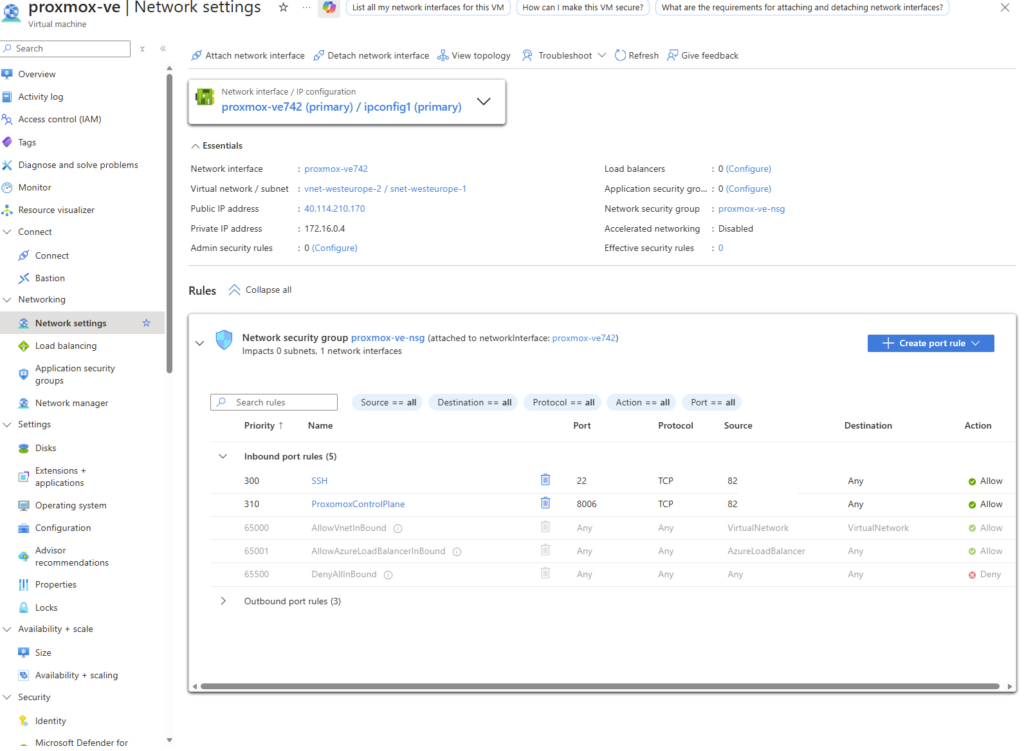
L’interface web de Proxmox écoute en HTTPS sur le port 8006. Comme ce port n’existe dans aucun modèle du portail, il faut ajouter la règle à la main dans le groupe de sécurité réseau de la carte.
Ouvrez la VM, puis Networking et Network settings.
Cliquez sur Create port rule puis Inbound port rule.
Source : IP Addresses, et saisissez votre adresse IP publique. Destination : Any. Port de destination : 8006. Protocole : TCP. Action : Allow. Nommez la règle, la mienne s’appelle ProxmoxControlPlane.
Profitez-en pour resserrer la règle SSH sur la même source.
Les deux seules règles entrantes qui comptent, chacune limitée à mon adresse IP publique.
Attention : n’ouvrez jamais 8006 en source Any. Vous exposeriez à Internet une console d’administration d’hyperviseur avec un formulaire de connexion root, et les robots d’analyse de ports mettent quelques minutes à la trouver. Source restreinte, ou Azure Bastion, ou rien.
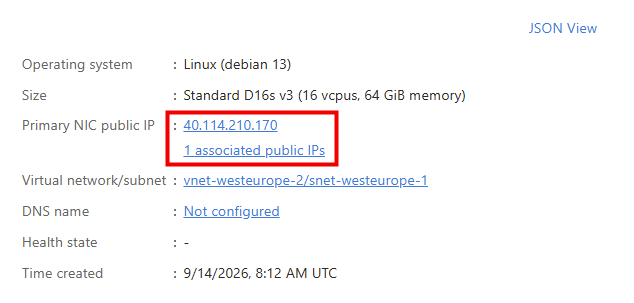
Gardez l’adresse IP publique sous la main, elle apparaît dans les propriétés de la machine.
L’adresse IP publique, à saisir dans le navigateur avec le port 8006.
6. Étape 3 : vérifier la virtualisation imbriquée et préparer Debian
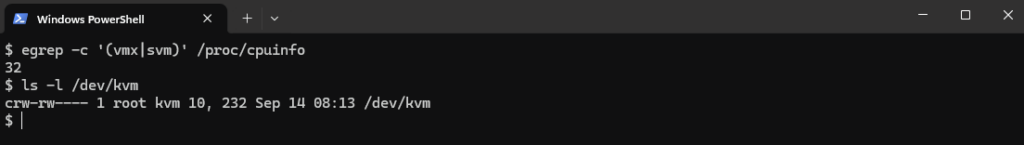
Connectez-vous en SSH sur l’adresse publique, avec le compte azureuser. Première chose à faire, avant même de penser à installer quoi que ce soit : vérifier que le processeur expose bien ses extensions de virtualisation et que le périphérique KVM existe.
egrep -c '(vmx|svm)' /proc/cpuinfo
ls -l /dev/kvm
La première commande doit renvoyer un nombre supérieur à zéro, 32 dans mon cas, ce qui correspond aux cœurs logiques qui exposent vmx. La seconde doit afficher le périphérique /dev/kvm. Si l’une des deux échoue, inutile d’aller plus loin : votre taille de VM ne prend pas en charge la virtualisation imbriquée, changez-la.
Le moment de vérité. Les extensions de virtualisation sont exposées et /dev/kvm est bien là.
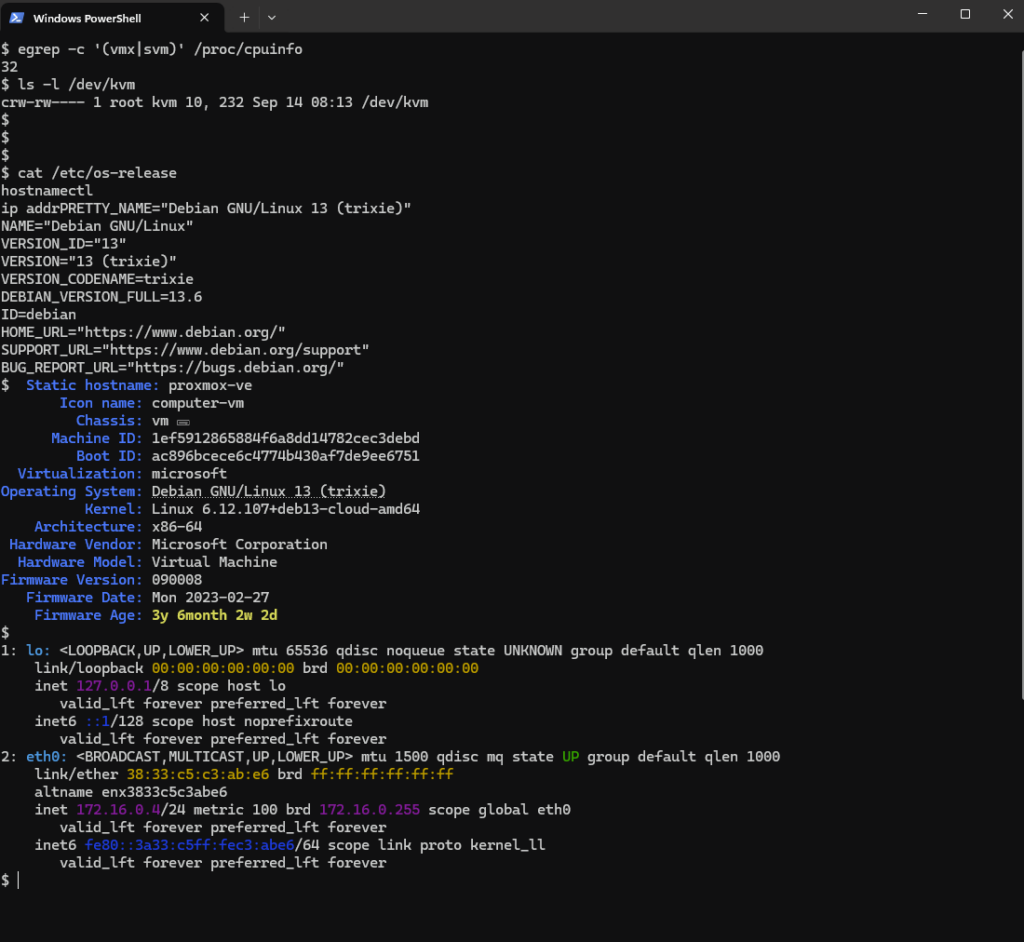
On regarde ensuite dans quoi on met les pieds :
cat /etc/os-release
hostnamectl
ip addr
hostnamectl confirme Virtualization: microsoft, autrement dit on tourne déjà dans un hyperviseur.
Trois informations à retenir de cet écran : la distribution est bien une Debian 13 « Trixie », hostnamectl annonce Virtualization: microsoft puisque nous sommes déjà invités d’un hyperviseur, et la carte eth0 porte l’adresse privée 172.16.0.4.
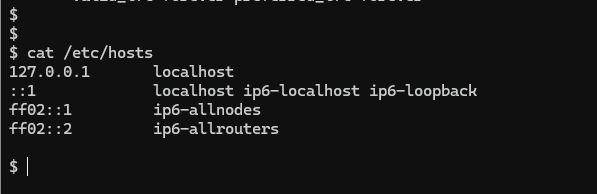
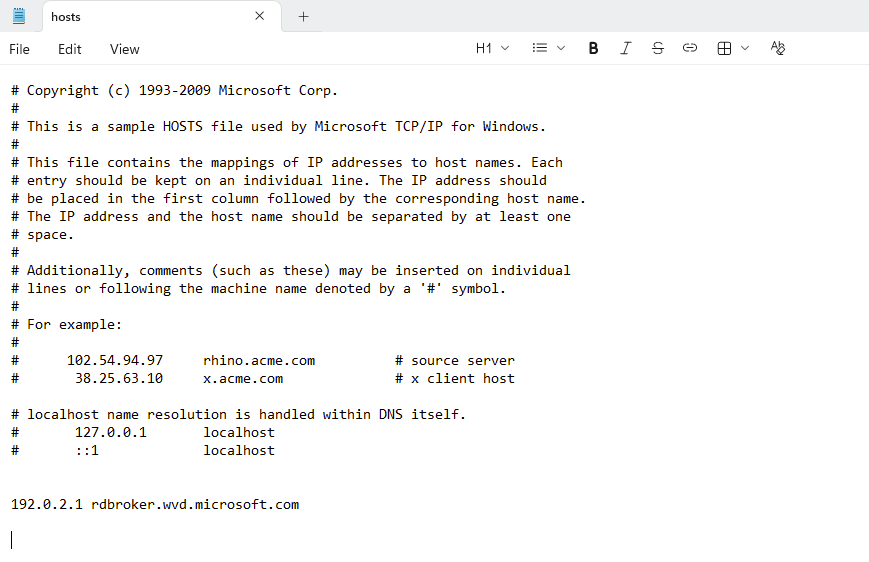
Vient ensuite la manipulation la plus discrète et la plus importante de tout l’article. Par défaut, le fichier /etc/hosts d’une image Azure ne contient pas de ligne associant le nom d’hôte à l’adresse IP privée.
cat /etc/hosts
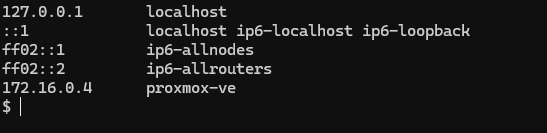
Il faut ajouter cette ligne, avec votre adresse privée et votre nom d’hôte, avant d’installer Proxmox.
echo '172.16.0.4 proxmox-ve' | sudo tee -a /etc/hosts
La ligne qui manque presque toujours et qui fait échouer l’installation.
Attention : cette étape n’est pas cosmétique. Proxmox VE résout le nom du nœud au démarrage de pve-cluster pour construire l’arborescence de /etc/pve. Si le nom d’hôte ne se résout pas vers l’adresse privée, l’installation se passe mal et l’interface web refuse de s’afficher correctement. Adaptez l’adresse et le nom à votre machine.
7. Étape 4 : installer Proxmox VE 9
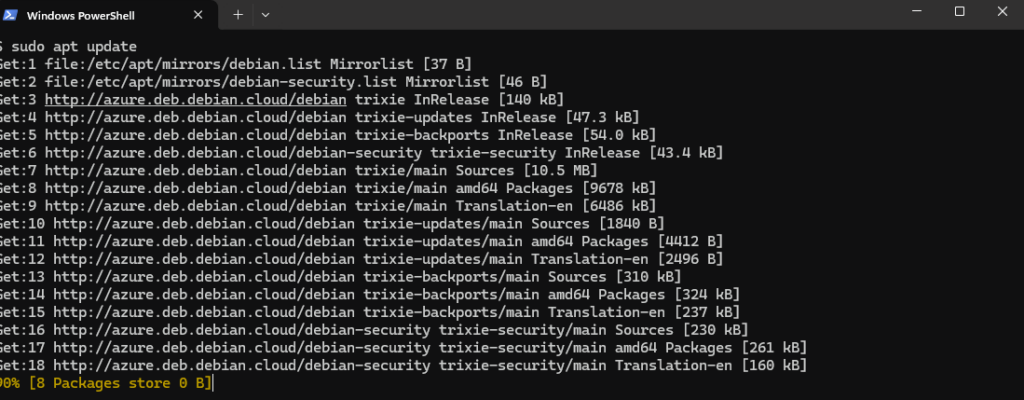
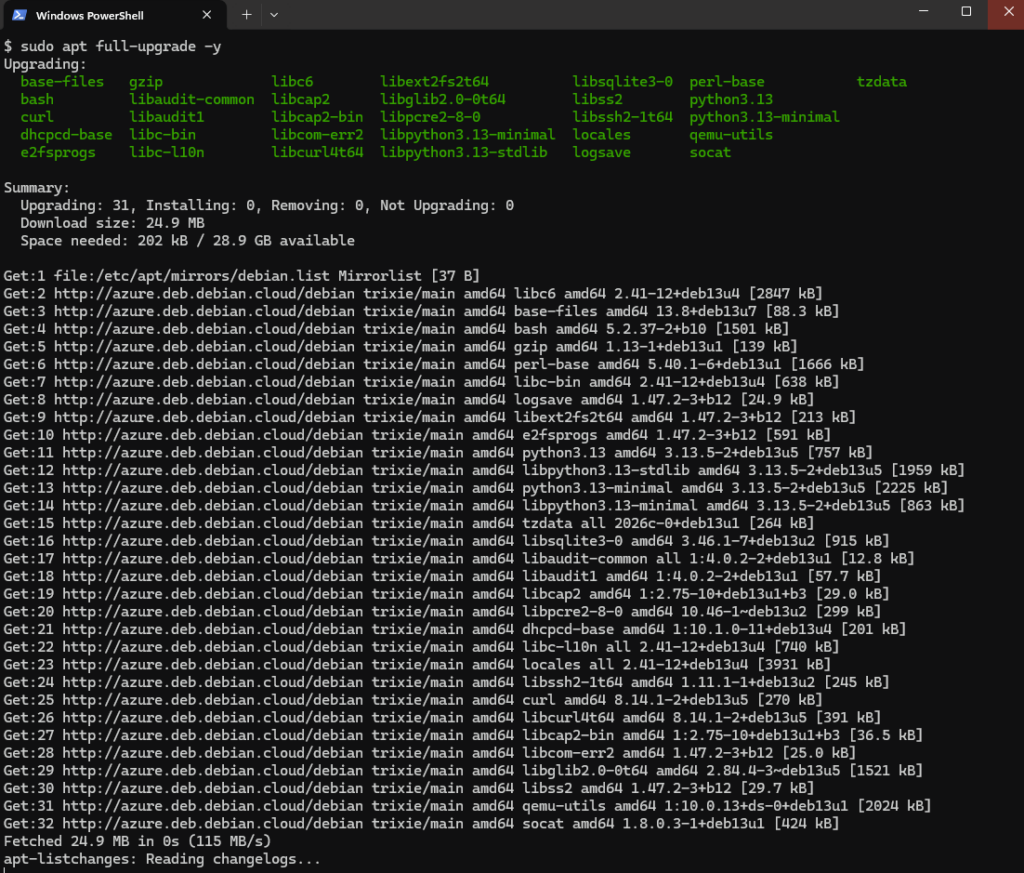
On commence par mettre la Debian à niveau. Les images Azure sont propres, mais rarement à jour au jour près.
sudo apt update
sudo apt full-upgrade -y
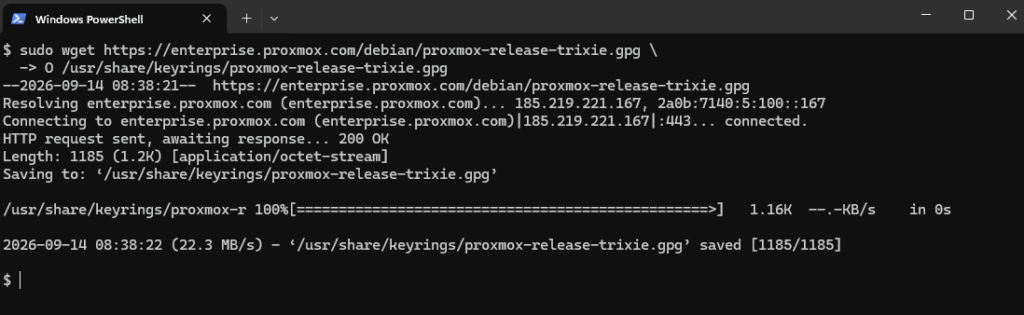
On ajoute ensuite la clé de signature du dépôt Proxmox pour Debian 13.
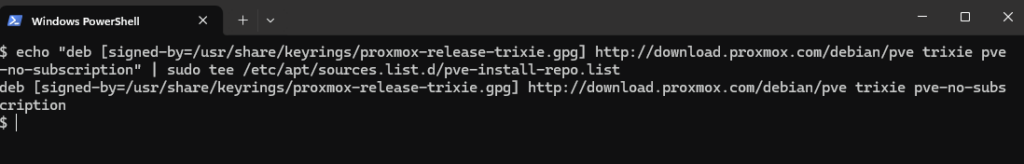
Puis le dépôt lui-même. J’utilise ici pve-no-subscription, celui qui ne demande pas de clé d’abonnement.
echo "deb [signed-by=/usr/share/keyrings/proxmox-release-trixie.gpg] http://download.proxmox.com/debian/pve trixie pve-no-subscription" | sudo tee /etc/apt/sources.list.d/pve-install-repo.list
Attention : le dépôt pve-no-subscription n’est pas destiné à la production. Il reçoit les paquets avant le dépôt entreprise et sert justement aux labs et aux tests. Pour une plateforme sérieuse, prenez un abonnement Proxmox et le dépôt qui va avec.
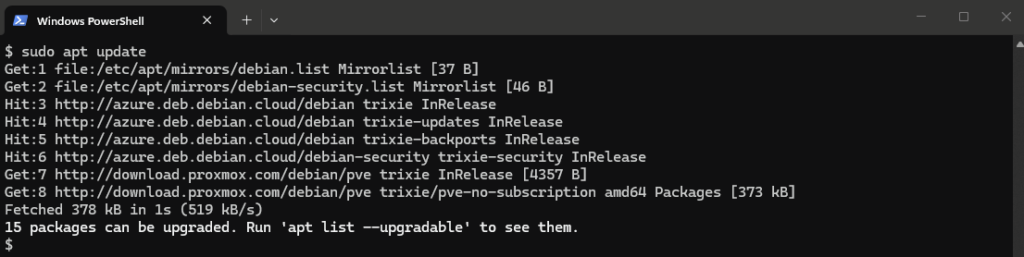
sudo apt update
Le dépôt Proxmox répond. On peut installer.
Place à l’installation !
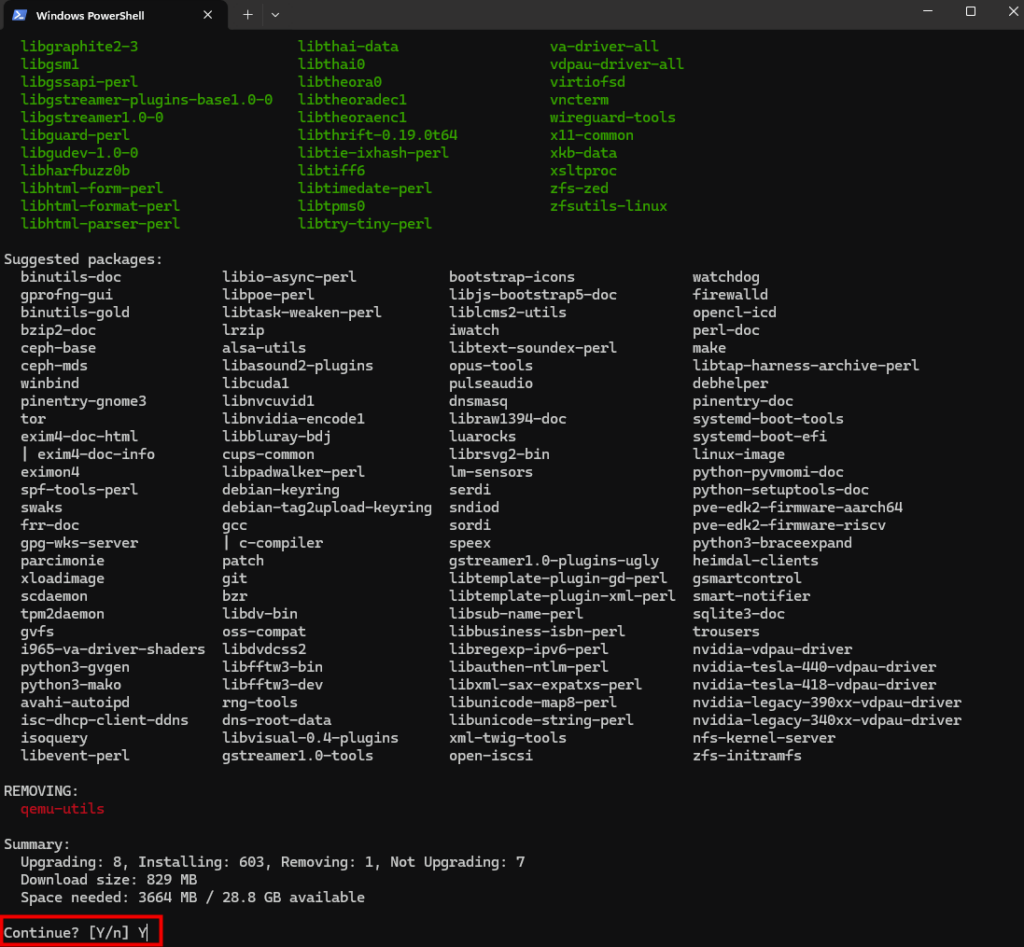
sudo apt install proxmox-ve
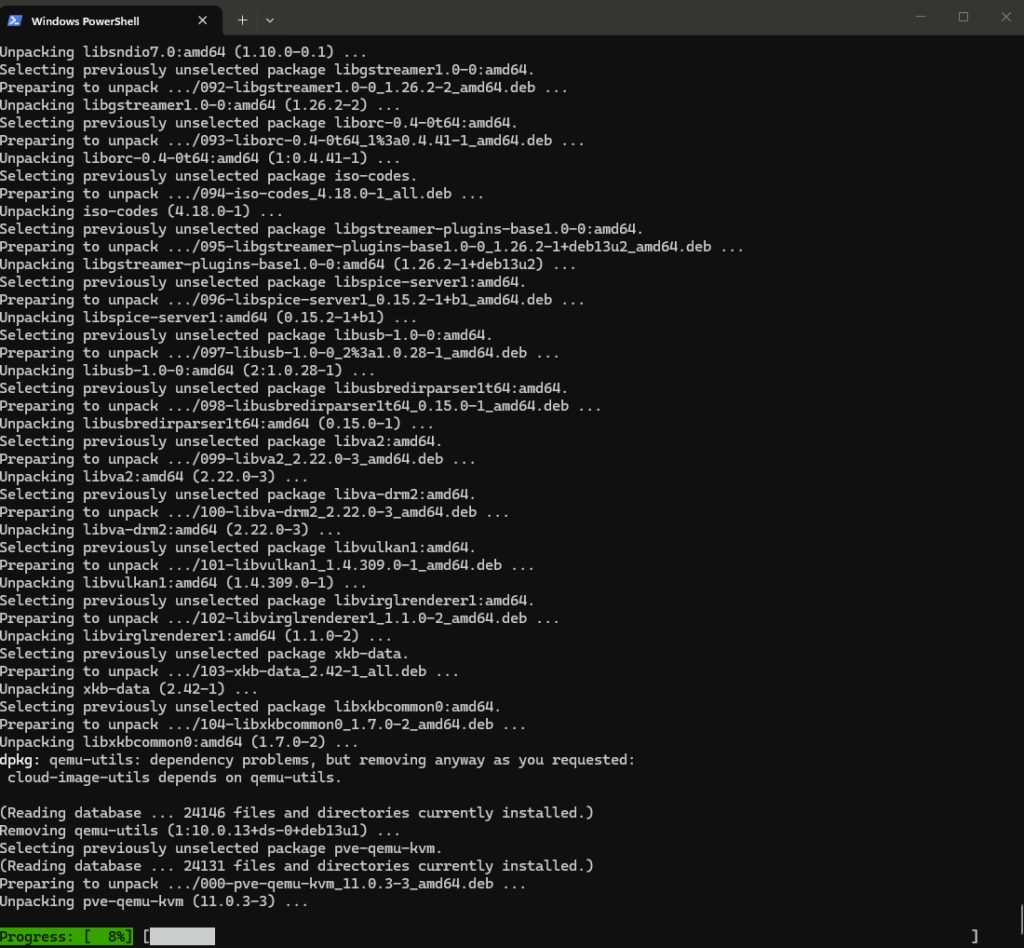
APT annonce la couleur : 603 paquets à installer, 829 Mo à télécharger, 3,6 Go d’espace disque. On valide et on laisse travailler.
603 paquets et 3,6 Go sur le disque. Proxmox VE, ce n’est pas un petit paquet.
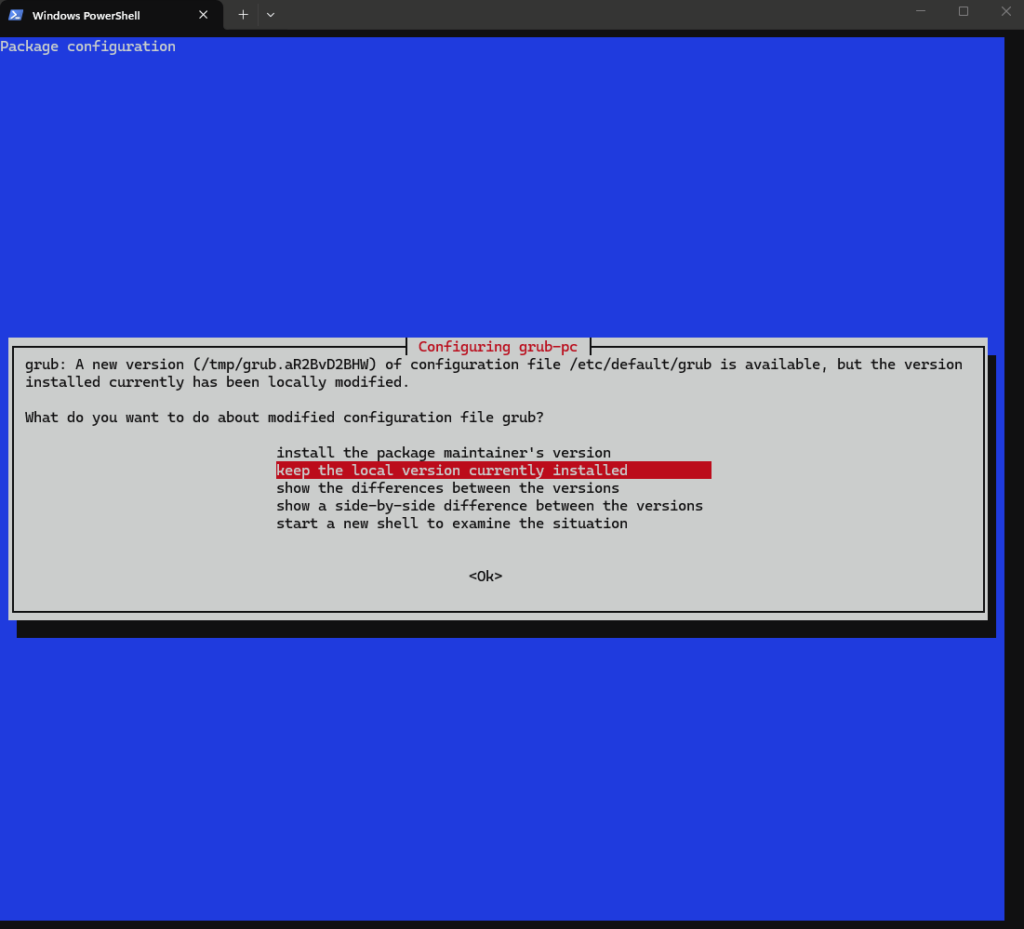
En cours de route, deux écrans bleus de configuration de paquet vont vous interrompre. Ils méritent chacun une réponse réfléchie.
Le premier concerne /etc/default/grub, qu’Azure a modifié pour la console série. Choisissez keep the local version currently installed :
Gardez la version locale. C’est celle qu’Azure a préparée pour votre VM.
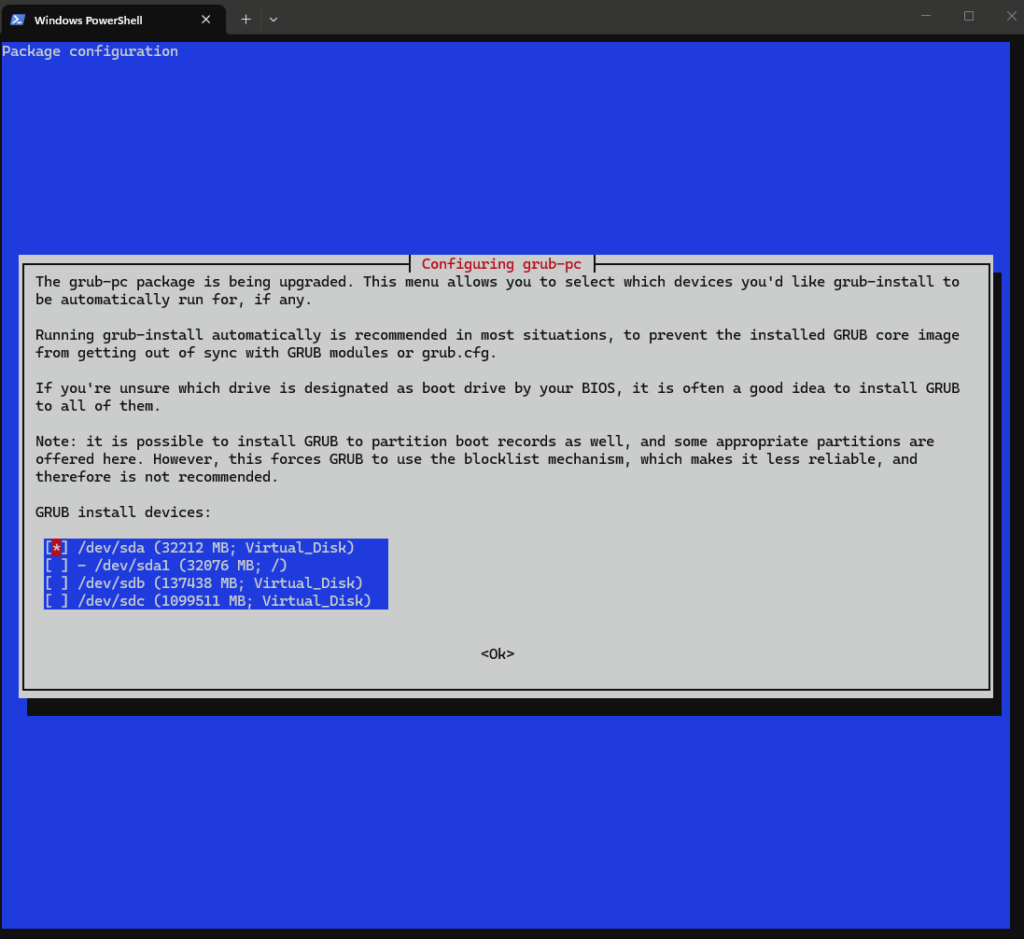
Le second demande sur quel périphérique installer GRUB. Cochez /dev/sda, le disque système, et rien d’autre.
On coche /dev/sda uniquement, surtout pas le disque de données.
Attention : ne cochez surtout pas /dev/sdc dans cet écran. C’est votre disque de données de 1 To, il n’a rien à faire dans la chaîne de démarrage.
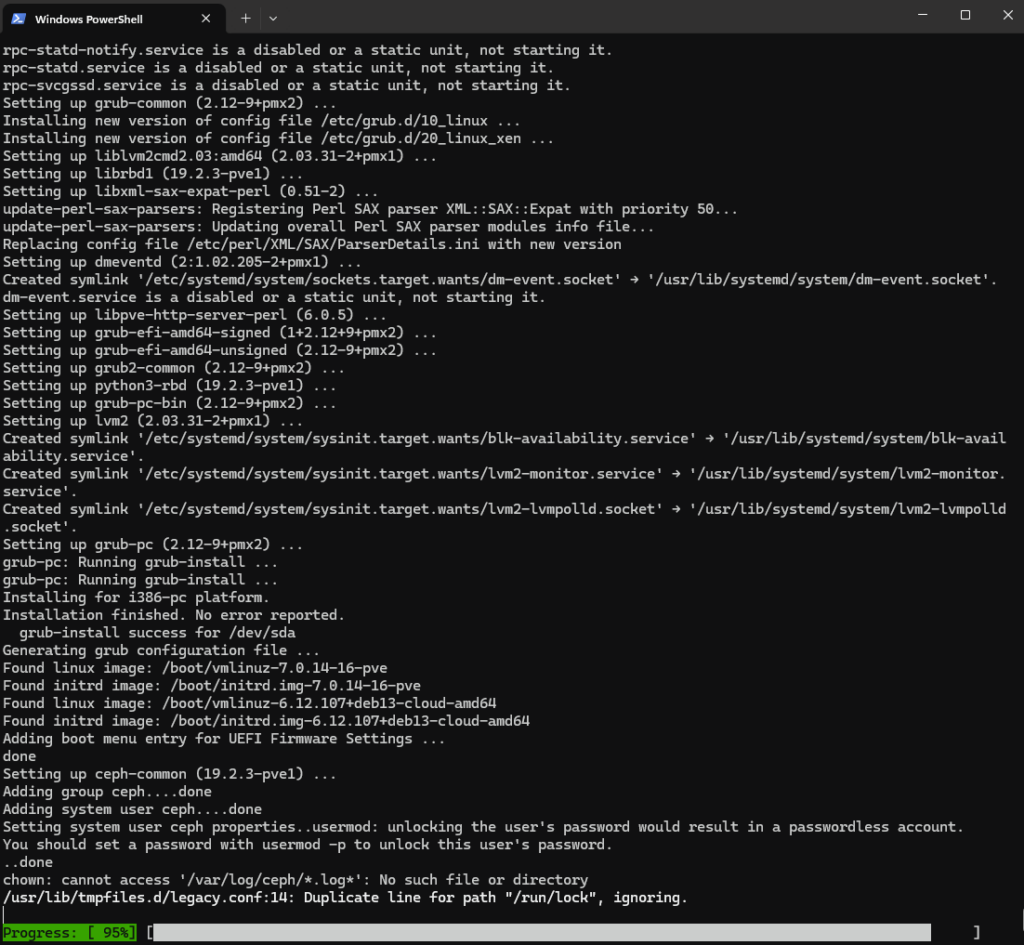
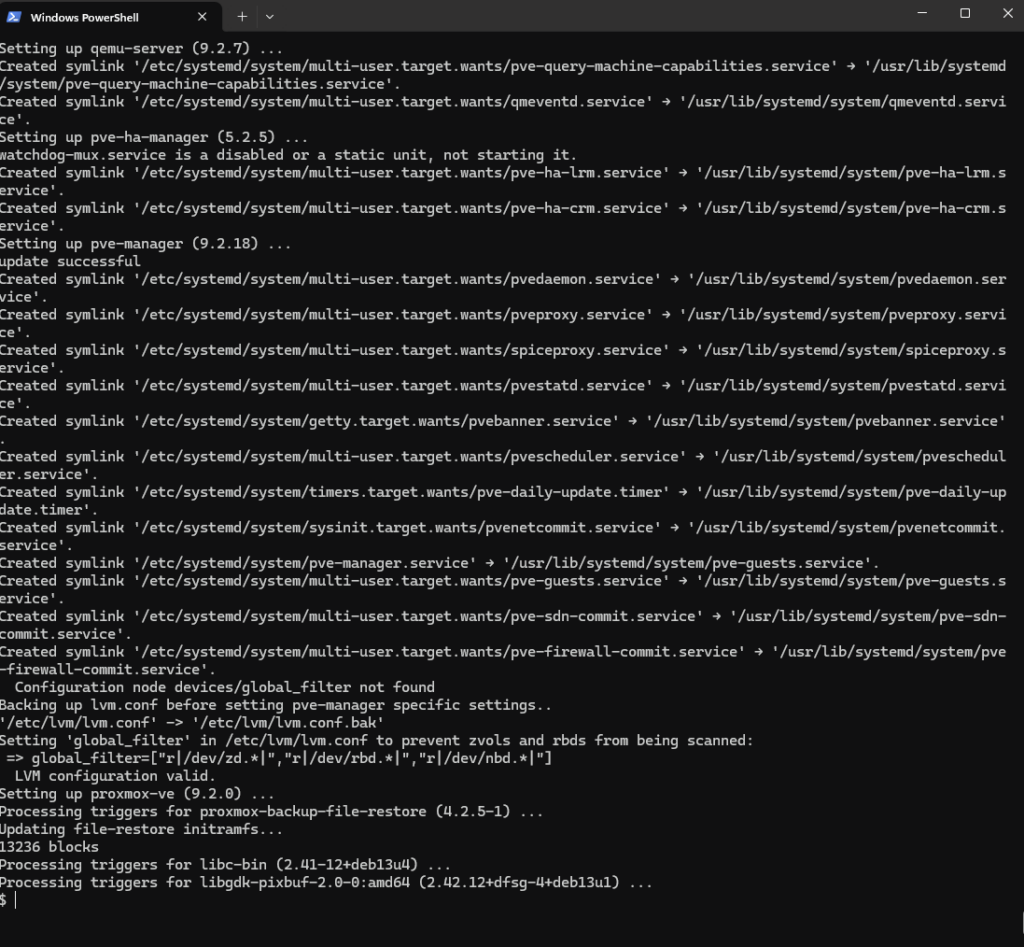
La fin de l’installation défile ensuite toute seule, avec la génération de la configuration GRUB et la mise en place des services Proxmox.
Le noyau pve apparaît dans la liste. Bon signe.
8. Étape 5 : vérifier que les services répondent
Avant de toucher au stockage et au réseau, on vérifie que les trois services principaux sont bien démarrés. C’est aussi une bonne occasion de comprendre qui fait quoi.
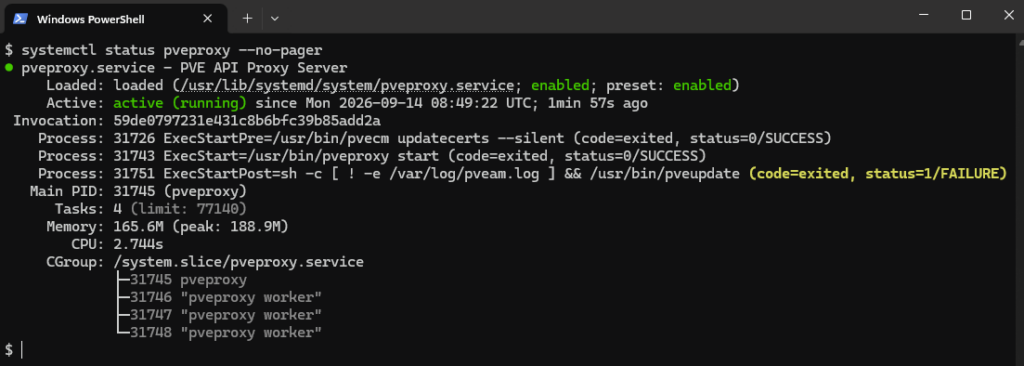
pveproxy est le serveur d’API et le frontal web, celui qui écoute sur 8006.
systemctl status pveproxy --no-pager
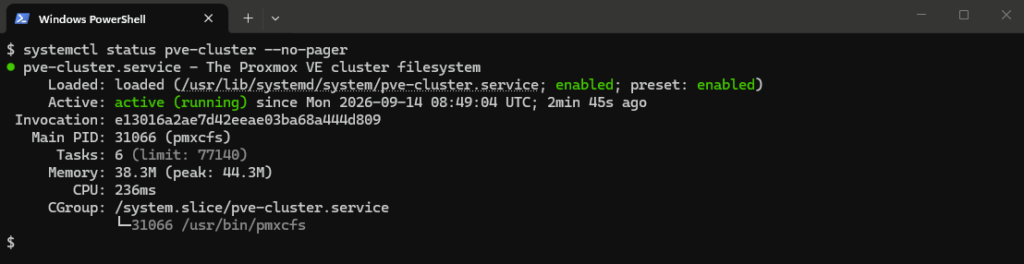
pve-cluster porte le système de fichiers de configuration pmxcfs, monté sur /etc/pve. Même sur un nœud isolé, s’il ne tourne pas, rien ne fonctionne.
systemctl status pve-cluster --no-pager
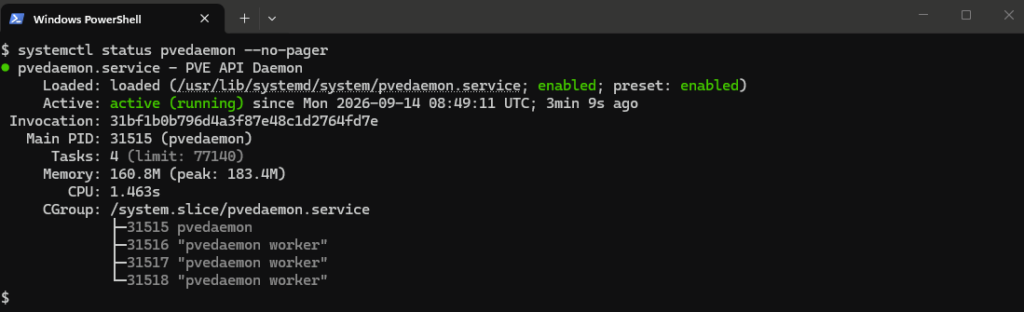
pvedaemon exécute les tâches demandées par l’API, du démarrage d’une VM à la création d’un disque.
systemctl status pvedaemon --no-pager
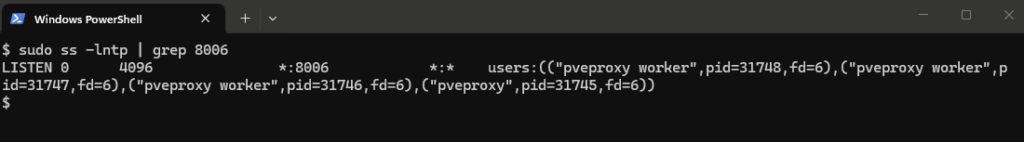
Dernière vérification, l’écoute effective du port.
sudo ss -lntp | grep 8006
Le port 8006 écoute. Reste à l’ouvrir côté Azure.
Mon retour terrain : sur ma machine, pveproxy affichait un ExecStartPost en échec, lié à la mise à jour du catalogue d’abonnement. Le service tournait très bien malgré tout : c’est une conséquence normale du dépôt sans abonnement, pas un problème d’installation.
9. Étape 6 : préparer le disque de 1 To
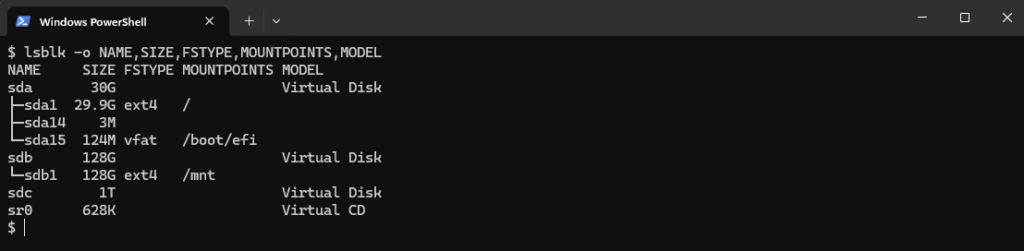
Le disque de données attaché à l’étape 1 est là, mais il est vierge. Première commande, et surtout ne formatez rien avant de l’avoir lue.
lsblk -o NAME,SIZE,FSTYPE,MOUNTPOINTS,MODEL
sdb est le disque temporaire d’Azure. Il est déjà monté sur /mnt et il ne faut rien y stocker.
Trois disques apparaissent. sda de 30 Go porte le système, sdb de 128 Go est monté sur /mnt, et sdc de 1 To est notre disque de données, encore sans partition.
Attention :sdb est le disque temporaire d’Azure. Son contenu peut disparaître à chaque désallocation ou opération de maintenance de la plateforme. Il est tentant de l’utiliser parce qu’il est déjà monté et rapide, mais n’y placez jamais un disque de machine virtuelle. Le disque à utiliser est sdc.
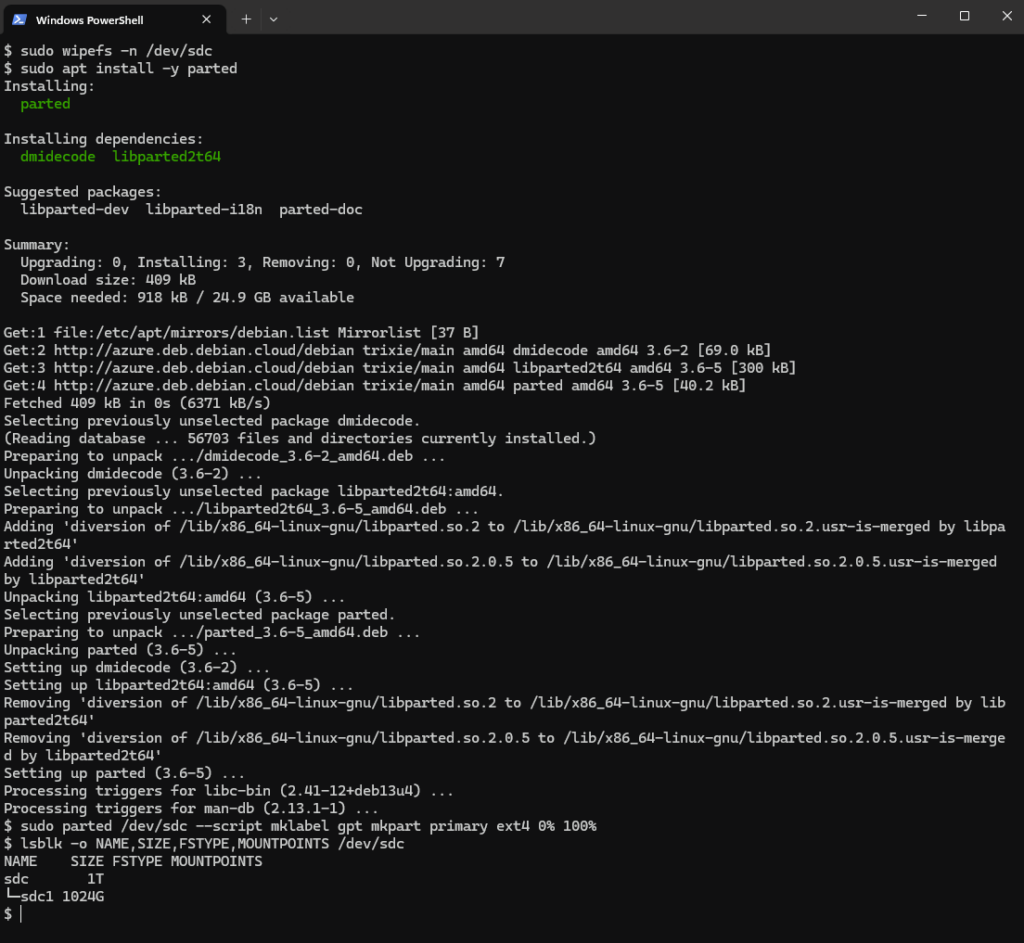
On vérifie une dernière fois que sdc ne contient aucune signature de système de fichiers, puis on le partitionne.
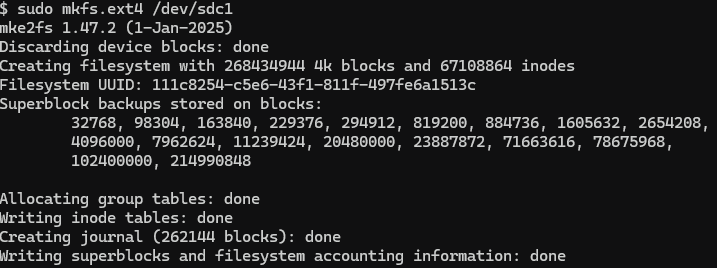
Notez l’UUID affiché ici. C’est lui qui ira dans /etc/fstab.
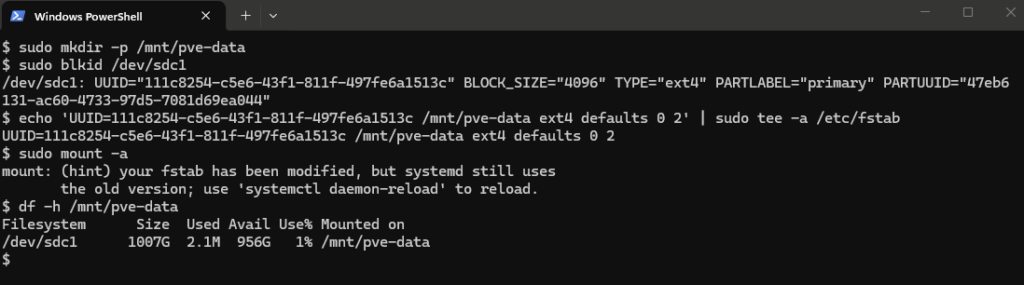
Reste à créer le point de montage et à le rendre permanent. Relevez l’UUID affiché par blkid et reportez-le dans /etc/fstab, l’UUID ci-dessous est le mien.
sudo mkdir -p /mnt/pve-data
sudo blkid /dev/sdc1
echo 'UUID=111c8254-c5e6-43f1-811f-497fe6a1513c /mnt/pve-data ext4 defaults 0 2' | sudo tee -a /etc/fstab
sudo mount -a
df -h /mnt/pve-data
Attention : montez toujours par UUID, jamais par /dev/sdc1. L’ordre d’énumération des disques d’une VM Azure n’est pas garanti d’un démarrage à l’autre, et un /etc/fstab qui pointe sur le mauvais périphérique donne une machine qui ne redémarre pas.
10. Étape 7 : le réseau, la partie qui change tout sur Azure
Voilà la section pour laquelle j’ai écrit cet article. Sur un Proxmox physique, la configuration réseau par défaut crée un bridge vmbr0 qui embarque la carte physique du serveur : les VM invitées se retrouvent directement sur le réseau de l’entreprise, avec une adresse du même plan que l’hôte. Sur Azure, cela ne fonctionne pas.
La raison est simple : une carte réseau Azure est associée à une configuration IP et à une adresse MAC connues de la plateforme. Une trame émise par une VM imbriquée, avec sa propre adresse MAC et sa propre adresse IP, n’est pas routée par le réseau virtuel. La documentation Microsoft sur la virtualisation imbriquée décrit d’ailleurs le même symptôme côté Hyper-V, avec le NAT comme réponse.
La réponse côté Proxmox tient en trois briques comme on pourrait faire tourner un serveur Hyper-V sur Azure : un bridge isolé sans port physique, du NAT pour la sortie, et un service DHCP et DNS interne pour que les invités reçoivent une configuration sans intervention.
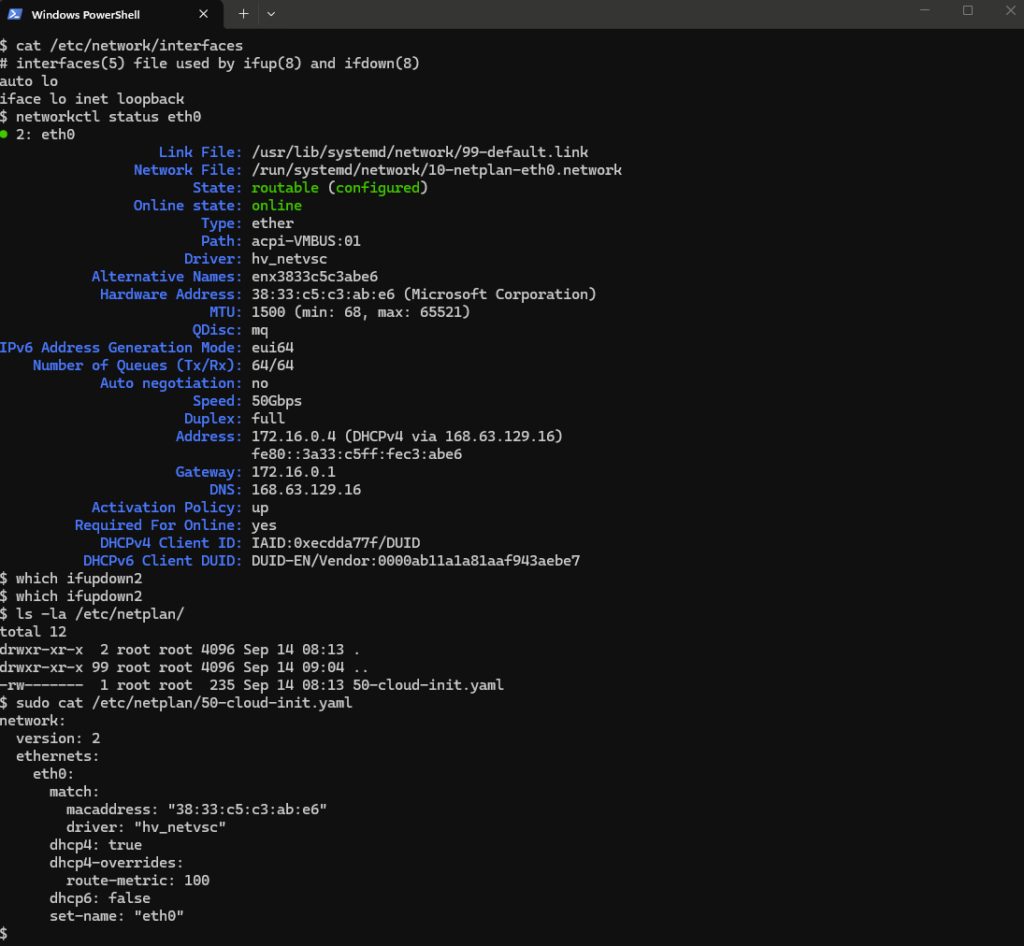
On commence par regarder comment la VM est câblée aujourd’hui.
ip -br addr
cat /etc/network/interfaces
networkctl status eth0
which ifupdown2
sudo cat /etc/netplan/50-cloud-init.yaml
eth0 est piloté par netplan et reçoit son adresse en DHCP depuis Azure.
Constat : eth0 est piloté par netplan et systemd-networkd, avec une adresse obtenue en DHCP auprès d’Azure, et /etc/network/interfaces ne contient presque rien. Proxmox, lui, s’appuie sur ifupdown2 pour appliquer les changements réseau depuis l’interface web.
Attention : on ne touche pas à eth0. C’est votre seule voie d’accès à la machine : si vous la basculez sous ifupdown2 et que la configuration est mauvaise, vous perdez le SSH et il ne reste plus que la console série du portail Azure pour réparer. On laisse netplan gérer eth0 et on se contente d’ajouter vmbr0.
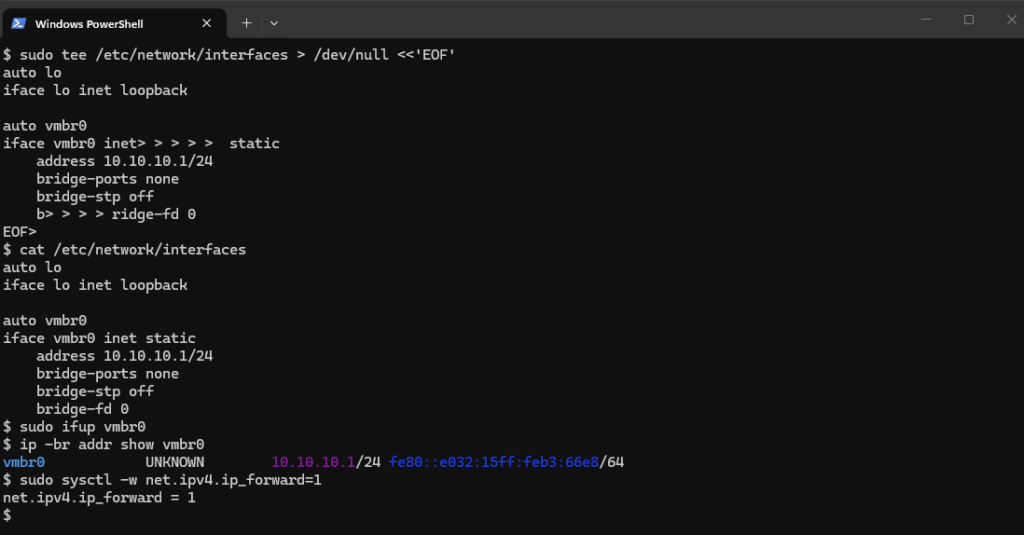
On déclare donc un bridge isolé, en 10.10.10.1/24, sans aucun port attaché. Ce sera la passerelle des VM invitées.
sudo tee /etc/network/interfaces > /dev/null <<'EOF'
# network interface settings; autogenerated

auto lo
iface lo inet loopback

source /etc/network/interfaces.d/*

iface eth0 inet manual

auto vmbr0
iface vmbr0 inet static
    address 10.10.10.1/24
    bridge-ports none
    bridge-stp off
    bridge-fd 0
EOF
Le paramètre qui compte ici est bridge-ports none : aucune carte physique n’est rattachée au commutateur. On active ensuite le bridge et le routage IPv4.
cat /etc/network/interfaces
sudo ifup vmbr0
ip -br addr show vmbr0
sudo sysctl -w net.ipv4.ip_forward=1
vmbr0 est là, en 10.10.10.1/24, sans aucun port physique attaché.
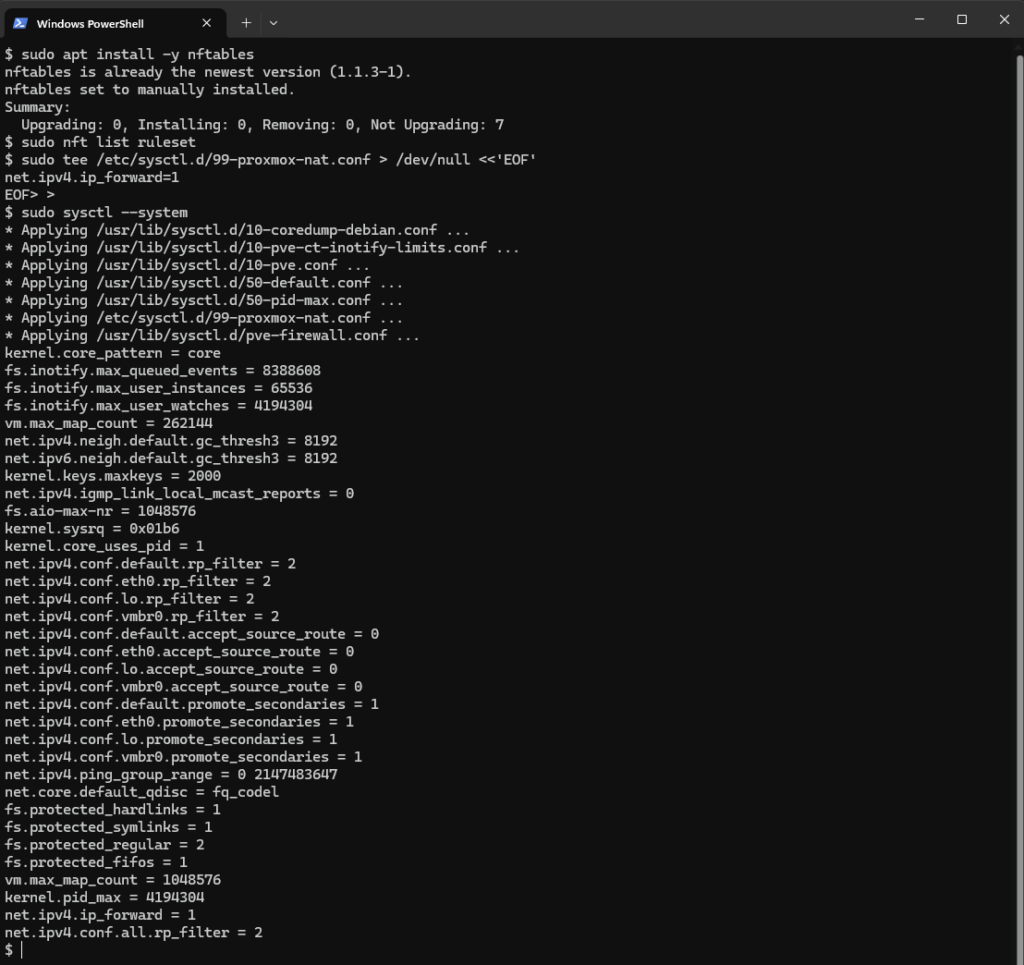
Pour que le routage survive au redémarrage, on l’écrit dans un fichier sysctl dédié, et on installe nftables.
sudo apt install -y nftables
sudo nft list ruleset
sudo tee /etc/sysctl.d/99-proxmox-nat.conf > /dev/null <<'EOF'
net.ipv4.ip_forward=1
EOF
sudo sysctl --system
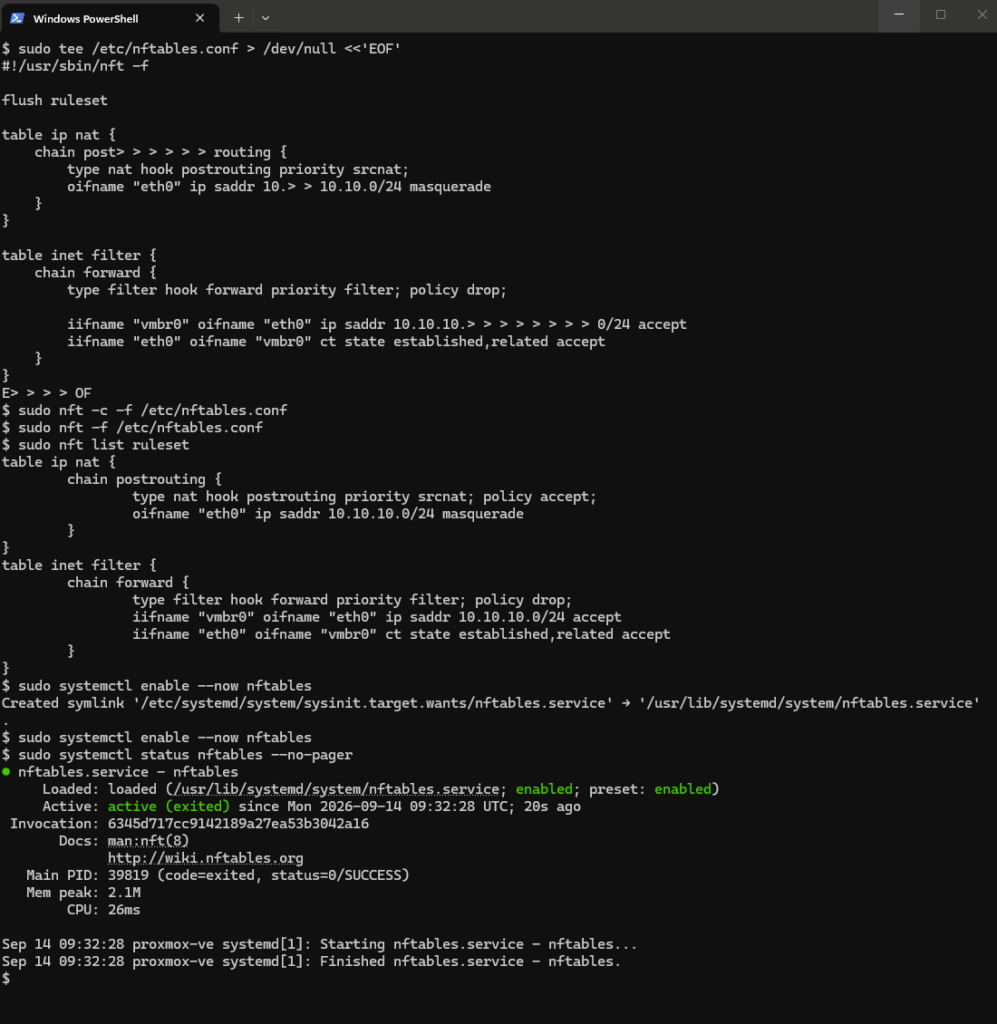
Puis le cœur du sujet : la translation d’adresses. La table nat masque le réseau 10.10.10.0/24 derrière l’adresse de eth0, et la table filter n’autorise que ce qui doit l’être, à savoir les flux sortants des invités et les réponses associées.
sudo tee /etc/nftables.conf > /dev/null <<'EOF'
#!/usr/sbin/nft -f

flush ruleset

table ip nat {
    chain postrouting {
        type nat hook postrouting priority srcnat;
        oifname "eth0" ip saddr 10.10.10.0/24 masquerade
    }
}

table inet filter {
    chain forward {
        type filter hook forward priority filter; policy drop;

        iifname "vmbr0" oifname "eth0" ip saddr 10.10.10.0/24 accept
        iifname "eth0" oifname "vmbr0" ct state established,related accept
    }
}
EOF
Le NAT est en place et la règle survivra au redémarrage.
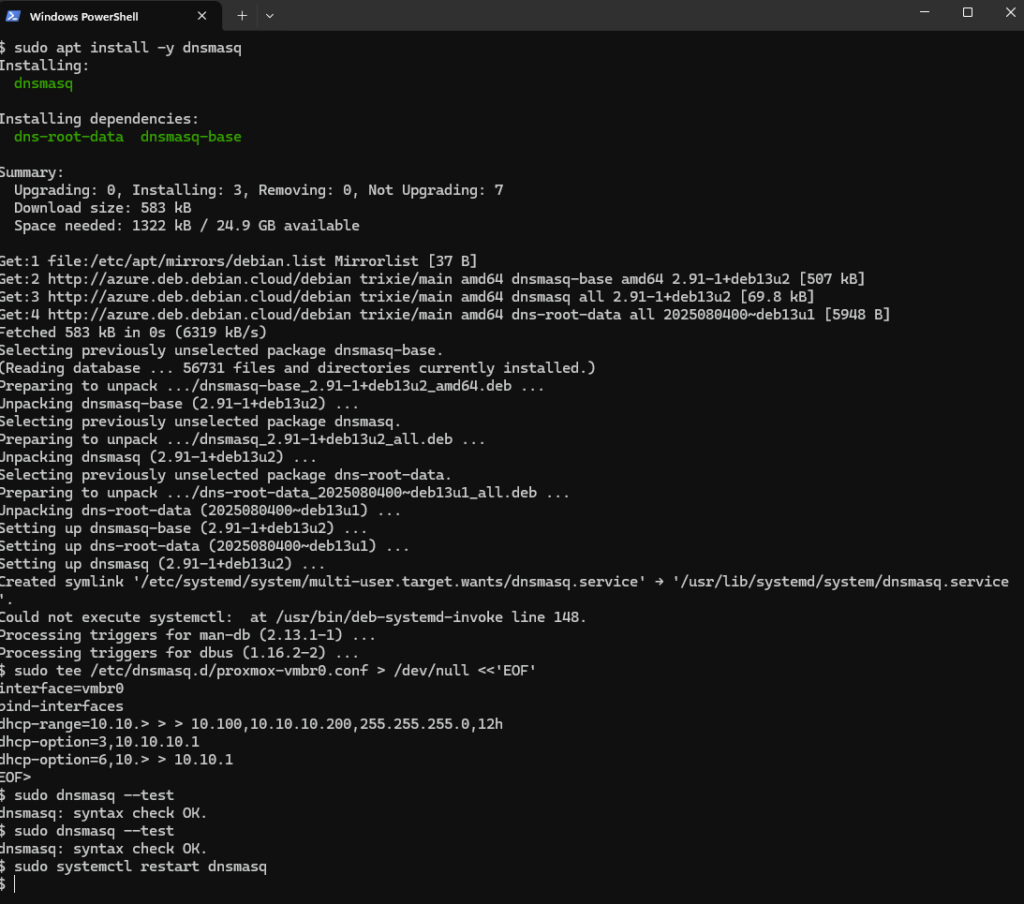
Dernière brique, le service DHCP et DNS des invités. Sans lui, il faudrait configurer une adresse IP fixe dans chaque VM créée, ce qui est vite pénible.
dnsmasq distribue les adresses et relaie les requêtes DNS vers le résolveur Azure.
Deux détails de cette configuration valent une explication. bind-interfaces limite l’écoute à vmbr0, donc votre DHCP ne partira jamais polluer le sous-réseau Azure. Et l’adresse 168.63.129.16 déclarée comme serveur amont n’est pas une adresse au hasard : c’est l’adresse IP virtuelle de la plateforme Azure, celle qui rend entre autres le service de résolution de noms aux machines virtuelles.
L’adresse IP Azure 168.63.129.16 est une adresse IP publique virtuelle qui facilite les canaux de communication vers les ressources de la plateforme Azure.
Attention : choisissez pour vmbr0 un plan d’adressage qui ne chevauche pas celui de votre réseau virtuel Azure. Mon sous-réseau Azure est en 172.16.0.0/24 et mon réseau interne en 10.10.10.0/24 : aucune ambiguïté de routage possible.
11. Étape 8 : première connexion à l’interface web
Le moment de vérité. Ouvrez votre navigateur sur l’adresse publique de la VM, en HTTPS, port 8006.
https://VOTRE-IP-PUBLIQUE:8006
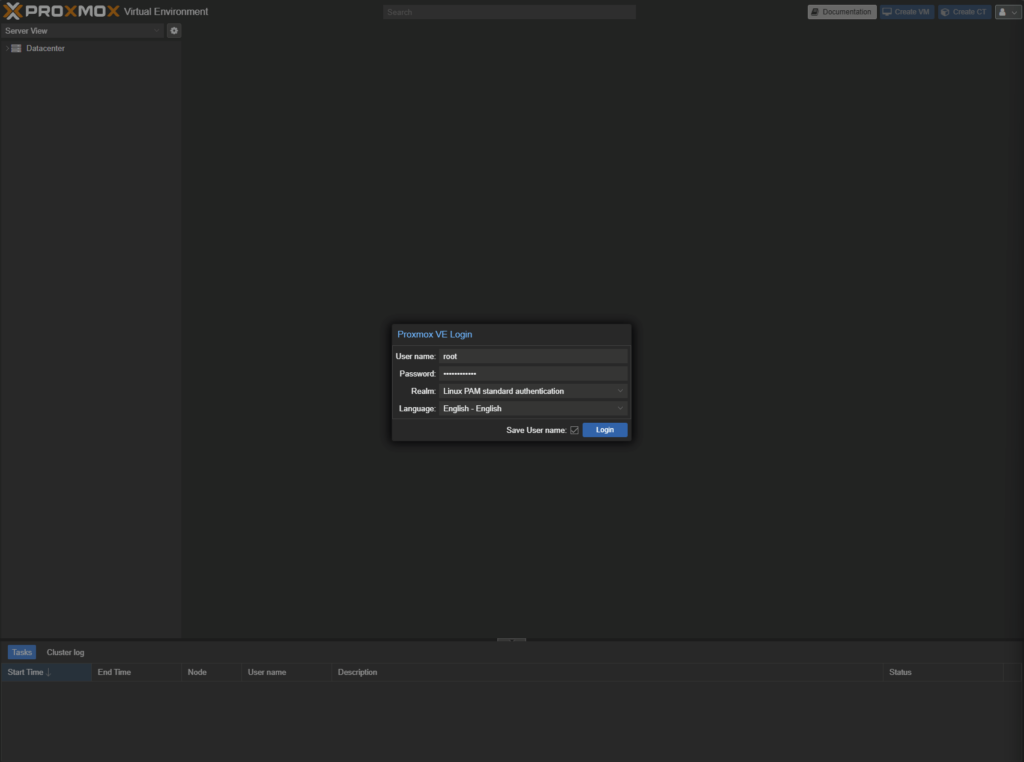
Le certificat est auto-signé, votre navigateur va râler, c’est normal. Connectez-vous avec l’utilisateur root, son mot de passe système, et le realm Linux PAM standard authentication.
Le realm Linux PAM. C’est bien le compte root du système que vous utilisez ici.
Attention : si vous n’avez jamais défini de mot de passe pour root sur cette machine, faites-le en SSH avec sudo passwd root avant d’essayer de vous connecter. Les images Azure livrent un compte root verrouillé.
Vous serez accueilli par la boîte de dialogue la plus célèbre de Proxmox. Elle vous rappelle simplement que vous utilisez le dépôt sans abonnement.
Le message d’accueil du dépôt sans abonnement. On clique sur OK et on continue.
Et voilà l’interface, avec l’arborescence Datacenter puis nœud à gauche, et le résumé du nœud au centre.
16 vCPU, 62,8 Gio de RAM et l’avertissement sur le dépôt de test, en jaune.
Mon retour terrain : regardez la ligne Kernel Version de ce résumé. Sur ma capture, la machine tournait encore sur le noyau cloud de Debian et pas sur le noyau pve, le redémarrage n’ayant pas encore eu lieu. Tout fonctionne quand même pour un lab, mais prévoyez un sudo reboot après l’installation pour démarrer sur le bon noyau.
12. Étape 9 : déclarer le stockage local-1TB
Le disque de 1 To est monté sur /mnt/pve-data, mais Proxmox ne le connaît pas encore. Un stockage se déclare au niveau du datacenter, pas du nœud, même quand il n’est physiquement présent que sur une seule machine.
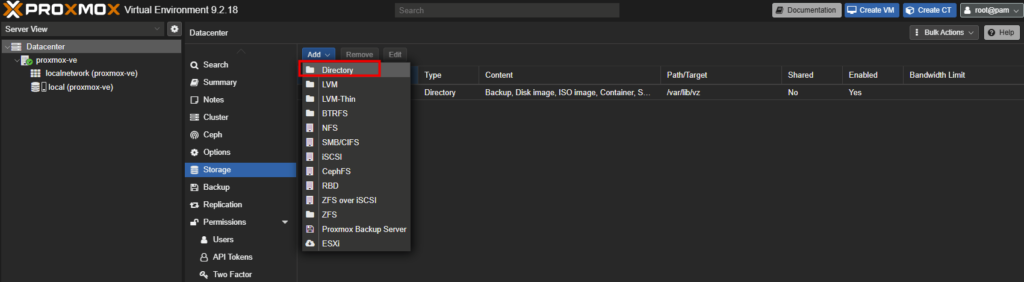
Allez dans Datacenter, Storage, puis Add et choisissez Directory.
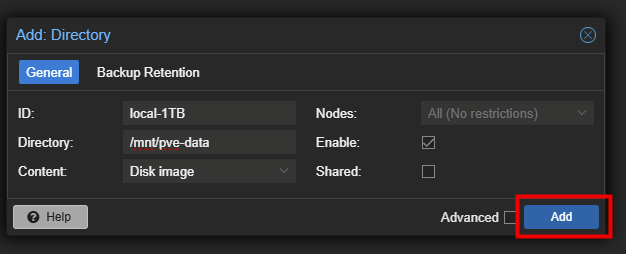
Renseignez l’ID local-1TB, le répertoire /mnt/pve-data, et le contenu Disk image.
Laissez Nodes sur All et cochez Enable, puis validez avec Add.
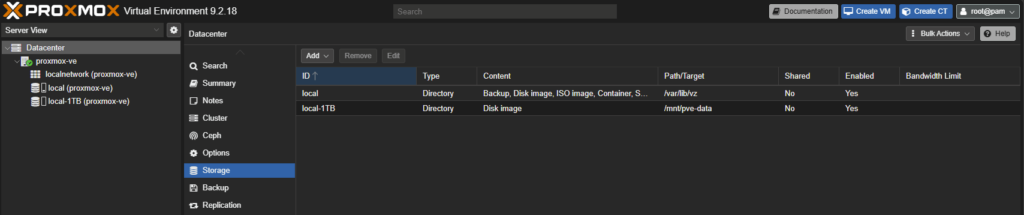
Vous vous retrouvez avec deux stockages. local, sur le disque système, garde les ISO, les sauvegardes et les modèles de conteneurs. local-1TB accueillera les disques des machines virtuelles.
Deux stockages : local pour les ISO, local-1TB pour les disques des machines virtuelles.
13. Étape 10 : voir vmbr0 dans l’interface et appliquer la configuration
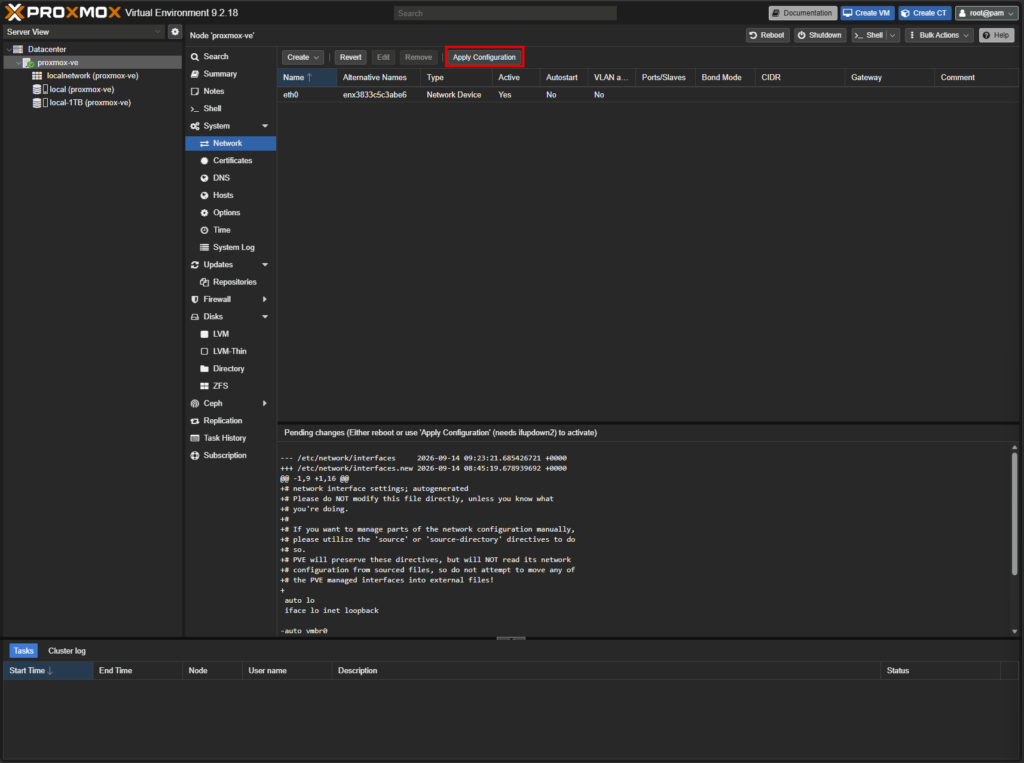
Le bridge créé en ligne de commande apparaît maintenant dans l’interface, avec un avertissement en bas de page signalant des modifications en attente. Proxmox n’applique pas la configuration réseau à chaud sans votre accord, il vous montre d’abord le différentiel entre /etc/network/interfaces et le fichier .new qu’il a préparé.
Sélectionnez le nœud, puis System et Network.
Relisez le bloc Pending changes en bas de la vue, ligne par ligne.
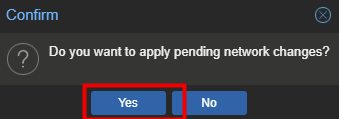
Cliquez sur Apply Configuration.
Proxmox affiche le différentiel avant de l’appliquer. Relisez-le.
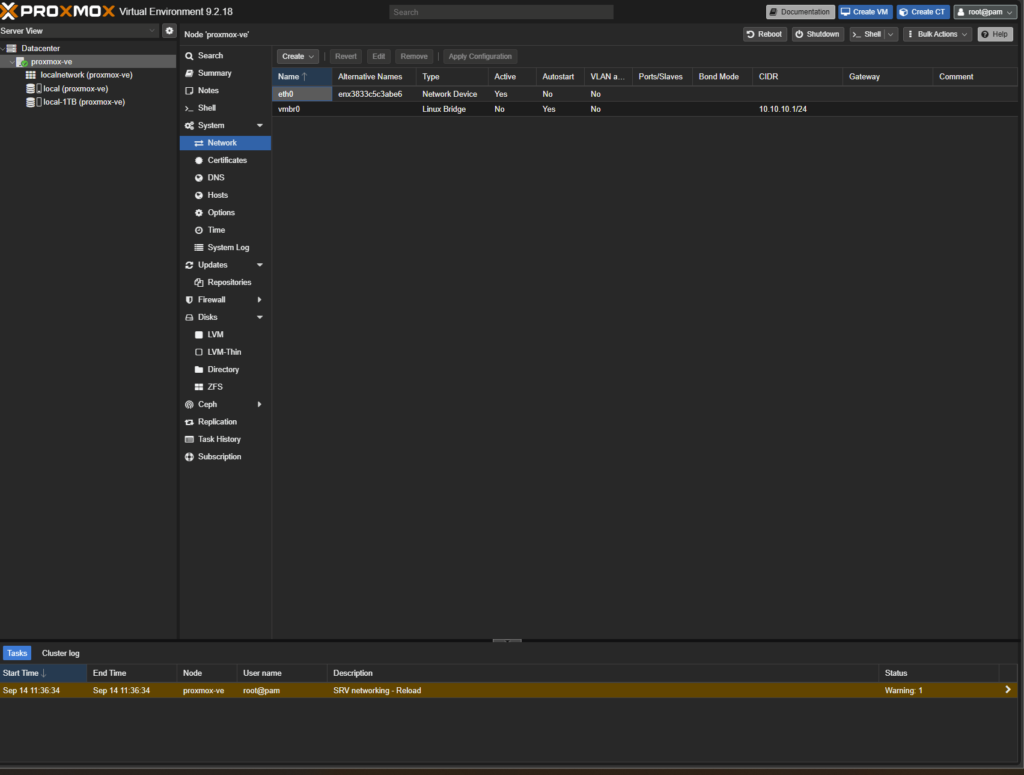
Après application, eth0 et le Linux Bridge vmbr0 en 10.10.10.1/24 cohabitent proprement.
Attention : c’est le seul moment de tout l’article où vous risquez de perdre l’accès à la machine. Relisez vraiment le différentiel avant de cliquer, et assurez-vous qu’aucune ligne ne touche à eth0.
14. Étape 11 : uploader l’ISO Windows 11
Pour installer un invité, il faut son image. Proxmox sait télécharger une ISO depuis une URL, mais pour Windows 11 vous passerez par l’upload depuis votre poste.
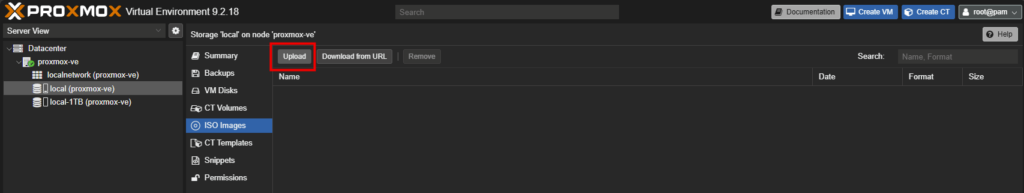
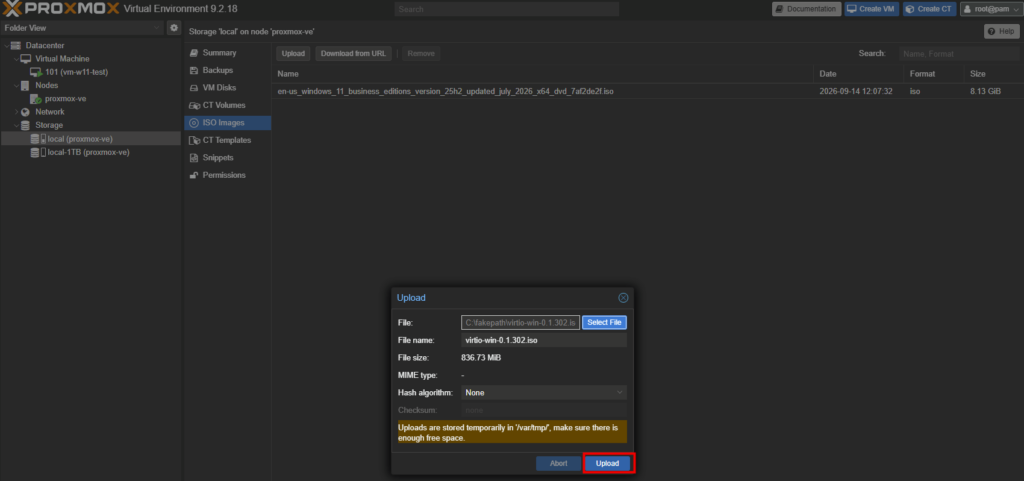
Dans l’arborescence, sélectionnez le stockage local du nœud, puis ISO Images.
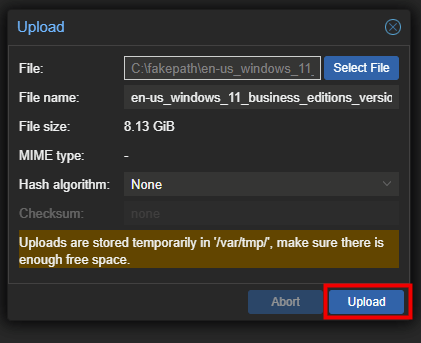
Cliquez sur Upload, choisissez votre fichier, puis Upload à nouveau.
8,13 Gio qui transitent par votre navigateur puis par /var/tmp. Prévoyez le temps.
Attention : l’upload transite par /var/tmp sur le nœud, comme la boîte de dialogue le signale. Avec une ISO de 8,13 Gio et un disque système de 30 Gio, ça passe, mais de justesse si vous en montez plusieurs. Surveillez l’espace libre, ou déclarez un second stockage de type Directory autorisant le contenu ISO image sur votre disque de 1 To.
15. Étape 12 : créer la machine virtuelle Windows 11
Cliquez sur Create VM en haut à droite. L’assistant compte huit onglets, et trois d’entre eux conditionnent la réussite de l’installation.
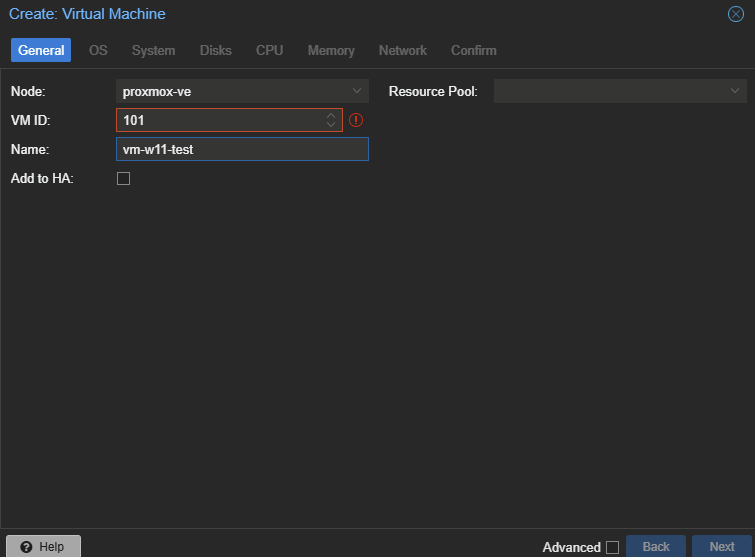
Dans General, donnez un nom à la VM, le mien est vm-w11-test, et notez le VMID proposé, 101 dans mon cas. Ce numéro est l’identifiant que vous retrouverez partout : dans l’arborescence, dans les noms de fichiers de disques, dans les journaux.
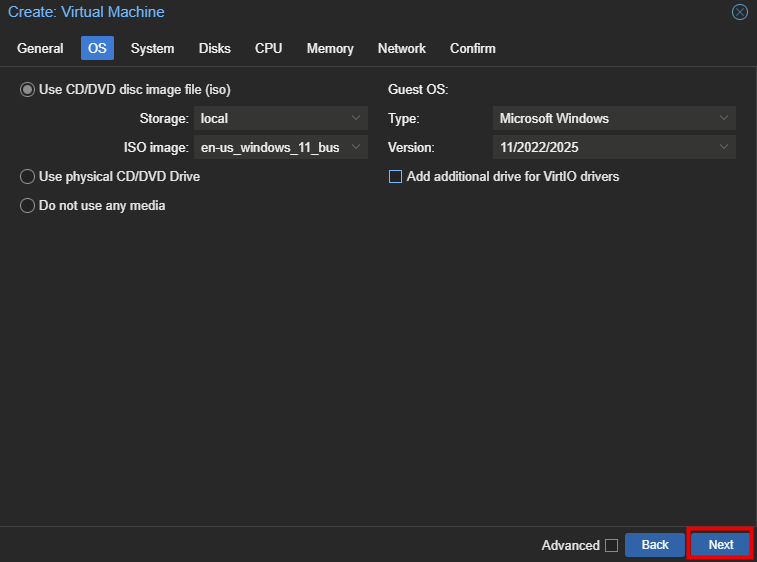
Dans OS, sélectionnez l’ISO sur le stockage local, puis le type d’invité Microsoft Windows et la version 11/2022/2025. Proxmox propose de monter un second lecteur contenant les pilotes VirtIO, ce que je n’utiliserai pas pour ce premier article :
Celle que l’on garde pour ce lab : pas de second lecteur, pas de pilote à charger.
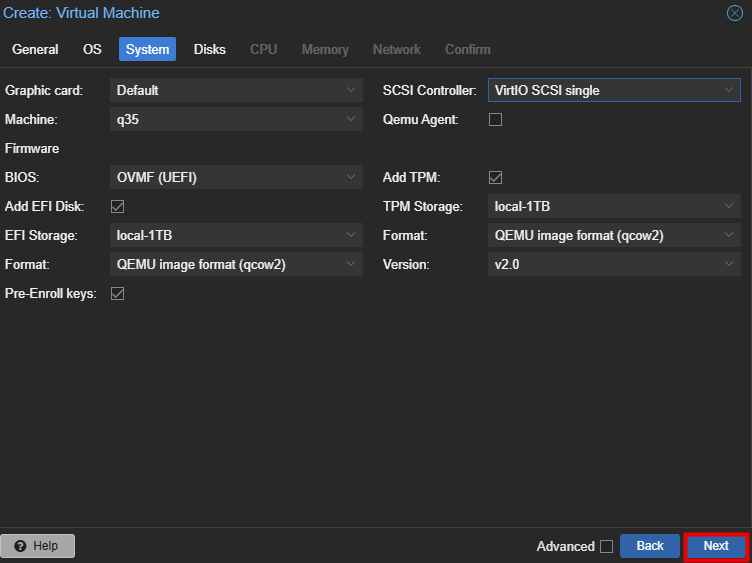
Dans System, on entre dans le dur. Windows 11 exige un démarrage UEFI, le démarrage sécurisé et un module de plateforme sécurisée.
Machine : q35, le jeu de puces moderne avec PCI Express.
BIOS : OVMF (UEFI), et cochez Add EFI Disk en le plaçant sur local-1TB.
Cochez Pre-Enroll keys pour que les clés Microsoft soient présentes dès le départ.
Cochez Add TPM, stockage local-1TB, version v2.0.
SCSI Controller : VirtIO SCSI single, la valeur par défaut, que l’on gardera même si notre disque sera en SATA.
UEFI et TPM 2.0. Les deux cases sans lesquelles l’installation de Windows 11 s’arrête.
Attention : sans OVMF (UEFI) et sans TPM 2.0, le programme d’installation de Windows 11 s’arrête sur le message « This PC can’t run Windows 11 ». Ces deux cases ne sont pas facultatives, et il est bien plus simple de les cocher maintenant que de les ajouter après coup.
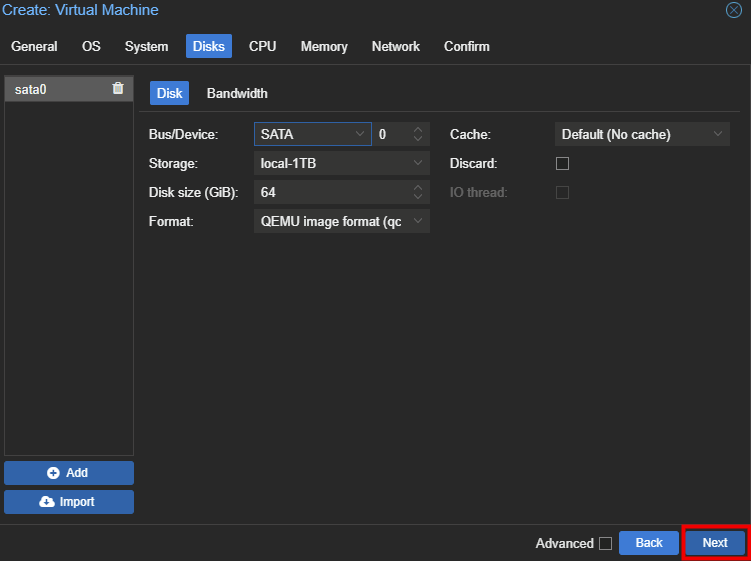
Dans Disks, l’assistant propose par défaut un disque scsi0 sur le contrôleur VirtIO SCSI. Le piège classique : sans les pilotes VirtIO, le programme d’installation de Windows ne verra tout simplement aucun disque, et vous resterez bloqué sur un écran de sélection vide.
Je bascule donc le Bus/Device sur SATA, taille 64 Gio, format qcow2, stockage local-1TB :
Le même disque, mais en SATA. Windows le verra tout seul.
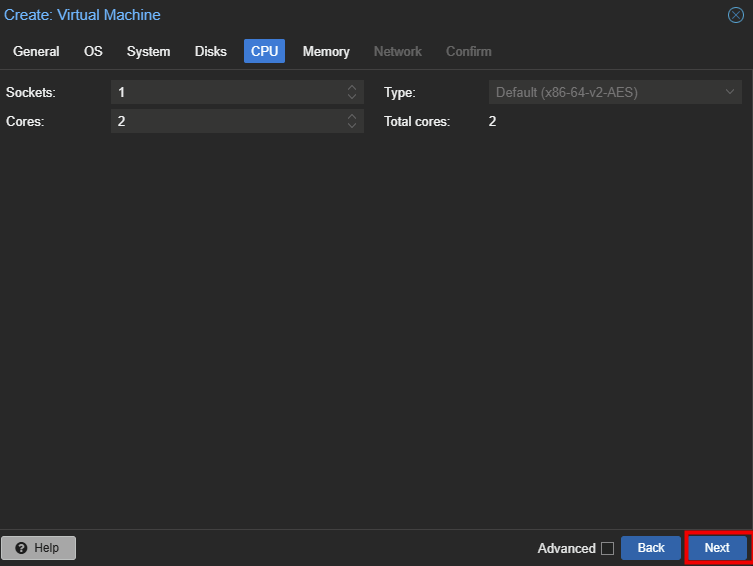
Les onglets CPU et Memory sont sans surprise. Un socket, deux cœurs, ce qui est le minimum demandé par Windows 11.
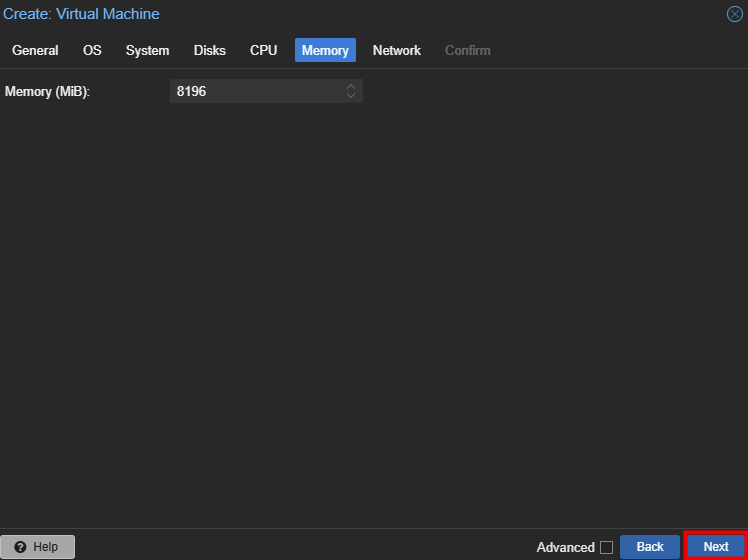
Et 8192 Mio de mémoire, largement supportables sur une VM hôte qui en a 64 Gio.
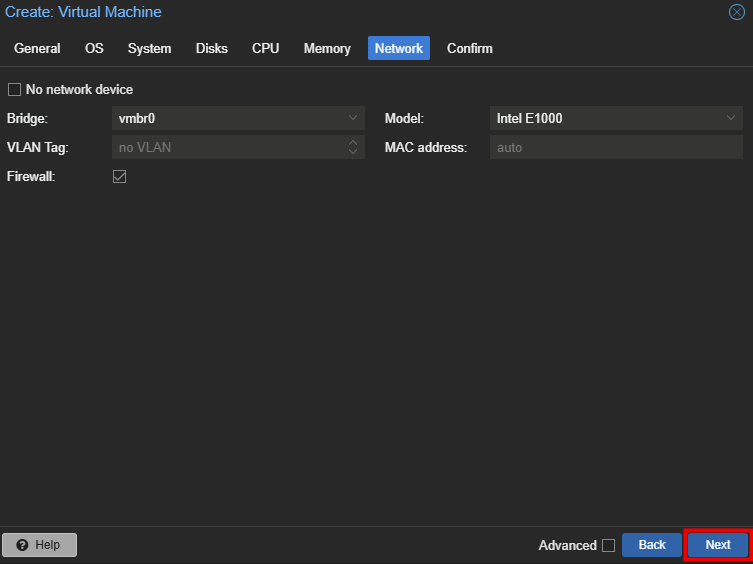
Dans Network, même logique que pour le disque. Le modèle VirtIO (paravirtualized) proposé par défaut est le plus performant, mais Windows n’en a pas le pilote.
Je choisis donc Intel E1000, sur le bridge vmbr0, en laissant le pare-feu coché. Windows embarque ce pilote depuis toujours, la carte sera donc opérationnelle dès le premier démarrage, et elle recevra son adresse de notre dnsmasq :
Intel E1000. Windows embarque le pilote, le réseau fonctionne dès le premier démarrage.
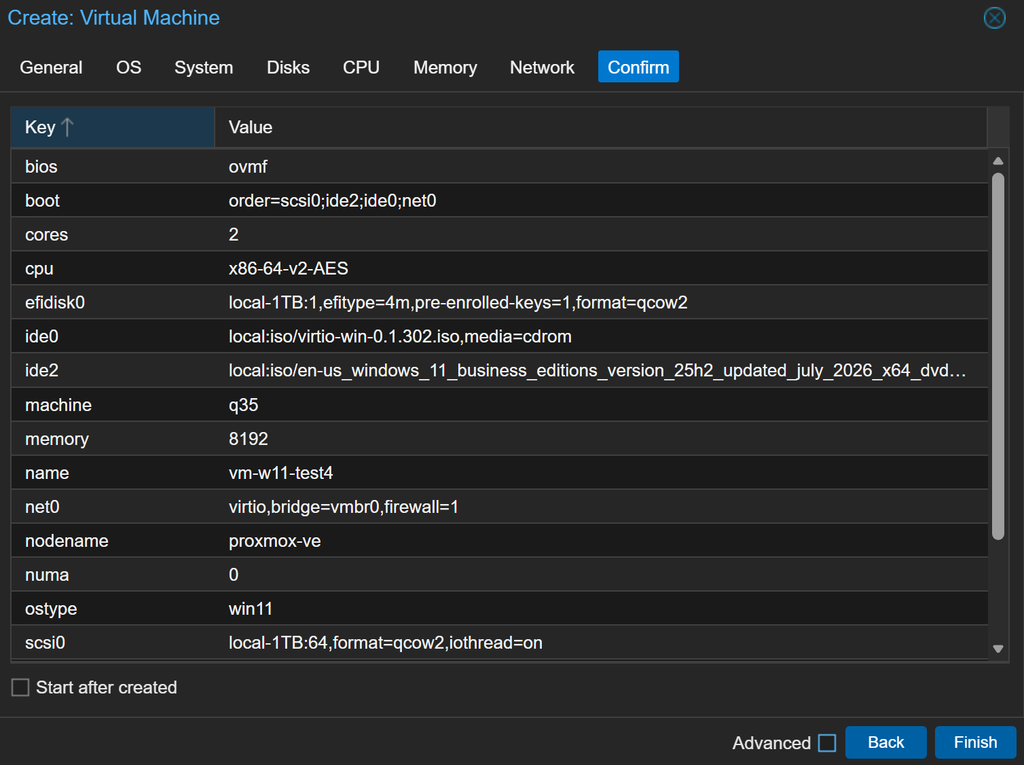
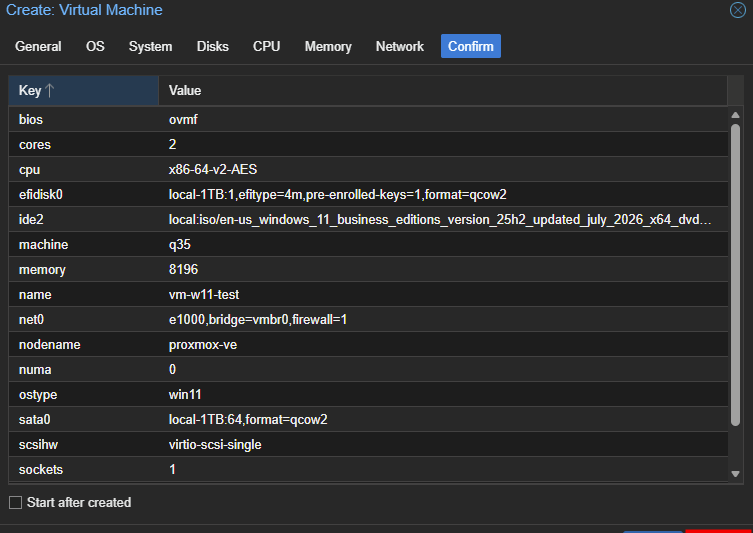
L’onglet Confirm récapitule le tout. Vérifiez la présence de bios: ovmf, machine: q35, ostype: win11, du disque sata0 et de net0 en e1000, puis validez.
Mon retour terrain : le choix SATA plus E1000 est un compromis de confort. Vous perdez en performances par rapport à VirtIO, ce qui est sans importance pour un lab, et vous gagnez une installation qui se déroule sans jamais chercher un pilote. Sur ma capture de l’onglet OS, le second lecteur censé porter les pilotes pointait d’ailleurs sur ma propre ISO Windows et pas sur une ISO virtio-win : aucun pilote n’était donc réellement disponible. Basculer un invité Windows en VirtIO après coup mérite son propre article, j’y reviendrai.
16. Étape 13 : installer Windows 11 jusqu’au bureau
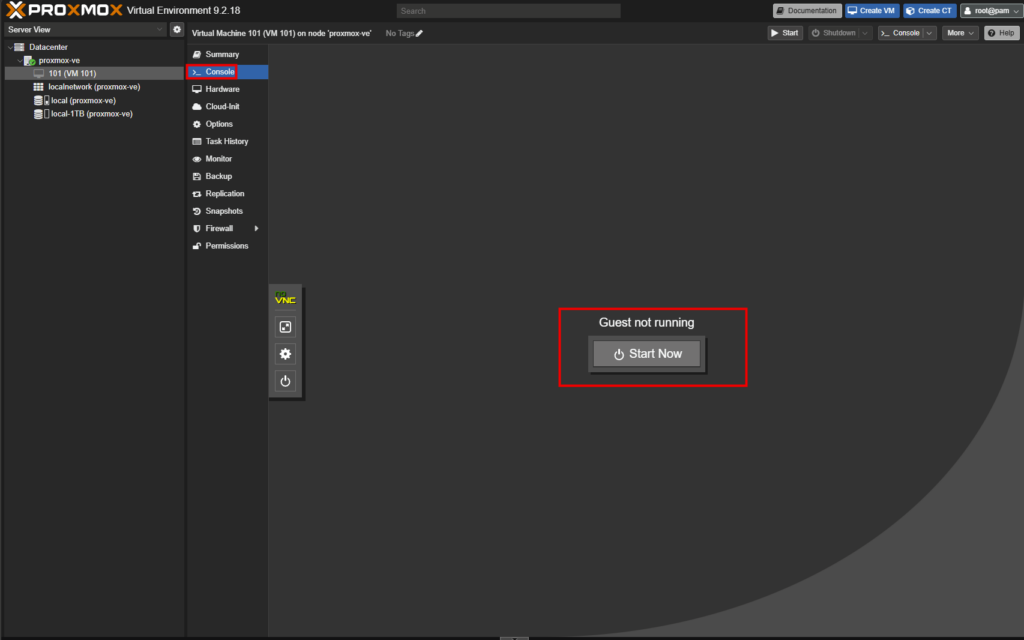
Sélectionnez la VM 101 dans l’arborescence, ouvrez l’onglet Console et cliquez sur Start Now.
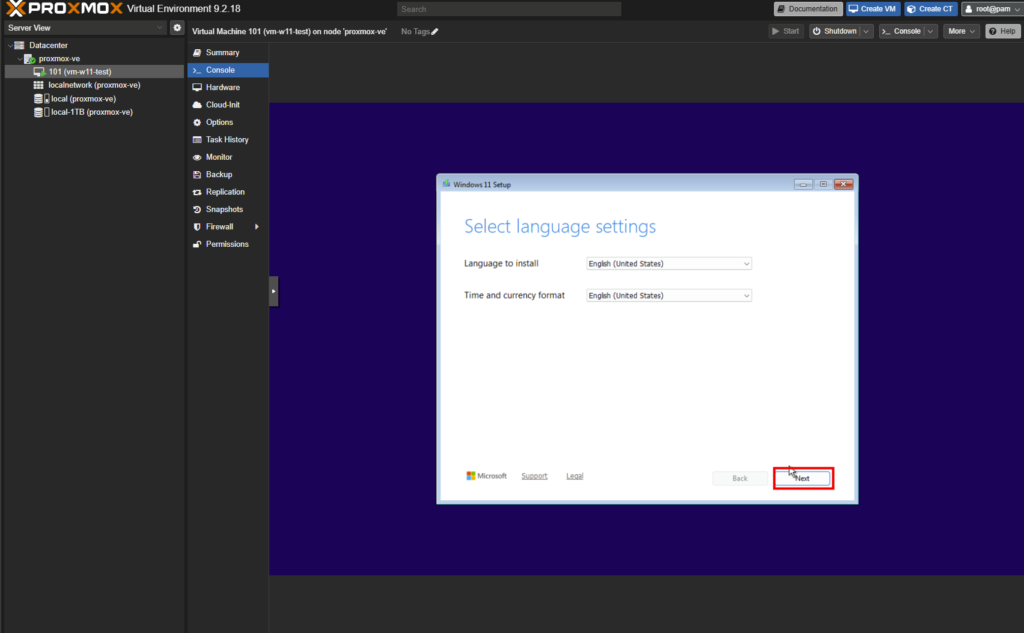
La console noVNC s’affiche dans votre navigateur, et le programme d’installation de Windows 11 démarre.
Et là, magie : le programme d’installation de Windows 11 démarre dans un onglet de navigateur.
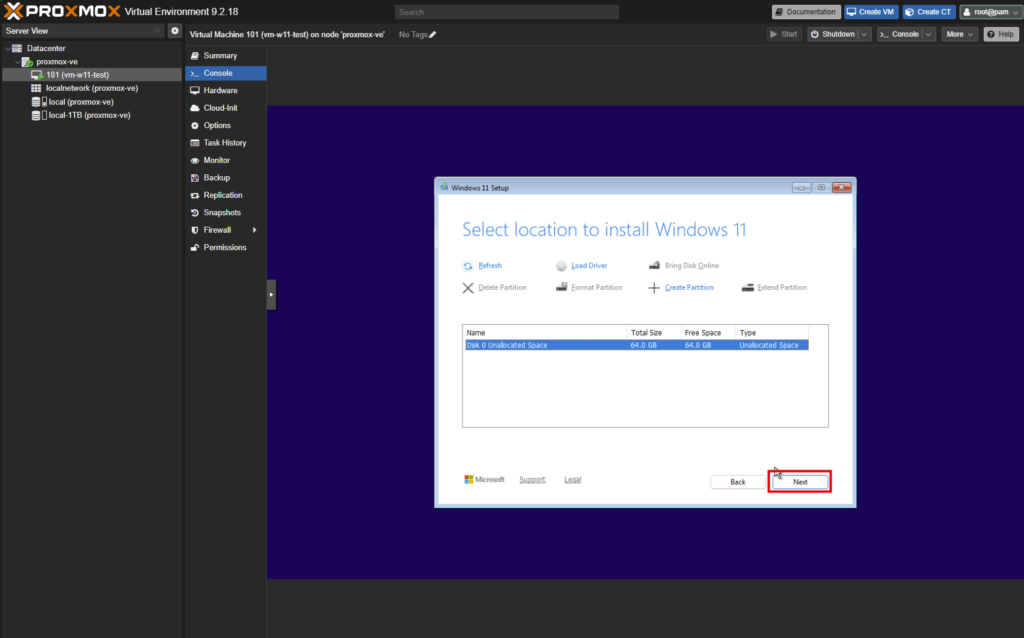
Déroulez l’installation normalement. L’écran de sélection du disque est celui qui valide tous les choix de l’étape précédente. Le disque de 64 Go apparaît sans avoir eu à charger le moindre pilote. Le pari est gagné :
Le disque de 64 Go apparaît sans avoir eu à charger le moindre pilote.
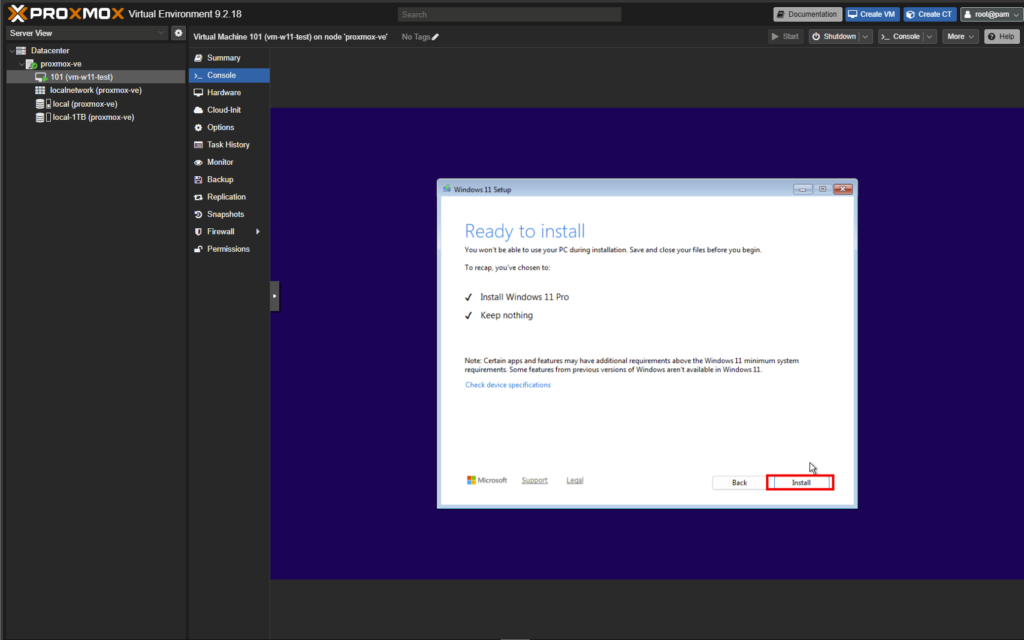
Lancez l’installation de Windows 11 :
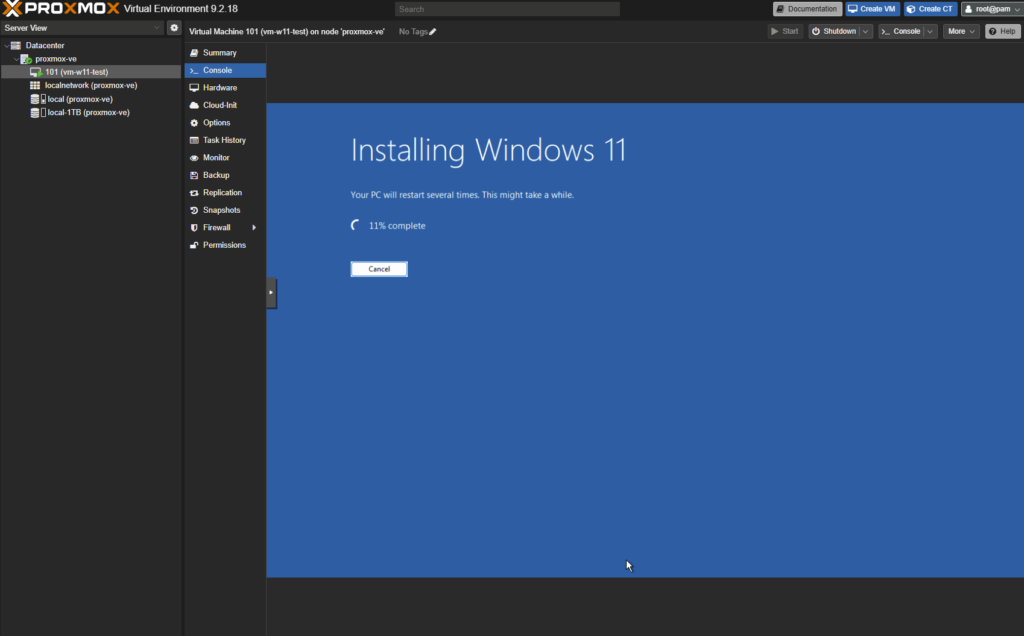
Attendez plusieurs minutes :
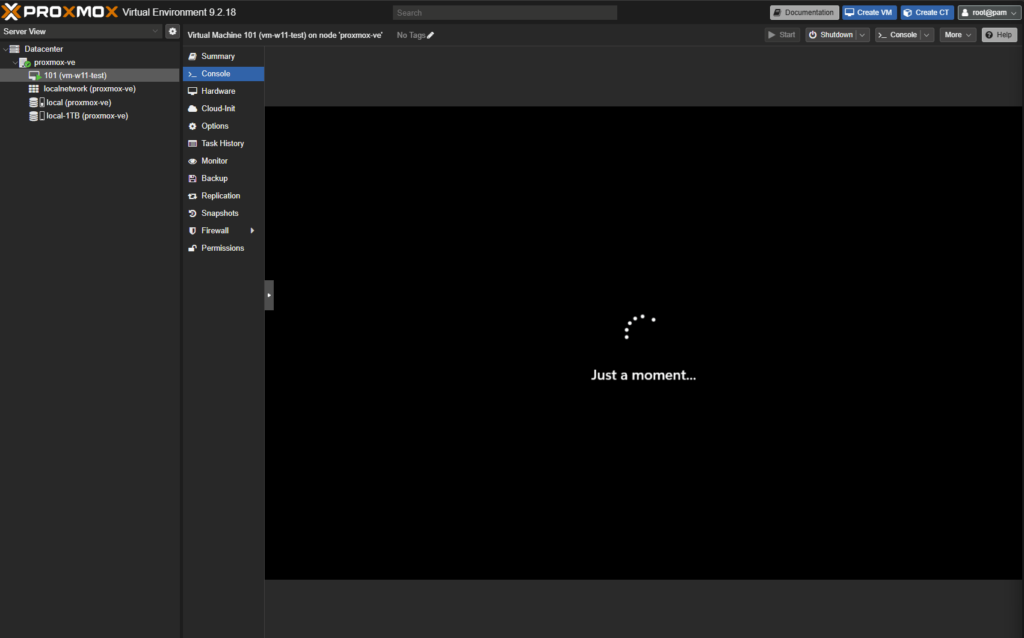
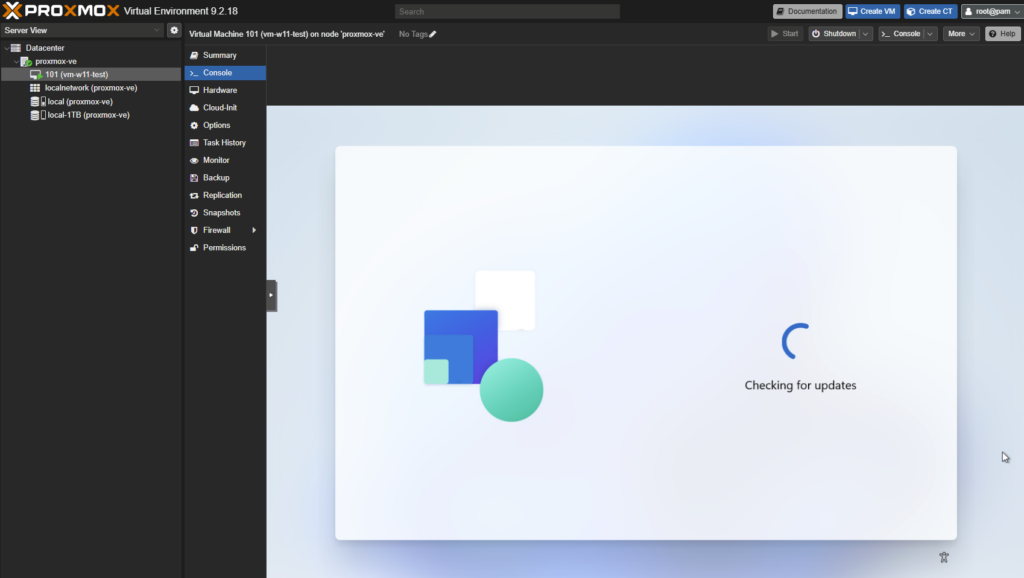
La VM redémarre plusieurs fois, puis enchaîne sur l’expérience de première ouverture de session.
La recherche de mises à jour est un excellent test réseau : si cet écran passe, c’est que votre chaîne bridge, NAT et DHCP fonctionne de bout en bout.
La VM sort sur Internet à travers le NAT nftables. La chaîne réseau fonctionne de bout en bout.
Nommez votre machine Windows 11 :
Définissez le type de compte Windows à créer :
Attendez la fin de configuration de Windows 11 :
Attendez encore la fin du téléchargement puis de l’installation des mises à jours OS :
Et au bout du compte, un bureau Windows 11 complet, qui tourne dans Proxmox VE, qui tourne dans une machine virtuelle Azure. La console fonctionne dans un simple onglet de navigateur, sans client RDP.
Trois niveaux de virtualisation empilés, et tout répond.
17. Étape 14 : activer le QEMU guest agent
Votre Windows tourne, mais Proxmox ne sait presque rien de lui. Dans l’onglet Summary de la VM, la ligne des adresses IP reste désespérément vide, et un clic sur Shutdown se contente d’envoyer un signal ACPI en espérant que l’invité l’écoute. Le QEMU guest agent règle ces deux points.
Concrètement, c’est un petit service qui tourne dans l’invité et qui dialogue avec l’hôte par un canal série virtuel dédié. Il ne remplace aucun pilote de disque ni de carte réseau : votre VM continue de démarrer sur son disque SATA et de communiquer par sa carte E1000. C’est justement ce qui le rend sans risque, et c’est pour ça que je le traite ici plutôt que dans un article dédié à VirtIO.
Ce qu’il apporte, une fois en place :
les adresses IP de l’invité remontent dans l’interface, ce qui évite d’ouvrir la console pour savoir quelle adresse dnsmasq a distribuée
l’arrêt et le redémarrage depuis Proxmox deviennent un arrêt propre demandé au système invité
les instantanés et les sauvegardes peuvent geler les écritures le temps de la copie, donc obtenir un état cohérent du système de fichiers
vous pouvez interroger l’invité depuis le shell du nœud, sans passer par le réseau
L’activation se fait en deux moitiés, et il faut les deux.
Côté Proxmox : ajouter le périphérique
Sur la capture de l’onglet System de l’étape 12, la case Qemu Agent était décochée, comme par défaut. On rattrape ça dans les options de la VM.
Sélectionnez la VM, puis Options.
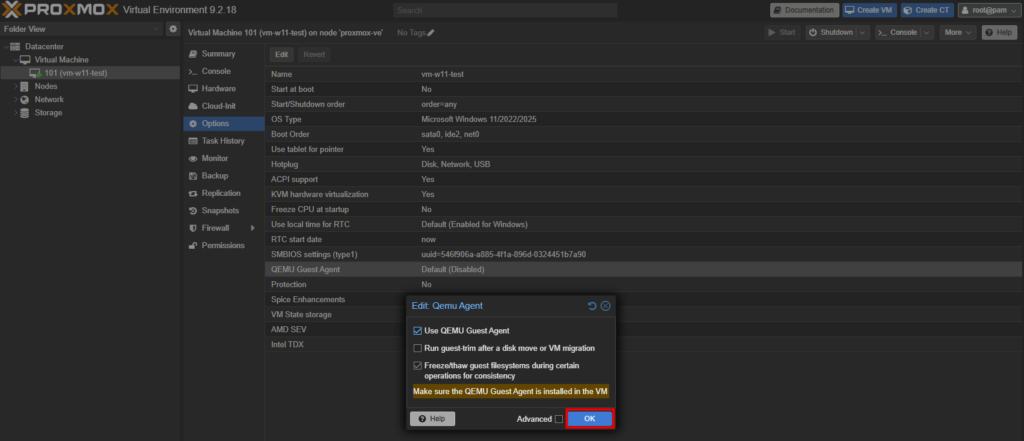
Double-cliquez sur QEMU Guest Agent et cochez Use QEMU Guest Agent.
Validez.
Attention : cocher cette option ajoute un périphérique à la machine virtuelle. Un redémarrage demandé depuis Windows ne suffit pas, il faut un arrêt complet puis un démarrage depuis Proxmox pour que QEMU recrée la VM avec son canal série. C’est la raison numéro un des « j’ai installé l’agent et il ne remonte toujours rien ».
Côté Windows : installer le service
Le programme d’installation de l’agent est livré sur l’ISO virtio-win, la même que celle des pilotes. Uploadez-la dans le stockage local comme vous l’avez fait pour Windows :
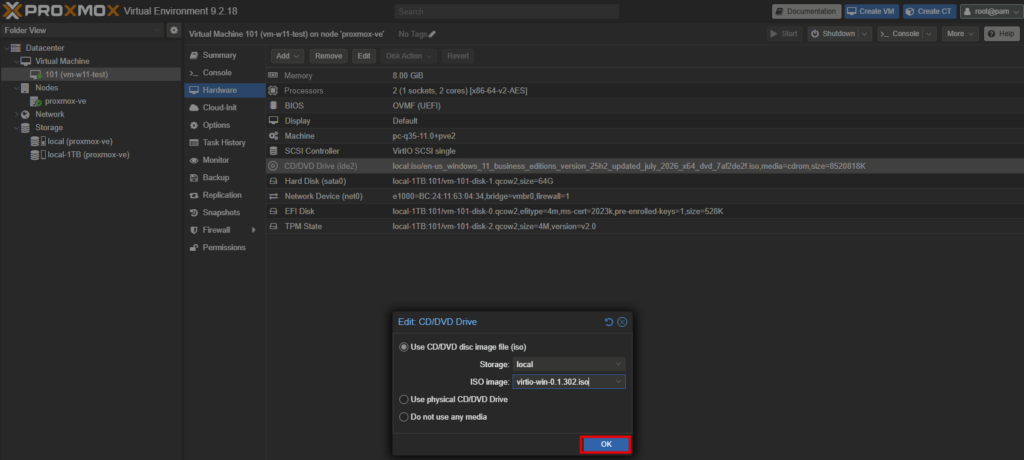
Puis montez-la dans la VM avec Hardware, Add, CD/DVD Drive :
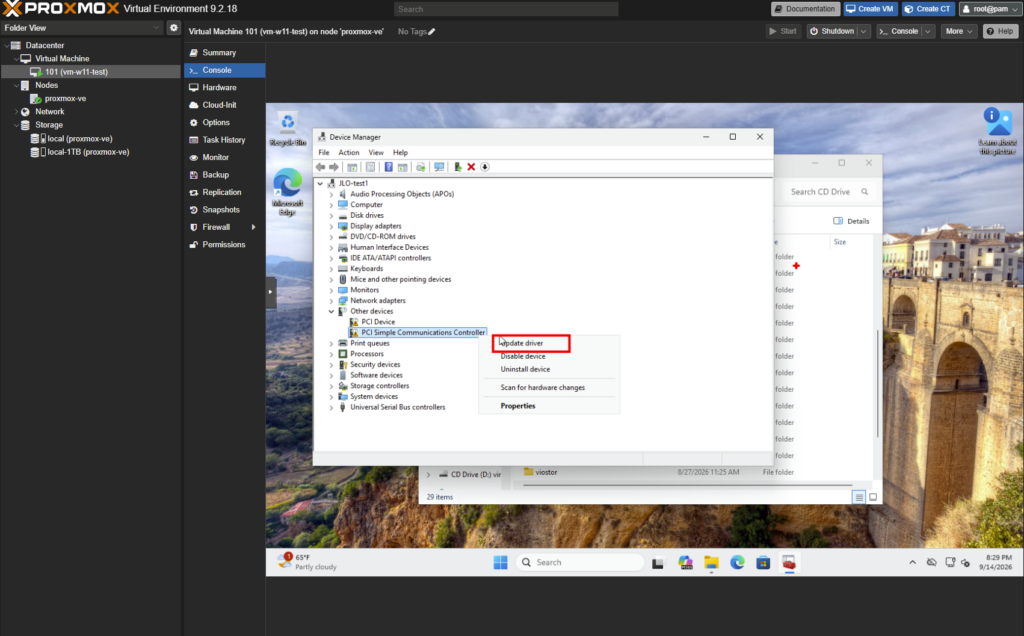
Dans Windows, ouvrez le gestionnaire des périphériques afin de mettre à jour le driver suivant :
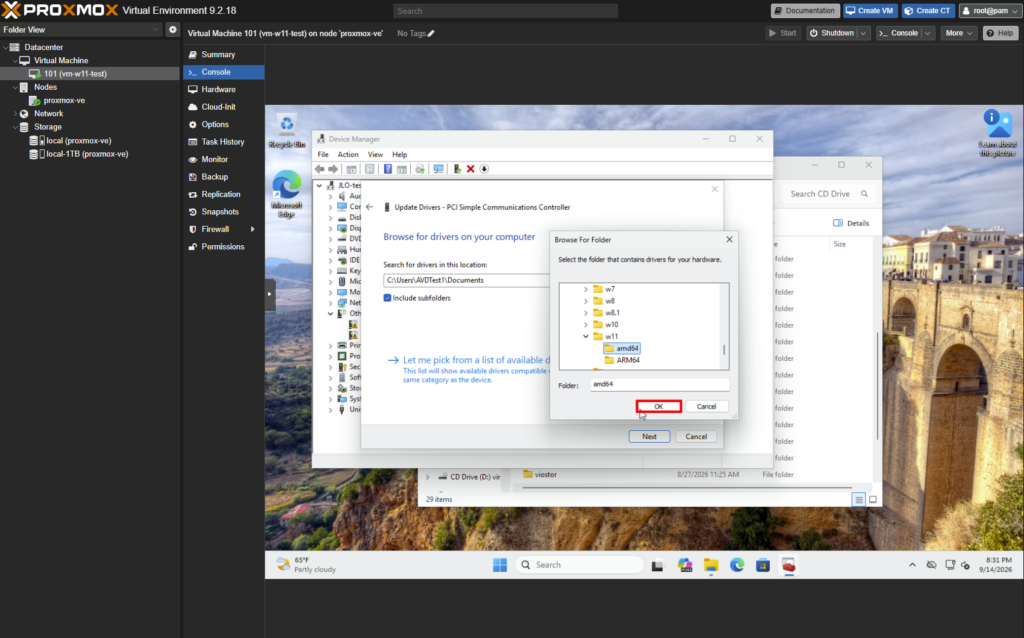
Choisissez le dossier correspondant à l’OS de votre VM :
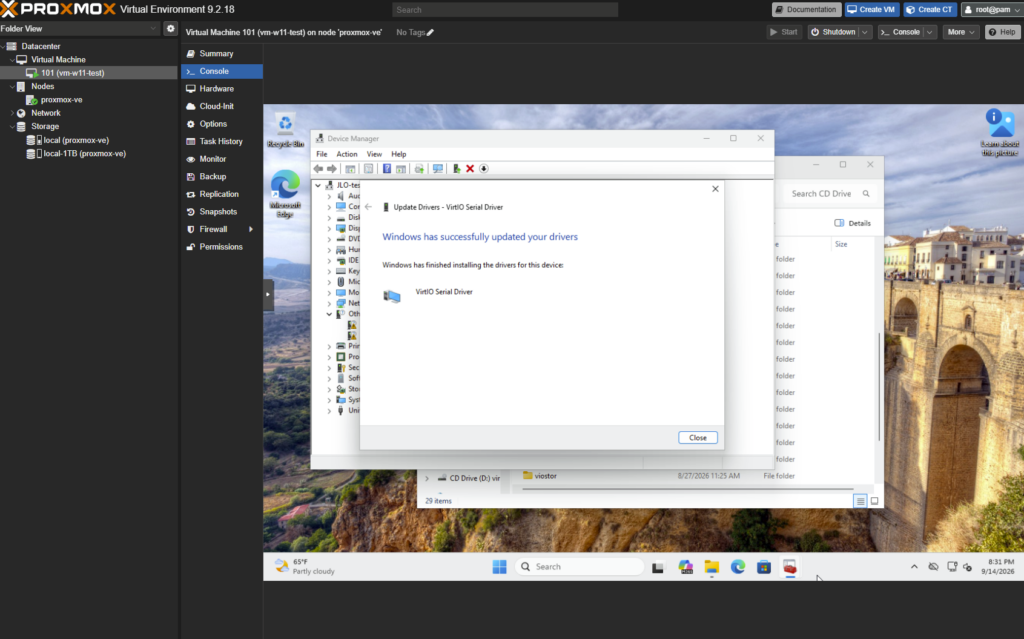
Attendez le succès de l’installation :
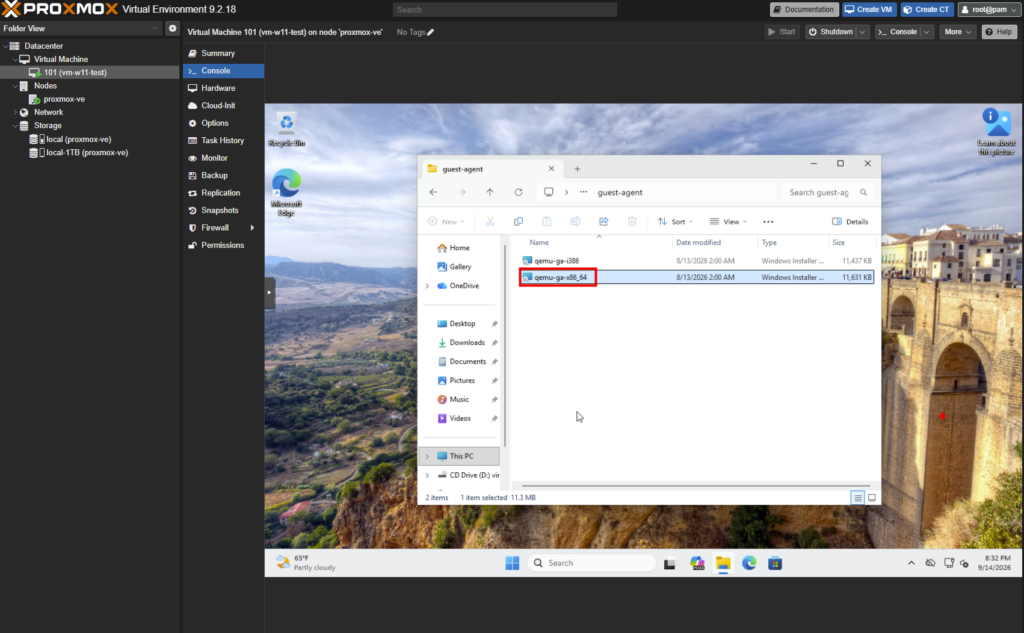
ouvrez le lecteur et lancez le paquet du dossier guest-agent, en version 64 bits. Il installe uniquement le service QEMU Guest Agent, visible ensuite dans la console des services, et ne touche ni au contrôleur de disque ni à la carte réseau :
Mon retour terrain : c’est le seul morceau de l’ISO virtio-win que j’installe dès le premier jour sur un invité Windows. Le reste, pilotes de disque et de carte réseau, demande une procédure plus prudente et fera l’objet d’un article à part, parce qu’un disque système basculé trop vite en VirtIO SCSI vous accueille au redémarrage avec un écran bleu INACCESSIBLE_BOOT_DEVICE.
Vérifier que ça marche
Retournez sur l’onglet Summary de la VM : les adresses IP de l’invité doivent maintenant s’afficher, avec l’adresse distribuée par votre dnsmasq dans la plage 10.10.10.100 à 10.10.10.200 :
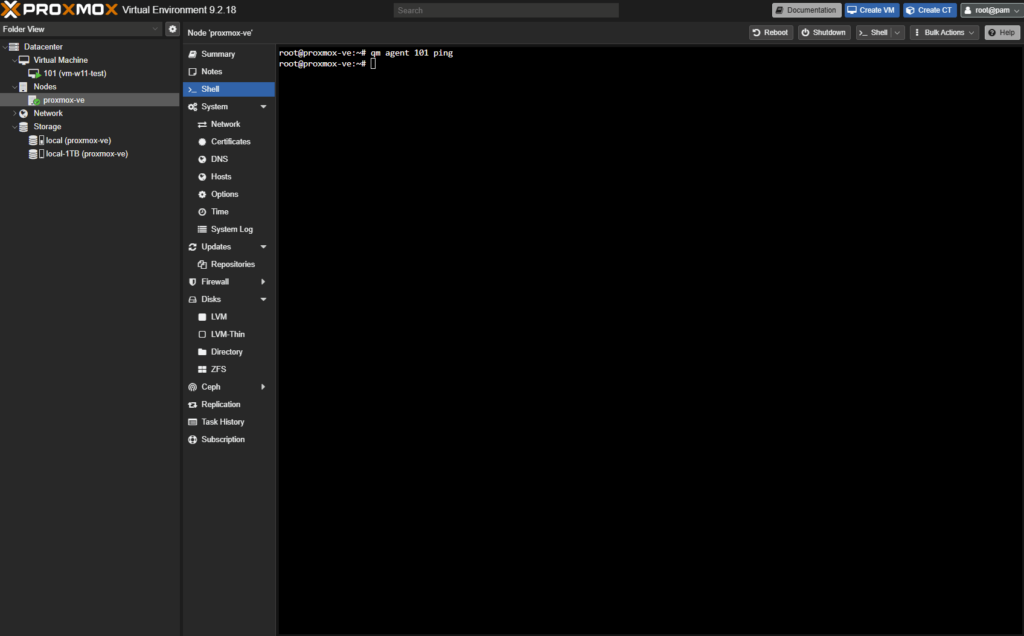
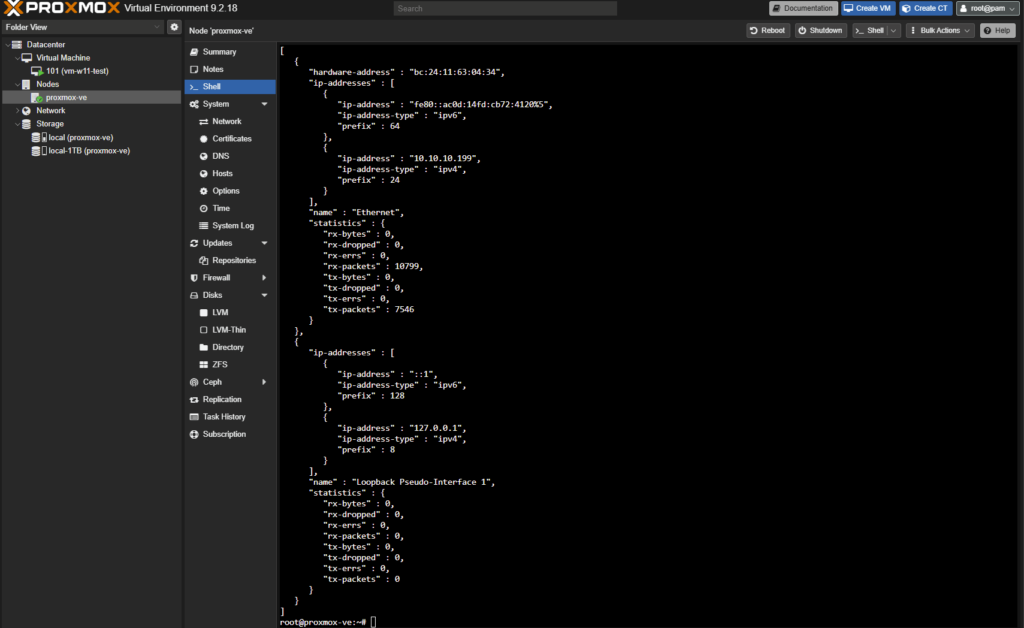
Depuis le shell du nœud, deux commandes confirment le dialogue.
La première ne renvoie rien quand tout va bien, ce qui est la définition d’un bon silence :
La seconde vous rend la configuration réseau vue de l’intérieur de Windows, au format JSON :
Remplacez 101 par le VMID de votre machine.
18. Les pièges à retenir
Le piège
Le symptôme
La parade
Mauvaise taille de VM Azure
/dev/kvm absent, Proxmox ne démarre aucune VM
Prendre une taille qui prend en charge la virtualisation imbriquée, Dsv3 par exemple
Port 8006 fermé
L’interface web ne répond pas alors que le service écoute
Ajouter une règle entrante dans le NSG, limitée à votre adresse IP
Nom d’hôte non résolu
Installation bancale, interface web incomplète
Ajouter la ligne adresse privée et nom d’hôte dans /etc/hosts avant d’installer
Mauvais disque dans GRUB
Chaîne de démarrage incohérente
Cocher /dev/sda uniquement dans l’écran bleu grub-pc
Utilisation de sdb
Disques de VM perdus après une désallocation
Ne stocker que sur le disque de données, monté par UUID
Bridge sur la carte Azure
Les invités n’ont aucune connectivité
Bridge isolé avec bridge-ports none, plus NAT et dnsmasq
Plans d’adressage qui se chevauchent
Routage imprévisible entre invités et réseau Azure
Sous-réseau Azure et réseau interne dans deux plages distinctes
Disque en VirtIO SCSI
Aucun disque proposé par le programme d’installation Windows
Basculer le disque en SATA, ou charger les pilotes VirtIO
Pas de TPM ni d’UEFI
« This PC can’t run Windows 11 »
OVMF, disque EFI, Pre-Enroll keys et TPM 2.0 dès la création
Guest agent activé sans arrêt complet
L’agent est installé mais aucune adresse IP ne remonte
Arrêter puis démarrer la VM depuis Proxmox, pas un simple redémarrage Windows
Dépôt sans abonnement
Avertissement jaune et boîte de dialogue à chaque connexion
Parfait pour un lab, à remplacer par le dépôt entreprise en production
VM Azure laissée allumée
Une facture désagréable en fin de mois
Arrêter et désallouer, puis supprimer le groupe de ressources
Conclusion
Voilà, en quatorze étapes, vous avez un hyperviseur Proxmox VE 9 complet, avec son stockage dédié, son réseau interne routé, son interface web accessible, et une machine virtuelle Windows 11 qui tourne dedans, agent invité compris. Le tout sans acheter un seul serveur.
Concrètement, ça donne quoi ? Vous avez de quoi vous former sur Proxmox, tester des scénarios de migration, comparer honnêtement ce que fait la concurrence avec ce que vous connaissez déjà, et tout détruire d’un clic quand vous avez fini. Pour quelqu’un qui vit dans Azure toute la journée, c’est la façon la moins coûteuse de sortir de sa zone de confort.
Les trois points que je retiens de ce lab : la taille de la VM Azure décide de tout dès le premier écran, le réseau imbriqué se traite par du NAT et pas par du bridge, et le couple SATA plus E1000 fait gagner un temps fou sur l’installation d’un invité Windows.
Foncez tester, et n’oubliez pas de désallouer la VM en partant. Le prochain article sera consacré au passage en VirtIO d’un invité Windows déjà installé, disque et carte réseau : c’est le gain de performances évident de ce lab, mais c’est aussi la manipulation qui casse le plus de machines quand on la fait dans le mauvais ordre. On ira voir ensuite les instantanés et les sauvegardes.
🤖
Contenu assisté par IACet article a été rédigé avec l’assistance d’une intelligence artificielle et relu par l’auteur. Conformément à l’AI Act (UE) en vigueur depuis le 2 août 2026.
Vous avez un Cloud PC qui refuse de provisionner, un Win32 qui ne descend jamais, une session qui rame sans raison apparente, et vous passez trois jours à interroger Intune alors que le coupable est une règle de pare-feu écrite il y a deux ans ? Cet article est fait pour vous. On part d’une VM Windows toute neuve et on va dérouler, capture après capture, un diagnostic réseau complet de vos endpoints Microsoft Intune, Windows 365 et Azure Virtual Desktop, puis on va casser le réseau exprès pour vérifier que l’outil dit bien la vérité.
Il ne s’agit pas d’un produit commercial ni d’un module à installer : c’est un script PowerShell unique, sans dépendance, qui teste en un seul run l’ensemble des prérequis réseau que Microsoft publie sur quatre pages de documentation différentes.
Pour vous guider plus facilement dans cet article, voici des liens rapides :
1. Le vrai problème : des prérequis réseau éparpillés
Le problème, ce n’est pas la difficulté technique, c’est le périmètre. La documentation Windows 365 le dit noir sur blanc : les prérequis se répartissent sur quatre familles distinctes, l’appareil physique, le service Microsoft Intune, la machine virtuelle session host Azure Virtual Desktop et le service Windows 365.
Although most of the configuration is for the Cloud PC network, end user connectivity occurs from a physical device. Therefore, you must also follow the connectivity guidelines on the physical device network.
Puis extraire à la main les FQDN, les recopier dans un tableur, et lancer une boucle de Test-NetConnection maison en espérant n’avoir rien oublié…
Concrètement, ça donne quoi ? Ça donne un Cloud PC parfaitement provisionné dont l’utilisateur n’arrive pas à se connecter, parce que le poste physique dans l’agence de Lyon sort par un proxy qui ne connaît pas les endpoints du client Windows App. Vous avez validé le réseau Azure, vous n’avez pas validé le réseau du poste. Deux périmètres, deux jeux de règles, deux équipes différentes.
Mon retour terrain : le ticket qui revient le plus souvent n’est pas « rien ne marche », c’est « ça marche pour 90 % des gens ». Et un taux de 90 %, en réseau, c’est presque toujours la signature d’un site, d’un breakout Internet ou d’un profil de proxy qui diverge du reste du parc.
2. D’où vient l’outil et ce qu’il couvre
Le script a une histoire. Il démarre comme un vérificateur réseau Windows 365, publié en février 2026 sous le nom The Ultimate Windows 365 Network Validation Script. Daniel Bowker l’a ensuite élargi bien au-delà de son périmètre initial, et la version 4 marque le vrai basculement : Microsoft Intune obtient sa propre validation dédiée, à côté de Windows 365 et d’Azure Virtual Desktop.
Résultat, la version 4.1 s’appelle désormais Test-CloudEndpointNetworkHealth.ps1. L’ancien nom Test-W365NetworkHealth.ps1 reste disponible comme lanceur de compatibilité, pour ne pas casser les scripts et les runbooks écrits avant le renommage.
Élément
Valeur
Nom du script
Test-CloudEndpointNetworkHealth.ps1
Version couverte ici
v4.1
Auteur
Daniel Bowker, Microsoft MVP Windows 365
Licence
MIT
Dépendances
Aucune, PowerShell seul
Jeu d’endpoints
445 entrées, cloud Microsoft commercial
Périmètre
Microsoft Intune, Windows 365, Azure Virtual Desktop
Fichier de données
Endpoints.csv, téléchargé automatiquement
Le point qui m’a le plus intéressé n’est pas le nombre d’endpoints, c’est la nature des tests. Un script de validation réseau naïf fait un Test-NetConnection sur le port 443 et affiche un joli vert. Celui-ci va nettement plus loin :
vrai handshake TLS avec SNI, pas un simple socket ouvert sur 443
détection de l’inspection SSL probable via l’analyse de la chaîne de certificats
échecs DNS remontés séparément des échecs de port
endpoints wildcard réellement testés quand c’est possible
test UDP réel pour RDP Shortpath
test SNTP/NTP, avec mesure de la dérive d’horloge
vérification d’Azure IMDS et de WireServer
test de connectivité IPv6
mesure de la latence de connexion
détection d’interception par ZTNA ou Secure Web Gateway
validation du port 80 là où Microsoft exige 80 et 443
tests parallélisés et déduplication des couples hôte/port
Cette liste compte douze améliorations, et chacune correspond à un faux positif que vous avez probablement déjà rencontré en production sans le savoir.
3. Workload et Mode : la distinction que tout le monde rate
Au lancement, le script pose deux questions. Elles se ressemblent, elles n’ont rien à voir. C’est le point de design le plus important de l’outil et c’est aussi celui qui provoque le plus de mauvaises interprétations.
La première question, c’est le workload, autrement dit ce que vous validez :
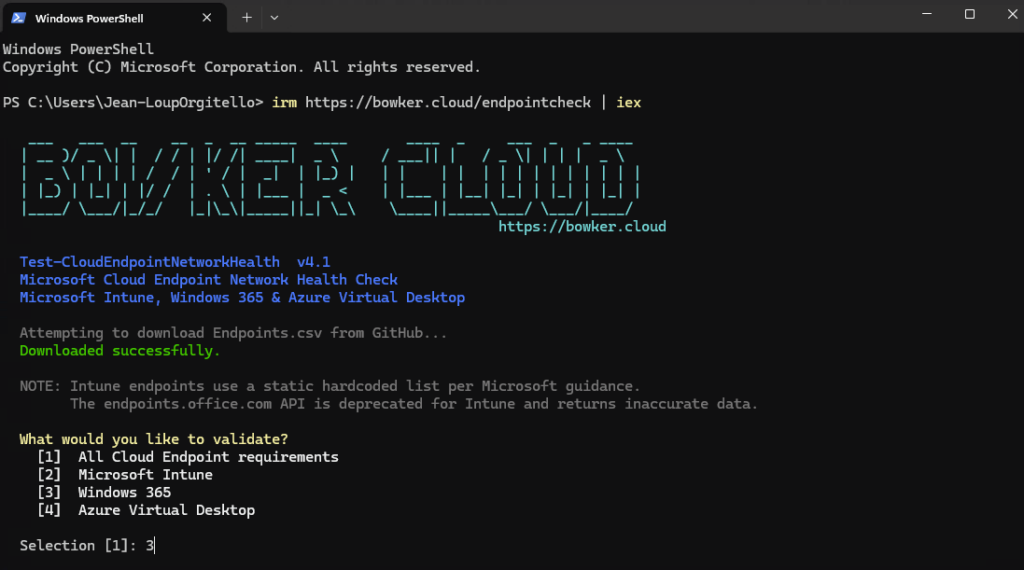
[1] All Cloud Endpoint requirements
[2] Microsoft Intune
[3] Windows 365
[4] Azure Virtual Desktop
Workload égale QUOI, Mode égale OÙ. Retenez ces deux mots et vous ne vous tromperez plus. Un même workload Intune se teste indifféremment depuis un Cloud PC ou depuis un poste physique managé, parce que les prérequis Intune sont des prérequis d’appareil, pas des prérequis de datacenter.
Workload
Ce qui est validé
All
Tout ce qui suit. C’est la valeur par défaut.
Intune
Les prérequis réseau Microsoft Intune publiés pour les appareils Windows
Windows365
Les endpoints du service Windows 365, plus les dépendances AVD, Intune et plateforme Azure sur lesquelles il repose
AVD
Les prérequis Azure Virtual Desktop côté session host et côté client
Le choix de conception à saluer se trouve dans la ligne Windows365. Sélectionner ce workload ne teste pas seulement les FQDN du service Windows 365. Un Cloud PC est un poste managé par Windows 365 qui s’appuie sur Intune, sur les composants de connectivité Azure Virtual Desktop et sur des services de plateforme Azure. Ne tester que les endpoints *.infra.windows365.microsoft.com vous donnerait un résultat entièrement vert alors qu’une vraie dépendance reste bloquée.
Symétriquement, le workload Windows365 exclut volontairement les fonctionnalités Intune optionnelles dont un Cloud PC n’a pas besoin pour être provisionné, managé ou joignable, comme Remote Help et le Microsoft Store. Vous ne verrez donc pas de rouge sur des services que vous n’utilisez pas.
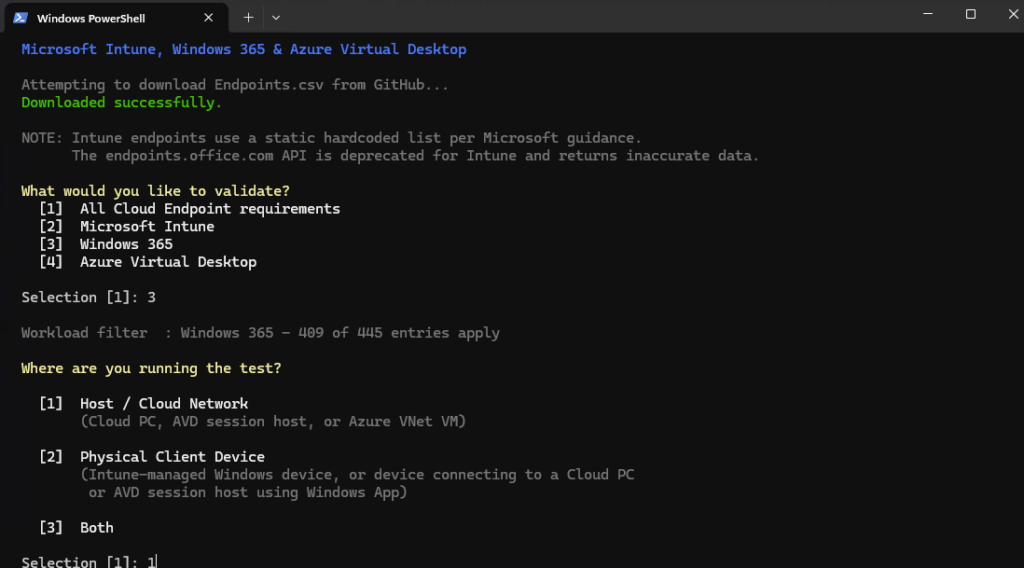
La seconde question, c’est le mode, autrement dit d’où vous testez :
[1] Host / Cloud Network
    (Cloud PC, AVD session host, or Azure VNet VM)
[2] Physical Client Device
    (Intune-managed Windows device, or device connecting to a
     Cloud PC or AVD session host using Windows App)
[3] Both
Attention : Remote Help et Microsoft Store restent dans leurs propres catégories quand vous lancez le workload Intune. Un rouge sur ces lignes ne signifie pas que votre environnement est cassé, juste que vous n’ouvrez pas ces flux. Lisez la catégorie avant de paniquer.
4. Étape 0 : les prérequis avant de lancer quoi que ce soit
Avant la moindre commande, trois règles.
Règle 1, lisez le script avant de l’exécuter. L’auteur documente lui-même la procédure, et c’est tout à son honneur. Un irm | iex exécute du code distant sans que vous ne l’ayez vu, et cette pratique n’a rien à faire dans un environnement de production sans revue préalable :
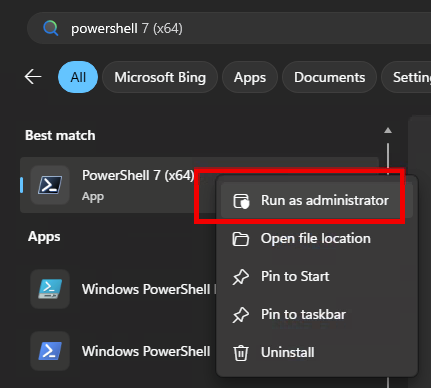
Règle 2, exécutez en session élevée. Certaines vérifications de la fabric Azure se comportent différemment hors élévation et peuvent apparaître injoignables alors que tout va bien. Administrateur local suffit, pas besoin d’aller plus loin.
Règle 3, PowerShell 7 de préférence. Windows PowerShell 5.1 fonctionne, mais 7 est la cible recommandée par l’auteur. Pour lancer le script, rien de plus simple et aucune dépendance à installer :
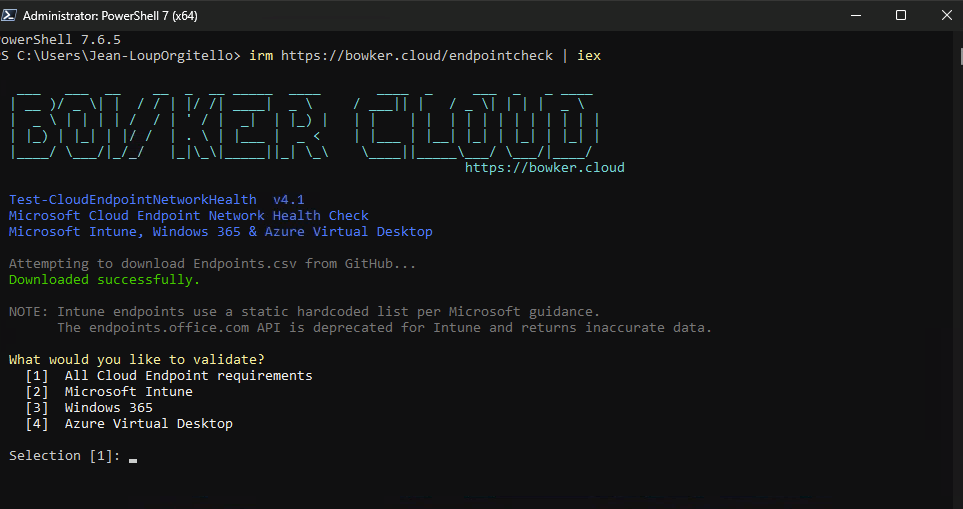
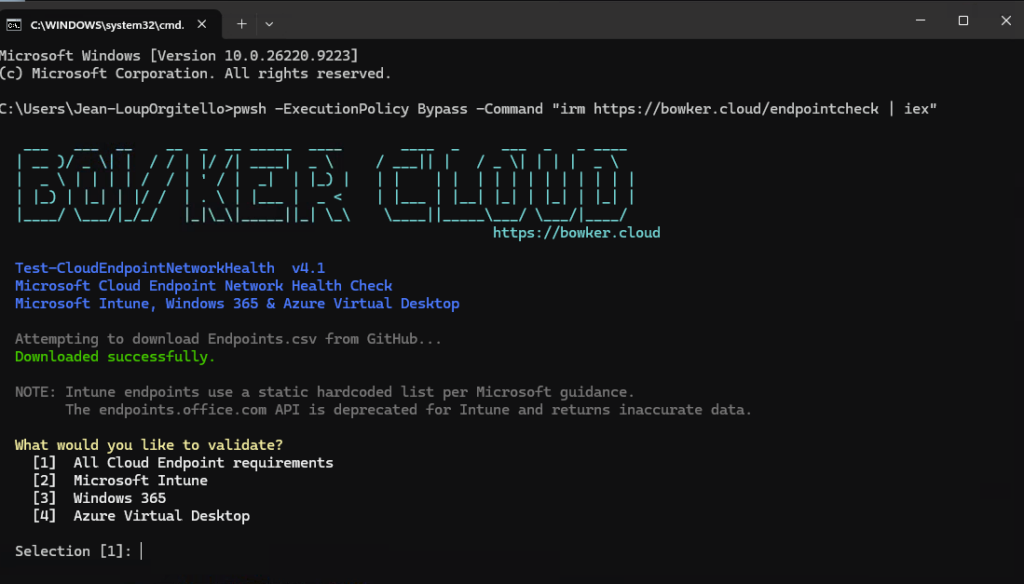
irm https://bowker.cloud/endpointcheck | iex
Ce dernier point mérite d’être souligné : le script ne demande aucun rôle Entra ID, aucun consentement d’application, aucune permission Graph. Il ne lit pas votre tenant. Il teste des sockets. C’est ce qui le rend utilisable par une équipe réseau qui n’a aucun droit dans Intune, et c’est précisément le genre de cloisonnement qu’on rencontre dans les grandes structures.
Voici les paramètres disponibles, tels que documentés dans le dépôt :
Désactive le filtrage optionnel des plages IP Intune. Alias : -NoRegionFilter
Off
-SkipRegionPicker
Ancien nom de paramètre, conservé pour compatibilité
Off
-MaxParallel
Nombre de sondes concurrentes
12
Attention : ne montez pas -MaxParallel à l’aveugle. Douze sondes concurrentes, c’est déjà un profil de trafic qui ressemble beaucoup à du scan sortant. Sur un site protégé par un IPS ou une solution ZTNA agressive, vous risquez de déclencher une alerte SOC ou de vous faire jeter au bout de trente secondes, et vos résultats seront faussés. Prévenez l’équipe sécurité avant le run.
5. Étape 1 : le premier run et la baseline tout verte
Toute la démarche de cet article repose sur une idée simple : un diagnostic ne vaut rien sans point de comparaison. On commence donc par un run de référence sur une machine dont on sait que le réseau est sain, et on garde le résultat sous le coude.
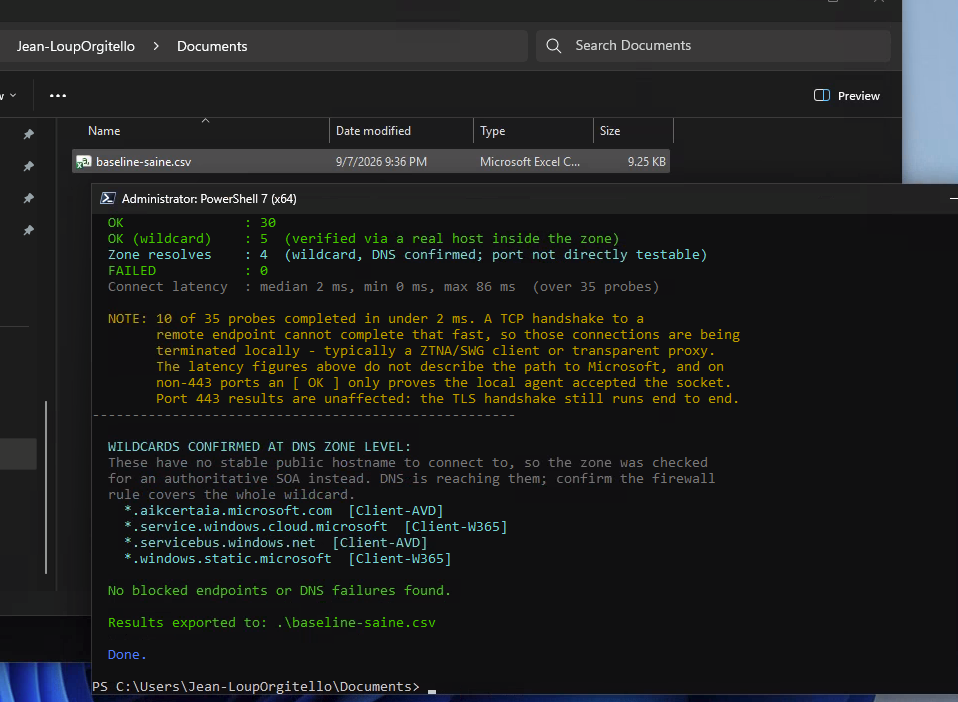
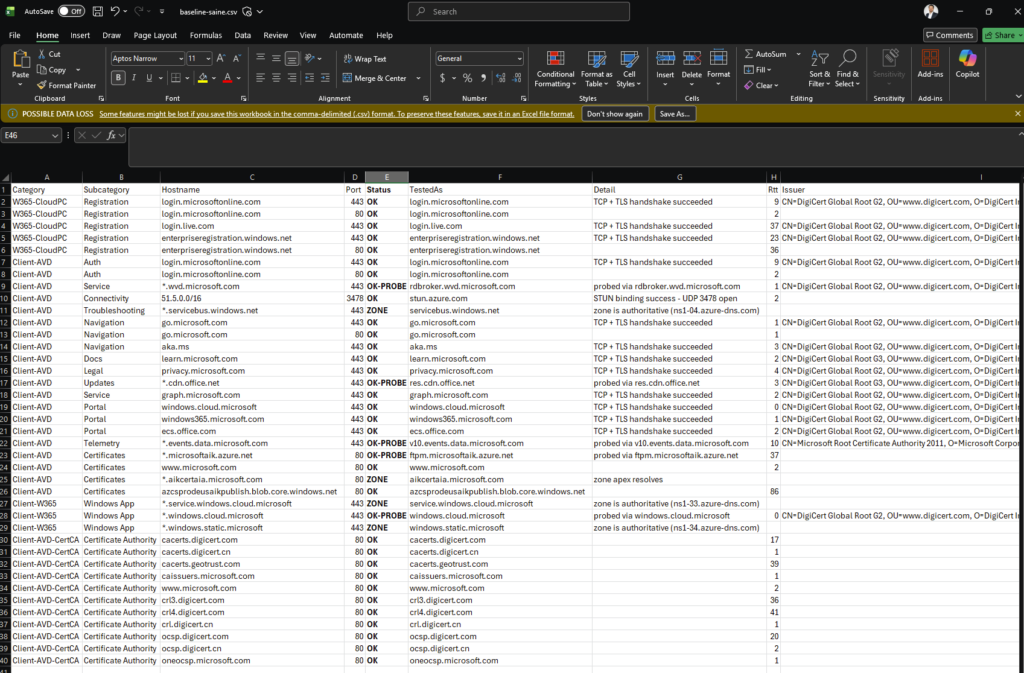
Et pour la baseline de cet article, la version explicite avec export CSV, celle que je vous recommande parce qu’elle vous laisse une trace exploitable à lancer depuis une fenêtre PowerShell :
& ([scriptblock]::Create((irm https://bowker.cloud/endpointcheck))) -Workload All -Mode 2 -OutputPath .\baseline-saine.csv
Mon retour terrain : exportez systématiquement en CSV avec -OutputPath, même quand tout est vert. Le jour où un utilisateur remonte un problème, la comparaison entre le CSV du jour et celui de la mise en service vaut mille suppositions. C’est la même logique qu’un baseline de performance, appliquée au réseau.
6. Lire les résultats : OK, FAIL, DNS!, TLS!, INSP, ZONE, INFO
C’est ici que l’outil se distingue vraiment des scripts maison. La plupart des validations réseau que j’ai vues chez des clients renvoient deux états : ça passe ou ça ne passe pas. Or un problème DNS, un blocage de pare-feu et une inspection SSL cassent tous les trois le service, mais appellent trois correctifs radicalement différents, portés par trois équipes différentes.
Statut
Signification
[ OK ]
Connecté. Sur le port 443, cela signifie un handshake TLS complet avec SNI là où c’est supporté
[FAIL]
Le DNS a résolu, mais la connexion a échoué
[DNS!]
Le nom d’hôte n’a pas résolu
[TLS!]
Le TCP est établi, mais le handshake TLS a échoué
[INSP]
Le TLS aboutit, mais la chaîne de certificats suggère une inspection SSL probable
[ZONE]
Le wildcard n’a pas de nom d’hôte public stable, la zone DNS parente a été validée à la place
[INFO]
Plage IP publiée, vérification propre à Azure, entrée de référence ou autre résultat informatif
Cette granularité change la nature de la conversation. Avec un simple rouge, vous ouvrez un ticket réseau et vous attendez. Avec un [DNS!], vous savez que le pare-feu n’est pas en cause et vous allez voir l’équipe qui gère la résolution de noms. Avec un [INSP], vous savez qu’il faut demander une exclusion d’inspection, pas une ouverture de flux : le flux est déjà ouvert.
Sur ce dernier point, Microsoft est parfaitement explicite dans la documentation Windows 365 :
These traffic interception technologies can cause issues with running Azure network connection checks or Cloud PC provisioning. Make sure no network interception is enforced for Cloud PCs provisioned within the Windows 365 service.
Autrement dit, un environnement où l’inspection SSL est appliquée aux Cloud PC est un environnement hors des rails documentés, et le statut [INSP] est le seul moyen simple que je connaisse de le prouver en une capture d’écran devant l’équipe sécurité.
Deux subtilités à connaître, et elles évitent des faux diagnostics :
Certains endpoints CDN de Windows Update et Delivery Optimization sont volontairement exclus de la validation TLS, parce que les certificats renvoyés par le CDN ne couvrent pas de façon fiable le nom d’hôte Microsoft. Ces entrées sont testées en TCP seul, pour éviter de générer un faux [TLS!].
Les wildcards ne sont plus systématiquement ignorés. Quand il n’existe pas de nom d’hôte public stable derrière, c’est la zone DNS parente qui est validée, d’où le statut [ZONE]. Ce n’est ni un succès complet ni un échec, c’est une validation partielle assumée.
7. Le lab de pannes : on casse le réseau exprès
Le moment de vérité. Un outil de diagnostic qui affiche du vert quand tout va bien, ce n’est pas un exploit. Ce qu’on veut savoir, c’est s’il dit la vérité quand ça va mal, et surtout s’il désigne la bonne cause. J’ai donc monté une VM Windows jetable et j’ai cassé le réseau, panne par panne, avec un run du script après chaque manipulation.
Attention : toutes les manipulations qui suivent se font sur une machine virtuelle jetable, hors production, et de préférence non managée par Intune. Bloquer un port sortant ou casser la résolution DNS sur un poste de production vous fera perdre bien plus de temps que le diagnostic que vous cherchiez à poser.
Voici le rendu du script avant toute modification de la configuration :
Cas n°1 : la résolution DNS est cassée
Le scénario réel derrière ce cas : un serveur DNS interne injoignable, un forwarder mal configuré, ou un split-brain DNS où la zone publique Microsoft n’est plus résolue depuis le réseau interne. C’est fréquent, et c’est très mal diagnostiqué, parce que l’utilisateur décrit un symptôme applicatif alors que le problème est au niveau de la résolution.
La manipulation, dans une console élevée sur la VM de test. On note d’abord la configuration DNS actuelle pour pouvoir la remettre :
Get-DnsClientServerAddress -AddressFamily IPv4

# On pointe la carte vers un resolveur qui n'existe pas
Set-DnsClientServerAddress -InterfaceAlias "Ethernet" -ServerAddresses 127.0.0.1
Clear-DnsClientCache
Puis on relance le script. Le résultat attendu est une avalanche de [DNS!], et surtout aucun [FAIL] : le script doit dire que rien n’a résolu, pas que les ports sont bloqués.
Et là, magie : là où un script maison basé sur Test-NetConnection vous aurait affiché un mur de rouge indifférencié, envoyant l’équipe réseau chercher une règle de pare-feu inexistante pendant deux jours, vous avez immédiatement la bonne piste.
Pour restaurer, remettez l’adresse notée à l’étape précédente, ou repassez en DHCP :
Cas n°2 : DNS partiellement cassé, une seule zone tombe
Le cas précédent est brutal et facile à diagnostiquer même sans outil. Le cas vicieux, celui qui coûte vraiment des journées, c’est la panne partielle : tout résout, sauf une famille de noms. Un enregistrement de blocage laissé dans le DNS interne, une entrée hosts oubliée par un collègue en test, une politique de filtrage DNS qui sinkhole une zone.
On simule ça proprement avec le fichier hosts, en pointant un endpoint Windows 365 vers une adresse inexploitable :
notepad C:\Windows\System32\drivers\etc\hosts
Ajouter la ligne suivante, puis enregistrer
192.0.2.1 rdbroker.wvd.microsoft.com
Lancer la commande suivante pour purger le cache :
Clear-DnsClientCache
Ici le nom résout, mais vers une adresse qui ne mène nulle part. Le comportement attendu n’est donc pas le même que dans le cas n°1, et c’est tout l’intérêt de la démonstration. La ligne concernée doit basculer en [FAIL], pas en [DNS!], pendant que le reste du run reste vert :
Le piège classique : sur ce genre de panne, l’utilisateur vous dira que « AVD ne marche pas », alors que le provisioning, l’authentification et Intune fonctionnent parfaitement. Seul le broker de connexion est injoignable. Sans un test endpoint par endpoint, vous cherchez au mauvais endroit.
Pensez à retirer la ligne du fichier hosts et à vider le cache DNS avant de continuer, sinon elle va polluer tous vos runs suivants.
Cas n°3 : le port 5671 bloqué, le grand classique du provisioning
Si vous ne deviez retenir qu’un seul cas de cet article, c’est celui-là. La documentation Windows 365 exige que les endpoints d’enregistrement IoT Hub soient joignables sur deux ports, 443 et 5671, en sortie :
Or, dans la vraie vie, une équipe réseau qui reçoit une demande d’ouverture pour Windows 365 ouvre le 443 et considère le travail terminé. Le 5671, c’est de l’AMQP, ça ne ressemble pas à du web, et ça passe très souvent à la trappe. Résultat : le Cloud PC ne s’enregistre jamais auprès du service de santé, le provisioning échoue ou reste bloqué, et tous les tests web que vous ferez à la main répondront correctement.
On reproduit la panne avec une règle de pare-feu sortante :
Voilà la démonstration que je cherchais. Le script teste le couple hôte et port, pas seulement l’hôte. Vous voyez le même FQDN en vert sur une ligne et en rouge sur l’autre, et la conversation avec l’équipe réseau devient triviale : le flux existe, il manque un port.
Mon retour terrain : le 5671 est le port oublié numéro un des déploiements Windows 365 avec Azure Network Connection. Juste derrière, le port 80 sur les endpoints où Microsoft exige à la fois 80 et 443, typiquement pour les listes de révocation de certificats. Le script valide ce cas explicitement, et c’est une bonne raison de ne pas se contenter d’un test sur 443.
Cas n°4 : l’UDP coupé, la session qui rame sans jamais tomber
Celui-ci est le plus sournois de tous, parce qu’il ne produit aucune erreur. Rien ne tombe. L’utilisateur se connecte, travaille, et vous dit simplement que « c’est mou ». Vous regardez les logs, tout est vert, et vous concluez à un problème de perception.
Ce qui se passe réellement, la documentation Azure Virtual Desktop l’explique très bien. RDP démarre sur un transport TCP en reverse connect, puis tente d’établir la session en UDP. Si l’UDP réussit, le TCP est abandonné. Sinon, le TCP sert de solution de repli :
By default, the Remote Desktop Protocol (RDP) begins a TCP-based reverse connect transport, then tries to establish a remote session using UDP. If the UDP connection succeeds the TCP connection drops, otherwise the TCP connection is used as a fallback connection mechanism.
Ce mécanisme de repli est une excellente idée pour la disponibilité, et une catastrophe pour le diagnostic : il transforme une panne franche en dégradation silencieuse. C’est exactement la raison pour laquelle le test UDP réel de RDP Shortpath est, à mon sens, la fonctionnalité la plus sous-estimée de ce script.
Pour reproduire, on bloque l’UDP sortant sur la VM de test. Lancez d’abord un run normal et relevez dans la sortie le port UDP effectivement testé par le script pour Shortpath, puis créez la règle correspondante :
Regardez bien cette capture. C’est le seul rouge de tout le run. Sans ce test, votre validation réseau aurait été déclarée conforme à 100 %, et vous auriez cherché la cause du côté du dimensionnement du Cloud PC ou de la carte graphique. Une ligne rouge, quelques secondes de lecture, et vous savez qu’il faut aller ouvrir l’UDP sortant.
Les cas que je n’ai pas provoqués, mais que le script sait détecter
Par souci d’honnêteté, je ne décris ici que ce que j’ai réellement cassé et observé. Trois autres capacités de l’outil méritent d’être connues, même si je ne les ai pas mises en scène dans ce lab :
l’inspection SSL, qui remonte en [INSP] lorsque la chaîne de certificats renvoyée ne correspond pas à ce que Microsoft présente normalement
le handshake TLS qui échoue alors que le TCP passe, qui remonte en [TLS!], typiquement quand un Secure Web Gateway accepte le socket puis refuse le nom d’hôte au moment du SNI
la dérive d’horloge, mesurée via le test SNTP/NTP, cause classique et rarement soupçonnée d’échecs d’authentification
Si vous disposez d’un proxy d’inspection dans votre environnement de test, ces trois cas se provoquent facilement et feraient un excellent complément à ce lab.
8. Du symptôme utilisateur au correctif réseau
Voici la table de correspondance que j’ai construite à partir de ce lab. C’est elle que je garderais sous le coude en support N2, parce qu’elle part de ce que l’utilisateur dit, pas de ce que la console affiche.
Ce que dit l’utilisateur
Statut renvoyé par le script
Où aller chercher
Plus rien ne fonctionne depuis ce matin
[DNS!] massif
Résolution de noms, forwarders, serveurs DNS de la carte réseau
Windows 365 ne marche pas, mais je reçois mes mails
[FAIL] isolé sur un endpoint
Filtrage DNS, entrée hosts, sinkhole sur une zone précise
Mon Cloud PC est resté en cours de provisioning
[FAIL] sur azure-devices.net en 5671
Pare-feu sortant, port AMQP non ouvert
C’est lent, mais ça marche
Échec du test UDP Shortpath
UDP sortant bloqué, repli TCP en cours
Ça marche à Paris, pas à Lyon
Résultats divergents entre deux runs
Breakout Internet local, profil de proxy par site
Je n’arrive pas à me connecter mais le Cloud PC est vert dans Intune
Échecs en Mode 2 uniquement
Réseau du poste physique, pas le réseau Azure
La dernière ligne mérite un mot. C’est le scénario le plus courant et le plus mal traité, parce que les deux équipes concernées regardent chacune leur périmètre et le déclarent sain. Lancer le script en Mode 2 depuis le poste de l’utilisateur qui se plaint tranche le débat en trois minutes.
9. Ce que l’outil ne fait pas
Un article qui ne présente que les qualités d’un outil ne vous sert à rien. Voici les limites, et elles sont d’ailleurs documentées honnêtement par l’auteur, ce qui est suffisamment rare pour être signalé.
Le jeu d’endpoints couvre le cloud Microsoft commercial. Si vous êtes en GCC, GCC High ou dans un cloud souverain, les FQDN diffèrent et ce jeu de données ne vous concerne pas.
Le workload Intune valide les prérequis réseau publiés par Microsoft pour les appareils Windows. Il ne prétend pas tester tous les endpoints de tous les produits qui s’intègrent à Intune.
Les produits qui disposent de leur propre documentation réseau, comme Microsoft Defender for Endpoint ou Security Copilot, ont des prérequis supplémentaires non couverts ici.
Le script teste la connectivité, pas la configuration du tenant. Un flux ouvert ne garantit pas qu’une stratégie Intune soit correctement ciblée.
Il ne mesure pas la bande passante ni la qualité de la liaison sous charge. La latence est reportée, mais ce n’est pas un outil de capacity planning.
Cinq limites, aucune n’est rédhibitoire, et toutes sont assumées par le périmètre annoncé. C’est un outil de diagnostic de connectivité, il fait ce qu’il dit.
Attention : le fichier Endpoints.csv est téléchargé automatiquement depuis GitHub à chaque exécution. Sur un réseau très fermé, c’est justement ce téléchargement qui va échouer en premier. Récupérez le CSV depuis un poste ayant accès à Internet et passez-le en local avec -EndpointsCSV, sinon vous allez diagnostiquer l’absence d’accès à GitHub plutôt que votre problème réel.
10. Conclusion et pièges à retenir
Voilà, en une commande et quatre pannes provoquées, nous avons vérifié qu’un script PowerShell gratuit, sans dépendance et sans le moindre droit sur le tenant, sait faire la différence entre un DNS cassé, un port fermé et un transport UDP absent. C’est exactement ce qu’on demande à un outil de diagnostic.
Concrètement, ça donne quoi ? Vous gagnez la capacité de qualifier un incident réseau avant de l’escalader. Vous arrivez devant l’équipe réseau avec une ligne précise, un hôte, un port, un protocole et un statut, au lieu d’un « Windows 365 ne marche pas » qui va tourner en boucle pendant une semaine.
Les cinq pièges à retenir :
Ne confondez pas Workload et Mode. Le premier dit ce que vous validez, le second dit d’où vous testez. Un run en Mode 1 ne vous apprend rien sur le poste de l’utilisateur.
Exécutez en session élevée, sans quoi les vérifications de la fabric Azure peuvent apparaître en échec alors qu’elles vont bien.
Le port 5671 n’est pas optionnel pour Windows 365. Un pare-feu qui n’ouvre que le 443 casse le provisioning sans jamais produire d’erreur web.
Un run entièrement vert en TCP ne prouve rien sur la qualité de session. Si l’UDP est bloqué, RDP bascule silencieusement sur son repli TCP et l’utilisateur subit sans que rien ne remonte.
Gardez une baseline. Exportez en CSV le jour de la mise en service, c’est ce qui vous permettra de comparer le jour où ça se dégrade.
Foncez tester. Le script est sous licence MIT, il ne demande aucun droit, il tourne sur une VM jetable en trois minutes, et le pire qui puisse vous arriver est de découvrir que votre réseau n’est pas aussi conforme que vous le pensiez. Ce qui, précisément, est le but recherché.
Contenu assisté par IACet article a été rédigé avec l’assistance d’une intelligence artificielle et relu par l’auteur. Conformément à l’AI Act (UE) en vigueur depuis le 2 août 2026.
Vous avez acheté des instances réservées (RI) Azure, vous vous êtes toujours dit qu’en cas de changement de workload vous pourriez les échanger, et vous découvrez maintenant que ce filet de sécurité va disparaître ? Cet article est fait pour vous. On part de l’annonce Microsoft du 30 juillet 2026 et on déroule ce qui change, ce qui ne bouge pas, les scénarios chiffrés, et le plan d’action à mener avant le 1er février 2027.
Pour rappel, jusqu’ici l’échange était le joker des réservations Azure : vous aviez surdimensionné une série de VM, vous vous étiez trompé de région, vous aviez migré de Dsv3 vers Dsv5, et hop, un échange remettait le compteur d’engagement à zéro et sans pénalité :
Ce joker se referme bientôt : à partir du 1er février 2027, si un service Azure est couvert par un saving plan, la réservation correspondante n’est plus échangeable.
Pour vous guider plus facilement dans ce changement à venir, voici des liens rapides :
Mais avant de rentrer dans ce sujet bientôt brûlant, et si les réservations d’instance ne sont pas encore votre tasse de thé :
Qu’est ce qu’une instance réservée Azure ?
Pour faire simple, les Azure RIs sont comme des places de parking que vous louer pour 1 ou 3 ans, et où les VM (ou d’autres services de compute), peuvent y être affectées, afin d’économiser des frais de stationnement, donc ici des coûts d’infrastructure auprès de Microsoft.
Voici une vidéo qui va vous éclairer sur les RIs :
Et voici une vidéo expliquant cette fois les saving plans :
Voici donc comment on peut voir comment faire son choix entre instance réservée et un saving plan :
La règle tient en une phrase, et Microsoft l’écrit noir sur blanc :
Starting February 1, 2027, reservations purchased after this date aren’t eligible for exchange if the corresponding service is supported by savings plans.
En clair, à partir du moment où un service dispose d’un savings plan, Microsoft considère que vous avez déjà l’outil de flexibilité qu’il vous faut, et retire donc la flexibilité de la réservation. Deux régimes cohabitent, et tout se joue sur la date d’achat.
Date d’achat de la réservation
Droit d’échange
Avant le 1er février 2027
Échanges illimités jusqu’au 31 janvier 2027, puis un échange final après cette date
À partir du 1er février 2027
Aucun échange possible
Le mot important est final. Une réservation active achetée avant la bascule conserve le droit à un échange, un seul, et la réservation issue de cet échange n’est plus échangeable du tout. Microsoft le confirme dans la FAQ de son annonce : une fois l’échange final consommé, la réservation obtenue ne peut plus être échangée.
La politique est aussi prospective, et c’est un point que beaucoup vont rater : tout produit compute ou base de données qui deviendra éligible aux savings plans après le 1er février 2027 tombera automatiquement sous la même règle, et les réservations déjà achetées pour ce produit basculeront à leur tour sur le régime de l’échange unique.
les réservations de produits non couverts par les savings plans, Azure VMware Solution étant l’exemple cité par Microsoft ;
Attention : si vous opérez dans un cloud souverain ou un environnement où les savings plans ne sont pas disponibles, vous n’êtes pas concerné aujourd’hui. Mais la formulation Microsoft dit bien « don’t currently support », donc le jour où le savings plan y arrive, la règle vous rattrape.
La première exclusion mérite qu’on s’y arrête, parce qu’elle recoupe directement un sujet que j’ai traité récemment. Les séries D, Ds, Dv2, Dsv2, Ls, Av2, Amv2, B, F, Fs, Fsv2, G, Gs et Lsv2 ont toutes une date de retraite annoncée en 2028, et j’ai détaillé ce calendrier dans VM Azure : anticipez les dépréciations. Ces séries entrent a priori dans la catégorie des produits dépréciés et proches de la fin de vie, donc dans l’exclusion.
Attention : Microsoft ne publie aucune liste nominative des produits couverts par cette exclusion. Si une part de votre portefeuille porte sur ces anciennes séries, faites confirmer le point par votre account team plutôt que de le déduire. Et rappelez-vous que pour la plupart d’entre elles, la question ne se pose déjà plus à l’achat : les réservations ne sont plus commercialisées depuis le 1er juillet 2026.
2. Les services concernés
La page Learn se contente de « Azure Virtual Machines, Azure App Service, Azure SQL Database, and similar services », ce qui est un peu court quand on doit auditer un portefeuille d’engagements. L’annonce sur le Tech Community, elle, donne la liste exacte au moment de la publication :
Compute
Bases de données
Azure Virtual Machines, y compris les échanges entre stockage non premium et premium
Azure Database for PostgreSQL
Azure Dedicated Host
Azure Database for MySQL
Azure App Service
Azure DocumentDB
Azure Cosmos DB
Azure SQL Database
Azure SQL Managed Instance
Soit trois services compute et six services de bases de données, neuf au total. Notez la mention entre parenthèses sur les VM : l’échange F1 vers F1s, celui qu’on utilisait tranquillement pour passer une réservation vers une taille compatible stockage premium, entre lui aussi dans le périmètre.
Attention : cette liste est celle du 30 juillet 2026. Microsoft précise que d’autres services éligibles aux savings plans viendront s’y ajouter. Ne la figez pas dans votre documentation interne sans date de revue.
À l’inverse, deux familles gardent leur échangeabilité complète parce qu’elles ne sont pas couvertes par les savings plans : Azure VMware Solution et Nutanix on Azure BareMetal, qui restent d’ailleurs des cibles d’échange valides au sein de la famille compute.
3. Ce qui ne change pas
Avant de paniquer, faisons le tri. Beaucoup de choses restent en place, et Microsoft insiste lourdement sur le fait que les réservations ne sont pas en cours de retrait.
L’instance size flexibility pour les VM n’est pas touchée. Votre réservation D4s_v5 continue de couvrir deux D2s_v5 sans que vous ayez quoi que ce soit à faire.
La politique d’annulation ne bouge pas : le plafond reste à 50 000 USD de commitment annulé sur 12 mois glissants, par billing profile ou par enrollment.
Le trade-in vers un savings plan reste possible, sans limite de date, et sa politique est inchangée.
L’achat et le renouvellement de réservations restent disponibles pour tous les services concernés.
Sur la question « est-ce que Microsoft tue les réservations ? », la FAQ officielle répond non, et précise que le changement porte uniquement sur l’échangeabilité. Ce qui disparaît, c’est le droit à l’erreur, pas le produit.
4. Pourquoi Microsoft fait ça : ma lecture
Ce n’est pas la première tentative
Avant d’analyser le pourquoi, un rappel qui change la lecture de toute l’annonce : Microsoft a déjà essayé de fermer ce robinet, deux fois, et a reculé les deux fois.
Octobre 2022, au moment même du lancement du savings plan : Microsoft annonce la dépréciation de l’échange des réservations compute au 1er janvier 2024. L’argumentaire est déjà mot pour mot celui d’aujourd’hui, le savings plan apportant la flexibilité automatiquement, la politique d’échange des réservations est ajustée en conséquence.
Octobre 2023, premier recul : une période de grâce repousse l’échéance à « au moins le 1er juillet 2024 », avec déjà le principe d’un dernier échange conservé pour les réservations achetées avant la fin de cette période.
Mai 2024, deuxième recul, et cette fois sans nouvelle date.
30 juillet 2026 : la notification promise arrive, pour le 1er février 2027. Six mois et deux jours de préavis. Microsoft tient son engagement au calendrier près.
Originally with a deadline of 1 July 2024, we have extended this and customers may continue exchanging their compute reservations for different instance series and regions until we notify them again, which will be at least 6 months in advance of the new deadline.
Cette phrase de 2024 est la clé pour comprendre pourquoi il faut prendre 2027 au sérieux. Le préavis promis vient d’être consommé. Il n’existe plus aucun engagement derrière lequel espérer un troisième report, et parier sur « ils vont encore reculer », c’est parier contre la seule garantie que l’on avait.
Il y a même un précédent dans l’autre sens, et il est récent. La fin des réservations un an sur les anciennes séries de VM était initialement fixée au 15 novembre 2027 : Microsoft l’a avancée au 1er juillet 2026, soit plus d’un an plus tôt que prévu. J’ai documenté cet épisode dans VM Azure : anticipez les dépréciations. Autrement dit, une date annoncée sur les engagements Azure peut aussi bien reculer que se rapprocher, et construire un plan sur l’hypothèse d’un report est le plus mauvais des paris.
Deuxième différence de taille : en 2022, la mesure ne visait que le compute, soit les réservations Azure Reserved Virtual Machine Instances, Azure Dedicated Host et Azure App Service. La version 2027 y ajoute six services de bases de données. Ce n’est pas la même annonce repoussée de trois ans, c’est une version élargie.
Attention : la trace du sursis de 2024 est toujours en ligne. La page Learn consacrée aux échanges et remboursements contient encore la mention d’une période de grâce permettant d’échanger les réservations compute « until further notice », à quelques lignes de l’encadré annonçant le 1er février 2027. Ne vous fiez pas à ce paragraphe résiduel, c’est la nouvelle date qui fait foi.
La justification officielle est l’alignement : Microsoft explique que la mesure aligne la politique d’échange des réservations sur la flexibilité déjà offerte par les savings plans, et donne un cadre de choix clair et prévisible entre les deux mécanismes d’engagement.
Concrètement, ça donne quoi ? Depuis l’arrivée du savings plan, Azure proposait deux produits qui se recouvraient partiellement : une réservation échangeable à volonté offrait à peu près la même souplesse qu’un savings plan, avec en prime une remise plus élevée. Le portefeuille était incohérent. En retirant l’échange, Microsoft rend les deux produits réellement distincts : la réservation devient un engagement ferme sur une configuration précise, avec la remise maximale ; le savings plan devient l’engagement souple, avec une remise plus faible mais applicable partout.
Mon retour terrain : l’échange était devenu, chez pas mal de clients, une béquille de mauvais dimensionnement. On achetait large « parce qu’on pourra toujours échanger », et on ajustait six mois plus tard. Cette pratique s’arrête. La conséquence directe : le travail de sizing et de prévision remonte en amont de l’achat, là où il aurait toujours dû être.
5. Cinq scénarios concrets
Les trois premiers cas sont ceux documentés par Microsoft, les deux suivants sont les questions que l’on me pose systématiquement en atelier FinOps.
Cas n°1 : réservation achetée avant la bascule
Vous achetez une réservation compute ou base de données d’un an ou trois ans avant le 1er février 2027. Vous pouvez l’échanger autant de fois que vous voulez tant que la date n’est pas passée. Si vous l’échangez après le 1er février 2027, la nouvelle réservation issue de l’échange n’est plus échangeable, parce que l’échange est traité comme une annulation, un remboursement et un nouvel achat, et que ce nouvel achat tombe sous les conditions du 1er février 2027.
Le piège classique est là : beaucoup vont croire qu’ils « gardent le droit d’échange » indéfiniment sur une réservation ancienne. Non. Le mécanisme d’échange fabrique une réservation neuve, et une réservation neuve après la bascule est verrouillée.
Cas n°2 : réservation achetée après la bascule
Vous achetez une réservation d’un an ou trois ans après le 1er février 2027. Vous ne pouvez pas l’échanger. Point. Il vous reste deux sorties : le trade-in vers un savings plan, toujours possible, et le remboursement dans la limite du plafond de 50 000 USD.
Cas n°3 : échange partiel de quantités
C’est le cas le plus intéressant et le moins connu. Vous achetez avant la bascule une réservation avec 10 quantités. Après le 1er février 2027, vous en échangez 2. Les 8 quantités restantes sur la réservation d’origine conservent chacune leur droit à un échange supplémentaire.
Autrement dit, l’échange final se compte à la quantité, pas à la réservation. C’est une marge de manœuvre réelle si vous savez déjà que votre parc va bouger par vagues : vous pouvez étaler vos ajustements plutôt que de tout jouer d’un coup.
Cas n°4 : l’échange coûte plus cher que prévu
Vous avez une réservation trois ans à 100 USD par mois, vous avez déjà payé 18 mensualités. Votre engagement restant est de 1 800 USD. Pour échanger, la nouvelle réservation doit avoir une valeur totale d’au moins 1 800 USD, que vous payiez au mois ou en une fois. Même logique sur un achat upfront : une réservation d’un an payée 2 400 USD, échangée après six mois, laisse un engagement restant de 1 200 USD, et la nouvelle réservation doit donc valoir 1 200 USD ou plus.
Et le terme repart de zéro. La réservation issue de l’échange démarre un nouveau cycle d’un ou trois ans à compter de la date d’échange. Si vous consommez votre échange final en fin de vie d’une réservation, vous vous rengagez donc pour un cycle complet, sur un actif désormais figé.
Cas n°5 : le trade-in plutôt que l’échange
Vos réservations VM ne collent plus à votre parc, mais vous ne savez pas vers quelle série aller. Plutôt que de brûler votre échange final sur un pari, vous les échangez contre un savings plan compute. Azure annule les réservations, vous rembourse au prorata, annule les échéances futures si vous payiez au mois, et vous engage sur un nouveau commitment horaire d’un an ou trois ans.
Attention : le trade-in est un aller simple. Vous ne pouvez pas échanger un savings plan contre une réservation, ni contre un autre savings plan. Réfléchissez avant.
6. Réservation ou savings plan : la grille d’arbitrage
Le savings plan, c’est un engagement en dollars par heure sur des services compute ou bases de données éligibles, appliqué automatiquement quelle que soit la région. La réservation, c’est un engagement sur un type d’instance ou une famille d’instances, dans une région donnée.
Microsoft prend l’exemple d’une D2v4 en Japan East pour un an d’un côté, et de 5,00 USD par heure pendant trois ans de l’autre.
Critère
Réservation
Savings plan
Nature de l’engagement
Instance ou famille d’instances, région fixée
Dépense horaire, toutes régions éligibles
Niveau de remise
Le plus élevé quand l’utilisation est pleine
Remise significative, mais inférieure
Souplesse
Instance size flexibility uniquement
Application automatique sur les services éligibles
Échange
Un échange final, puis plus rien après le 1er février 2027
Non échangeable par construction
Profil de workload
Continu, stable, sans changement prévu
Dynamique, évolutif, multi-familles ou multi-régions
Microsoft propose une séquence d’optimisation en cinq temps, et elle vaut le détour parce qu’elle remet l’ordre des opérations à l’endroit :
Right-sizer d’abord, en supprimant les ressources inutilisées ou surdimensionnées. Une remise réduit un tarif, elle ne réduit pas du gaspillage.
Échanger les réservations sous-utilisées vers des configurations mieux adaptées, tant que c’est encore possible.
Basculer en trade-in les réservations sous-utilisées dont l’usage est variable.
Acheter de nouvelles réservations, uniquement sur les workloads stables et bien compris.
Ajouter des savings plans, dimensionnés sur une base de consommation déjà nettoyée.
Les points 2 et 3 ont maintenant une date de péremption. C’est tout l’enjeu des prochains mois.
7. Le trade-in en pratique
Le trade-in est le mécanisme qui survit intégralement au changement de politique, autant savoir s’en servir correctement.
Ce qui est éligible
Les réservations Azure Virtual Machines, Dedicated Hosts et Azure App Service s’échangent contre un savings plan compute, avec un nouvel engagement d’un an ou trois ans. Les réservations de bases de données s’échangent contre un savings plan database, avec un engagement d’un an. En dehors de ces produits, aucune autre réservation ni aucun pre-purchase plan n’est éligible au trade-in. Vous pouvez traiter jusqu’à 100 réservations dans une même opération d’achat de savings plan.
Les droits nécessaires
Il vous faut être owner du Reservation Order concerné, et disposer du rôle Savings plan purchaser ou être owner de la subscription qui portera l’achat. Et voici le piège qui fait échouer la moitié des premières tentatives : les permissions EA Admin write et Billing profile contributor, qui suffisent pour un achat direct de savings plan, ne fonctionnent pas pour un achat réalisé dans le cadre d’un trade-in de réservation.
Calculer le bon commitment horaire
Attention, celui-ci mérite qu’on s’y arrête. Lors d’un trade-in, le commitment horaire proposé par défaut est calculé à partir de la valeur monétaire restante des réservations retournées. Ce montant n’est pas forcément suffisant pour couvrir les VM que les réservations couvraient. Vous risquez donc de sortir de l’opération avec une couverture en baisse sans vous en rendre compte.
La méthode Microsoft pour calculer le vrai commitment, produit par produit, en partant de la calculatrice de prix Azure et d’un affichage upfront :
Récupérer le coût upfront annuel du produit concerné pour le terme de savings plan visé.
Diviser ce coût par 8 760 pour un savings plan d’un an, ou par 26 280 pour un savings plan de trois ans.
Multiplier le résultat par le nombre d’instances que vous retournez.
Répéter pour chaque produit du trade-in, puis additionner : c’est votre commitment horaire.
Attention : ce calcul suppose une utilisation à 100 % des réservations retournées. Et comme le savings plan est un bénéfice flexible, rien ne garantit qu’il s’appliquera toujours en priorité aux ressources précédemment couvertes. Vérifiez votre couverture réelle dans les jours qui suivent l’opération.
8. Les pièges à connaître
Sept points de vigilance à garder sous la main quand vous allez manipuler votre portefeuille d’engagements dans les prochains mois.
Le plafond de remboursement. 50 000 USD de commitment annulé maximum sur 12 mois glissants, par billing profile ou enrollment. Bonne nouvelle : les remboursements issus d’un échange ne consomment pas ce plafond. Mauvaise nouvelle : si l’échange n’est plus disponible, toute sortie passe désormais par un remboursement qui, lui, décompte.
Le réapprovisionnement du plafond. Il n’est pas annuel civil. Si vous annulez 2 400 USD, votre marge tombe à 47 600 USD et remonte de 2 400 USD exactement 365 jours après l’opération.
Les gros engagements bloqués. Sur une réservation trois ans à 3 000 USD par mois, soit 108 000 USD, vous ne pouvez rien annuler tant que vous n’avez pas consommé 58 000 USD de votre engagement, parce que le reste dépasse le seuil de 50 000 USD.
Pas d’échange entre familles de produits. Une réservation Cosmos DB ne s’échange pas contre une réservation SQL Database. Les échanges restent cantonnés à la famille : compute avec compute, SQL avec SQL.
Certaines réservations n’ont jamais été échangeables. Les plans Red Hat, les plans SUSE Linux et tous les pre-purchase plans sont exclus de l’échange comme du remboursement, et ce point n’a pas changé.
Les droits sur le Reservation Order. Il faut être owner ou Reservation administrator sur le Reservation Order pour échanger ou rembourser. Ce n’est pas un rôle de subscription, et ça se prépare à l’avance.
Le cas CSP. Un client CSP ne peut pas échanger, annuler, renouveler ou rembourser lui-même : c’est le partenaire qui effectue l’opération pour son compte. Si vous êtes dans ce modèle, calez le sujet avec votre partenaire dès maintenant, pas le 25 janvier 2027.
Deux précisions financières utiles pour le dossier que vous allez devoir monter en interne. Côté EA, un remboursement revient sous forme de crédit sur l’Azure Prepayment, et ce crédit n’est valable que 90 jours : passé ce délai, il est perdu. Côté frais, Microsoft ne facture pas de frais de résiliation anticipée aujourd’hui, mais la documentation mentionne explicitement la possibilité de 12 % à l’avenir, sans date annoncée.
9. Votre plan d’action avant le 1er février 2027
Il vous reste environ cinq mois. Microsoft résume l’action attendue en une ligne : passez en revue votre portefeuille de réservations, évaluez vos besoins futurs de flexibilité, envisagez les savings plans là où c’est pertinent, et planifiez la façon dont vous voulez utiliser l’échange final. Voici comment je le décline concrètement.
Inventoriez. Exportez la liste de vos réservations avec, pour chacune, le service, la date d’achat, le terme, la date d’expiration, la quantité et le taux d’utilisation. Si vous n’avez pas encore fait l’inventaire de vos VM par série, la procédure pas-à-pas est dans VM Azure : anticipez les dépréciations, et les deux exercices se font très bien dans la foulée.
Classez chaque ligne en trois piles : stable et bien dimensionnée, sous-utilisée, ou obsolète parce que le workload a bougé.
Right-sizez le parc avant de toucher aux engagements. On n’optimise pas une remise sur des ressources qu’on va éteindre, ni sur une série qui part à la retraite en 2028.
Traitez la pile « sous-utilisée » avant le 31 janvier 2027, tant que les échanges sont encore illimités. C’est votre fenêtre de correction gratuite.
Pour les workloads dont vous ne savez pas dire où ils seront dans un an, privilégiez le trade-in vers un savings plan plutôt que de consommer l’échange final sur un pari.
Documentez, pour chaque réservation antérieure à la bascule, si son échange final est encore disponible. Sans ce suivi, personne ne saura répondre en 2028.
Vérifiez dès maintenant les droits : owner ou Reservation administrator sur les Reservation Orders, rôle Savings plan purchaser pour les trade-in.
Reprenez vos gabarits d’achat et vos process internes : à partir du 1er février 2027, un achat de réservation est un engagement ferme, il mérite le même niveau de validation qu’un investissement.
Conclusion
Voilà, en neuf sections, de quoi arrêter de subir cette annonce. Le changement n’est pas une catastrophe, c’est une remise à plat : Azure vous propose désormais deux produits d’engagement clairement séparés, un rigide et très remisé, un souple et un peu moins remisé, et vous demande de choisir en connaissance de cause.
Les quatre pièges à retenir :
Un échange réalisé après le 1er février 2027 produit une réservation définitivement figée, parce qu’un échange est techniquement un rachat.
L’échange final se compte à la quantité, pas à la réservation : c’est une marge de manœuvre, à condition de la suivre.
Le commitment horaire proposé par défaut lors d’un trade-in ne garantit pas votre niveau de couverture précédent.
Sans échange, la seule porte de sortie restante est le remboursement, et lui se heurte au plafond de 50 000 USD sur 12 mois glissants.
Sortez votre export de réservations, comptez les lignes sous-utilisées, et calez l’exercice avant fin janvier. Foncez, c’est le genre de chantier qui prend deux heures maintenant et coûte très cher plus tard.
🤖
Contenu assisté par IA Cet article a été rédigé avec l’assistance d’une intelligence artificielle et relu par l’auteur. Conformément à l’AI Act (UE) en vigueur depuis le 2 août 2026.
Depuis quelques mois, à l’heure où j’écris ces lignes fin juillet 2026, vous avez peut-être déjà reçu un ou plusieurs mails d’Azure au sujet de certaines de vos machines virtuelles : des annonces sur les Reserved Instances, sur des séries qui partent à la retraite, et vous vous demandez ce qui va réellement vous tomber dessus, et surtout quand ? Cet article est fait pour vous.
Car ces annonces ne forment pas un seul événement, mais trois vagues distinctes qui convergent sur la même période. On va les démêler une par une, poser le calendrier noir sur blanc, puis dérouler, capture après capture, ce que vous devez vérifier et faire dès maintenant dans le portail Azure. Objectif : que vous ressortiez de cette lecture avec un plan d’action clair, pas juste une vague inquiétude.
Pour vous guider plus facilement dans cet article, voici des liens rapides :
Les annonces Azure mélangent plusieurs vocabulaires, et la plupart des malentendus viennent de leur confusion. Le cycle de vie d’une taille de VM passe par quatre états successifs :
Génération courante : la série recommandée, avec capacité garantie.
Previous-gen (génération précédente) : encore pleinement supportée, mais sans garantie de capacité supplémentaire. Deux nuances, next-gen available (pas encore de date de retraite) et capacity limited (plus aucune capacité déployée).
Retraite annoncée : une date de fin est fixée, la VM tourne encore mais il faut migrer.
Retirée : la taille n’est plus disponible, impossible d’en provisionner.
Deux autres termes, financiers cette fois, reviennent sans arrêt :
Reserved Instance (RI) : un engagement d’un ou trois ans sur une série de VM précise, en échange d’une remise. C’est un dispositif de facturation, pas un état de la VM.
Quota : le plafond de cœurs que votre abonnement peut déployer pour une série donnée, dans une région donnée.
Le fil rouge de tout l’article tient en deux phrases : previous-gen ne veut pas dire retirée, et fin des RI ne veut pas dire retraite de la VM. Gardez ces distinctions en tête, elles évitent la grande majorité des paniques inutiles.
Voici d’ailleurs pour info un portail très utile des décommissionnements prévus par Microsoft, accessible directement depuis le portail Azure Advisor :
Vague 1 : la fin des Reserved Instances (1er juillet 2026)
Première vague dans l’ordre chronologique, et elle est déjà passée. Depuis le 1er juillet 2026, Azure ne vend plus et ne renouvelle plus certaines Reserved Instances. Mais l’histoire a commencé bien avant cette date, car les réservations 1 an et 3 ans ne s’arrêtent pas au même moment. Voici le tableau complet des échéances :
Séries
RI 3 ans : plus d’achat ni de renouvellement depuis
RI 1 an : plus d’achat ni de renouvellement depuis
D, Ds, Dv2, Dsv2, Ls
1er mai 2025
1er juillet 2026
Av2, Amv2, Bv1, F, Fs, Fsv2, G, Gs, Lsv2
15 novembre 2025
1er juillet 2026
Dv3, Dsv3, Ev3, Esv3
1er juillet 2026
1er juillet 2026
Ce qu’il faut lire dans ce tableau : pour la plupart de ces séries, les réservations 3 ans ne sont déjà plus renouvelables depuis 2025 (mai pour la famille D et Ls, novembre pour les autres). Seules les réservations 1 an tenaient encore, et c’est cette dernière porte qui s’est refermée le 1er juillet 2026. Pour Dv3, Dsv3, Ev3 et Esv3, les deux durées s’arrêtent le même jour, le 1er juillet 2026.
Bon à savoir : cette date du 1er juillet 2026 pour les RI 1 an a été avancée. Elle était initialement fixée au 15 novembre 2027 (Azure Update 500682). Microsoft l’a donc rapprochée de plus d’un an, ce qui laisse encore moins de marge que ce qui était annoncé au départ.
Un point capital pour Dv3, Dsv3, Ev3 et Esv3 : ces séries ne sont pas retirées, elles restent « product active ». Ce sont seulement leurs réservations qui s’arrêtent. Ne confondez pas les deux.
Le piège classique : croire que le renouvellement automatique vous protège. Il ne joue plus pour ces séries. Vos réservations existantes restent valables jusqu’au bout de leur terme, un contrat 3 ans en cours court par exemple jusqu’à sa date de fin, mais à leur expiration, la charge bascule automatiquement en tarif pay-as-you-go, souvent bien plus cher, même si l’option de renouvellement automatique était cochée.
« July 1, 2026 does not terminate existing RIs. RIs remain valid until their individual expiration dates. »
Attention : le 1er juillet 2026 ne résilie aucune réservation en cours. Une RI reste honorée jusqu’à sa date d’expiration individuelle. Le risque n’est pas une coupure, c’est une hausse de facture silencieuse le jour où elle expire.
Trois leviers, selon votre situation :
Passer à l’Azure savings plan for compute : un engagement basé sur la dépense horaire, flexible entre familles de VM et entre régions. C’est la recommandation numéro un de Microsoft.
Migrer vos charges vers une série récente, qui redonne accès aux RI comme aux Savings Plans.
Ne rien faire et assumer le pay-as-you-go, mais que ce soit un choix conscient, pas un oubli.
Note : la possibilité de renouveler une dernière fois les réservations 1 an existait jusqu’au 30 juin. Depuis le 1er juillet, cette porte est fermée pour les séries listées ci-dessus, et celle des réservations 3 ans l’était déjà depuis 2025 :
Vague 2 : le gel de la croissance de capacité (31 juillet 2026)
Deuxième vague, et de loin la plus imminente puisque la première est déjà derrière nous. À compter du 31 juillet 2026, Azure gèle la croissance de capacité des anciennes séries. Concrètement, les demandes suivantes ne seront plus approuvées :
les nouveaux déploiements de VM sur ces séries,
les opérations de scale-out qui réclament de la capacité supplémentaire,
les demandes d’augmentation de quota,
vos plans de croissance future sur ces séries.
Ce qui n’est pas touché, et c’est la bonne nouvelle : vos déploiements existants continuent de tourner dans la limite de la capacité déjà allouée. Aucune interruption, aucune VM coupée du jour au lendemain à cause de ce gel.
Les séries concernées se répartissent en deux groupes. D’abord celles qui partent à la retraite et sont soumises au gel :
Attention : le gel ne coupe rien, mais il vous enferme. Si demain vous avez besoin d’ajouter des VM sur une de ces séries (montée en charge, nouveau projet, reprise d’activité dans une autre région), la demande peut être refusée. C’est précisément le scénario à anticiper avant le 31 juillet.
Je vous propose de regarder en exemple une machine virtuelle en série Bs avant la date du 31 juillet 2026. Le redimensionnement de celle-ci vers différentes tailles de la même famille est possible :
Et celui-ci fonctionne bien :
Par contre, j’avais déjà eu un refus de la part de Microsoft sur une demande d’augmentation de quota pour cette série :
Je vous referai dans quelques jours d’autres copies d’écran afin de comparer le changement à partir du 1er août.
Vague 3 : le calendrier de retraite des séries v1 à v4
Troisième vague, la plus étalée dans le temps. Voici le calendrier consolidé des retraites, de la plus ancienne (déjà effective) à la plus lointaine.
Série
Catégorie
Statut
Date de retraite
NCv3, NCv3-NC24rs
GPU
Retirée
30/09/2025
NVv3, NVv4
GPU
Annoncée
30/09/2026
M192idms_v2, M192ids_v2, M192ims_v2, M192is_v2
Mémoire
Annoncée
31/03/2027
NP-series
FPGA
Annoncée
31/05/2027
D, Ds, Dv2, Dsv2
Usage général
Annoncée
01/05/2028
Ls
Stockage
Annoncée
01/05/2028
Av2, Amv2
Usage général
Annoncée
15/11/2028
B-series (V1)
Usage général
Annoncée
15/11/2028
F, Fs, Fsv2
Compute optimisé
Annoncée
15/11/2028
G, Gs
Mémoire
Annoncée
15/11/2028
Lsv2
Stockage
Annoncée
15/11/2028
Deux lectures à retenir. D’une part, certaines séries GPU sont déjà retirées depuis septembre 2025 : si vous tournez encore dessus, vous êtes hors support et hors SLA. D’autre part, le gros des séries généralistes (D, Ds, Av2, F, G et compagnie) part en 2028, ce qui vous laisse du temps pour planifier, à condition de commencer maintenant. Le lot du 15 novembre 2028 (F, Fs, Fsv2, Lsv2, G, Gs, Av2, Amv2 et la série B) fait d’ailleurs l’objet d’une annonce dédiée, l’Azure Update 500682.
Attention : la date de retraite n’est pas le seul mur. Dès qu’une série passe en capacity limited, vous pouvez vous heurter à un manque de capacité bien avant la date officielle. Le gel du 31 juillet, c’est exactement ça. Ne calez pas votre migration sur 2028 en pensant être tranquille.
Vers quoi migrer ? Les séries cibles v5, v6, v7
Bonne nouvelle, Microsoft fournit une table de correspondance claire. Voici les cibles recommandées, série par série.
Stockage local NVMe, débit distant nettement supérieur
Ls, Lsv2
Lsv3/Lasv3, Lsv4/Lasv4
Lsv4 et Lasv4 sont la dernière génération L
Dv3, Dsv3 (RI arrêtées)
Dsv5/Ddsv5/Dasv5, Dsv6/Ddsv6/Dasv6
Pas retirées, mais plus de RI
Ev3, Esv3 (RI arrêtées)
Esv5/Edsv5/Easv5, Esv6/Edsv6/Easv6
Pas retirées, mais plus de RI
Attention : la génération v6 impose des prérequis. Elle exige le NVMe activé (donc un OS supporté), fonctionne uniquement avec des VM de Génération 2, et requiert l’adaptateur réseau MANA avec un OS compatible. Si l’un de ces points bloque, repliez-vous provisoirement sur la v5. Et vérifiez la capacité régionale de la cible, elle n’est pas garantie partout.
Ce que vous devez faire, concrètement
Assez de théorie. Voici la marche à suivre, étape par étape, capture après capture. Comptez une petite heure pour un premier inventaire propre.
Étape 1 : inventorier vos VM par série
Direction le portail Azure. Dans la barre de recherche, tapez Virtual machines pour ouvrir la liste de vos VM. Ajoutez la colonne Size (bouton Manage view puis Edit columns) pour voir d’un coup d’œil la taille de chaque machine, puis repérez celles dont la série figure dans les tableaux ci-dessus :
Vous pouvez aussi utiliser le rapport Service Retirement Workbook disponible dans Azure Advisor :
Étape 2 : auditer vos Reserved Instances
Toujours dans le portail, recherchez Reservations. Filtrez par Product type réglé sur Virtual machines, puis examinez deux colonnes, la VM family et la date d’expiration. Toute réservation dont la famille figure dans la liste de la vague 1 est concernée :
Pour aller plus loin, ouvrez le détail de la réservation concernée et vérifiez son taux d’utilisation ainsi que sa date de fin. Confirmez si la charge continuera au-delà de l’expiration : si oui, il faut agir avant :
Étape 3 : choisir votre stratégie de coûts
Pour chaque réservation ou VM concernée, tranchez entre trois options : basculer vers un Azure savings plan for compute, moderniser la VM, ou assumer le pay-as-you-go.
Passez un instant sur le calculateur de prix Azure pour chiffrer l’écart entre votre coût actuel et la cible :
Le calculateur de prix met les coûts côte à côte : de quoi éviter les mauvaises surprises en comité budget.
Étape 4 : vérifier le quota de la série cible
Avant de redimensionner, assurez-vous que votre abonnement dispose d’assez de quota pour la série visée. Ouvrez Subscriptions, sélectionnez votre abonnement, puis Usage + quotas :
Si le plafond est trop bas, cliquez sur Request increase pour demander une augmentation sur la série cible :
Étape 5 : redimensionner la VM
Dernière ligne droite. Le redimensionnement se fait en trois temps. Sur la VM, cliquez sur Stop pour la désallouer proprement avant :
Une fois la machine virtuelle arrêtée et désallouée, ouvrez le volet Size, choisissez la taille cible, validez avec Resize :
Une fois le redimensionnement réussi, cliquez sur Start pour redémarrer la machine :
Le piège classique : oublier que les données du disque temporaire et de la mémoire sont perdues à la désallocation. Les disques managés, eux, sont conservés. Prévenez donc les applications qui s’appuient sur le disque temporaire avant de lancer l’opération.
Mon retour terrain : planifiez ce chantier 6 mois avant chaque échéance, pas la veille. Alignez la bascule sur vos fenêtres de maintenance applicative et sur vos cycles d’achat de Savings Plan, et faites modéliser les coûts par votre équipe de compte Microsoft. Le faire dans l’urgence, c’est la garantie de payer plus cher et de casser quelque chose.
En résumé : les pièges à retenir
Voilà, en trois vagues, tout ce qui se joue sur vos anciennes VM Azure. Concrètement, qu’est-ce que vous devez garder en tête ?
Deux dates pivots : le 1er juillet 2026 (fin des RI 1 an, déjà passé, les RI 3 ans ayant même cessé dès 2025) et le 31 juillet 2026 (gel de capacité, imminent).
Previous-gen n’est pas retirée, mais capacity limited peut vous bloquer bien avant la date de retraite officielle.
Fin des RI n’est pas retraite de la VM : Dv3, Dsv3, Ev3 et Esv3 restent actives, seules leurs réservations s’arrêtent.
Le renouvellement automatique ne joue plus : à l’expiration, bascule silencieuse en pay-as-you-go.
La v6 impose des prérequis (NVMe, Génération 2, MANA) et une capacité régionale non garantie : testez avant.
À la désallocation, disque temporaire et mémoire perdus, disques managés conservés.
Le vrai message : aucune de ces vagues ne coupe vos VM du jour au lendemain, mais toutes récompensent ceux qui anticipent et punissent ceux qui attendent. Faites votre inventaire cette semaine, pendant que vous avez encore le temps de choisir plutôt que de subir.
Foncez auditer vos abonnements, et si cet article vous a fait gagner du temps, dites-le moi en commentaire.
Vous les avez peut-être testées en préversion, comme moi : l’orchestration des hôtes de session, la mise à l’échelle dynamique et les disques OS éphémères sur Azure Virtual Desktop. Bonne nouvelle, depuis juin 2026 ces trois briques de gestion avancée des host pools sont annoncées en disponibilité générale. L’occasion de faire le point, de regrouper mes trois anciens tutos de préversion, et surtout de pointer ce qui a changé depuis, car un seul détail peut casser vos anciens déploiements.
Ces fonctionnalités, je les avais chacune détaillées dans un tutoriel pas-à-pas quand elles étaient en préversion. Plutôt que de vous renvoyer vers trois articles vieillissants, je les réunis ici en une synthèse à jour de la GA, avec des liens vers chaque tuto d’origine si vous voulez remettre les mains dans le portail.
1. De la préversion à la GA : ce qui change vraiment
Avant d’entrer dans le détail, un rappel utile sur la notion de fond. Sur Azure Virtual Desktop, un pool d’hôtes partagé se gère de deux façons :
La gestion standard, où vous créez, mettez à jour et scalez vos hôtes avec vos propres outils, et la gestion par configuration d’hôte de session, celle que Microsoft qualifie d’automatisée. C’est cette seconde approche, et les capacités qui gravitent autour, qui passe en GA :
Point de vigilance à connaître dès maintenant : le choix de l’approche se fait à la création du pool d’hôtes et ne peut plus être modifié ensuite :
Un pool créé sans configuration d’hôte de session ne pourra jamais en recevoir une par la suite. Cette approche ne concerne par ailleurs que les pools d’hôtes mutualisés :
À surveiller : à l’heure où j’écris ces lignes, certaines pages de référence Microsoft, comme celle de la mise à jour de l’hôte de session ou celle de l’identité managée, portent encore la mention préversion. Le changelog officiel, lui, annonce bien la disponibilité générale et distingue clairement les nouveautés qui restent en preview. Le plus probable est un simple décalage de documentation, doublé d’un déploiement progressif. À vérifier dans votre tenant avant tout passage en production.
2. L’orchestration des hôtes de session
C’est la brique centrale. La configuration d’hôte de session, ou session host configuration, décrit une bonne fois pour toutes ce que doivent être vos hôtes : image, taille de VM, type de disque, type de sécurité, jonction de domaine, réseau, identité, tags.
Tous les hôtes du pool s’alignent sur cette configuration unique :
Pour faire évoluer votre parc, vous ne touchez plus chaque VM une par une, vous modifiez la configuration :
Puis vous déclenchez une mise à jour de l’hôte de session :
La mise à jour de l’hôte de session vous permet de mettre à jour le type de disque de machine virtuelle sous-jacente, l’image du système d’exploitation et d’autres propriétés de configuration de tous les hôtes de session dans un pool d’hôtes avec une configuration d’hôte de session. La mise à jour de l’hôte de session libère ou supprime les machines virtuelles existantes et en crée de nouvelles qui sont ajoutées à votre pool d’hôtes avec la configuration mise à jour.
Concrètement, la mise à jour ne bricole pas vos VM en place, elle les remplace. Le service cible d’abord un seul hôte, dit initial, pour valider que le processus fonctionne de bout en bout, puis il traite le reste par lots dont vous fixez la taille :
Chaque hôte concerné passe en mode drain, vos utilisateurs connectés reçoivent une notification et un délai avant déconnexion, l’ancienne VM est retirée du pool, une nouvelle est créée depuis la configuration à jour, jointe au domaine puis remise en service :
L’ancienne VM est enfin supprimée. La progression n’avance que lorsqu’un hôte est réellement terminé, ce qui explique qu’elle reste à 0 % pendant le traitement du tout premier.
Bon à savoir : l’état d’alimentation existant est respecté, vous pouvez donc lancer une mise à jour sur un pool dont tous les hôtes sont OFF pour limiter les coûts. Le pas-à-pas complet, du domaine managé jusqu’au déclenchement de la mise à jour, reste disponible dans mon tuto dédié : Orchestrez votre AVD.
3. La mise à l’échelle dynamique : créer et supprimer, pas seulement allumer et éteindre
Le plan de mise à l’échelle existait déjà pour optimiser les coûts d’un pool.
Ce qui arrive en GA, c’est sa méthode dynamique. La différence tient en une phrase :
En gestion de l’énergie, le plan se contente d’allumer et d’éteindre des VM existantes :
En mode dynamique, il crée et supprime réellement les machines virtuelles selon l’usage et la planification, en s’appuyant sur la mise à jour de l’hôte de session pour les recréer dans leur dernière version :
Les phases du plan, elles, ne changent pas : montée en charge, période de pointe, descente en charge et hors-période.
Vous y réglez les seuils de capacité, l’algorithme d’équilibrage, le nombre minimum et maximum de VM, et la déconnexion forcée éventuelle en descente de charge. L’intérêt du dynamique : quand la charge tombe, vous ne payez plus des VM éteintes qui traînent, elles disparaissent, puis se recréent à la demande :
Les mécanismes de fond, eux, restent les mêmes d’une méthode à l’autre.
La mise à l’échelle démarre/crée progressivement des machines virtuelles quand une certaine limite d’utilisateurs est atteinte :
Elle éteint/supprime les machines virtuelles tant qu’elles ne sont pas exploitées :
Elle peut forcer la déconnexion des utilisateurs, uniquement si vous l’avez activé en descente de charge :
Quelques garde-fous à garder en tête : la méthode dynamique vise les pools mutualisés (pas les environnements personnels), s’appuie sur un pool déjà configuré avec la mise à jour de l’hôte de session, et connaît des restrictions selon le type de jonction et l’hébergement.
Le principe : le disque système vit sur le stockage local de l’hôte, pas sur du stockage distant managé :
Résultat, des lectures et écritures à plus faible latence, un provisionnement et une réinitialisation plus rapides :
Et un coût inclus dans celui de la taille de VM :
La contrepartie est assumée, ces disques ne conservent rien au-delà du cycle de vie de la machine :
Le changement de la GA est là. En préversion, l’interface de création d’AVD ne permettait pas de choisir un disque éphémère, ce qui obligeait à un contournement, créer les VM à la main puis les rattacher au pool :
Microsoft annonce désormais les disques éphémères disponibles et optimisés pour Azure Virtual Desktop, et la configuration d’hôte de session inclut les informations du disque OS. La prise en charge devient donc officielle et intégrée, au lieu d’un montage manuel.
Pour bien saisir les différents disques éphémères sur Azure, l’excellente vidéo de John Savill reste la meilleure entrée en matière :
Les contraintes restent les mêmes, et il faut les connaître : pas de sauvegarde de la VM, pas de désallocation, et un redimensionnement qui fait perdre toute la donnée. Pour un pool AVD bâti sur une golden image et qui ne stocke pas de données utilisateur, ce ne sont pas des bloqueurs, plutôt des propriétés à assumer.
5. Le vrai piège : l’identité managée devient incontournable
Si vous relisez mes anciens tutos, vous verrez que je faisais reposer les droits sur l’application de service Azure Virtual Desktop, avec des rôles RBAC assignés à la main sur le Key Vault et un rôle personnalisé pour la lecture de la configuration. Cette mécanique n’est plus la bonne. Microsoft a basculé vers l’identité managée, et ce n’est pas une simple recommandation :
Attention : l’identité managée est devenue nécessaire pour les pools qui utilisent une configuration d’hôte de session. Le calendrier annoncé par Microsoft est sans ambiguïté : depuis le 19 septembre 2025, un nouveau pool de ce type doit être créé avec une identité managée ; depuis le 15 octobre 2025, un pool existant ne peut plus mettre à jour sa configuration sans en ajouter une ; et depuis le 15 novembre 2025, il ne peut plus créer d’hôtes sans elle. Si vous suivez encore la méthode service principal de mes anciens articles, vous allez vous heurter à un mur.
La bonne nouvelle, c’est que l’identité managée simplifie le tableau. Elle supprime le besoin d’assigner des permissions à l’application de service Azure Virtual Desktop, attribue automatiquement les droits en fonction des paramètres de la configuration d’hôte de session, et apporte un contrôle plus fin par pool :
Elle débloque aussi deux cas concrets : l’accès à un Key Vault dont l’accès public est désactivé, réservé aux services Microsoft de confiance, et l’usage d’une image hébergée dans un autre abonnement du même tenant. La marche à suivre est décrite sur la page de configuration de l’identité managée.
Concrètement, ça donne quoi ?
Voilà, en une synthèse, trois briques de préversion réunies et remises à niveau pour la disponibilité générale : la configuration d’hôte de session pour standardiser et mettre à jour votre parc, la mise à l’échelle dynamique pour créer et supprimer les VM au fil de la charge, et les disques éphémères désormais intégrés proprement.
Les pièges à retenir :
L’identité managée n’est plus optionnelle, oubliez la méthode service principal de mes anciens tutos.
L’approche de gestion se choisit à la création du pool et ne se change plus après.
Les disques éphémères ne persistent rien, parfait pour une golden image, à proscrire pour de la donnée utilisateur.
Certaines pages de doc portent encore le label préversion, vérifiez l’état réel dans votre tenant avant la prod.
Si vous avez lu mon article de juillet 2025 sur les VPN Azure et la deadline du 30/09, vous vous souvenez du test avec une VPN Gateway Basic SKU avec une IP publique dynamique. Le verdict était brutal : suppression de la connexion, suppression de la gateway, impossibilité de migrer l’IP dynamique, création d’une nouvelle IP Standard, recréation complète de la gateway, changement d’adresse IP à la clé. Un calvaire. Bonne nouvelle : Microsoft a depuis simplifié la procédure pour les VPN Gateways Basic SKU. En 2026, c’est un clic dans le portail, sans coupure réseau, sans changement d’IP, en moins de cinq minutes.
Pour rappel, jusqu’ici les VPN Gateways Basic SKU pouvaient être créées avec une IP publique Basic SKU. Azure a migré ces IPs en interne vers des IPs Standard SKU depuis. Il reste une dernière action à faire côté client : supprimer la référence à l’ancienne ressource IP Basic dans la configuration de la gateway. C’est ce qu’on va faire ensemble, capture après capture.
Attention : cet article concerne uniquement la VPN Gateway Basic SKU (le SKU développement/lab, sans SLA). Si vous avez une gateway VpnGw1 à VpnGw5 ou un SKU legacy (Standard, High Performance), le processus est différent : utilisez l’outil de migration dédié dans la Configuration de la gateway. Ce n’est pas ce dont on parle ici.
Pour vous guider plus facilement dans cet article, voici des liens rapides :
Avant de toucher quoi que ce soit, vérifiez que vous êtes bien dans le cas de figure de cet article. Le piège classique : confondre « VPN Gateway Basic SKU » et « IP publique Basic SKU ». Ce sont deux ressources distinctes. Ici, on parle bien du SKU de la gateway elle-même.
Situation
Action
VPN Gateway Basic SKU avec une référence à une IP publique Basic SKU
✅ Vous êtes concerné par cet article
VPN Gateway Basic SKU sans référence IP Basic (déjà nettoyée)
✅ Rien à faire, vous êtes bon
VPN Gateway VpnGw1 à VpnGw5 (non-AZ ou AZ)
❌ Pas cet article : utiliser l’outil « Migrate to Standard IP » dans Configuration
VPN Gateway SKU legacy (Standard, High Performance)
❌ Pas cet article : suivre le guide de migration dédié Microsoft
Pour rappel, la VPN Gateway Basic SKU est un SKU développeur, sans SLA. Elle ne retire pas, contrairement à ce que beaucoup pensaient (moi y compris, au moment de mon article 2025). Microsoft a confirmé qu’elle reste disponible : c’est uniquement la référence à l’IP Basic qui doit être nettoyée.
2. Étape 0 : identifier la présence de la référence IP Basic
Deux façons de vérifier si votre gateway est concernée : depuis la CLI Azure ou directement depuis le portail.
Via Azure CLI : récupérez d’abord l’ID de l’IP publique associée à votre gateway.
az network vnet-gateway show \
    --name <nom-de-votre-gateway> \
    --resource-group <votre-resource-group> \
    --query "ipConfigurations[].publicIpAddress.id" \
    --output tsv
Copiez l’ID retourné, puis vérifiez le SKU de cette IP :
az network public-ip show \
    --ids <id-copié-ci-dessus> \
    --query "sku.name" \
    --output tsv
Si la commande retourne Basic, vous êtes concerné. Si elle retourne Standard, votre gateway est déjà propre :
Via le portail Azure : naviguez vers votre ressource Virtual network gateway. Dans le menu de gauche, sous Settings, cliquez sur Configuration. Si votre gateway est concernée, vous verrez une section Validation avec un bouton Delete Basic Public IP Reference. C’est la confirmation visuelle que vous devez agir.
Si vous ne voyez pas cette section, soit votre gateway n’a plus de référence IP Basic (déjà nettoyée), soit vous n’êtes pas sur un gateway Basic SKU.
3. Étape 1 : vérifier la validation dans le portail
Toujours sur la page Configuration, regardez la section Validation. Chaque ressource listée doit afficher le statut Succeeded avant de pouvoir continuer.
Attention : si une ou plusieurs ressources affichent un statut autre que Succeeded, ne continuez pas. Résolvez d’abord les erreurs signalées avant de déclencher la suppression.
4. Étape 2 : supprimer la référence IP Basic
Toutes les ressources sont en Succeeded ? Le moment de vérité. Cliquez sur le bouton Delete Basic Public IP Reference.
Concrètement, ça donne quoi ? Cette action retire l’association entre la ressource IP publique Basic SKU et la gateway. Ce n’est pas une migration. Azure avait déjà basculé l’IP en interne vers une ressource Standard SKU non visible dans votre subscription : vous ne faites que supprimer le pointeur côté client.
This action removes the association between your Basic SKU public IP address resource and the Basic SKU VPN gateway. It’s not a migration operation. The public IP address itself is already moved internally by Azure to a Standard SKU public IP address resource used by the VPN gateway.
Mon retour terrain : dans mon article de 2025, le Test III montrait qu’il fallait supprimer la connexion VPN, supprimer la gateway, recréer une IP Standard, et tout reconstruire. L’IP changeait au passage. C’était le comportement de l’époque pour une IP dynamique. La procédure 2026 est radicalement différente pour la Basic SKU Gateway : un bouton, zéro downtime, l’IP reste la même. Microsoft a bien bossé sur ce point.
5. Étape 3 : vérifier le résultat
Une fois l’opération terminée, retournez sur la page de la gateway. Et là, surprise possible : l’adresse IP peut apparaître comme null dans le portail, ou le nom de l’ancienne ressource IP Basic est encore affiché sans lien cliquable.
Attention : ce comportement est un bug cosmétique connu et documenté par Microsoft. La gateway fonctionne parfaitement, l’IP n’a pas changé, et vos connexions S2S/P2S continuent de tourner. Ne paniquez pas.
Pour vérifier l’IP réelle utilisée par la gateway, deux options. Depuis le portail, cliquez sur JSON View en haut à droite de la page Overview de la gateway : les propriétés réelles de la ressource y sont correctement renseignées, avec l’adresse IP effective.
Ou depuis la CLI, via la propriété tunnelIpAddresses :
az network vnet-gateway show \
    --name <nom-de-votre-gateway> \
    --resource-group <votre-resource-group> \
    --query "bgpSettings.bgpPeeringAddresses[0].tunnelIpAddresses[0]" \
    --output tsv
6. Étape 4 : supprimer l’ancienne ressource IP Basic
La suppression de la référence ne supprime pas la ressource IP publique Basic SKU de votre subscription. Elle reste dans votre resource group, et Azure continue de vous la facturer tant que vous ne la supprimez pas manuellement.
Depuis le portail, naviguez vers votre resource group, repérez la ressource de type Public IP address avec le SKU Basic, et supprimez-la. Ou en CLI :
az network public-ip delete \
    --name <nom-de-votre-ip-basic> \
    --resource-group <votre-resource-group>
Une fois supprimée, la facturation de cette ressource s’arrête. La gateway continue d’utiliser une IP Standard SKU gérée en interne par Azure, non visible et non facturée séparément dans votre subscription.
7. Pièges à éviter
Piège n°1 : tenter d’upgrader l’ancienne ressource IP Basic manuellement. Après avoir supprimé la référence, vous pourriez être tenté d’upgrader la ressource IP Basic restante vers un Standard SKU via le portail ou PowerShell. Ne le faites pas. Microsoft a documenté que cette tentative provoque un état de provisionnement Failed sur la ressource. La bonne action est la suppression pure et simple, pas l’upgrade.
Piège n°2 : paniquer devant l’affichage null dans le portail. Comme vu à l’étape 3, le portail peut afficher l’IP comme null ou encore le nom de l’ancienne ressource Basic sans lien. C’est purement cosmétique. Fiez-vous à la vue JSON ou à la CLI pour vérifier l’état réel, et testez vos tunnels VPN : ils fonctionnent.
Piège n°3 : ne rien faire avant le 30 juin 2026. Si vous ne supprimez pas la référence avant la deadline, votre gateway continuera de fonctionner, mais dans une configuration non supportée, sans garantie de SLA. Microsoft ne viendra pas corriger ça pour vous. La VPN Gateway Basic SKU est déjà un SKU sans SLA en temps normal : sans cette action, elle perd toute couverture de support.
8. Questions fréquentes
Microsoft a publié une FAQ détaillée sur cette procédure. Voici les points que je trouve les plus utiles à avoir en tête.
Cette opération change-t-elle le SKU ou migre-t-elle ma gateway ?
Non. C’est le point qui perturbe le plus : on parle de « migration IP » partout, mais cette opération ne migre rien et ne change pas le SKU de la gateway. Elle supprime uniquement la référence côté client.
This operation doesn’t change the VPN Gateway SKU and doesn’t migrate the gateway. It only removes the reference to the Basic SKU public IP address resource from the gateway configuration.
La valeur de l’IP ne change pas. En revanche, après l’opération, la ressource IP publique Basic SKU côté client n’est plus liée à la gateway. L’IP est désormais portée par une ressource Standard SKU interne, non visible dans votre subscription.
The IP address value itself doesn’t change and continues to be used by the VPN gateway. However, after removing the reference: the customer-visible Basic SKU public IP address resource is no longer linked to the gateway. The IP address is now associated with an internal Standard SKU public IP address resource that isn’t visible in your subscription.
Pourquoi ne puis-je pas accéder à la nouvelle ressource IP Standard créée par Azure ?
Parce qu’elle est intentionnellement invisible. C’est une ressource interne Azure-managed, hors du périmètre de votre subscription. Vous ne pouvez pas la gérer, la voir, ni la facturer.
The Standard SKU public IP address that’s used by the VPN gateway after this process is an internal Azure-managed resource. It isn’t customer-visible or customer-manageable.
L’opération elle-même n’entraîne aucun nouveau frais. Mais l’ancienne ressource IP Basic reste dans votre subscription et continue d’être facturée jusqu’à sa suppression manuelle. La nouvelle IP Standard interne, elle, n’est pas facturée séparément.
Dis-associating the Basic public IP reference from your VPN gateway doesn’t introduce any new charges and doesn’t result in additional billing. Once you delete it, billing for that Basic public IP resource stops. Your VPN gateway continues to use an internally managed Standard SKU public IP address provided by Azure. This internal Standard SKU public IP address isn’t customer-visible and isn’t billed separately.
Que se passe-t-il si je ne fais rien avant le 30 juin 2026 ?
Votre gateway continue de tourner, mais dans une configuration officiellement non supportée. Pas de SLA, pas d’intervention Microsoft. Et contrairement à ce qu’on pourrait espérer, Microsoft ne fera rien à votre place.
If you don’t take action, your VPN gateway will continue running in an unsupported state. The VPN Gateway Basic SKU doesn’t include SLA guarantees and isn’t intended for production use. Microsoft won’t automatically modify or clean up resources in your subscription. Your gateway might continue to function, but reliability, availability, and support aren’t guaranteed.
Voilà, en quatre étapes : vérification CLI ou portail, validation de la section Configuration, clic sur Delete Basic Public IP Reference, suppression de l’ancienne ressource IP Basic. Dix minutes grand maximum, zéro coupure réseau, l’IP ne change pas.
Par rapport à la situation de 2025 décrite dans mon article sur la deadline du 30/09, Microsoft a vraiment simplifié la procédure pour le cas VPN Gateway Basic SKU. En 2025, le seul chemin pour une IP dynamique était la destruction et la recréation complète, avec changement d’IP à la clé. En 2026, c’est un bouton dans le portail.
Les trois pièges à retenir :
Ne pas tenter d’upgrader l’ancienne ressource IP Basic après dissociation, sous peine de la mettre en état Failed.
L’affichage null dans le portail est cosmétique : vérifier via la vue JSON ou la CLI.
Deadline le 30 juin 2026. Microsoft ne fait rien pour vous si vous ne bougez pas.
Foncez tester en lab si vous n’êtes pas encore passé à l’acte, et planifiez la prod dans la foulée. C’est le genre d’opération qui se fait en dix minutes et qui évite une mauvaise surprise après le 30 juin.
Et pendant que vous êtes dans le portail Azure, profitez-en pour jeter un œil au Service Retirement Workbook, accessible depuis Azure Advisor > Workbooks > Service Retirement. Ce classeur liste toutes vos ressources impactées par des retraits Azure en cours, avec les dates d’échéance et les actions recommandées. Je l’avais déjà présenté dans mon article de 2025 et il reste, aujourd’hui encore, le meilleur moyen de ne rien rater dans votre tenant.
Que peut bien dire le titre de cet article ? Vous avez peut être déjà entendu parler des Context-based Redirections à droite à gauche, vous savez vaguement ce dont ça parle, mais vous n’avez jamais mis les mains dedans ? Cet article est fait pour vous. On va dérouler, écran après écran, jusqu’à voir une redirection (presse-papiers, lecteurs, imprimante, USB…) s’activer pour une machine conforme et se couper net pour une machine non conforme.
Pour rappel, jusqu’ici une politique de redirection sur AVD ou Windows 365 était binaire : si vous bloquiez le presse-papiers (ou les lecteurs, l’USB, l’imprimante), c’était bloqué pour tout le monde, sur tous les appareils : le portable corporate conforme comme le téléphone perso en BYOD. La seule parade, c’était de maintenir deux host pools séparés.
Avec les Context-based Redirections, on peut enfin faire varier la redirection au niveau de chaque connexion, selon la conformité de l’appareil, le réseau, ou le rôle de l’utilisateur. Un seul host pool, deux comportements. C’est du Zero Trust appliqué à la redirection.
Attention : au moment où j’écris ces lignes, la fonctionnalité est en Public Preview. À tester en lab, pas en prod. Et elle n’est supportée que via les clients Windows App (Windows, web, Android, iOS, macOS), le bon vieux mstsc ne participe pas au mécanisme.
Pour vous guider plus facilement dans cet article, voici des liens rapides :
Concrètement, ça donne quoi ? C’est une capacité qui applique des politiques d’accès granulaires aux redirections client, en s’appuyant sur un contexte d’authentification Microsoft Entra. L’idée : la redirection n’est autorisée que si la session atteint le niveau de confiance exigé.
La redirection contextuelle permet aux organisations de contrôler le comportement de redirection en fonction des conditions d’utilisateur et de session.
À l’aide du contexte d’authentification, les administrateurs peuvent définir quand des fonctionnalités client spécifiques doivent être autorisées ou restreintes en fonction de facteurs tels que le rôle d’utilisateur, la conformité de l’appareil ou l’emplacement réseau.
Cela permet de s’assurer que les données sensibles sont accessibles uniquement lorsque la session répond au niveau de confiance requis.
Le point que je veux marteler tout de suite, parce que je vais beaucoup parler du presse-papiers dans la démonstration : la fonctionnalité ne se limite pas au copier-coller. Microsoft documente quatre redirections pilotables par contexte d’authentification :
Clipboard : le presse-papiers (copier-coller texte, image, fichier… dans un sens ou dans l’autre).
Drive : les lecteurs locaux (fixes, amovibles, réseau) remontés dans la session distante.
Printer : la redirection d’imprimante.
USB : la redirection des périphériques USB.
Attention, il est possible que ces options ne soit pas encore visibles sur votre tenant. Cela n’est qu’une question de jours.
Dans cet article, je teste le clipboard et les lecteurs, tout simplement parce que ce sont les deux redirections que j’avais déjà sous la main, restreintes via mes anciennes polices (j’y reviens juste en dessous). Mais le principe, l’enchaînement des trois couches, la logique d’évaluation à la connexion : tout est rigoureusement identique pour l’imprimante et l’USB. Si vous savez piloter le presse-papiers par contexte, vous savez piloter les quatre. Vous remplacez juste la redirection ciblée dans la dernière couche.
Pour info : la policy Remote Connection Experience expose chacune de ces redirections avec le même menu déroulant. Pour chaque ligne, vous choisissez « activé », « non configuré » ou « contexte d’authentification ». C’est ce dernier choix qui déclenche tout le mécanisme, et il se présente exactement de la même façon que vous soyez sur Clipboard, Drive, Printer ou USB.
2. Pourquoi maintenant ? Le durcissement par défaut depuis mi-2025
Petit détour utile pour comprendre pourquoi cette fonctionnalité tombe à pic. Depuis mi-2025, Microsoft a basculé d’une logique « tout ouvert, à vous de durcir » vers du secure by default : sur les nouvelles images Windows 365 et les nouveaux host pools AVD, les redirections (presse-papiers, lecteurs, USB, imprimantes) sont désactivées nativement. C’est aligné avec la Microsoft Secure Future Initiative (SFI).
J’ai déjà décortiqué ces deux sujets dans le détail, et je vous renvoie à mes articles précédents si vous voulez creuser le sujet :
Configurez le presse-papier dans AVD/W365 : le durcissement par défaut depuis le 18 juin 2025, la logique des deux couches (propriétés RDP côté client + polices GPO/Intune côté serveur), et le détail des niveaux SCClipLevel / CSClipLevel.
AVD : Restriction du Presse-papier : comment restreindre finement le copier-coller via Intune et les propriétés RDP, sens par sens et type de donnée par type de donnée.
Là où le bât blessait : cette restriction par défaut, bien qu’affinée, restait globale :
Au niveau des configurations RDP d’Azure Virtual Desktop :
Au niveau des polices de configuration Intune :
Une fois le presse-papiers (ou les autres) bloqué ou débloqué, il l’était pour toutes les connexions, sans distinction de l’appareil ou du réseau :
C’est exactement le mur que les Context-based Redirections font tomber : on garde la posture « fermé par défaut », mais on rouvre dynamiquement pour les connexions de confiance.
D’où l’enchaînement logique de cet article : on part d’un environnement où la redirection est restreinte, et on la rend conditionnelle :
3. Comment ça marche : l’architecture en 3 couches
C’est LE point à comprendre avant de cliquer partout. Le mécanisme repose sur trois couches qui s’enchaînent :
Le contexte d’authentification : un simple « jeton » d’exigence que l’on définit dans Entra et que l’on « publie ».
La policy d’accès conditionnel (CA) : elle cible ce contexte et impose une exigence (appareil conforme, réseau de confiance, MFA…). C’est elle qui décide si le claim c1 est émis ou non dans le token de session.
La policy Remote Connection Experience (RCE) côté Windows 365 (ou la propriété RDP du host pool côté AVD), qui lie une redirection donnée (clipboard, drive, printer ou USB) au contexte.
La logique de bout en bout, à la connexion :
La redirection est liée à c1 → elle est OFF par défaut, et ne s’allume que si le claim c1 est présent dans le token de session.
Le claim c1 n’est présent que si le step-up d’authentification pour c1 réussit.
Ce step-up réussit si aucune CA ne le bloque, ou si une CA qui le cible est satisfaite.
Mon retour terrain : la CA ne sert qu’à poser des exigences sur l’émission du claim c1. S’il n’y a aucune CA qui cible c1, rien ne bloque → le claim passe → vous avez vos redirections (selon ce que la RCE autorise). Dès qu’une CA cible c1, il faut la satisfaire ; si vous êtes bloqué par elle, le claim n’est jamais émis → redirection coupée. C’est aussi simple que ça, mais ça m’a pris un paquet de tests pour le formuler clairement.
4. Pré-requis
Brique
Ce qu’il vous faut
Poste de travail virtuel
Windows 365 Enterprise (Cloud PC) ou Azure Virtual Desktop
Identité & accès conditionnel
Microsoft Entra ID P1 (minimum) pour le Conditional Access
Gestion des stratégies
Microsoft Intune (config + RCE policy + conformité)
Client de connexion
Windows App (Windows / web / Android / iOS / macOS). Pas mstsc.
Image / agent
Cloud PC sur image récente prenant en charge la preview
Pré-requis à valider selon votre déploiement (W365 ou AVD).
5. Étape 0 : Débrayer les restrictions par défaut
Le piège classique, et il est sournois : sur les images récentes de Cloud PC (et les nouveaux pools d’hôtes AVD), les redirections client sont désactivées par défaut :
C’est précisément le durcissement dont je parlais à la section 2. Si vous laissez ça en l’état, vous allez croire que votre conf context-based « bloque bien »… alors qu’en réalité c’est juste le défaut restrictif qui parle. Et surtout : la policy la plus restrictive l’emporte. Tant qu’une stratégie restreint la redirection « en dur », le mécanisme context-based ne pourra jamais l’autoriser.
Si vous utilisez une image de galerie récente pour tester votre PC cloud ou si vous avez des stratégies existantes dans votre environnement qui affectent les redirections, modifiez-les avant le test, car la stratégie la plus restrictive l’emporte.
Par conséquent, vous devez définir les redirections que vous souhaitez tester pour qu’elles soient « non configurées » ou « activées » pour que la redirection basée sur le contexte fonctionne correctement.
La parade : créer (ou réutiliser) une policy Settings catalog dans Intune qui remet les redirections que l’on veut tester sur Disabled au sens « Do not allow… = Disabled » :
Autrement dit, on désactive la désactivation, donc on autorise. 😅
Dans mon lab, je m’appuie justement sur le groupe et les polices que j’avais montés pour mes articles précédents sur le presse-papiers : c’est mon point de départ « fermé », que je vais rouvrir conditionnellement.
Plateforme : Windows 10 and later ; type de profil : Settings catalog → Create.
Basics : donnez un nom parlant et une description.
Configuration settings → + Add settings.
Pour le presse-papiers, les lecteurs et l’USB : recherchez Device and Resource Redirection, sélectionnez la catégorie, puis cochez les réglages à piloter :
Pour l’imprimante : recherchez Printer Redirection (catégorie distincte) et cochez les réglages voulus :
Basculez chaque réglage « Do not allow… » sur Disabled. On ne veut aucune interdiction « en dur » sur les redirections qu’on va confier au contexte
Scope tags (facultatif) → Next
Assignments : ciblez le groupe qui doit recevoir la policy → Next
Review + create → Create
Une fois la configuration poussée sur le poste, cela nous donne la configuration de registre suivante :
Pour info : sous le capot, ces réglages pilotent les valeurs de registre RDP côté session (par ex. fDisableClip pour le presse-papiers, fDisableCdm pour les lecteurs). « Débrayé à 0 » = redirection autorisée. Si vous voulez le détail de ces clés, des deux couches client/serveur et des niveaux SCClipLevel / CSClipLevel, tout est dans mon article Configurez le presse-papier dans AVD/W365.
6. Étape 1 : Créer le contexte d’authentification (c1)
Première vraie brique du mécanisme. Le contexte d’authentification, c’est ce « jeton d’exigence » qu’on va ensuite cibler depuis la CA et lier depuis la RCE. Pas à pas :
Cochez impérativement Publish to apps, puis choisissez une valeur dans le menu ID (ici c1)
Sauvegardez
Attention : si Publish to apps n’est pas coché, vous pourrez bien référencer c1 dans la RCE policy, mais il ne sera jamais sollicité à la connexion. Résultat : la CA reste en « Not Applied » et rien ne se déclenche. C’est l’oubli n°1.
C’est ici que se joue la « condition de confiance ». Le squelette est toujours le même : la CA cible le contexte d’authentification c1 (dans Target resources, pas dans les conditions !), et c’est le Grant (ou l’exclusion) qui décide. Je vous donne trois cas de figure que j’ai testés.
Cas n°1 : Exiger un appareil conforme compliant
Le scénario BYOD par excellence : redirection autorisée depuis une machine gérée et conforme, coupée depuis une machine perso non gérée.
Conditional Access → Policies → New Policy :
Donnez un nom, puis des utilisateurs : All users sous Include (ou votre groupe de test) :
Target resources → menu Select what this policy applies to → Authentication context → cochez c1 :
Grant → Grant access → cochez Require device to be marked as compliant → Select.
Enable policy = On → Create.
Cas n°2 : Restreindre par adresse IP (Named location)
Ici on veut : redirection autorisée uniquement depuis un réseau de confiance (votre plage IP publique), coupée ailleurs.
Le point clé à intégrer : une location, c’est une CONDITION, pas un grant. On ne peut pas dire « autorise si IP de confiance ». La bonne logique est inversée : « Bloque c1 partout, SAUF depuis l’IP de confiance ».
D’abord, créez la Named location :
Conditional Access → Named locations → + New location (IP ranges)
Nommez-la et saisissez votre plage IP publique en CIDR (ex. 203.0.113.42/32)
Cochez Mark as trusted location si proposé → Create
Ensuite, la CA :
Users : All users (ou groupe de test)
Target resources → Authentication context → c1
Conditions → Locations : Include = Any location ; Exclude = Loc-Confiance
Grant → Block access → Select
Enable policy = On → Create
Attention : le Conditional Access voit l’IP publique de sortie du client. Derrière un NAT ou un proxy d’entreprise, c’est l’IP du NAT qu’il faut déclarer, pas celle du poste. Et si votre IP est dynamique (box FAI), le test peut « sauter » quand elle change. Élargissez la plage plutôt qu’un /32 figé.
Cas n°3 : Combiner conformité & adresse IP
Pourquoi pas les deux ? Pour exiger à la fois un appareil conforme et un réseau de confiance, deux approches :
Une seule CA : ciblez c1, Grant = Require device to be marked as compliant, ET ajoutez la condition Locations (Include = la location de confiance) pour ne l’évaluer que sur ce réseau. Hors réseau de confiance, prévoyez une seconde CA de blocage.
Deux CA qui ciblent c1 : une exige le compliant, l’autre bloque hors réseau de confiance. Comme toutes les CA ciblant c1 doivent passer, le claim n’est émis que si appareil conforme et sur réseau de confiance.
Mon retour terrain : quand plusieurs CA ciblent c1, elles se cumulent (« most restrictive wins » côté claim). Pour un test propre d’un seul cas, mettez les autres CA ciblant c1 sur Off le temps de l’essai, sinon vous ne saurez plus laquelle bloque.
8. Étape 3 : La police Remote Connection Experience (et la variante AVD)
C’est la couche qui lie une redirection au contexte c1. Côté Windows 365, ça passe par une policy Remote Connection Experience (preview). C’est aussi ici que vous décidez quelle(s) redirection(s) parmi les quatre (Clipboard, Drive, Printer, USB) vous confiez au contexte :
Intune → Devices → Manage Windows 365 Cloud PCs → Cloud PC Settings
Create → Remote Connection Experience (preview) :
Basics : nom et description de la police :
Dans Configuration settings → Device redirections, repérez la redirection à piloter (Clipboard, Drive, Printer ou USB) et choisissez Authentication context: Context-based redirection :
Dans le champ Entra Authentication context qui apparaît, sélectionnez c1.
Laissez les redirections non voulues sur Not configured.
Scope tags (facultatif) → Next :
Assignments → Add groups → sélectionnez un groupe de DEVICES (les Cloud PC), surtout pas un groupe d’utilisateurs → Next :
Review + create → Create :
Veillez à affecter cette stratégie d’expérience de connexion à distance Windows 365 à des groupes d’appareils (PC cloud), et non à des groupes d’utilisateurs.
La redirection basée sur le contexte étant appliquée au niveau de l’appareil, l’attribution de la stratégie aux utilisateurs n’applique pas le comportement de redirection attendu.
Pas de RCE policy : la liaison se fait dans les propriétés RDP du host pool. Dans l’onglet Device redirection, au lieu d’un toggle activé/désactivé, vous choisissez « Dynamically configure using authentication context » et sélectionnez le contexte. La logique d’évaluation à la connexion est la même qu’en Windows 365.
9. Pièges & retour terrain
Le piège qui m’a rendu fou : la persistance du token Windows App : Windows App garde un token de session en cache. Tant que ce token vit, le résultat du step-up c1 (présent ou absent) est figé dedans. Vous pouvez changer la CA et la RCE mille fois, la session en cours ne réévalue rien. Il faut un token frais : vraie déconnexion/reconnexion. Ne perdez pas trois heures comme moi à modifier des policies : reconnectez-vous avec une session neuve.
Client non supporté : avec mstsc / Bureau à distance legacy, c1 n’est jamais demandé. Passez par Windows App.
Assignation RCE sur des users : la RCE/context-based s’applique au device. Assignée à un groupe d’utilisateurs, elle ne fait rien. Groupe de devices (Cloud PC) obligatoire.
« Publish to apps » oublié sur le contexte d’authentification → c1 jamais sollicité → CA « Not Applied ».
Restrictions par défaut non débrayées → « most restrictive wins » → la redirection reste coupée quoi que vous fassiez.
Direction du clipboard : le binding porte sur une direction précise (ex. « clipboard local disponible dans la session distante » = copie sur votre PC → colle DANS le Cloud PC). Testez bien la direction que vous avez liée à c1.
Propagation lente : comptez quelques minutes côté CA, et au premier déploiement la RCE peut nécessiter un redémarrage du Cloud PC avant d’être prise en compte.
10. Conclusion
Voilà, comment en 4 étapes, on est passé d’un Cloud PC tout neuf à une redirection dynamique qui s’adapte à la confiance de la connexion. Concrètement, ça donne quoi ? Un seul host pool / une seule conf, et la redirection (presse-papiers, lecteurs, mais aussi imprimante et USB sur exactement le même modèle) qui s’ouvre pour les machines conformes (ou sur le bon réseau) et qui se ferme pour le reste.
Le rêve du BYOD sans compromis. J’ai testé le clipboard et les lecteurs, mais gardez bien en tête que les quatre redirections se pilotent à l’identique : c’est la même mécanique de bout en bout.
Foncez tester en lab, c’est clairement l’une des évolutions sécurité les plus utiles de l’année sur AVD / Windows 365. Einfin pour aller plus loin : quelques lectures qui complètent bien le sujet, et que je vous recommande :
Vous avez vu passer l’annonce Microsoft parlant d’une file share comme une ressource Azure de premier niveau et vous vous dites : mais attendez, les partages de fichiers existent depuis des années dans Azure, où est la nouveauté ? Cet article est fait pour vous. On va partir du modèle historique : le compte de stockage pour dérouler ce que change vraiment le nouveau provider Microsoft.FileShares, passé en GA en 2026, et surtout vous aider à trancher : vous migrez, ou pas encore ?
Azure Files introduit une nouvelle expérience de gestion des services de partage de fichiers, désormais généralement disponible, dans laquelle les partages sont déployés en tant que ressources Azure indépendantes et de niveau supérieur via le Microsoft.
Chaque partage de fichiers a des performances dédiées, la sécurité, la mise en réseau et la facturation, ce qui permet une meilleure isolation, des performances prévisibles et un suivi précis des coûts.
L’expérience améliore également considérablement la mise à l’échelle et l’efficacité, prenant en charge jusqu’à 10 000 partages par abonnement par région, un provisionnement plus rapide et une automatisation native cloud via des modèles ARM, des Bicep et des flux de travail CI/CD.
Il est actuellement disponible pour les partages NFS 4.1.
C’est la première confusion qu’il faut lever, parce qu’on l’entend partout : « des partages de fichiers, Azure en propose depuis longtemps ». Vrai… et faux. Jusqu’ici, le partage de fichiers n’a jamais été une ressource Azure à part entière. C’était toujours un objet enfant, créé à l’intérieur d’un compte de stockage. La ressource Azure, celle que vous voyiez dans votre groupe de ressources, c’était le compte de stockage et pas le partage :
Cette nuance n’est pas de la sémantique : c’est elle qui explique 90 % des frictions qu’on va voir. Tant que le partage était un sous-objet, il héritait de tout ce qui appartenait au compte. Le nouveau modèle casse précisément cet héritage.
2. Avant : tout partait du compte de stockage
Pour rappel, jusqu’ici le schéma était le suivant : vous créiez un compte de stockage, vous choisissiez un SKU (général avec blobs/queues/tables, ou un SKU dédié file storage), puis vos partages SMB ou NFS sous ce compte. Tout partait de là, et c’est là que les ennuis commençaient.
Les limites sont partagées. IOPS, capacité provisionnée, débit : c’est le compte qui porte les plafonds, et tous les partages se les répartissent. Un partage gourmand peut pénaliser les autres.
Le control plane aussi est mutualisé. Créer, modifier, supprimer des partages, gérer les snapshots : ces opérations tapent dans des quotas au niveau du compte. À plusieurs administrateurs sur le même compte, ça devient un point de contention :
Le réseau est hérité. C’est le compte de stockage qui porte la configuration réseau. Vos private endpoints, vos règles, vous les héritez du compte, donc pas de granularité par partage :
La facturation est au niveau du compte. Bon courage pour faire du showback / chargeback propre par partage : il faut décortiquer une facture agrégée :
La clé de compte est toute-puissante. La fameuse account key donne accès à tout ce qui vit dans le compte de stockage. Côté sécurité, c’est un secret à très large rayon d’action :
Le piège classique : au moment de créer un compte de stockage, le nombre d’options (SKU, type, redondance, protocoles…) est tel qu’on ne sait plus exactement ce qu’on configure. Beaucoup de comptes finissent surdimensionnés ou mal typés « au cas où ».
3. Après : Microsoft.FileShares, ressource de premier niveau
Concrètement, ça donne quoi ? Microsoft introduit un nouveau provider de ressources, Microsoft.FileShares, et avec lui un nouveau type de ressource top-level : le partage de fichiers lui-même. Pas d’enfant, pas de parent compte de stockage. Vous créez directement un file share dans un groupe de ressources et un abonnement, vous lui donnez un nom, et c’est tout.
Nous annonçons la mise à disposition générale d’une nouvelle expérience de gestion des services pour les partages de fichiers SSD Premium (NFS), qui permet de créer, sécuriser, faire évoluer et facturer chaque partage de fichiers de manière indépendante, sans être lié à un compte de stockage.
Gestion familière et intuitive des partages de fichiers : l’expérience utilisateur s’aligne sur les modèles des NAS et des serveurs de fichiers sur site, ce qui améliore la convivialité par rapport au modèle classique.
Infrastructure-as-Code : définissez la nomenclature, la capacité, les IOPS, la mise en réseau, les balises et la sécurité dans des modèles Bicep ou ARM pour une automatisation simplifiée avec vos outils DevOps préférés.
Évoluez en fonction de la charge de travail : prise en charge de jusqu’à 10 000 partages de fichiers par abonnement et par région, avec une expérience de provisionnement des partages de fichiers 2,5 fois plus rapide.
Sécurité et réseau au niveau des partages : restrictions réseau, instantanés et chiffrement limités au partage individuel, ce qui permet de faire correspondre les limites d’isolation aux limites de la charge de travail.
Visibilité des coûts par partage : les compteurs de facturation s’affichent sous la ressource de partage de fichiers, ce qui permet aux équipes d’effectuer des refacturations précises, de suivre les coûts par charge de travail et d’améliorer la refacturation sans avoir recours à des solutions de contournement.
Au jour du GA, le périmètre est volontairement resserré :
Tier SSD uniquement
Protocole NFS 4.1 uniquement
Facturation alignée sur le modèle provisioned v2 SSD
Côté résilience, vous choisissez LRS ou ZRS
Capacité, IOPS et débit se provisionnent indépendamment
Azure file share using Microsoft.FileShares is now generally available… shares are deployed as independent, top-level Azure resources through the Microsoft.FileShares resource provider, removing the dependency on storage accounts.
Assez de théorie, passons aux mains dans le cambouis. Le mieux pour comprendre ce qui change, c’est de dérouler la création d’un partage dans le portail. Vous allez voir : il n’y a plus jamais le mot « compte de stockage » dans le parcours.
Étape 0 : Le nouveau point d’entrée « File shares »
Depuis l’accueil du portail, vous cherchez directement File shares. C’est un hub à part entière, qui liste vos partages comme des ressources autonomes :
Étape 1 : Les bases : abonnement, groupe de ressources, nom
On clique sur Create. Et là, surprise par rapport au monde d’avant : on vous demande un abonnement, un groupe de ressources et un nom de partage. Point. Exactement comme pour n’importe quelle ressource Azure de premier niveau :
Étape 2 : Tier, protocole et résilience
Au GA, le choix est volontairement cadré : tier SSD et protocole NFS 4.1 imposés. La seule décision de résilience se fait ici, au niveau du partage : LRS (redondance locale) ou ZRS (redondance inter-zones) selon la région Azure choisie :
Étape 3 : Le cœur du sujet : capacité, IOPS et débit séparés
C’est l’écran le plus important. Vous provisionnez la capacité, les IOPS et le débit de façon indépendante. Plus de « budget commun » réparti entre tous les partages du compte : ce que vous réglez ici, ce sont les limites de ce partage, et de lui seul :
Les maximums d’IOPS et de débit s’ajustent selon la capacité choisie (la plage va de 32 Gio à 256 Tio).
Le Calculateur de prix Azure vous permet de travailler ces valeurs, tout en mesurant l’impact sur le prix :
Étape 4 : L’onglet Advanced : root squash, chiffrement et nom de montage
C’est l’onglet qu’on a tendance à survoler, et c’est dommage, parce qu’il porte trois réglages qui changent la vie côté NFS :
Protocol → Root squash. C’est le mapping de l’identité root côté client NFS. Vous choisissez entre no root squash, root squash et all squash selon le niveau de confiance que vous accordez aux clients qui montent le partage.
Security → Require encryption in transit. Vous imposez le chiffrement du flux entre le client et le partage. À garder activé sauf raison impérieuse.
Other → Mount name. Vous donnez au partage un nom de montage différent du nom de la ressource Azure. Pratique pour garder des chemins de montage propres côté clients NFS sans vous imposer la convention de nommage Azure.
Mon retour terrain : le Mount name est le petit réglage que je règle systématiquement. Découpler le chemin de montage du nom de la ressource Azure vous évite de trimballer une convention de nommage cloud jusque dans vos fstab et vos scripts. Vos clients NFS gardent des chemins courts et lisibles.
Étape 5 : Le réseau, au niveau du partage
Autre changement de fond : la configuration réseau se fait ici, pas sur un compte parent. Vous décidez pour ce partage s’il est exposé en public endpoint ou enfermé derrière des private endpoints. Chaque partage a donc sa propre posture réseau :
Étape 6 : Review + create, le moment de vérité
On valide, on crée. Et là, magie : le partage apparaît dans le groupe de ressources comme une ressource Microsoft.FileShares à part entière, avec ses propres tags, son propre coût, son propre control plane :
Aucune clé de compte à aller récupérer quelque part, parce qu’il n’y en a tout simplement pas :
Du côté des performances et de la taille, tout est toujours rectifiable :
Et c’est là que le bât blesse. Du côté de la sauvegarde, un menu Snapshots est bien présent, mais il ne permet que des déclenchements manuels :
Plus inquiétant : le service de sauvegarde Azure Recovery Services vault ne le voit même pas :
Même chose pour les Backup vaults, qui ne sauvegardent pas ce type de stockage :
Et même le service Resiliency ne le détecte pas :
Attention ! la sauvegarde, c’est LE gros angle mort du GA : côté protection des données, on est à l’os. Le menu Snapshots existe, mais en déclenchement manuel uniquement : pas de planification, pas de rétention automatique.
Pire, la ressource est invisible pour Azure Backup, ni le coffre Recovery Services, ni les Backup vaults ne la voient et elle n’apparaît même pas dans Resiliency. Autrement dit : aucune sauvegarde managée au GA. Si votre donnée a la moindre valeur, prévoyez votre propre stratégie (snapshots scriptés + copie hors-partage) en attendant que Microsoft branche la protection native.
Étape 7 : On monte le partage : la lame Connect
Mais avant d’aller plus loin dans la connexion, l’intégration réseau est obligatoire :
Mon réseau est à présent configuré sur celui de ma machine Linux via un Service Endpoint :
Reste à le monter côté client. La lame Connect du partage vous donne directement la commande de montage NFS, avec le bon endpoint et les bonnes options pré-remplis : vous n’avez qu’à la copier sur votre client Linux :
Téléchargez le paquet Microsoft correspondant à votre version d’Ubuntu, afin d’ajouter le dépôt officiel Microsoft (nécessaire pour installer ensuite des outils comme aznfs) :
La commande sudo apt-get update met à jour la liste des paquets disponibles, puis sudo apt-get install aznfs installe le client Azure NFS (aznfs) depuis le dépôt Microsoft :
sudo apt-get update
sudo apt-get install aznfs
Créez le dossier /mount/jloshare qui servira de point de montage pour le partage NFS :
sudo mkdir -p /mount/jloshare
Montez le partage Azure Files en NFS sur votre point /mount/jloshare en utilisant le client optimisé aznfs, avec des options de performance et de compatibilité NFS 4.1 :
sudo mount -t aznfs fs-vlsw3zm2p5tvmn54j.z22.file.storage.azure.net:/fs-vlsw3zm2p5tvmn54j/jloshare /mount/jloshare -o vers=4,minorversion=1,sec=sys,nconnect=4
Affichez les systèmes de fichiers montés et filtrez pour vérifier que votre partage jloshare est bien monté :
df -h | grep jloshare
Depuis le portail Azure, la modification du volume du file share apparait immédiatement sur le partage :
5. Ce que vous gagnez concrètement
Le bénéfice tient en un mot : isolation. Tout ce qui était mutualisé au niveau du compte redescend au niveau du partage.
Performance dédiée : chaque partage a ses propres limites de capacité, d’IOPS et de débit. Plus de voisin bruyant qui mange votre budget perf.
Control plane par partage : les opérations (création, modification, suppression, snapshots) consomment un quota propre à chaque partage, sur un modèle de « seau » qui se recharge en continu. Les plafonds sont tellement hauts qu’en pratique, les blocages control-plane qu’on connaissait deviennent très improbables.
Réseau par partage : public endpoint, private endpoints : vous les configurez au niveau du partage, pas d’un compte parent qui impose ses règles à tout le monde.
Plus de clé de compte : il n’y a tout simplement pas d’account key toute-puissante. Le partage est sa propre ressource, avec sa propre surface de sécurité.
Facturation et tags granulaires : le coût est porté par le partage (capacité + IOPS + débit), avec ses propres tags. Le showback / chargeback devient enfin trivial.
Mon retour terrain : le gros gain au quotidien, ce n’est pas la perf brute, c’est la traçabilité des coûts et la fin de la clé de compte. Sur des environnements multi-équipes ou multi-projets, pouvoir taguer et facturer partage par partage change la vie des FinOps.
6. Les limites au jour du GA
Soyons honnêtes : « GA » ne veut pas dire « complet ». Le modèle est jeune, et plusieurs fonctionnalités qu’on tient pour acquises côté classique ne sont pas encore là. À l’heure où j’écris, il manque notamment :
La sauvegarde managée. C’est le point noir : au GA, vous n’avez que des snapshots manuels. Pas d’Azure Backup sur ce type de ressource, ni coffre Recovery Services, ni Backup vault ne le prennent en charge et il n’apparaît pas non plus dans Resiliency (voir la démo §4). La protection de la donnée est entièrement à votre charge.
SMB. C’est NFS 4.1 uniquement. Si vos workloads sont Windows/SMB (AVD + FSLogix, partages bureautiques…), ce modèle ne vous concerne pas encore.
CMK (clés gérées par le client), soft delete / corbeille, autres protocoles. Tout ça est annoncé comme « à venir », mais pas disponible au GA.
Attention ! FSLogix / AVD, ce modèle n’est pas pour vous aujourd’hui : au GA, c’est NFS 4.1 uniquement, et SMB n’est pas disponible. Or FSLogix exige du SMB (profils VHD/VHDX montés en SMB). Mécaniquement, vous ne pouvez pas poser vos profils FSLogix sur un partage Microsoft.FileShares pour l’instant. Pour de l’AVD, restez sur le compte de stockage classique en Azure Files SMB (provisioned v2 SSD). SMB est annoncé « à venir » sur ce nouveau modèle : le jour où il arrive, l’isolation par partage et la fin de l’account key deviendront très intéressantes pour de l’AVD multi-équipes, mais on n’y est pas.
7. Alors, je l’utilise ou pas ?
La règle est simple : si vos besoins rentrent dans le périmètre actuel, c’est le futur, foncez. Sinon, le classique fait toujours le job. Voici comment je le résume.
Voilà : cette « nouvelle ressource file share », ce n’est pas un énième renommage, c’est un vrai changement d’architecture. Le partage cesse d’être un sous-objet du compte de stockage pour devenir une ressource Azure de plein droit, avec sa perf, son réseau, sa sécurité et sa facture à lui. À la clé : une isolation propre, la fin de la clé de compte toute-puissante, un coût traçable partage par partage et une vraie compatibilité infrastructure-as-code.
Les trois pièges à retenir avant de vous lancer :
La sauvegarde, c’est le gros trou du GA : Snapshots manuels uniquement, et aucune prise en charge par Azure Backup (Recovery Services vault, Backup vault) ni par Resiliency. La protection de la donnée est à votre charge, n’y mettez rien de critique sans stratégie maison.
NFS 4.1 / SSD uniquement : pas de SMB (donc pas de FSLogix / AVD), pas de HDD.
Facturation provisioned v2 : dimensionnez correctement capacité, IOPS et débit, vous payez le provisionné.
Si vous êtes sur du NFS, foncez tester en lab : c’est clairement la direction que prend Azure Files. Pour le reste, le classique a encore de beaux jours devant lui, le temps que la sauvegarde managée, SMB et les autres briques manquantes débarquent.
Dernier point, et il pèse lourd dès qu’on dimensionne du provisionné : la capacité réservée, vous la payez. Autant ne pas voir trop large « au cas où » et faire grossir le partage automatiquement quand le besoin arrive.