Display Protection sur AVD/Windows 365

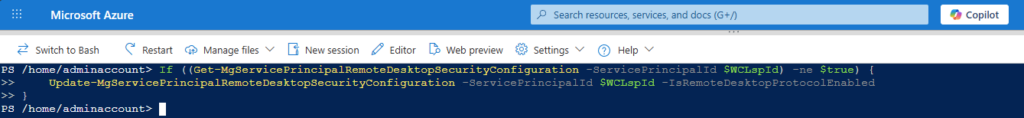
Vous avez peut-être déjà entendu parler de Display Protection, vous vous doutez que ça doit bloquer les captures d’écran sur AVD ou Windows 365, mais vous n’avez jamais mis les mains dedans ? Rassurez-vous, la préversion publique vient juste de sortir et cet article est fait pour vous. On part d’un host pool Azure Virtual Desktop tout ce qu’il y a de plus classique, où le Snipping Tool capture allègrement la session, et on va dérouler, capture après capture, jusqu’à un flux d’affichage chiffré que le poste local n’arrive tout simplement plus à copier.
Un mot tout de suite sur le statut : la fonctionnalité est passée maintenant en preview publique. Et pour vous guider plus facilement dans cet article, voici des liens rapides :

1. Display Protection, c’est quoi au juste ?

Display Protection est le volet Output Protection de la famille Input and Output Protection 😂. Le principe tient en une phrase : le flux d’affichage est chiffré avant même de quitter le Cloud PC ou la session host, et il n’est déchiffré que dans un chemin de rendu de confiance sur le poste local.

Quand le GPU de l’endpoint sait faire, et Microsoft précise que les GPU intégrés comme discrets sont supportés, le déchiffrement se fait directement dedans. Sinon, on retombe sur un rendu logiciel protégé. Dans les deux cas, un outil de capture qui tourne sur le poste local ne voit plus le contenu de la session : il n’a pas de quoi décoder ce qu’il intercepte.

« …protect display output […] against unauthorized screen capture and recording »

Source : Display Protection for Windows 365 and Azure Virtual Desktop, Microsoft Learn
Trois caractéristiques structurantes à retenir de la documentation. D’abord, seuls les clients Windows App qui atteignent le niveau de protection exigé peuvent ouvrir une session protégée : c’est une exigence de confiance sur l’endpoint, pas un simple réglage cosmétique. Ensuite, le niveau de protection est configurable, avec une option d’exigence HDCP pour les écrans connectés. Enfin, la protection s’applique uniquement à la session distante affichée et ne change rien au comportement du Cloud PC lui-même.

Pour rappel, jusqu’ici, la seule réponse à la question « comment j’empêche un utilisateur de screenshoter sa session ? » était Screen Capture Protection, qui demande poliment à l’OS local de ne pas capturer. Display Protection change la nature du problème : le poste local n’a pas la clé.
2. Ne pas confondre : quatre features qui se ressemblent

C’est le point où tout le monde se mélange les pinceaux, y compris en avant-vente. Quatre fonctionnalités Microsoft parlent de protection de l’écran ou de la frappe, et elles ne font pas du tout la même chose.

FonctionnalitéCe qu’elle protègeCommentClients supportés
Display Protection (preview)L’affichage, contre la capture et l’enregistrement depuis le poste localChiffrement du flux d’affichage, déchiffrement dans le GPU ou en rendu logiciel protégéWindows App sur Windows 11 physique uniquement
Screen Capture ProtectionLa capture d’écran, via les API de l’OS localStratégie Intune (settings catalog) ou GPO appliquée à la VM ou au Cloud PCWindows, macOS, et iOS/iPadOS, Android, web via MAM Intune
WatermarkingRien techniquement, ça dissuade la photo au smartphoneFiligrane à code QR traçable dans la sessionMulti-plateformes
Input Protection (preview)Les frappes clavier, contre les keyloggersDriver noyau et MSI Windows Cloud IO Protect installé sur l’endpointWindows 11 physique avec TPM 2.0

La nuance qui compte : Microsoft écrit noir sur blanc, à propos de Screen Capture Protection, que la fonctionnalité « doesn’t provide Digital Rights Management (DRM)-level protection ». Display Protection joue dans une autre catégorie, celle du chemin d’affichage protégé de bout en bout. Les deux ne s’excluent pas, elles se complètent dans une logique de défense en profondeur.

Attention : Input Protection et Display Protection sont deux composants distincts de Input and Output Protection, et ils se configurent indépendamment. Activer l’un n’active pas l’autre, et ils n’ont ni la même propriété RDP, ni les mêmes pré-requis côté endpoint.

3. Les trois niveaux de protection

Azure Virtual Desktop et Windows 365 exposent exactement les mêmes niveaux. C’est le cœur de la décision d’architecture, donc autant les avoir en tête avant de toucher au portail.

NiveauValeur RDPComportement
Not configured0Pas de protection d’affichage sur le Cloud PC ou la session host.
Hardware or software enforcement1La machine tente d’établir un canal d’affichage protégé matériel. Si la protection matérielle n’est pas disponible, elle bascule sur la protection logicielle.
Hardware enforcement required2Le canal protégé matériel est obligatoire. Si l’endpoint ne peut pas le fournir, la connexion est bloquée et l’utilisateur voit une erreur.

Dans ce pas-à-pas je reste sur le niveau 1, celui qui ne casse personne : si le GPU du poste ne suit pas, on dégrade vers le logiciel au lieu de refuser la connexion. Le niveau 2 mérite son propre article, avec un parc d’endpoints qualifié en amont, parce qu’il transforme chaque poste non conforme en ticket au support.

4. Les pré-requis

ÉlémentExigence
ClientWindows App version 2.0.1236.0 ou plus récente, à mettre à jour depuis le Microsoft Store.
Poste localUn appareil Windows 11 physique. Les machines virtuelles ne sont pas supportées comme endpoint.
Machine distanteCloud PC Windows 365 ou session host Azure Virtual Desktop sur une version d’OS client Windows supportée, ou Windows Server.
AffichageUn écran piloté par le GPU du poste, en sortie HDMI, DisplayPort ou USB-C DisplayPort Alt Mode. Résolution jusqu’à 4K (3840 x 2160).
Non supportéEndpoints virtualisés, macOS, iOS, Android, navigateurs web, et appareils Windows 365 Link.

Ce tableau, lisez-le deux fois. La moitié des échecs de test viennent de là, en particulier la ligne « poste local » : si vous testez depuis une VM de démo, ça ne marchera jamais, quel que soit le nombre de fois où vous cliquerez sur Reconnect.

5. Étape 0 : la baseline de mon lab AVD

Avant de toucher quoi que ce soit, on documente l’état initial. C’est ce qui rendra la démonstration crédible auprès d’un RSSI, et ça évite de se demander plus tard si le comportement observé vient de la nouvelle configuration ou d’autre chose.

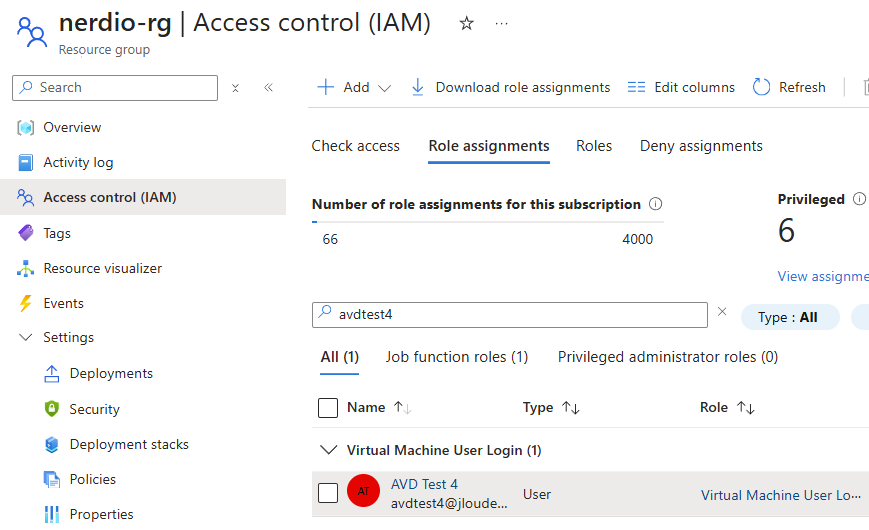
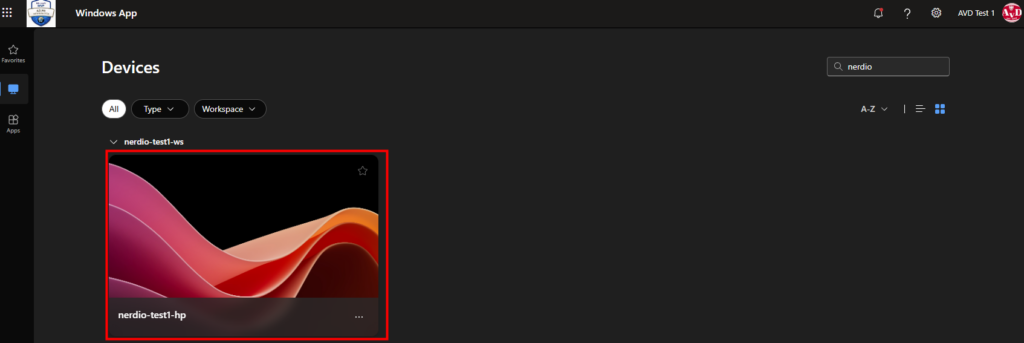
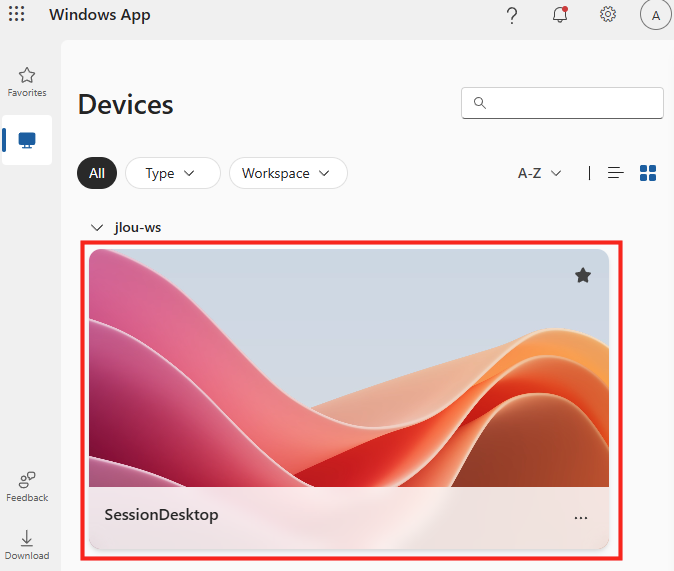
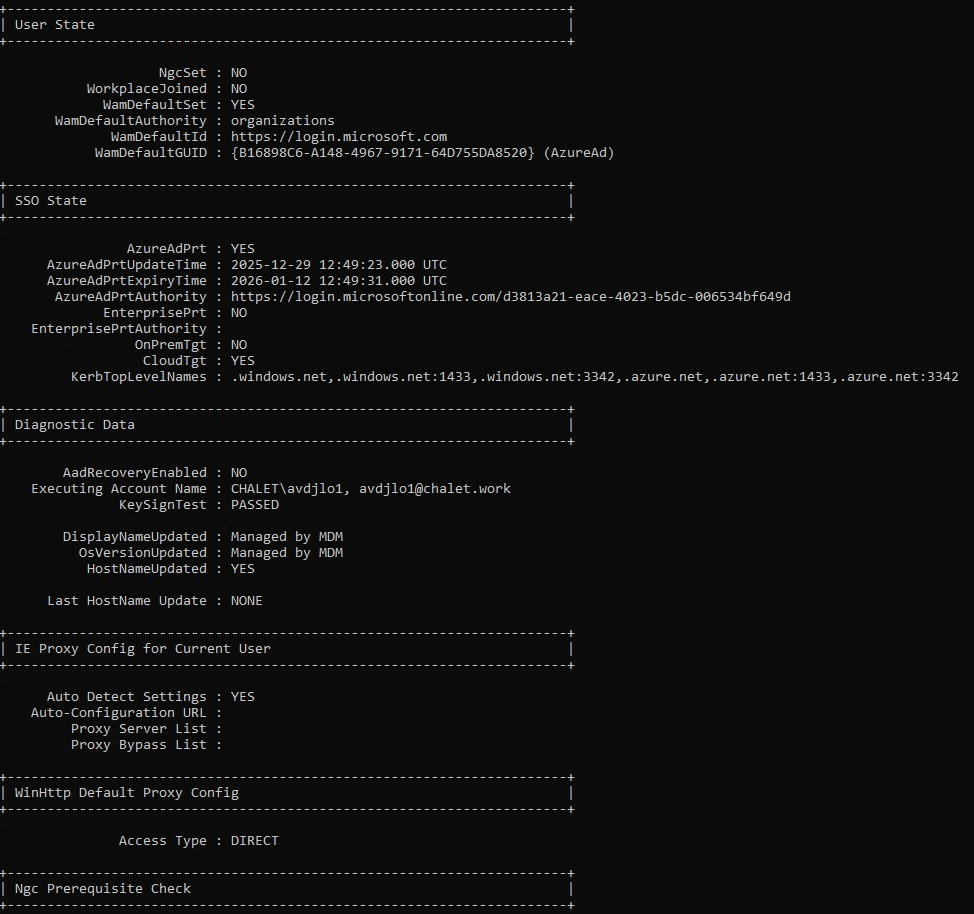
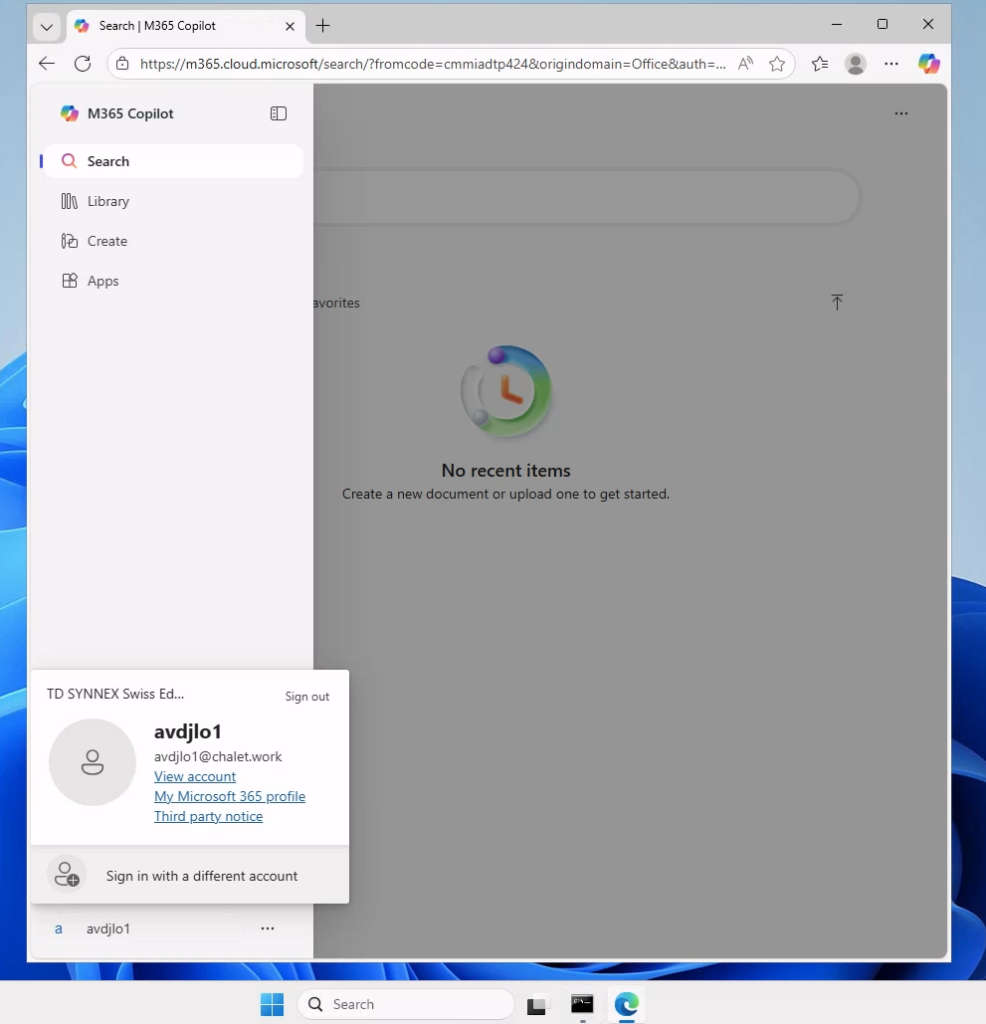
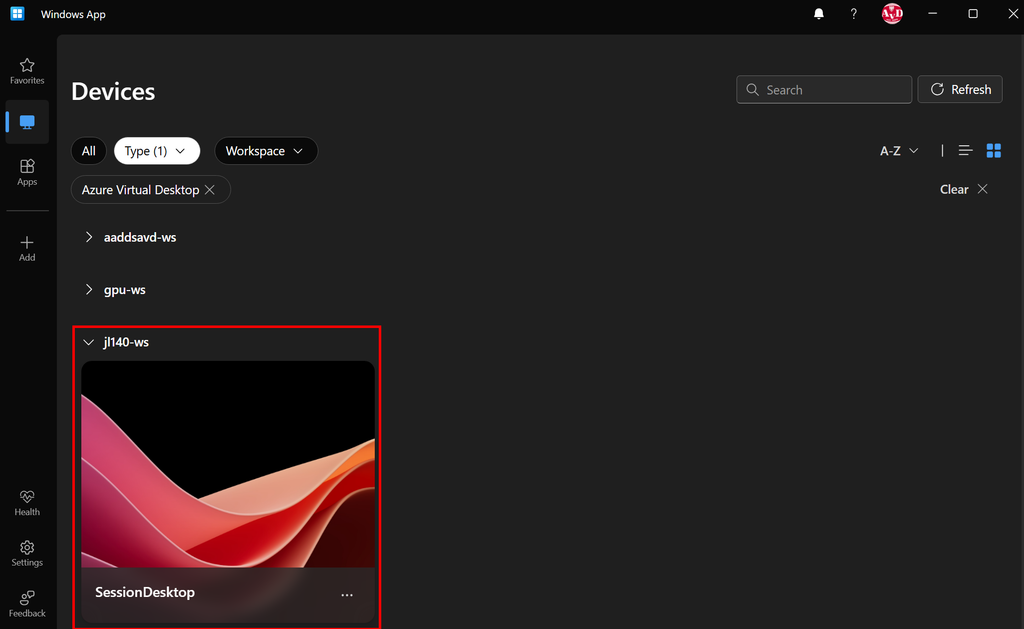
  1. Depuis le poste Windows 11 physique, ouvrez Windows App et connectez-vous au host pool de test :
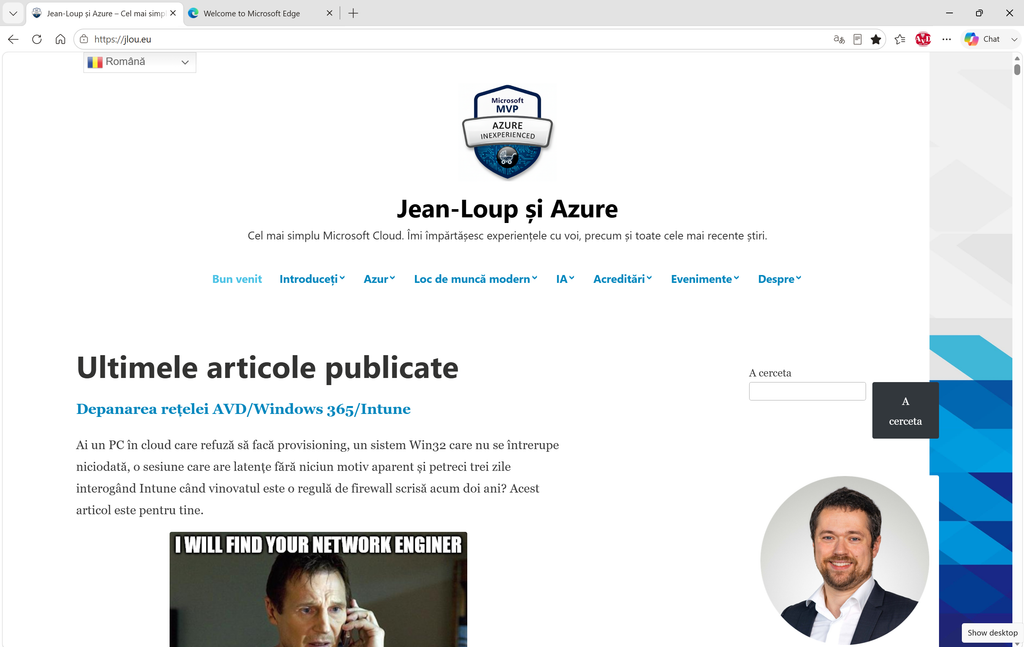
  1. Dans la session distante, affichez quelque chose de reconnaissable : un document, une page, peu importe, tant que c’est identifiable sur une capture :
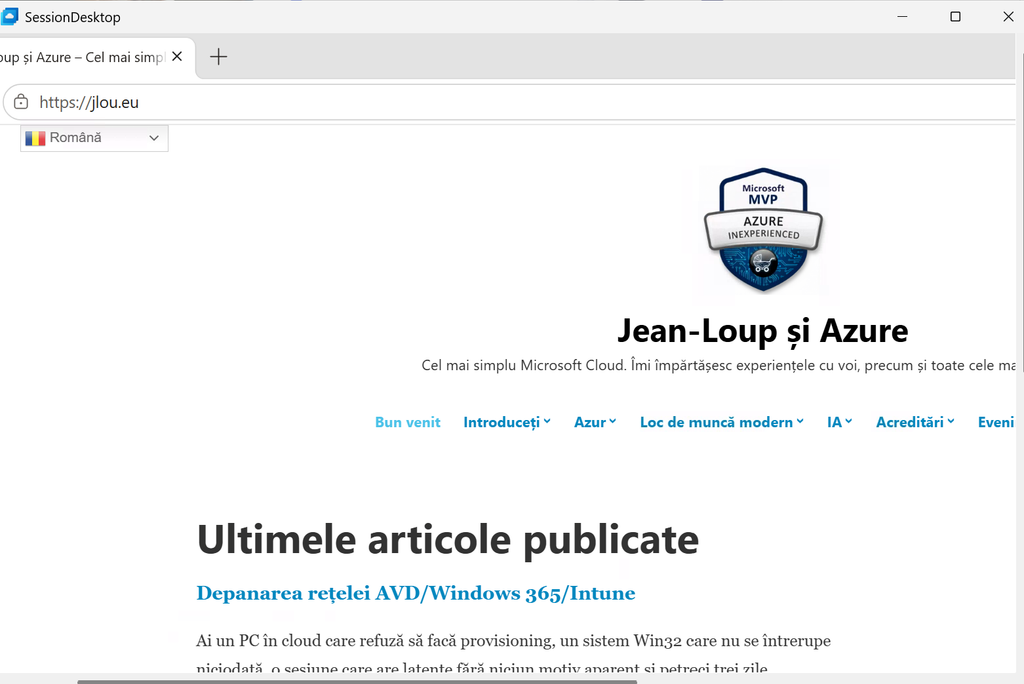
  1. Sur le poste local, pas dans la session, déclenchez l’outil Capture d’écran de Windows et capturez la fenêtre de la session. Collez le résultat et constatez : tout est lisible. C’est la situation de départ :
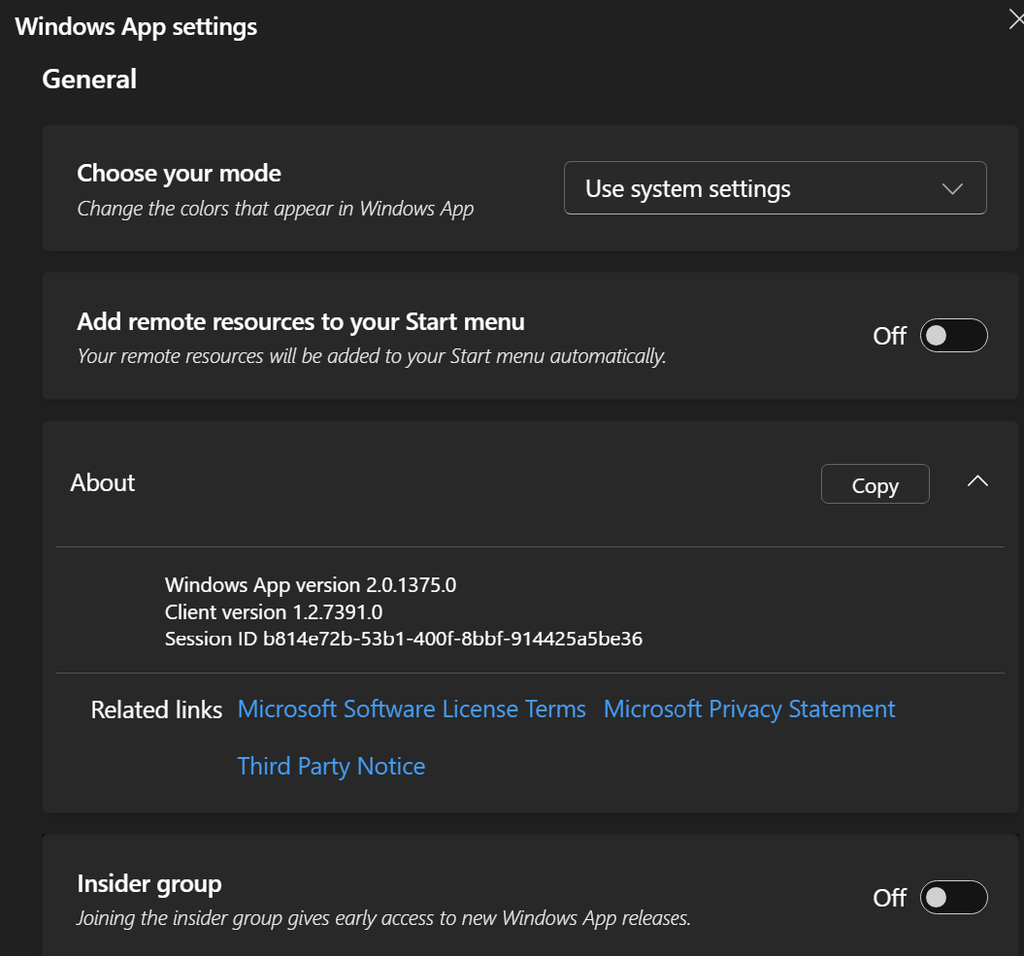
Notez au passage la version exacte de Windows App et la configuration graphique du poste. Ces deux informations vous serviront si un comportement bizarre apparaît plus loin :
6. Étape 1 : la propriété RDP sur le host pool

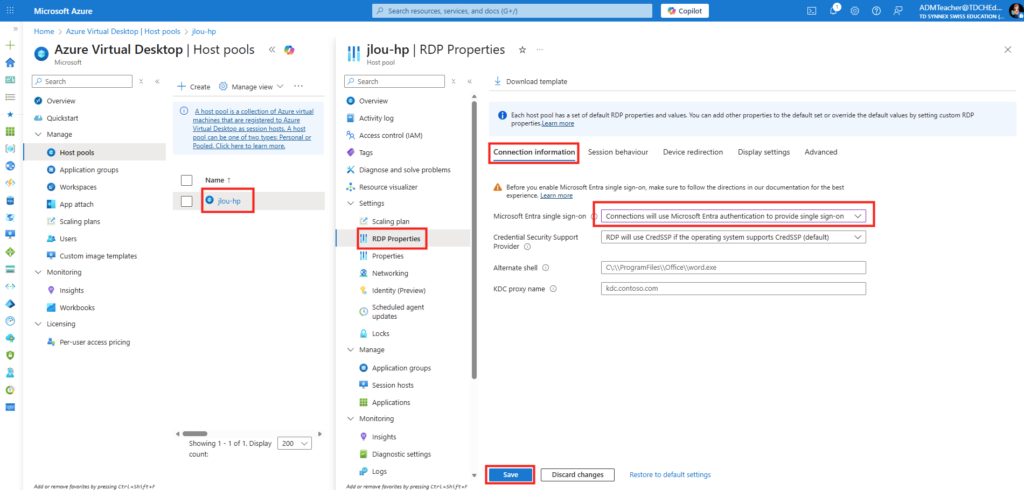
Côté Azure Virtual Desktop, la configuration passe par une propriété RDP ajoutée sur le host pool. Pas de GPO, pas de clé de registre, pas d’extension à déployer sur les session hosts.

  1. Dans le portail Azure, ouvrez le host pool cible.
  2. Allez dans RDP properties, puis l’onglet Advanced.
  3. Ajoutez la propriété suivante, puis enregistrez.
enableWindowsCloudIODisplayProtection:i:1

La valeur finale correspond au niveau choisi : 0 pour not configured, 1 pour hardware or software enforcement, 2 pour hardware enforcement required. Cette propriété active la vérification côté serveur que Display Protection est bien appliqué sur l’endpoint.
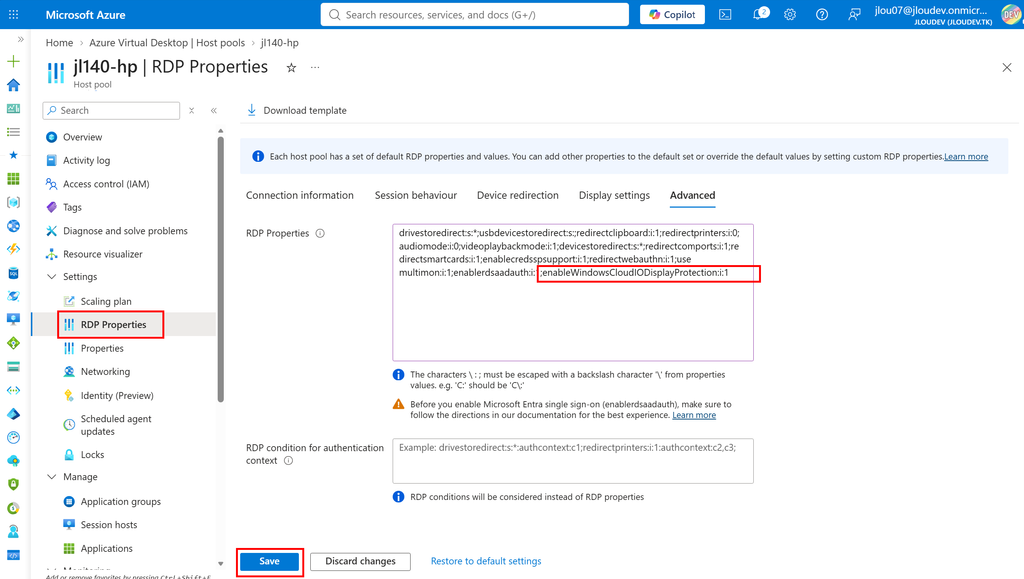
Attendez la sauvegarde du changement de la propriété avant de continuer :
Attention : activez la fonctionnalité uniquement sur les session hosts ou les Cloud PC que vous voulez inclure dans la validation de la preview. Microsoft le recommande explicitement, et sur un host pool de production partagé c’est la différence entre un test maîtrisé et une vague d’appels au helpdesk.

7. Étape 2 : préparer le poste client

La configuration est poussée vers l’endpoint à travers les propriétés de connexion RDP, puis mise en cache sur l’appareil. C’est ce cache qui explique la quasi-totalité des faux négatifs lors des tests.

  1. Vérifiez la version de Windows App sur le poste et mettez-la à jour depuis le Microsoft Store si elle est inférieure à 2.0.1236.0 :
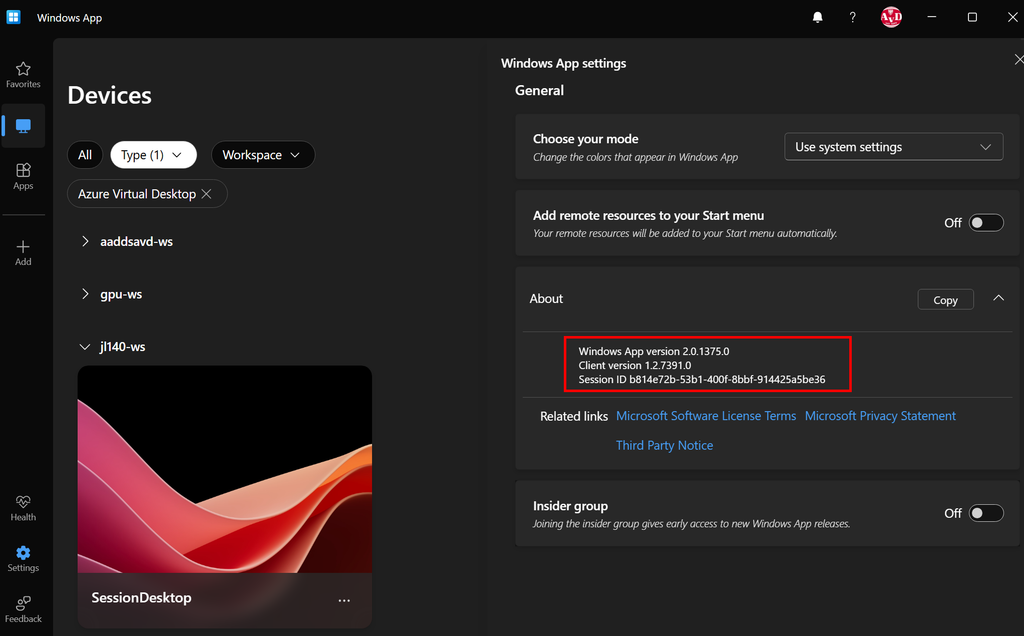
  1. Dans Windows App, sélectionnez Refresh pour récupérer immédiatement la configuration à jour :
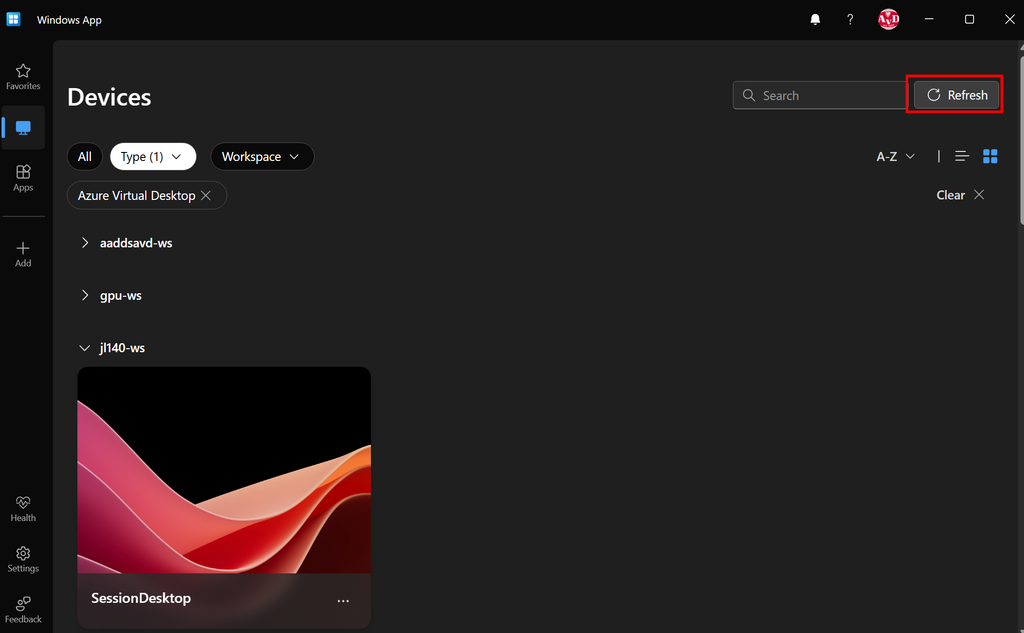
  1. Fermez la session existante, ne vous contentez pas d’une reconnexion sur une session déjà ouverte.
Attention : sans le Refresh, un changement de configuration peut mettre jusqu’à 8 heures à atteindre un endpoint. Si vous testez juste après avoir enregistré la propriété RDP et que rien ne se passe, ce n’est probablement pas un bug, c’est le cache.

8. Étape 3 : le moment de vérité

Le moment de vérité. On ouvre une nouvelle session et on refait exactement le même geste qu’à l’étape 0.

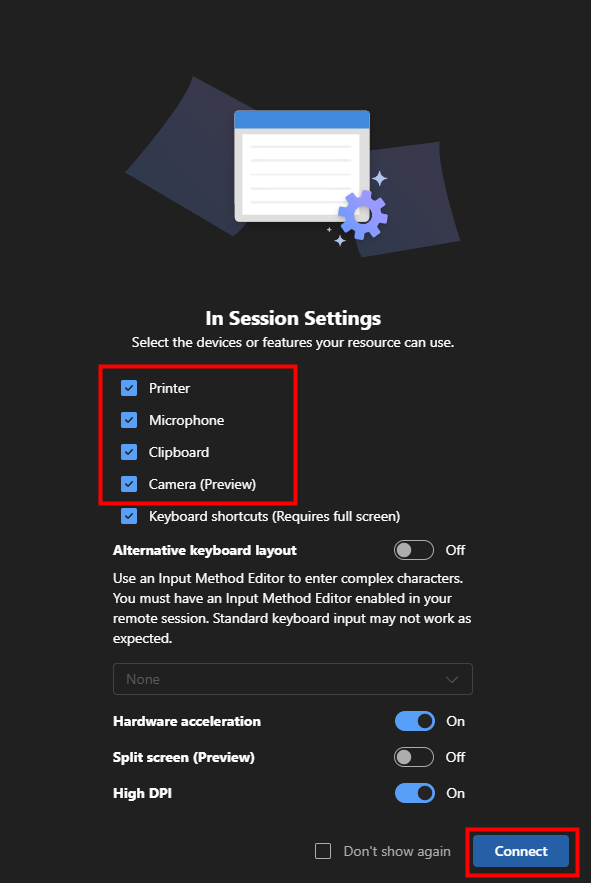
  1. Depuis le poste Windows 11 physique, ouvrez une nouvelle session sur le session host où Display Protection est activé :
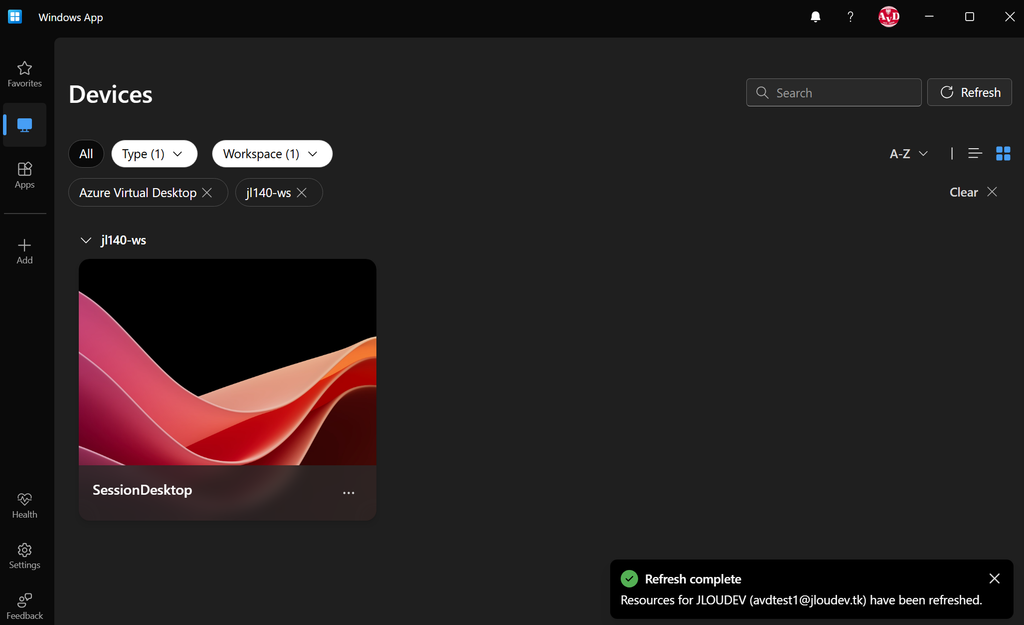
  1. Vérifiez que la connexion aboutit sans message d’erreur. C’est déjà une information : cela veut dire que l’endpoint satisfait le niveau demandé.
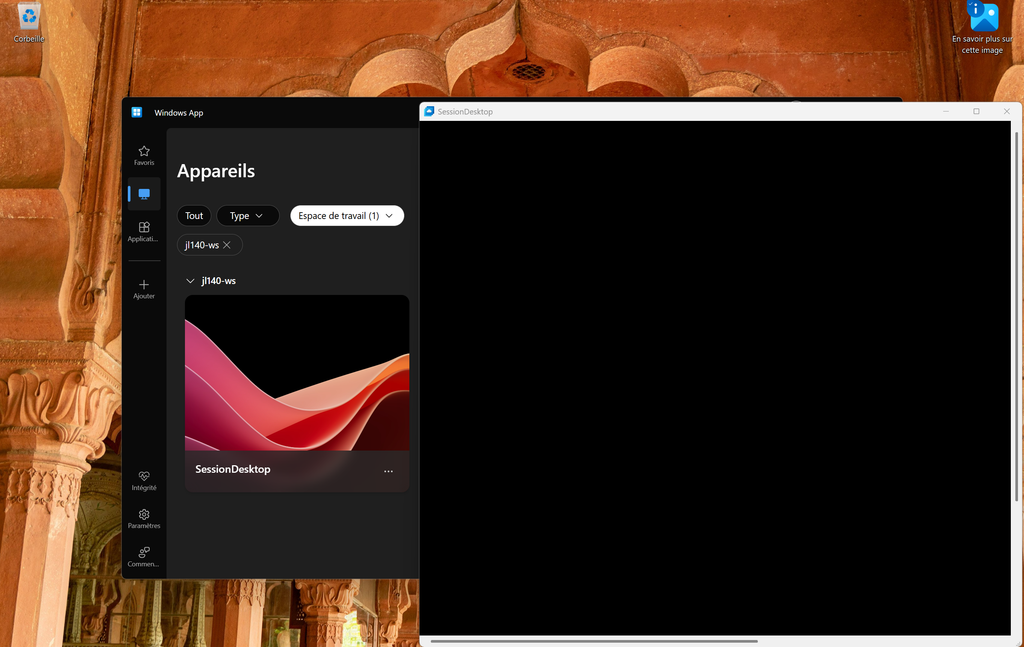
  2. Pendant que la session est active, relancez l’outil de capture sur le poste local et capturez la fenêtre de session.

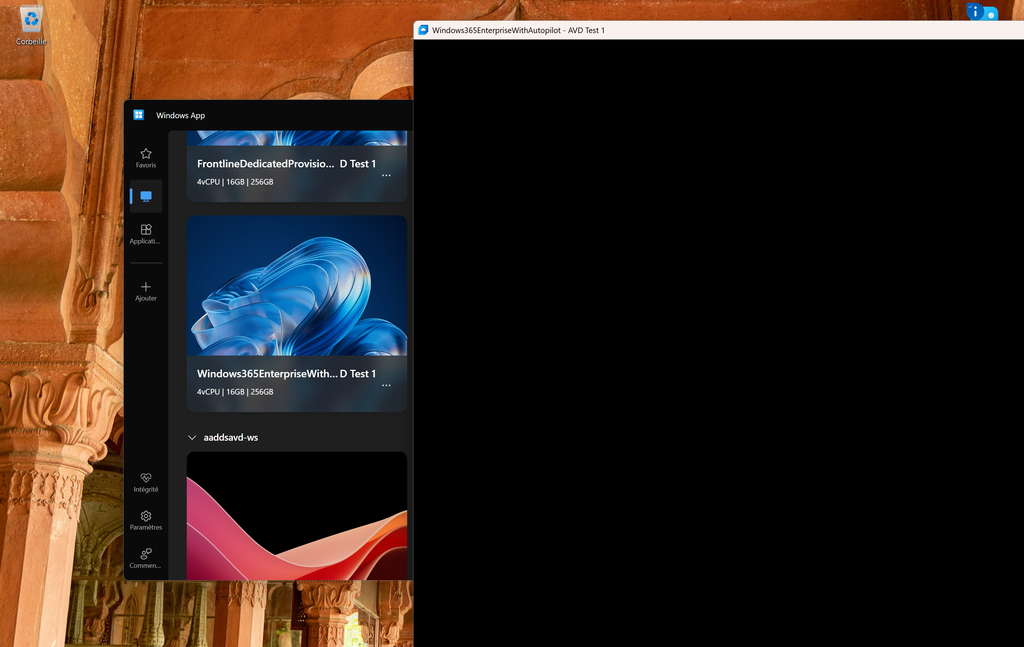
Et là, magie : le contenu capturé est bloqué ou apparaît vide. Le rectangle est là, l’image ne l’est pas :
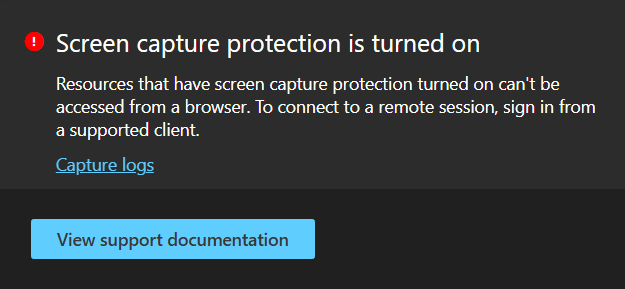
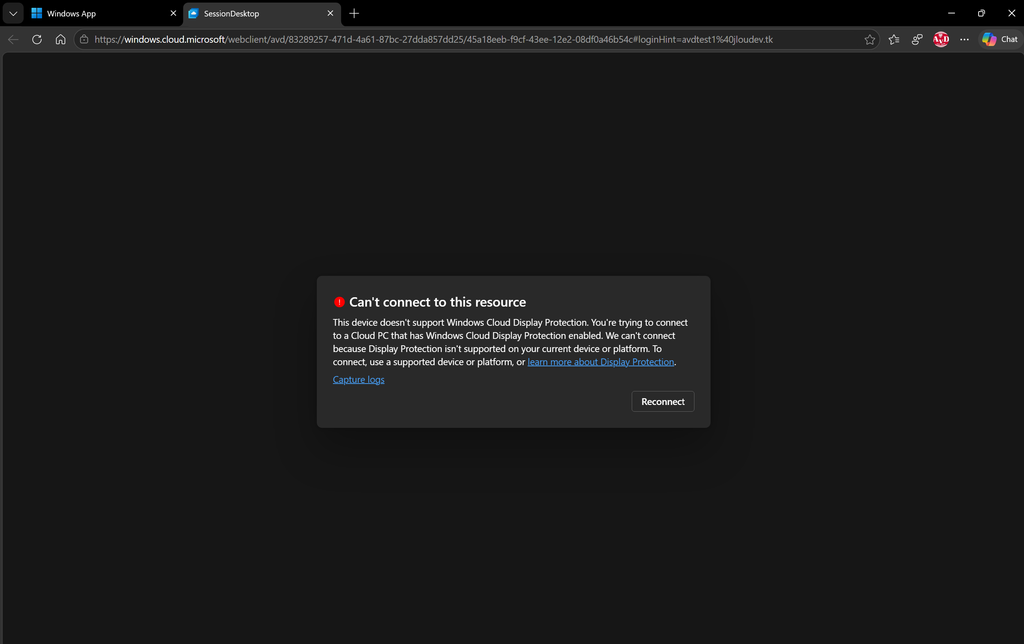
Attention, l’accès à Azure Virtual Desktop via le portail Web ne supporte pas cette fonctionalité :
Mon retour terrain : Display Protection ne referme pas toutes les portes. Une copie d’écran réalisée dans la machine virtuelle protégée, combinée à l’autorisation du presse-papier entre les deux postes, vous permettra d’extraire l’information vers la machine hôte. Microsoft le dit d’ailleurs pour Screen Capture Protection : « you should also disable clipboard, drive, and printer redirection », précisément parce que désactiver la redirection empêche les utilisateurs de copier du contenu depuis la session distante. La même logique s’applique ici.

9. L’impact réel sur l’environnement

Une fonctionnalité de sécurité qui ne coûte rien, ça n’existe pas. Voilà ce qui change et ce qui ne change pas.

Ce qui ne change pas : le comportement de la machine distante. La protection porte sur la session affichée, pas sur le Cloud PC ou la session host. Les applications, les stratégies et les outils qui tournent à l’intérieur ne voient pas la différence.

Ce qui change, en revanche, mérite une checklist avant tout déploiement large :

  • Performance : quand la protection matérielle n’est pas disponible, la session bascule en protection logicielle, ce qui peut allonger le temps d’établissement de la session. Pour la meilleure expérience, il faut des endpoints avec un GPU compatible.
  • Résolution : le plafond est 4K (3840 x 2160). Au-delà, la session protégée n’est pas supportée. Les postes à triple écran haute définition sont à qualifier sérieusement.
  • Docks et adaptateurs : les écrans branchés via DisplayLink ou un adaptateur graphique USB ne sont pas supportés, parce qu’ils ne fournissent pas le chemin d’affichage protégé et n’ont généralement pas de support HDCP. La session protégée peut être bloquée (erreur 0x110) ou le contenu protégé peut ne pas s’afficher.
  • Câblage : le VGA n’a pas de HDCP, les vieilles stations d’accueil et les moniteurs non HDCP non plus. Il faut viser une sortie HDMI, DisplayPort ou USB-C DisplayPort Alt Mode pilotée par le GPU du poste.
  • Parc client : macOS, iOS, Android, les navigateurs web et les appareils Windows 365 Link sont hors périmètre. Si une population utilise ces clients, elle ne pourra pas ouvrir de session protégée.
  • Redirections : le presse-papier reste un chemin d’exfiltration, comme démontré à l’étape 3. Si le sujet est vraiment la confidentialité, la désactivation des redirections fait partie du même chantier.

Le piège classique dans un parc d’entreprise : la flotte de portables est branchée sur des docks universels USB en open space. C’est exactement la population qui va tomber sur l’erreur HDCP, et ce n’est pas une question de licence ou de stratégie, c’est du câble.

10. Bonus Windows 365 : le même réglage dans Intune

Sur Windows 365, on ne passe pas par une propriété RDP saisie à la main mais par le centre d’administration Intune.

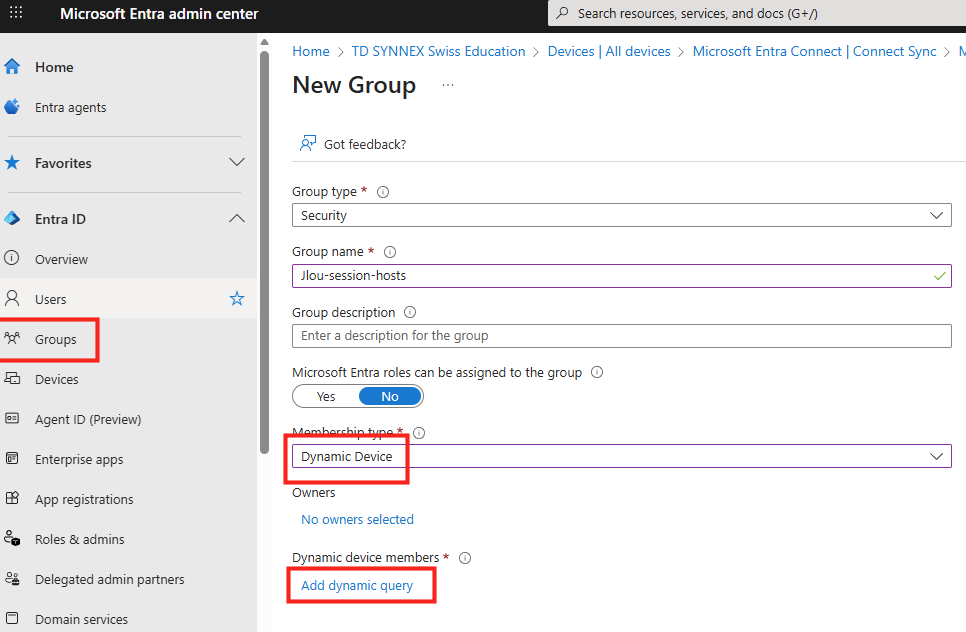
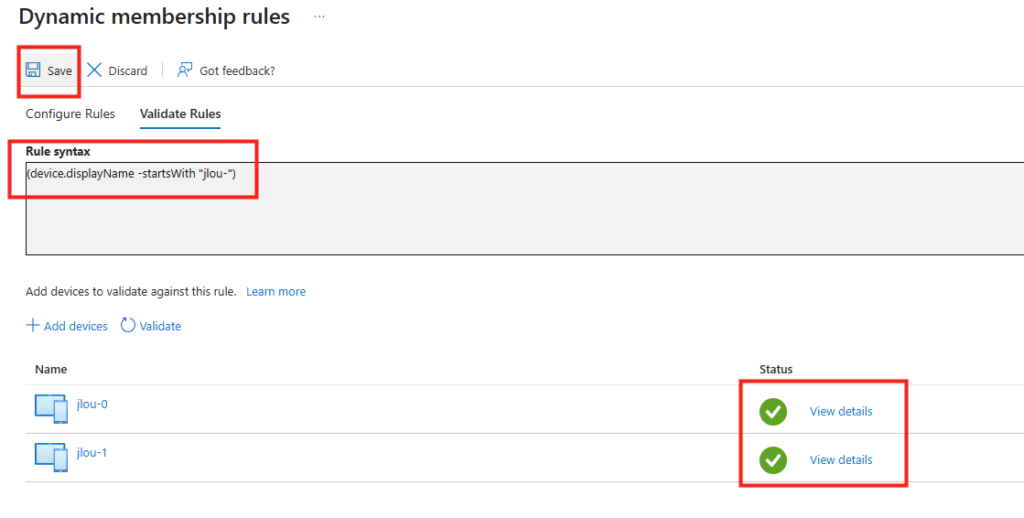
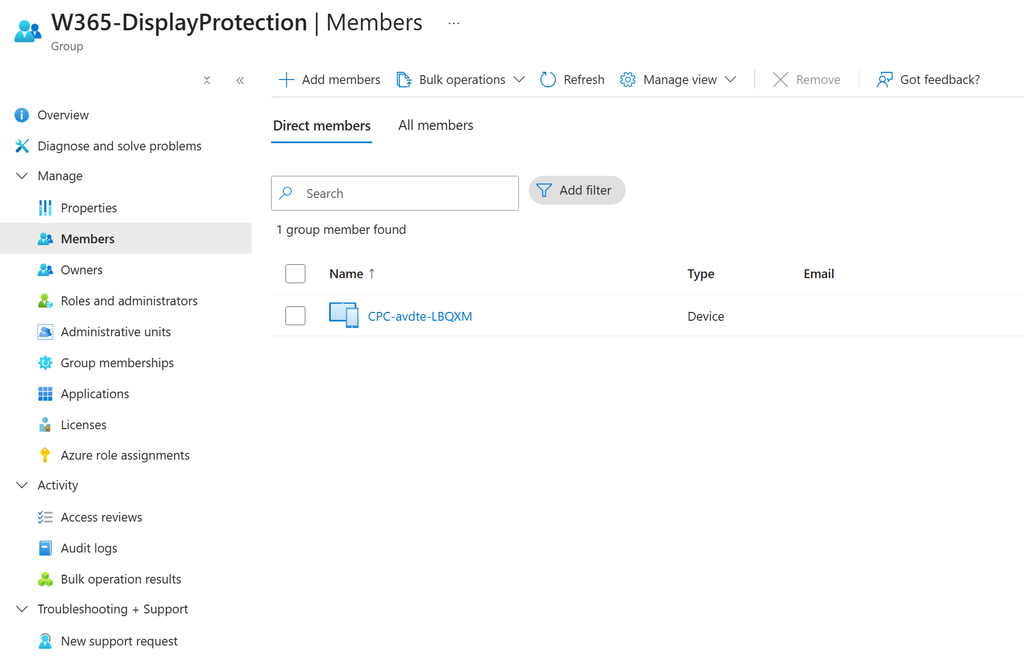
  1. Commencez par créer un groupe de machines Windows 365 :
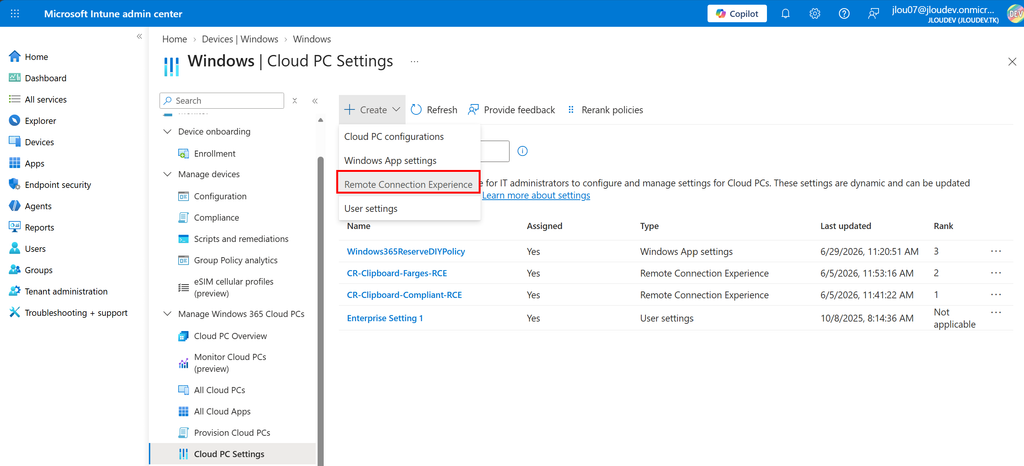
  1. Connectez-vous au centre d’administration Microsoft Intune, allez dans Devices, puis Manage Windows 365 Cloud PCs, Cloud PC Settings, puis Remote Connection Experience :
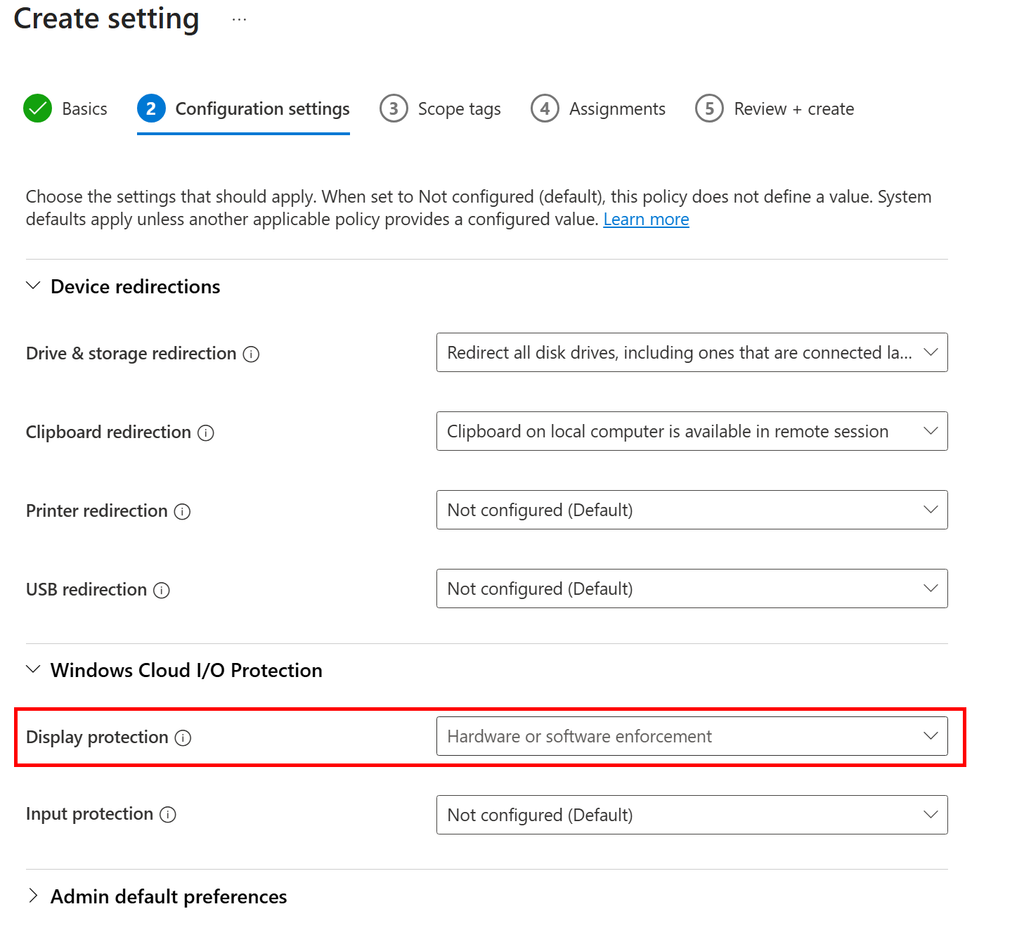
  1. Sous IO Protection, sélectionnez le niveau voulu pour Display Protection :
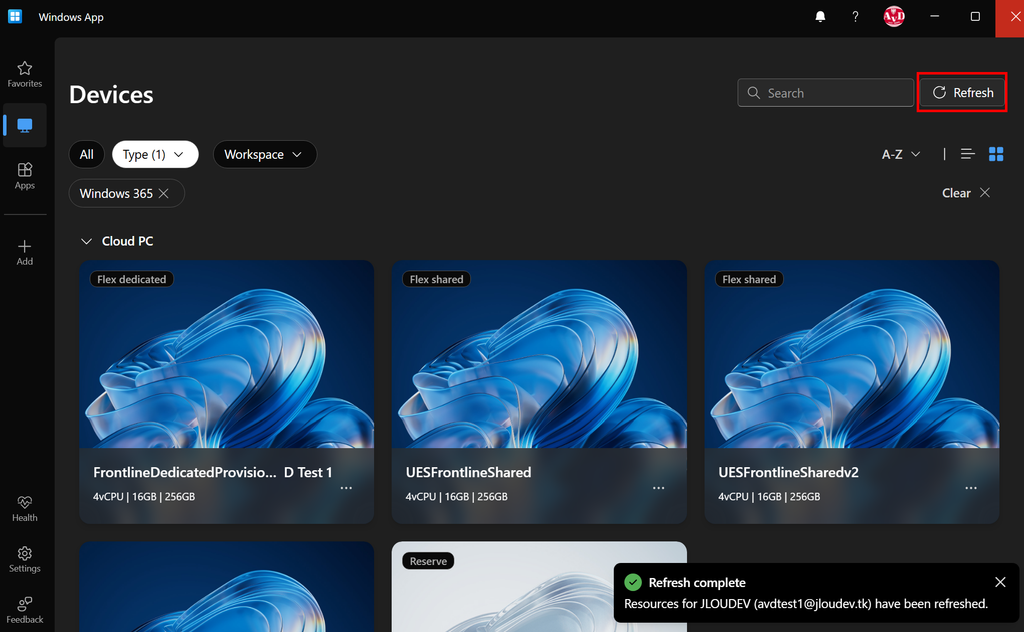
Les niveaux sont strictement les mêmes que sur AVD, et le mécanisme de propagation aussi : la configuration part vers l’endpoint dans les propriétés de connexion, elle est mise en cache, et le Refresh de Windows App reste le raccourci pour ne pas attendre :
Ouvrez une session Windows 365 sur votre utilisateur de test :
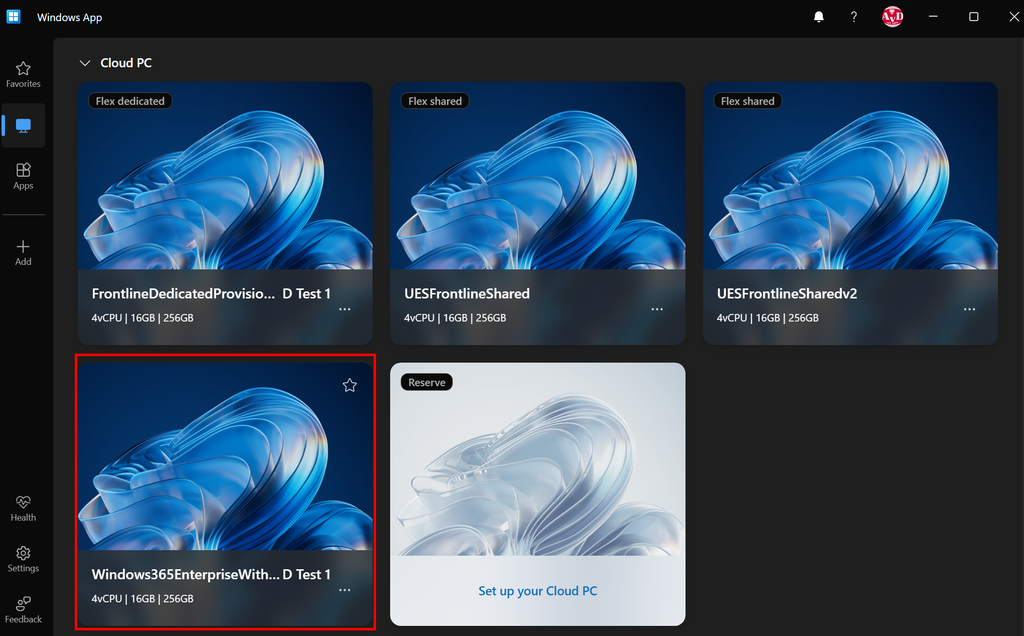
Tout comme AVD, le mécanisme fonctionne très bien depuis un client compatible :

Et comme sur AVD toujours, rien ne passe depuis le navigateur internet :
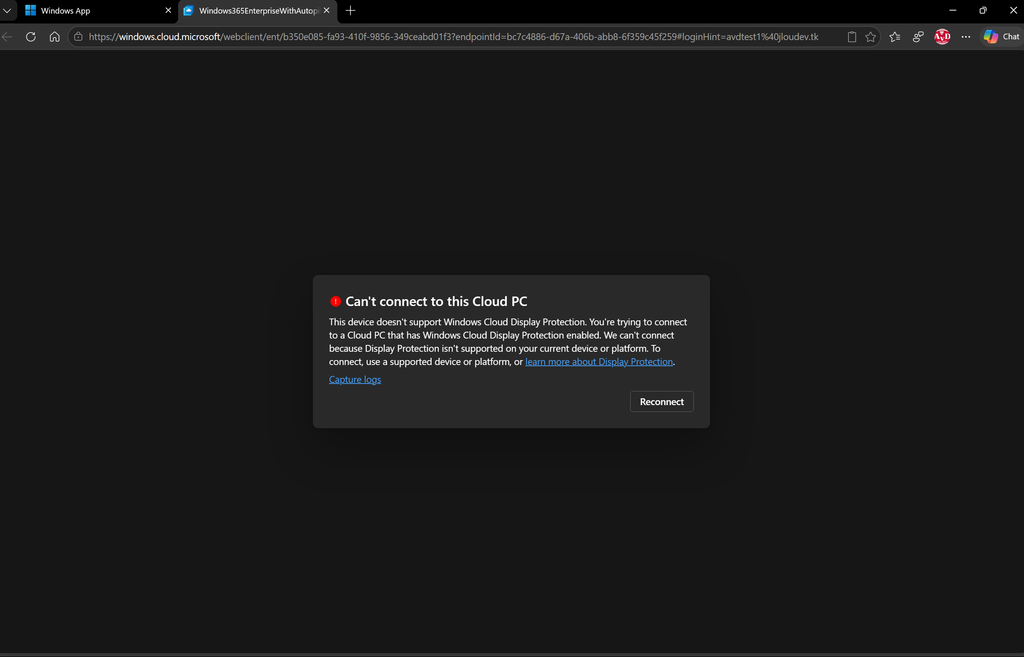
11. Les codes d’erreur et comment les lire

Quand la protection ne peut pas être établie, la connexion peut être bloquée et un message apparaît sur le poste. Voici la grille de lecture.

CodeCode étenduSignificationCauses fréquentes
0x2040x11f5Client incompatibleConnexion depuis iOS, macOS ou Android. Windows App antérieur à 2.0.1236. Configuration récemment activée ou modifiée et pas encore reçue par l’endpoint.
0x2040x11f6Stratégie non respectéeL’endpoint retombe sur la protection logicielle, absence de support GPU ou mauvaise configuration GPU, alors que la machine distante exige l’enforcement matériel.
0x110aucunExigences HDCP non satisfaitesVieilles stations d’accueil, adaptateurs USB et docks DisplayLink sans HDCP, câbles VGA, moniteurs non HDCP.

Le réflexe sur un 0x204 avec le code étendu 0x11f5 juste après avoir activé la fonctionnalité : sélectionner Refresh dans Windows App pour tirer la dernière configuration, ou attendre la propagation (jusqu’à 8 heures), puis retenter :
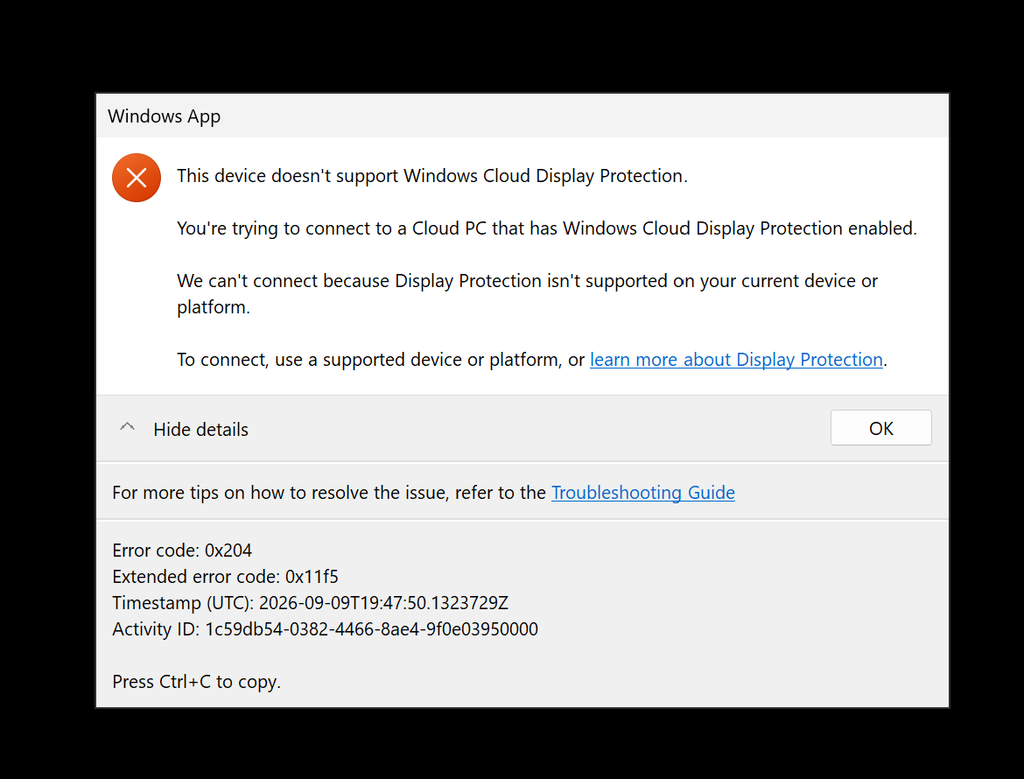
Voici l’erreur rencontrée lors d’une tentative de connexion depuis un poste compatible, mais dont l’ouverture de session est faite depuis Edge, non compatible à ce jour :
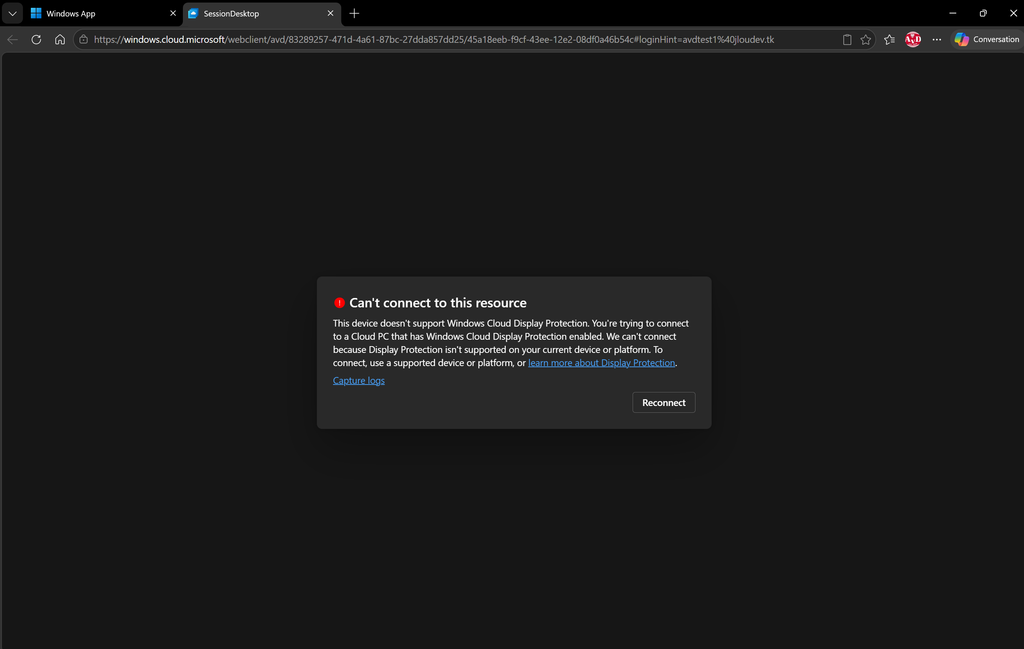
À noter que j’ai également rencontré cette erreur lors de la connexion à une session AVD depuis un poste Windows 365 qui ne le supportait pas. On aurait aimé un message d’erreur plus clair :
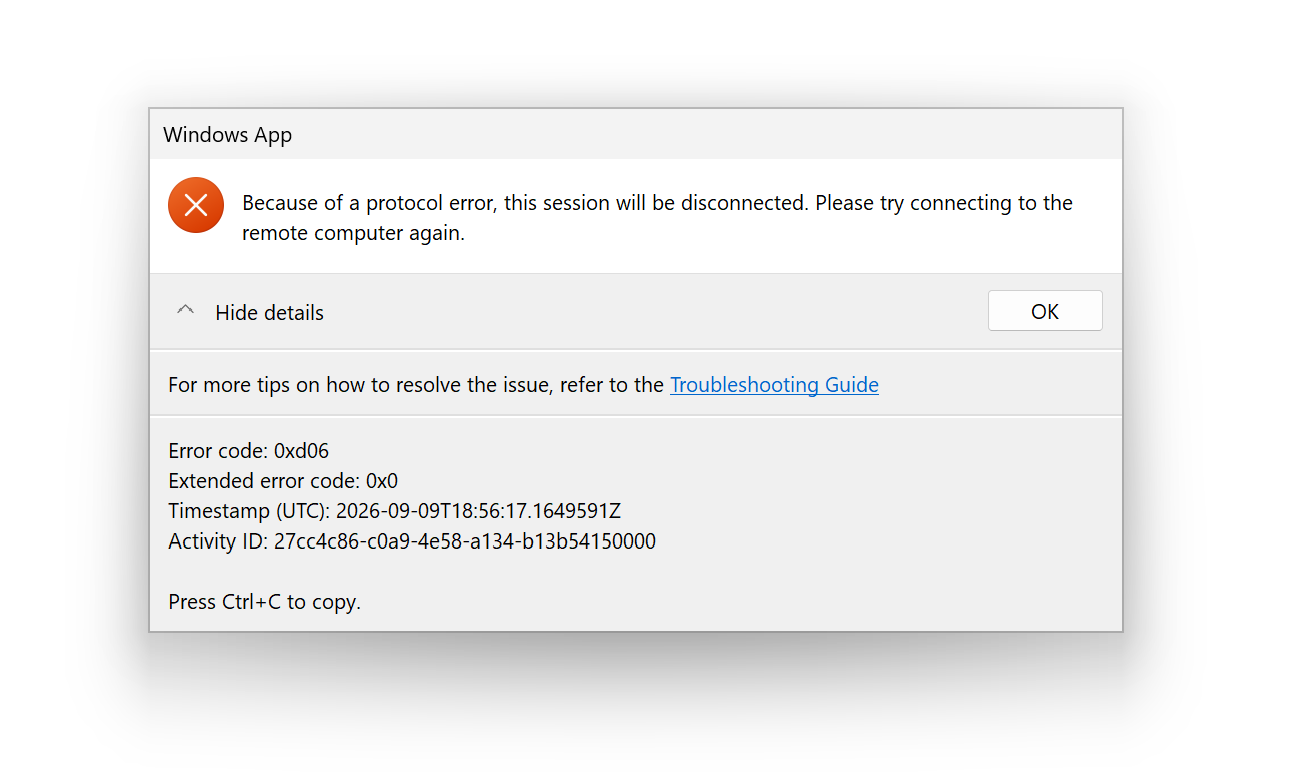
Si le code ne correspond à aucun de ceux listés par Microsoft, la marche à suivre est de contacter le support avec l’activity ID, l’horodatage de l’échec et les étapes de reproduction.

12. Monitoring : l’événement DisplayProtectionState

Tester sur un poste, c’est bien. Savoir ce qui se passe sur l’ensemble du tenant, c’est mieux, surtout si vous préparez un déploiement progressif.

Et autant vous le dire tout de suite, parce que c’est la première question qu’on se pose : il n’y a rien à vérifier dans l’OS. Ni sur le session host, ni sur le poste local. Pas de clé de registre d’état, pas de journal d’événements, pas de cmdlet. La négociation se fait à l’établissement de la connexion entre Windows App et la machine distante, et c’est le service qui en garde la trace. Le seul point de contrôle documenté est côté tenant.

  1. Dans le centre d’administration Microsoft Intune, allez dans Reports, puis Cloud PC monitoring (preview).
  2. Ouvrez l’onglet Connection health.
  3. Utilisez le sélecteur de plage de temps et les filtres pour cibler les connexions à investiguer.
  4. Sélectionnez View data pour déplier le volet, puis ouvrez la table Events.
  5. Ajoutez la colonne du nom d’événement si elle n’est pas affichée, ou cherchez l’événement par son nom.

Deux événements existent, un par composant : KeyboardInputProtectionState pour l’input protection et DisplayProtectionState pour le display protection. Ils servent à confirmer si la protection a été négociée pour une connexion donnée, et à investiguer celles où elle ne s’est pas appliquée.
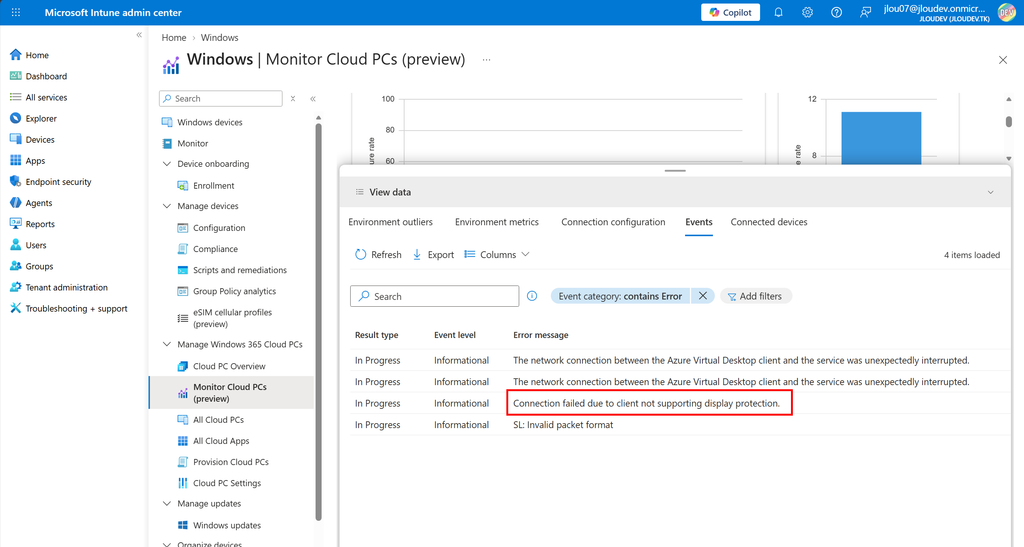
Conclusion

Voilà, en quatre étapes, de l’étape 0 à l’étape 3, vous êtes passé d’une session AVD que n’importe quel outil de capture pouvait aspirer à une session dont le flux d’affichage est chiffré jusqu’au GPU du poste.

Concrètement, ça donne quoi ? Une ligne de propriété RDP, une mise à jour de Windows App, et un argument de sécurité qui se démontre en deux captures d’écran devant un RSSI. Pas de nouvelle infrastructure, pas d’agent à déployer sur les session hosts.

Les cinq pièges à retenir :

  1. Le poste doit être un Windows 11 physique avec Windows App 2.0.1236.0 ou plus récent.
  2. La configuration est mise en cache sur l’endpoint et peut mettre jusqu’à 8 heures à se propager. Le bouton Refresh est votre ami.
  3. Les docks DisplayLink, les adaptateurs graphiques USB, le VGA et les moniteurs non HDCP sont des générateurs d’erreur 0x110.
  4. Sans GPU compatible, on bascule en protection logicielle, avec un temps d’établissement de session potentiellement plus long, et un plafond à 4K dans tous les cas.
  5. Le presse-papier reste ouvert. Sans désactivation des redirections, l’information sort de la session protégée par un simple copier-coller.

Foncez tester en lab, et prenez le temps de qualifier votre parc d’écrans et de docks avant de rêver au niveau 2. C’est cette qualification, plus que la configuration elle-même, qui décidera du succès du déploiement.

Sources

🤖
Contenu assisté par IA Cet article a été rédigé avec l’assistance d’une intelligence artificielle et relu par l’auteur. Conformément à l’AI Act (UE) en vigueur depuis le 2 août 2026.

Troubleshoot réseau AVD/Windows 365/Intune

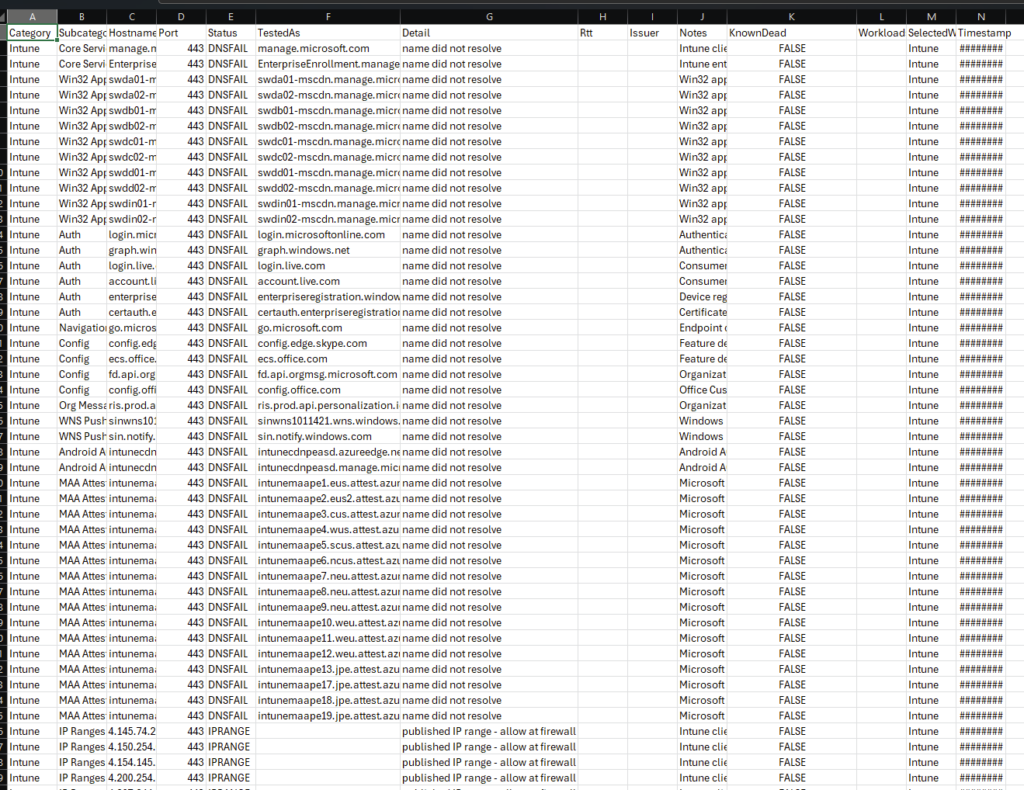
Vous avez un Cloud PC qui refuse de provisionner, un Win32 qui ne descend jamais, une session qui rame sans raison apparente, et vous passez trois jours à interroger Intune alors que le coupable est une règle de pare-feu écrite il y a deux ans ? Cet article est fait pour vous. On part d’une VM Windows toute neuve et on va dérouler, capture après capture, un diagnostic réseau complet de vos endpoints Microsoft Intune, Windows 365 et Azure Virtual Desktop, puis on va casser le réseau exprès pour vérifier que l’outil dit bien la vérité.

L’outil en question s’appelle Microsoft Cloud Endpoint Network Health Check. Il est écrit et maintenu par Daniel Bowker, Microsoft MVP sur Windows 365, et publié sous licence MIT sur GitHub:

Il ne s’agit pas d’un produit commercial ni d’un module à installer : c’est un script PowerShell unique, sans dépendance, qui teste en un seul run l’ensemble des prérequis réseau que Microsoft publie sur quatre pages de documentation différentes.

Pour vous guider plus facilement dans cet article, voici des liens rapides :

1. Le vrai problème : des prérequis réseau éparpillés

Le problème, ce n’est pas la difficulté technique, c’est le périmètre. La documentation Windows 365 le dit noir sur blanc : les prérequis se répartissent sur quatre familles distinctes, l’appareil physique, le service Microsoft Intune, la machine virtuelle session host Azure Virtual Desktop et le service Windows 365.

Although most of the configuration is for the Cloud PC network, end user connectivity occurs from a physical device. Therefore, you must also follow the connectivity guidelines on the physical device network.

Source : Network requirements for Windows 365, Microsoft Learn

Valider le réseau d’un déploiement Cloud Endpoint voulait dire donc ouvrir quatre onglets de documentation Microsoft en parallèle :

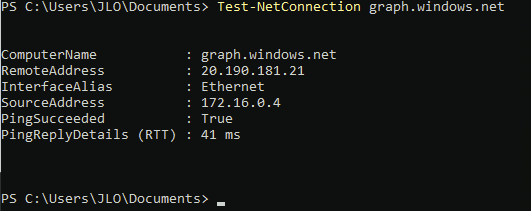
Puis extraire à la main les FQDN, les recopier dans un tableur, et lancer une boucle de Test-NetConnection maison en espérant n’avoir rien oublié…

Concrètement, ça donne quoi ? Ça donne un Cloud PC parfaitement provisionné dont l’utilisateur n’arrive pas à se connecter, parce que le poste physique dans l’agence de Lyon sort par un proxy qui ne connaît pas les endpoints du client Windows App. Vous avez validé le réseau Azure, vous n’avez pas validé le réseau du poste. Deux périmètres, deux jeux de règles, deux équipes différentes.

Mon retour terrain : le ticket qui revient le plus souvent n’est pas « rien ne marche », c’est « ça marche pour 90 % des gens ». Et un taux de 90 %, en réseau, c’est presque toujours la signature d’un site, d’un breakout Internet ou d’un profil de proxy qui diverge du reste du parc.

2. D’où vient l’outil et ce qu’il couvre

Le script a une histoire. Il démarre comme un vérificateur réseau Windows 365, publié en février 2026 sous le nom The Ultimate Windows 365 Network Validation Script. Daniel Bowker l’a ensuite élargi bien au-delà de son périmètre initial, et la version 4 marque le vrai basculement : Microsoft Intune obtient sa propre validation dédiée, à côté de Windows 365 et d’Azure Virtual Desktop.

Résultat, la version 4.1 s’appelle désormais Test-CloudEndpointNetworkHealth.ps1. L’ancien nom Test-W365NetworkHealth.ps1 reste disponible comme lanceur de compatibilité, pour ne pas casser les scripts et les runbooks écrits avant le renommage.

ÉlémentValeur
Nom du scriptTest-CloudEndpointNetworkHealth.ps1
Version couverte iciv4.1
AuteurDaniel Bowker, Microsoft MVP Windows 365
LicenceMIT
DépendancesAucune, PowerShell seul
Jeu d’endpoints445 entrées, cloud Microsoft commercial
PérimètreMicrosoft Intune, Windows 365, Azure Virtual Desktop
Fichier de donnéesEndpoints.csv, téléchargé automatiquement

Le point qui m’a le plus intéressé n’est pas le nombre d’endpoints, c’est la nature des tests. Un script de validation réseau naïf fait un Test-NetConnection sur le port 443 et affiche un joli vert. Celui-ci va nettement plus loin :

  • vrai handshake TLS avec SNI, pas un simple socket ouvert sur 443
  • détection de l’inspection SSL probable via l’analyse de la chaîne de certificats
  • échecs DNS remontés séparément des échecs de port
  • endpoints wildcard réellement testés quand c’est possible
  • test UDP réel pour RDP Shortpath
  • test SNTP/NTP, avec mesure de la dérive d’horloge
  • vérification d’Azure IMDS et de WireServer
  • test de connectivité IPv6
  • mesure de la latence de connexion
  • détection d’interception par ZTNA ou Secure Web Gateway
  • validation du port 80 là où Microsoft exige 80 et 443
  • tests parallélisés et déduplication des couples hôte/port

Cette liste compte douze améliorations, et chacune correspond à un faux positif que vous avez probablement déjà rencontré en production sans le savoir.

3. Workload et Mode : la distinction que tout le monde rate

Au lancement, le script pose deux questions. Elles se ressemblent, elles n’ont rien à voir. C’est le point de design le plus important de l’outil et c’est aussi celui qui provoque le plus de mauvaises interprétations.

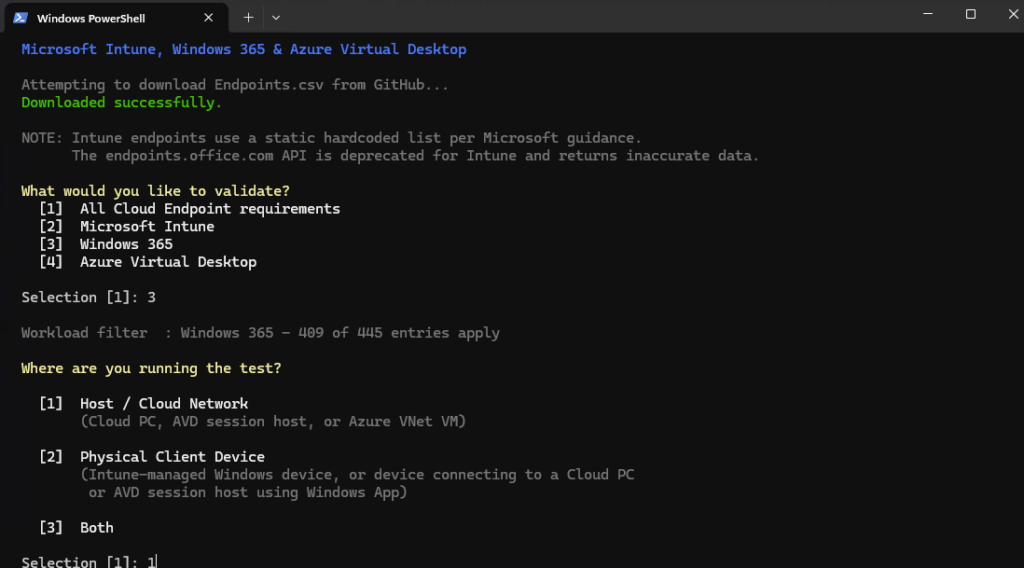
La première question, c’est le workload, autrement dit ce que vous validez :

[1] All Cloud Endpoint requirements
[2] Microsoft Intune
[3] Windows 365
[4] Azure Virtual Desktop

Workload égale QUOI, Mode égale OÙ. Retenez ces deux mots et vous ne vous tromperez plus. Un même workload Intune se teste indifféremment depuis un Cloud PC ou depuis un poste physique managé, parce que les prérequis Intune sont des prérequis d’appareil, pas des prérequis de datacenter.

WorkloadCe qui est validé
AllTout ce qui suit. C’est la valeur par défaut.
IntuneLes prérequis réseau Microsoft Intune publiés pour les appareils Windows
Windows365Les endpoints du service Windows 365, plus les dépendances AVD, Intune et plateforme Azure sur lesquelles il repose
AVDLes prérequis Azure Virtual Desktop côté session host et côté client

Le choix de conception à saluer se trouve dans la ligne Windows365. Sélectionner ce workload ne teste pas seulement les FQDN du service Windows 365. Un Cloud PC est un poste managé par Windows 365 qui s’appuie sur Intune, sur les composants de connectivité Azure Virtual Desktop et sur des services de plateforme Azure. Ne tester que les endpoints *.infra.windows365.microsoft.com vous donnerait un résultat entièrement vert alors qu’une vraie dépendance reste bloquée.

Symétriquement, le workload Windows365 exclut volontairement les fonctionnalités Intune optionnelles dont un Cloud PC n’a pas besoin pour être provisionné, managé ou joignable, comme Remote Help et le Microsoft Store. Vous ne verrez donc pas de rouge sur des services que vous n’utilisez pas.

La seconde question, c’est le mode, autrement dit d’où vous testez :

[1] Host / Cloud Network
    (Cloud PC, AVD session host, or Azure VNet VM)
[2] Physical Client Device
    (Intune-managed Windows device, or device connecting to a
     Cloud PC or AVD session host using Windows App)
[3] Both
Attention : Remote Help et Microsoft Store restent dans leurs propres catégories quand vous lancez le workload Intune. Un rouge sur ces lignes ne signifie pas que votre environnement est cassé, juste que vous n’ouvrez pas ces flux. Lisez la catégorie avant de paniquer.

4. Étape 0 : les prérequis avant de lancer quoi que ce soit

Avant la moindre commande, trois règles.

  • Règle 1, lisez le script avant de l’exécuter. L’auteur documente lui-même la procédure, et c’est tout à son honneur. Un irm | iex exécute du code distant sans que vous ne l’ayez vu, et cette pratique n’a rien à faire dans un environnement de production sans revue préalable :
Invoke-WebRequest https://bowker.cloud/endpointcheck -OutFile .\Test-CloudEndpointNetworkHealth.ps1
notepad .\Test-CloudEndpointNetworkHealth.ps1
.\Test-CloudEndpointNetworkHealth.ps1

Règle 2, exécutez en session élevée. Certaines vérifications de la fabric Azure se comportent différemment hors élévation et peuvent apparaître injoignables alors que tout va bien. Administrateur local suffit, pas besoin d’aller plus loin.

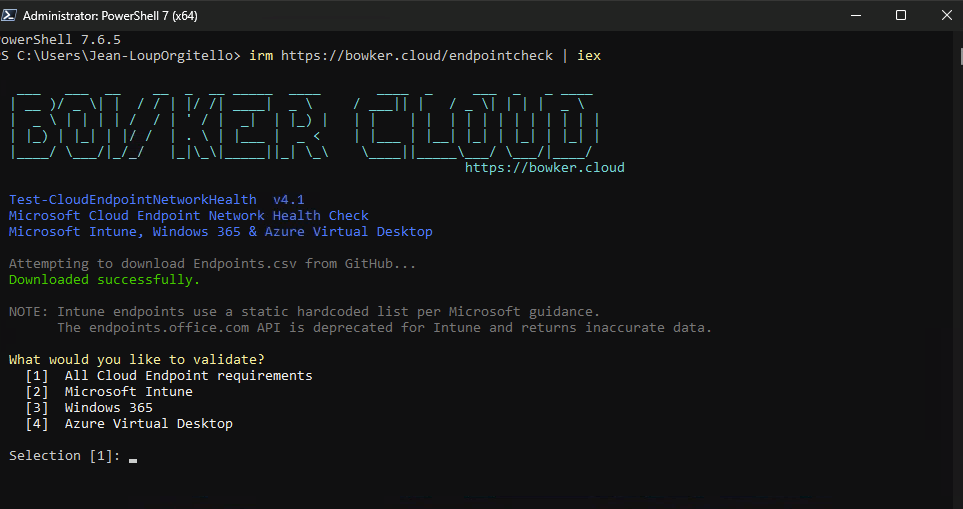
Règle 3, PowerShell 7 de préférence. Windows PowerShell 5.1 fonctionne, mais 7 est la cible recommandée par l’auteur. Pour lancer le script, rien de plus simple et aucune dépendance à installer :

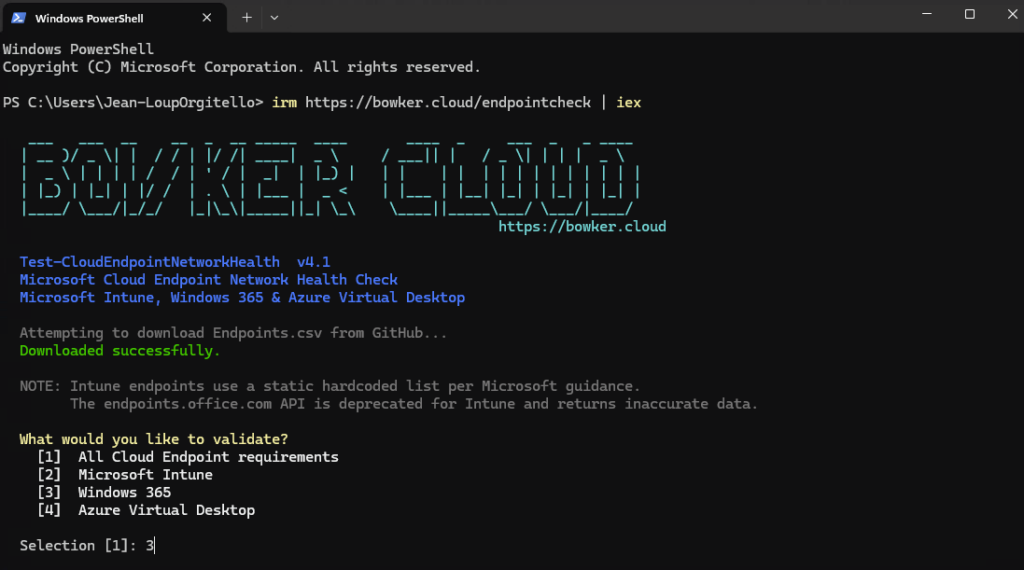
irm https://bowker.cloud/endpointcheck | iex

Ce dernier point mérite d’être souligné : le script ne demande aucun rôle Entra ID, aucun consentement d’application, aucune permission Graph. Il ne lit pas votre tenant. Il teste des sockets. C’est ce qui le rend utilisable par une équipe réseau qui n’a aucun droit dans Intune, et c’est précisément le genre de cloisonnement qu’on rencontre dans les grandes structures.

Voici les paramètres disponibles, tels que documentés dans le dépôt :

ParamètreDescriptionDéfaut
-WorkloadAll, Intune, Windows365, AVDDemandé, puis All
-Mode1 = Host / Cloud Network, 2 = Physical Client Device, 3 = BothDemandé, puis 1
-EndpointsCSVChemin vers un Endpoints.csv localTéléchargement auto
-OutputPathExport des résultats en CSVAucun
-NoTlsCheckIgnore le handshake TLS, TCP uniquementOff
-NoIntuneIPFilterDésactive le filtrage optionnel des plages IP Intune. Alias : -NoRegionFilterOff
-SkipRegionPickerAncien nom de paramètre, conservé pour compatibilitéOff
-MaxParallelNombre de sondes concurrentes12
Attention : ne montez pas -MaxParallel à l’aveugle. Douze sondes concurrentes, c’est déjà un profil de trafic qui ressemble beaucoup à du scan sortant. Sur un site protégé par un IPS ou une solution ZTNA agressive, vous risquez de déclencher une alerte SOC ou de vous faire jeter au bout de trente secondes, et vos résultats seront faussés. Prévenez l’équipe sécurité avant le run.

5. Étape 1 : le premier run et la baseline tout verte

Toute la démarche de cet article repose sur une idée simple : un diagnostic ne vaut rien sans point de comparaison. On commence donc par un run de référence sur une machine dont on sait que le réseau est sain, et on garde le résultat sous le coude.

Depuis une console PowerShell élevée :

irm https://bowker.cloud/endpointcheck | iex

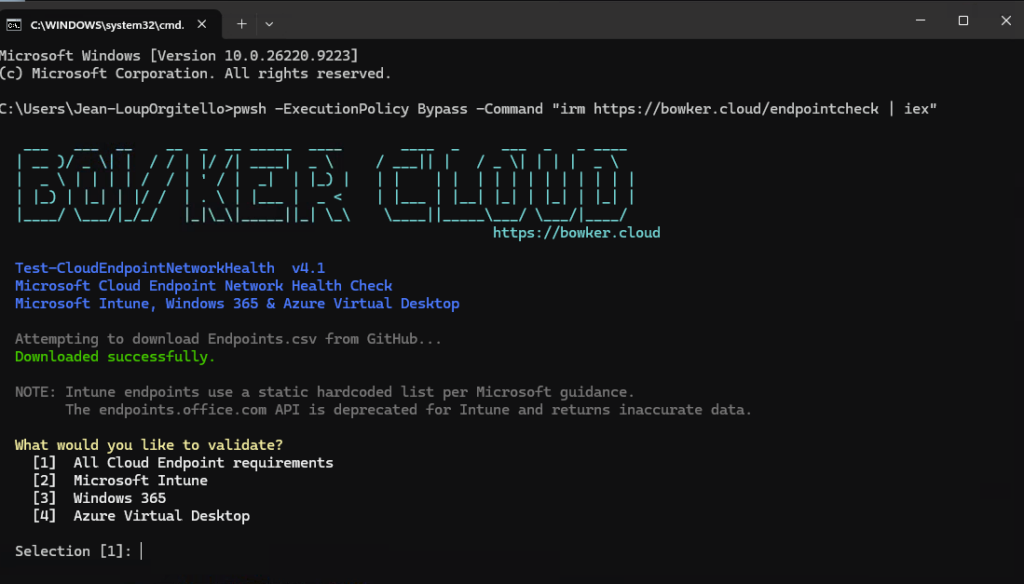
Ou, depuis CMD ou la boîte de dialogue Exécuter :

pwsh -ExecutionPolicy Bypass -Command "irm https://bowker.cloud/endpointcheck | iex"

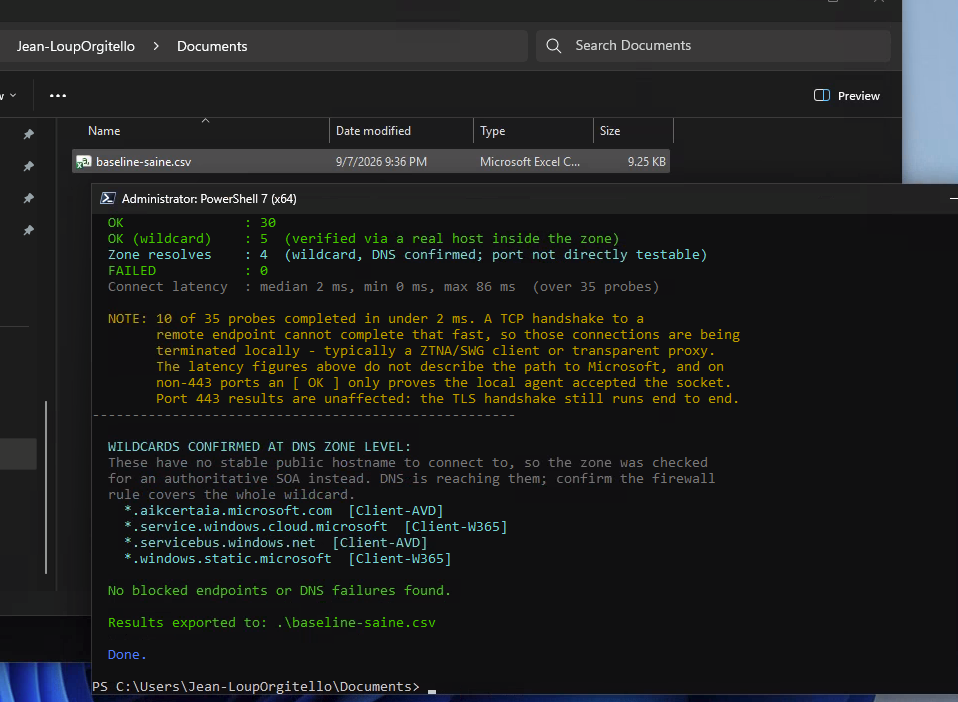
Et pour la baseline de cet article, la version explicite avec export CSV, celle que je vous recommande parce qu’elle vous laisse une trace exploitable à lancer depuis une fenêtre PowerShell :

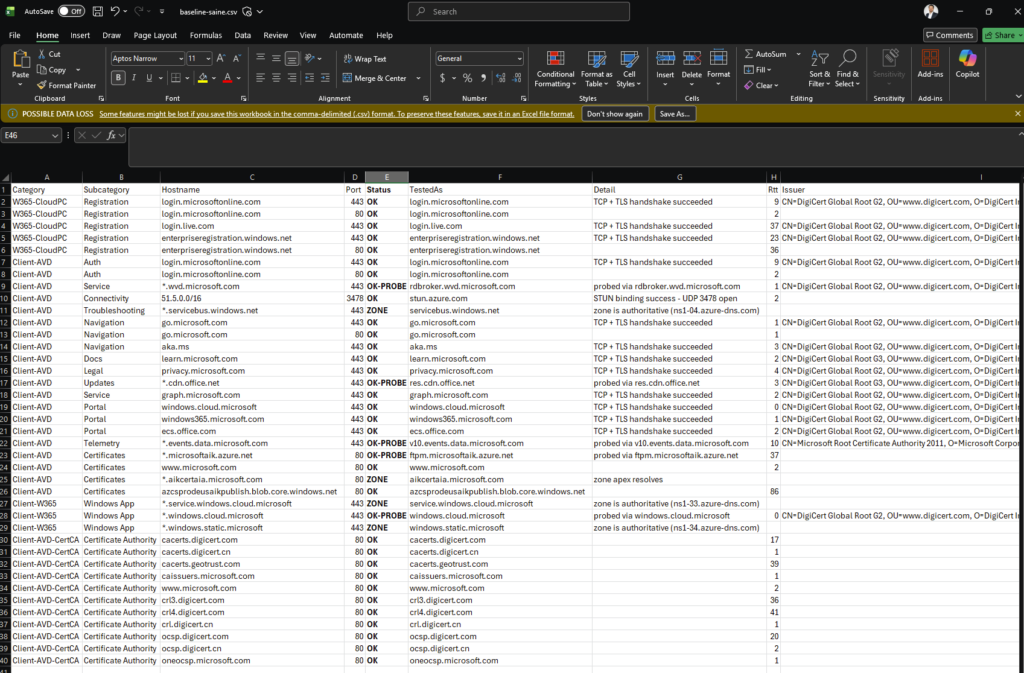
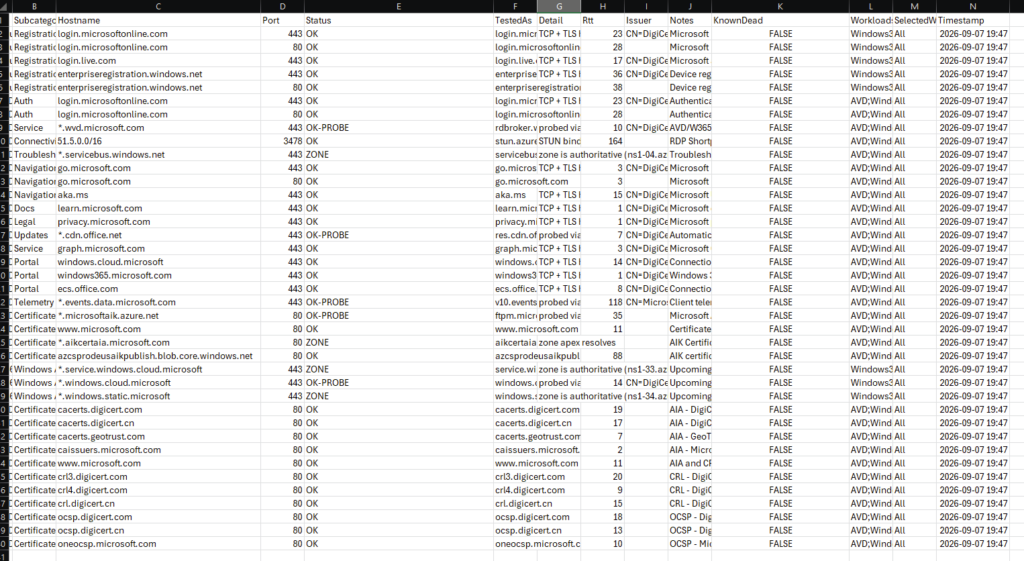
& ([scriptblock]::Create((irm https://bowker.cloud/endpointcheck))) -Workload All -Mode 2 -OutputPath .\baseline-saine.csv
Mon retour terrain : exportez systématiquement en CSV avec -OutputPath, même quand tout est vert. Le jour où un utilisateur remonte un problème, la comparaison entre le CSV du jour et celui de la mise en service vaut mille suppositions. C’est la même logique qu’un baseline de performance, appliquée au réseau.

6. Lire les résultats : OK, FAIL, DNS!, TLS!, INSP, ZONE, INFO

C’est ici que l’outil se distingue vraiment des scripts maison. La plupart des validations réseau que j’ai vues chez des clients renvoient deux états : ça passe ou ça ne passe pas. Or un problème DNS, un blocage de pare-feu et une inspection SSL cassent tous les trois le service, mais appellent trois correctifs radicalement différents, portés par trois équipes différentes.

StatutSignification
[ OK ]Connecté. Sur le port 443, cela signifie un handshake TLS complet avec SNI là où c’est supporté
[FAIL]Le DNS a résolu, mais la connexion a échoué
[DNS!]Le nom d’hôte n’a pas résolu
[TLS!]Le TCP est établi, mais le handshake TLS a échoué
[INSP]Le TLS aboutit, mais la chaîne de certificats suggère une inspection SSL probable
[ZONE]Le wildcard n’a pas de nom d’hôte public stable, la zone DNS parente a été validée à la place
[INFO]Plage IP publiée, vérification propre à Azure, entrée de référence ou autre résultat informatif

Cette granularité change la nature de la conversation. Avec un simple rouge, vous ouvrez un ticket réseau et vous attendez. Avec un [DNS!], vous savez que le pare-feu n’est pas en cause et vous allez voir l’équipe qui gère la résolution de noms. Avec un [INSP], vous savez qu’il faut demander une exclusion d’inspection, pas une ouverture de flux : le flux est déjà ouvert.

Sur ce dernier point, Microsoft est parfaitement explicite dans la documentation Windows 365 :

These traffic interception technologies can cause issues with running Azure network connection checks or Cloud PC provisioning. Make sure no network interception is enforced for Cloud PCs provisioned within the Windows 365 service.

Source : Network requirements for Windows 365, Microsoft Learn

Autrement dit, un environnement où l’inspection SSL est appliquée aux Cloud PC est un environnement hors des rails documentés, et le statut [INSP] est le seul moyen simple que je connaisse de le prouver en une capture d’écran devant l’équipe sécurité.

Deux subtilités à connaître, et elles évitent des faux diagnostics :

  • Certains endpoints CDN de Windows Update et Delivery Optimization sont volontairement exclus de la validation TLS, parce que les certificats renvoyés par le CDN ne couvrent pas de façon fiable le nom d’hôte Microsoft. Ces entrées sont testées en TCP seul, pour éviter de générer un faux [TLS!].
  • Les wildcards ne sont plus systématiquement ignorés. Quand il n’existe pas de nom d’hôte public stable derrière, c’est la zone DNS parente qui est validée, d’où le statut [ZONE]. Ce n’est ni un succès complet ni un échec, c’est une validation partielle assumée.

7. Le lab de pannes : on casse le réseau exprès

Le moment de vérité. Un outil de diagnostic qui affiche du vert quand tout va bien, ce n’est pas un exploit. Ce qu’on veut savoir, c’est s’il dit la vérité quand ça va mal, et surtout s’il désigne la bonne cause. J’ai donc monté une VM Windows jetable et j’ai cassé le réseau, panne par panne, avec un run du script après chaque manipulation.

Attention : toutes les manipulations qui suivent se font sur une machine virtuelle jetable, hors production, et de préférence non managée par Intune. Bloquer un port sortant ou casser la résolution DNS sur un poste de production vous fera perdre bien plus de temps que le diagnostic que vous cherchiez à poser.

Voici le rendu du script avant toute modification de la configuration :

Cas n°1 : la résolution DNS est cassée

Le scénario réel derrière ce cas : un serveur DNS interne injoignable, un forwarder mal configuré, ou un split-brain DNS où la zone publique Microsoft n’est plus résolue depuis le réseau interne. C’est fréquent, et c’est très mal diagnostiqué, parce que l’utilisateur décrit un symptôme applicatif alors que le problème est au niveau de la résolution.

La manipulation, dans une console élevée sur la VM de test. On note d’abord la configuration DNS actuelle pour pouvoir la remettre :

Get-DnsClientServerAddress -AddressFamily IPv4

# On pointe la carte vers un resolveur qui n'existe pas
Set-DnsClientServerAddress -InterfaceAlias "Ethernet" -ServerAddresses 127.0.0.1
Clear-DnsClientCache

Puis on relance le script. Le résultat attendu est une avalanche de [DNS!], et surtout aucun [FAIL] : le script doit dire que rien n’a résolu, pas que les ports sont bloqués.

Et là, magie : là où un script maison basé sur Test-NetConnection vous aurait affiché un mur de rouge indifférencié, envoyant l’équipe réseau chercher une règle de pare-feu inexistante pendant deux jours, vous avez immédiatement la bonne piste.

Pour restaurer, remettez l’adresse notée à l’étape précédente, ou repassez en DHCP :

Set-DnsClientServerAddress -InterfaceAlias "Ethernet" -ResetServerAddresses
Clear-DnsClientCache

Cas n°2 : DNS partiellement cassé, une seule zone tombe

Le cas précédent est brutal et facile à diagnostiquer même sans outil. Le cas vicieux, celui qui coûte vraiment des journées, c’est la panne partielle : tout résout, sauf une famille de noms. Un enregistrement de blocage laissé dans le DNS interne, une entrée hosts oubliée par un collègue en test, une politique de filtrage DNS qui sinkhole une zone.

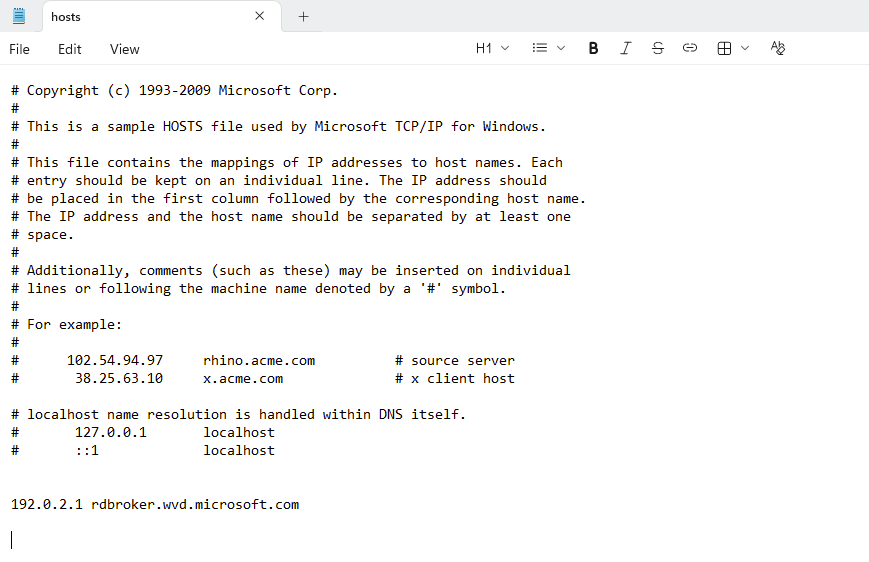
On simule ça proprement avec le fichier hosts, en pointant un endpoint Windows 365 vers une adresse inexploitable :

notepad C:\Windows\System32\drivers\etc\hosts

Ajouter la ligne suivante, puis enregistrer

  • 192.0.2.1 rdbroker.wvd.microsoft.com

Lancer la commande suivante pour purger le cache :

Clear-DnsClientCache

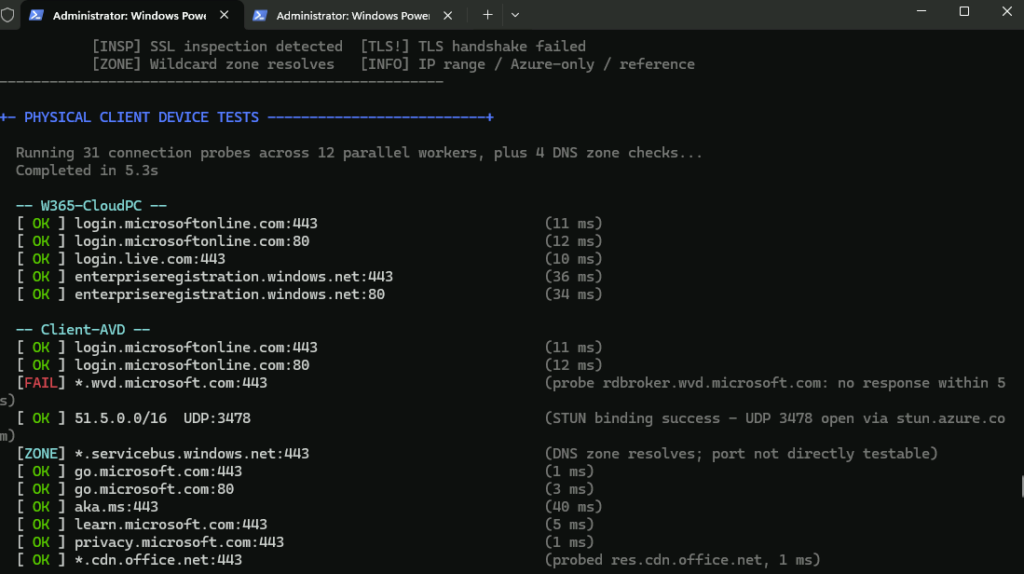
Ici le nom résout, mais vers une adresse qui ne mène nulle part. Le comportement attendu n’est donc pas le même que dans le cas n°1, et c’est tout l’intérêt de la démonstration. La ligne concernée doit basculer en [FAIL], pas en [DNS!], pendant que le reste du run reste vert :

Le piège classique : sur ce genre de panne, l’utilisateur vous dira que « AVD ne marche pas », alors que le provisioning, l’authentification et Intune fonctionnent parfaitement. Seul le broker de connexion est injoignable. Sans un test endpoint par endpoint, vous cherchez au mauvais endroit.

Pensez à retirer la ligne du fichier hosts et à vider le cache DNS avant de continuer, sinon elle va polluer tous vos runs suivants.

Cas n°3 : le port 5671 bloqué, le grand classique du provisioning

Si vous ne deviez retenir qu’un seul cas de cet article, c’est celui-là. La documentation Windows 365 exige que les endpoints d’enregistrement IoT Hub soient joignables sur deux ports, 443 et 5671, en sortie :

global.azure-devices-provisioning.net      (443 & 5671 outbound)
hm-iot-in-prod-prap01.azure-devices.net    (443 & 5671 outbound)
hm-iot-in-prod-prau01.azure-devices.net    (443 & 5671 outbound)
hm-iot-in-prod-preu01.azure-devices.net    (443 & 5671 outbound)
hm-iot-in-prod-prna01.azure-devices.net    (443 & 5671 outbound)

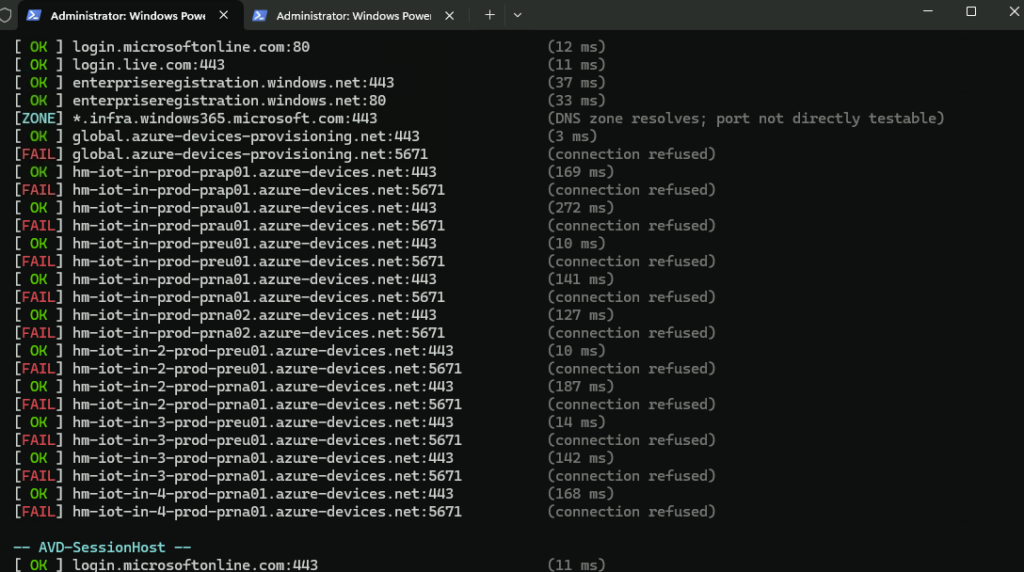
Or, dans la vraie vie, une équipe réseau qui reçoit une demande d’ouverture pour Windows 365 ouvre le 443 et considère le travail terminé. Le 5671, c’est de l’AMQP, ça ne ressemble pas à du web, et ça passe très souvent à la trappe. Résultat : le Cloud PC ne s’enregistre jamais auprès du service de santé, le provisioning échoue ou reste bloqué, et tous les tests web que vous ferez à la main répondront correctement.

On reproduit la panne avec une règle de pare-feu sortante :

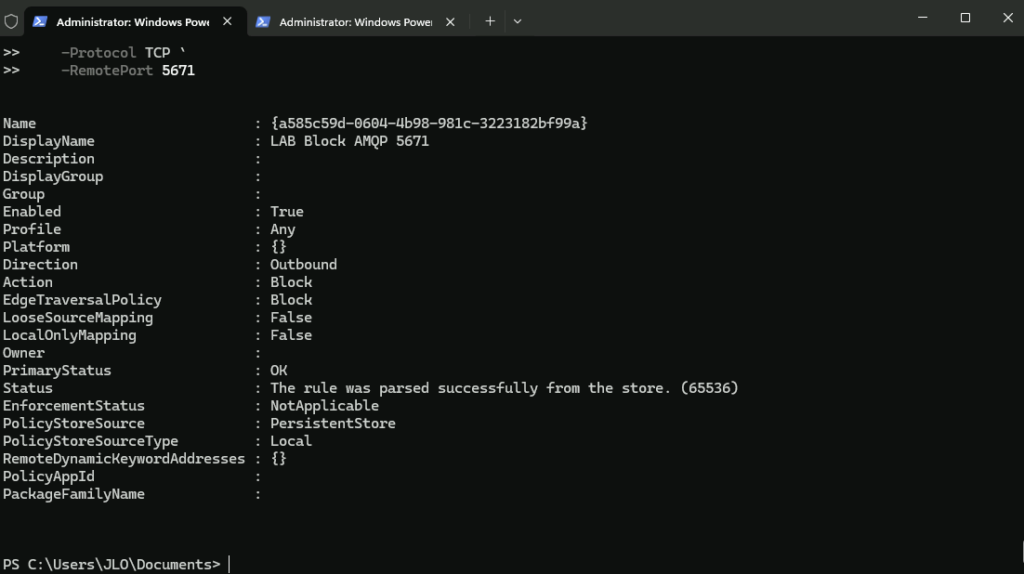
New-NetFirewallRule -DisplayName "LAB Block AMQP 5671" `
    -Direction Outbound `
    -Action Block `
    -Protocol TCP `
    -RemotePort 5671

Puis on relance, en ciblant le workload Windows 365 pour aller droit au but :

.\Test-CloudEndpointNetworkHealth.ps1 -Workload Windows365 -Mode 1

Voilà la démonstration que je cherchais. Le script teste le couple hôte et port, pas seulement l’hôte. Vous voyez le même FQDN en vert sur une ligne et en rouge sur l’autre, et la conversation avec l’équipe réseau devient triviale : le flux existe, il manque un port.

Mon retour terrain : le 5671 est le port oublié numéro un des déploiements Windows 365 avec Azure Network Connection. Juste derrière, le port 80 sur les endpoints où Microsoft exige à la fois 80 et 443, typiquement pour les listes de révocation de certificats. Le script valide ce cas explicitement, et c’est une bonne raison de ne pas se contenter d’un test sur 443.

Nettoyage de la règle une fois la capture prise :

Remove-NetFirewallRule -DisplayName "LAB Block AMQP 5671"

Cas n°4 : l’UDP coupé, la session qui rame sans jamais tomber

Celui-ci est le plus sournois de tous, parce qu’il ne produit aucune erreur. Rien ne tombe. L’utilisateur se connecte, travaille, et vous dit simplement que « c’est mou ». Vous regardez les logs, tout est vert, et vous concluez à un problème de perception.

Ce qui se passe réellement, la documentation Azure Virtual Desktop l’explique très bien. RDP démarre sur un transport TCP en reverse connect, puis tente d’établir la session en UDP. Si l’UDP réussit, le TCP est abandonné. Sinon, le TCP sert de solution de repli :

By default, the Remote Desktop Protocol (RDP) begins a TCP-based reverse connect transport, then tries to establish a remote session using UDP. If the UDP connection succeeds the TCP connection drops, otherwise the TCP connection is used as a fallback connection mechanism.

Source : RDP Shortpath for Azure Virtual Desktop, Microsoft Learn

Ce mécanisme de repli est une excellente idée pour la disponibilité, et une catastrophe pour le diagnostic : il transforme une panne franche en dégradation silencieuse. C’est exactement la raison pour laquelle le test UDP réel de RDP Shortpath est, à mon sens, la fonctionnalité la plus sous-estimée de ce script.

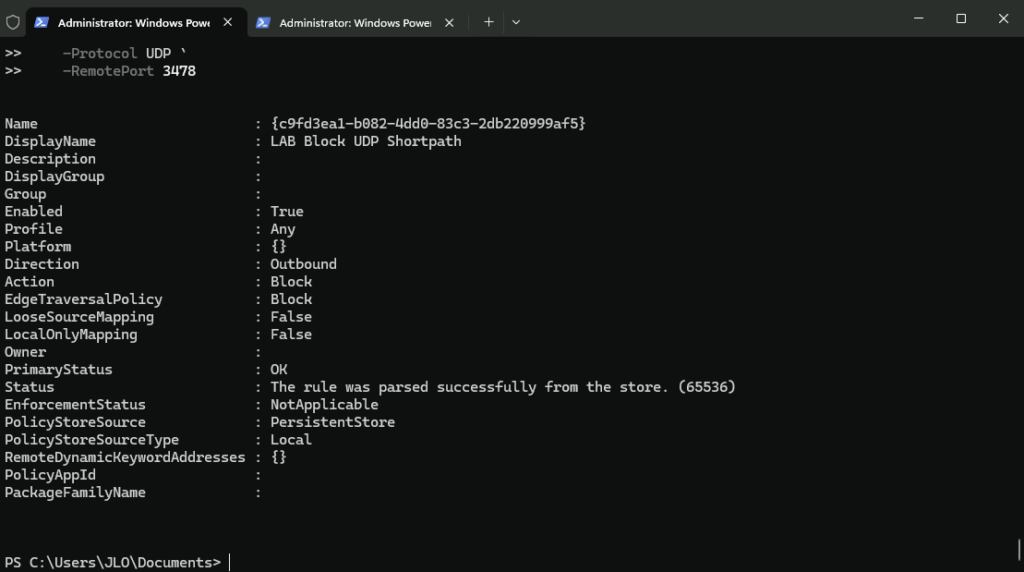
Pour reproduire, on bloque l’UDP sortant sur la VM de test. Lancez d’abord un run normal et relevez dans la sortie le port UDP effectivement testé par le script pour Shortpath, puis créez la règle correspondante :

New-NetFirewallRule -DisplayName "LAB Block UDP Shortpath" `
    -Direction Outbound `
    -Action Block `
    -Protocol UDP `
    -RemotePort 3478

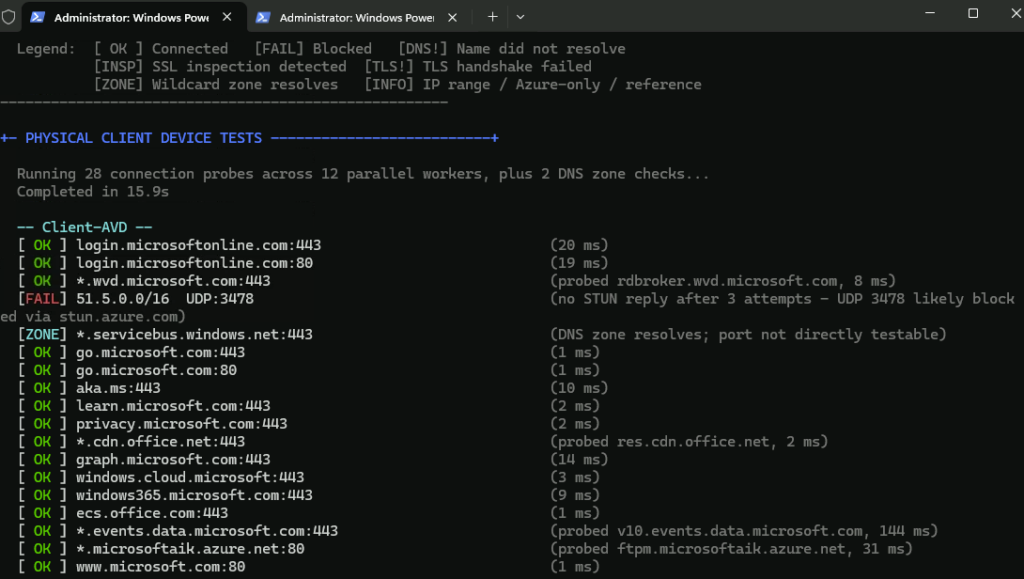
Relancez ensuite en mode client, puisque c’est le poste physique qui initie la négociation Shortpath :

.\Test-CloudEndpointNetworkHealth.ps1 -Workload AVD -Mode 2

Regardez bien cette capture. C’est le seul rouge de tout le run. Sans ce test, votre validation réseau aurait été déclarée conforme à 100 %, et vous auriez cherché la cause du côté du dimensionnement du Cloud PC ou de la carte graphique. Une ligne rouge, quelques secondes de lecture, et vous savez qu’il faut aller ouvrir l’UDP sortant.

Remove-NetFirewallRule -DisplayName "LAB Block UDP Shortpath"

Les cas que je n’ai pas provoqués, mais que le script sait détecter

Par souci d’honnêteté, je ne décris ici que ce que j’ai réellement cassé et observé. Trois autres capacités de l’outil méritent d’être connues, même si je ne les ai pas mises en scène dans ce lab :

  • l’inspection SSL, qui remonte en [INSP] lorsque la chaîne de certificats renvoyée ne correspond pas à ce que Microsoft présente normalement
  • le handshake TLS qui échoue alors que le TCP passe, qui remonte en [TLS!], typiquement quand un Secure Web Gateway accepte le socket puis refuse le nom d’hôte au moment du SNI
  • la dérive d’horloge, mesurée via le test SNTP/NTP, cause classique et rarement soupçonnée d’échecs d’authentification

Si vous disposez d’un proxy d’inspection dans votre environnement de test, ces trois cas se provoquent facilement et feraient un excellent complément à ce lab.

8. Du symptôme utilisateur au correctif réseau

Voici la table de correspondance que j’ai construite à partir de ce lab. C’est elle que je garderais sous le coude en support N2, parce qu’elle part de ce que l’utilisateur dit, pas de ce que la console affiche.

Ce que dit l’utilisateurStatut renvoyé par le scriptOù aller chercher
Plus rien ne fonctionne depuis ce matin[DNS!] massifRésolution de noms, forwarders, serveurs DNS de la carte réseau
Windows 365 ne marche pas, mais je reçois mes mails[FAIL] isolé sur un endpointFiltrage DNS, entrée hosts, sinkhole sur une zone précise
Mon Cloud PC est resté en cours de provisioning[FAIL] sur azure-devices.net en 5671Pare-feu sortant, port AMQP non ouvert
C’est lent, mais ça marcheÉchec du test UDP ShortpathUDP sortant bloqué, repli TCP en cours
Ça marche à Paris, pas à LyonRésultats divergents entre deux runsBreakout Internet local, profil de proxy par site
Je n’arrive pas à me connecter mais le Cloud PC est vert dans IntuneÉchecs en Mode 2 uniquementRéseau du poste physique, pas le réseau Azure

La dernière ligne mérite un mot. C’est le scénario le plus courant et le plus mal traité, parce que les deux équipes concernées regardent chacune leur périmètre et le déclarent sain. Lancer le script en Mode 2 depuis le poste de l’utilisateur qui se plaint tranche le débat en trois minutes.

9. Ce que l’outil ne fait pas

Un article qui ne présente que les qualités d’un outil ne vous sert à rien. Voici les limites, et elles sont d’ailleurs documentées honnêtement par l’auteur, ce qui est suffisamment rare pour être signalé.

  • Le jeu d’endpoints couvre le cloud Microsoft commercial. Si vous êtes en GCC, GCC High ou dans un cloud souverain, les FQDN diffèrent et ce jeu de données ne vous concerne pas.
  • Le workload Intune valide les prérequis réseau publiés par Microsoft pour les appareils Windows. Il ne prétend pas tester tous les endpoints de tous les produits qui s’intègrent à Intune.
  • Les produits qui disposent de leur propre documentation réseau, comme Microsoft Defender for Endpoint ou Security Copilot, ont des prérequis supplémentaires non couverts ici.
  • Le script teste la connectivité, pas la configuration du tenant. Un flux ouvert ne garantit pas qu’une stratégie Intune soit correctement ciblée.
  • Il ne mesure pas la bande passante ni la qualité de la liaison sous charge. La latence est reportée, mais ce n’est pas un outil de capacity planning.

Cinq limites, aucune n’est rédhibitoire, et toutes sont assumées par le périmètre annoncé. C’est un outil de diagnostic de connectivité, il fait ce qu’il dit.

Attention : le fichier Endpoints.csv est téléchargé automatiquement depuis GitHub à chaque exécution. Sur un réseau très fermé, c’est justement ce téléchargement qui va échouer en premier. Récupérez le CSV depuis un poste ayant accès à Internet et passez-le en local avec -EndpointsCSV, sinon vous allez diagnostiquer l’absence d’accès à GitHub plutôt que votre problème réel.

10. Conclusion et pièges à retenir

Voilà, en une commande et quatre pannes provoquées, nous avons vérifié qu’un script PowerShell gratuit, sans dépendance et sans le moindre droit sur le tenant, sait faire la différence entre un DNS cassé, un port fermé et un transport UDP absent. C’est exactement ce qu’on demande à un outil de diagnostic.

Concrètement, ça donne quoi ? Vous gagnez la capacité de qualifier un incident réseau avant de l’escalader. Vous arrivez devant l’équipe réseau avec une ligne précise, un hôte, un port, un protocole et un statut, au lieu d’un « Windows 365 ne marche pas » qui va tourner en boucle pendant une semaine.

Les cinq pièges à retenir :

  1. Ne confondez pas Workload et Mode. Le premier dit ce que vous validez, le second dit d’où vous testez. Un run en Mode 1 ne vous apprend rien sur le poste de l’utilisateur.
  2. Exécutez en session élevée, sans quoi les vérifications de la fabric Azure peuvent apparaître en échec alors qu’elles vont bien.
  3. Le port 5671 n’est pas optionnel pour Windows 365. Un pare-feu qui n’ouvre que le 443 casse le provisioning sans jamais produire d’erreur web.
  4. Un run entièrement vert en TCP ne prouve rien sur la qualité de session. Si l’UDP est bloqué, RDP bascule silencieusement sur son repli TCP et l’utilisateur subit sans que rien ne remonte.
  5. Gardez une baseline. Exportez en CSV le jour de la mise en service, c’est ce qui vous permettra de comparer le jour où ça se dégrade.

Foncez tester. Le script est sous licence MIT, il ne demande aucun droit, il tourne sur une VM jetable en trois minutes, et le pire qui puisse vous arriver est de découvrir que votre réseau n’est pas aussi conforme que vous le pensiez. Ce qui, précisément, est le but recherché.

Tout le mérite revient à Daniel Bowker, qui écrit, maintient et documente cet outil. Le code se trouve sur le dépôt GitHub du projet.

🤖
Contenu assisté par IA Cet article a été rédigé avec l’assistance d’une intelligence artificielle et relu par l’auteur. Conformément à l’AI Act (UE) en vigueur depuis le 2 août 2026.

Features AVD en GA en juin 2026

Vous les avez peut-être testées en préversion, comme moi : l’orchestration des hôtes de session, la mise à l’échelle dynamique et les disques OS éphémères sur Azure Virtual Desktop. Bonne nouvelle, depuis juin 2026 ces trois briques de gestion avancée des host pools sont annoncées en disponibilité générale. L’occasion de faire le point, de regrouper mes trois anciens tutos de préversion, et surtout de pointer ce qui a changé depuis, car un seul détail peut casser vos anciens déploiements.

Ces fonctionnalités, je les avais chacune détaillées dans un tutoriel pas-à-pas quand elles étaient en préversion. Plutôt que de vous renvoyer vers trois articles vieillissants, je les réunis ici en une synthèse à jour de la GA, avec des liens vers chaque tuto d’origine si vous voulez remettre les mains dans le portail.

1. De la préversion à la GA : ce qui change vraiment

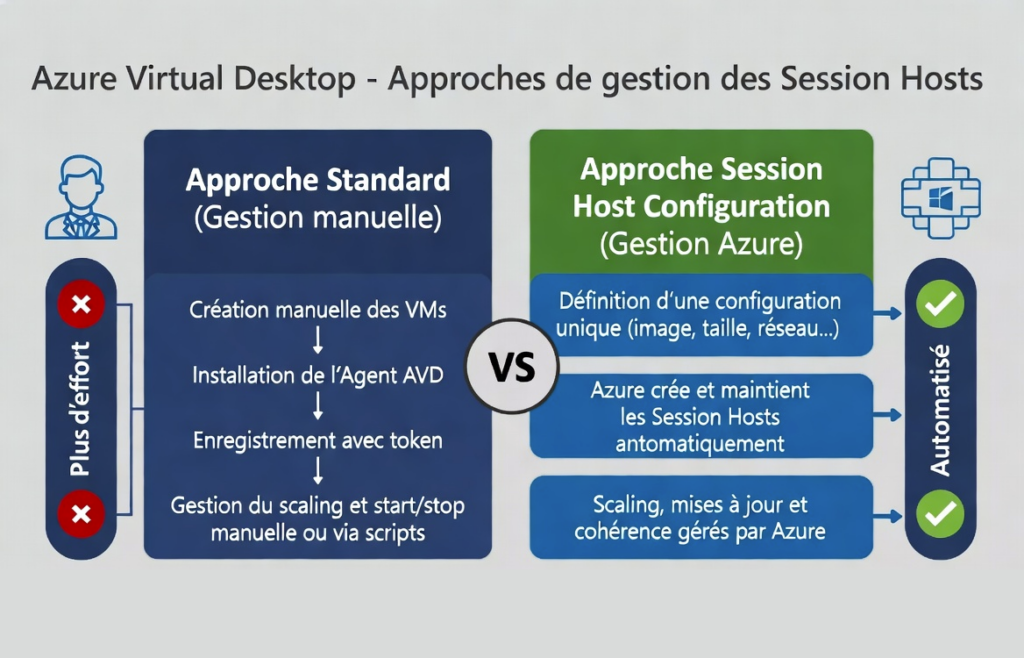
Avant d’entrer dans le détail, un rappel utile sur la notion de fond. Sur Azure Virtual Desktop, un pool d’hôtes partagé se gère de deux façons :

La gestion standard, où vous créez, mettez à jour et scalez vos hôtes avec vos propres outils, et la gestion par configuration d’hôte de session, celle que Microsoft qualifie d’automatisée. C’est cette seconde approche, et les capacités qui gravitent autour, qui passe en GA :

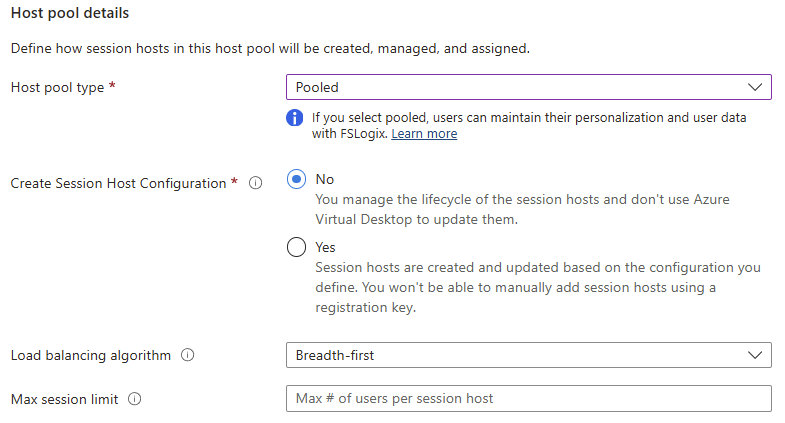
Point de vigilance à connaître dès maintenant : le choix de l’approche se fait à la création du pool d’hôtes et ne peut plus être modifié ensuite :

Un pool créé sans configuration d’hôte de session ne pourra jamais en recevoir une par la suite. Cette approche ne concerne par ailleurs que les pools d’hôtes mutualisés :

À surveiller : à l’heure où j’écris ces lignes, certaines pages de référence Microsoft, comme celle de la mise à jour de l’hôte de session ou celle de l’identité managée, portent encore la mention préversion. Le changelog officiel, lui, annonce bien la disponibilité générale et distingue clairement les nouveautés qui restent en preview. Le plus probable est un simple décalage de documentation, doublé d’un déploiement progressif. À vérifier dans votre tenant avant tout passage en production.

2. L’orchestration des hôtes de session

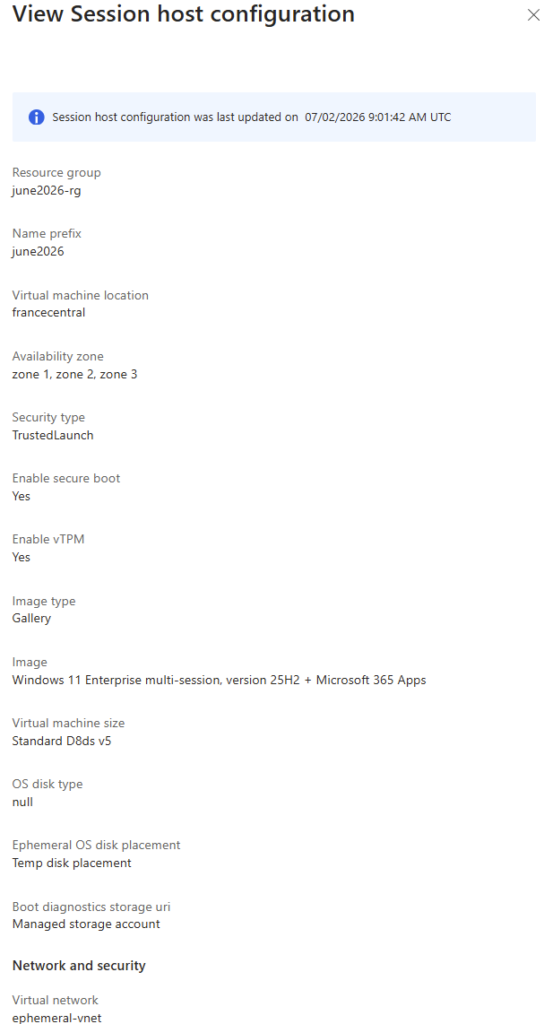
C’est la brique centrale. La configuration d’hôte de session, ou session host configuration, décrit une bonne fois pour toutes ce que doivent être vos hôtes : image, taille de VM, type de disque, type de sécurité, jonction de domaine, réseau, identité, tags.

Tous les hôtes du pool s’alignent sur cette configuration unique :

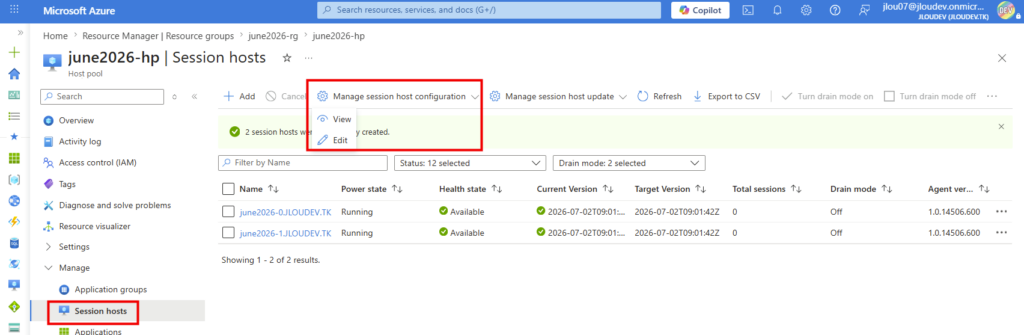
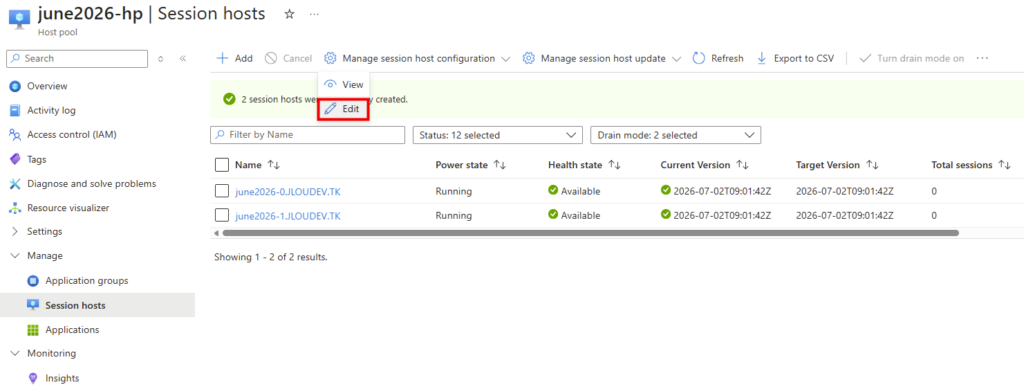
Pour faire évoluer votre parc, vous ne touchez plus chaque VM une par une, vous modifiez la configuration :

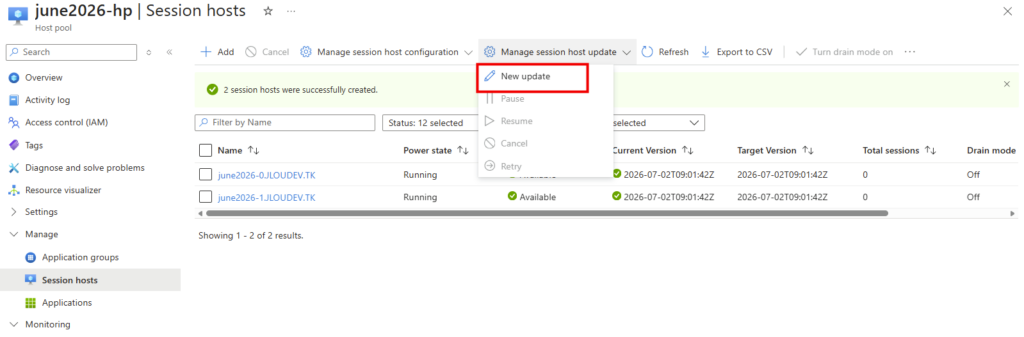
Puis vous déclenchez une mise à jour de l’hôte de session :

La mise à jour de l’hôte de session vous permet de mettre à jour le type de disque de machine virtuelle sous-jacente, l’image du système d’exploitation et d’autres propriétés de configuration de tous les hôtes de session dans un pool d’hôtes avec une configuration d’hôte de session. La mise à jour de l’hôte de session libère ou supprime les machines virtuelles existantes et en crée de nouvelles qui sont ajoutées à votre pool d’hôtes avec la configuration mise à jour.

Source : Mise à jour de l’hôte de session, Microsoft Learn

Concrètement, la mise à jour ne bricole pas vos VM en place, elle les remplace. Le service cible d’abord un seul hôte, dit initial, pour valider que le processus fonctionne de bout en bout, puis il traite le reste par lots dont vous fixez la taille :

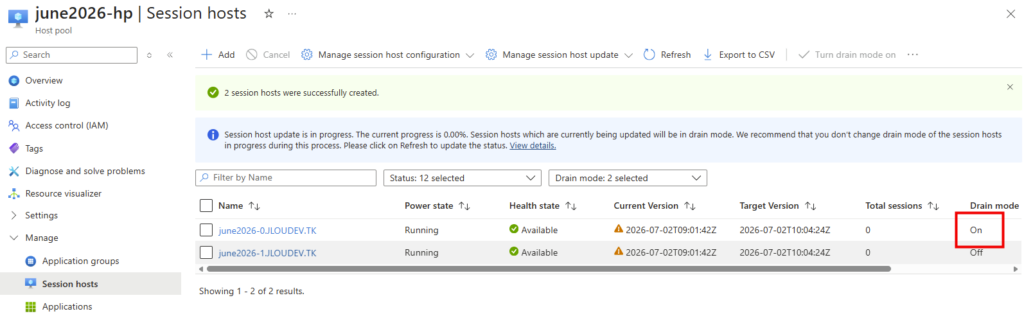
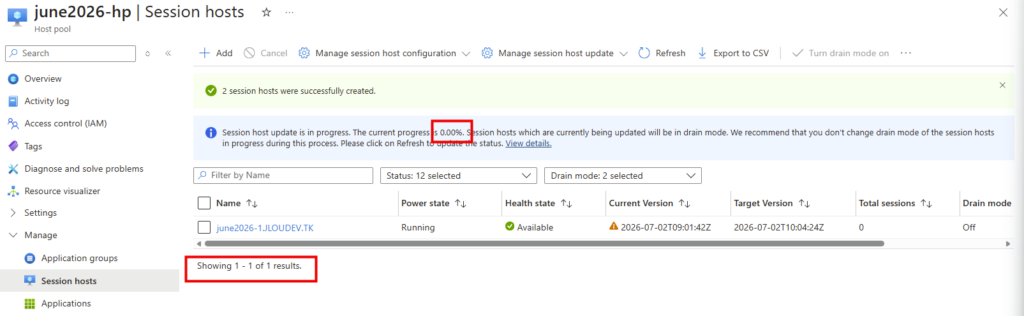
Chaque hôte concerné passe en mode drain, vos utilisateurs connectés reçoivent une notification et un délai avant déconnexion, l’ancienne VM est retirée du pool, une nouvelle est créée depuis la configuration à jour, jointe au domaine puis remise en service :

L’ancienne VM est enfin supprimée. La progression n’avance que lorsqu’un hôte est réellement terminé, ce qui explique qu’elle reste à 0 % pendant le traitement du tout premier.

Bon à savoir : l’état d’alimentation existant est respecté, vous pouvez donc lancer une mise à jour sur un pool dont tous les hôtes sont OFF pour limiter les coûts. Le pas-à-pas complet, du domaine managé jusqu’au déclenchement de la mise à jour, reste disponible dans mon tuto dédié : Orchestrez votre AVD.

3. La mise à l’échelle dynamique : créer et supprimer, pas seulement allumer et éteindre

Le plan de mise à l’échelle existait déjà pour optimiser les coûts d’un pool.

Ce qui arrive en GA, c’est sa méthode dynamique. La différence tient en une phrase :

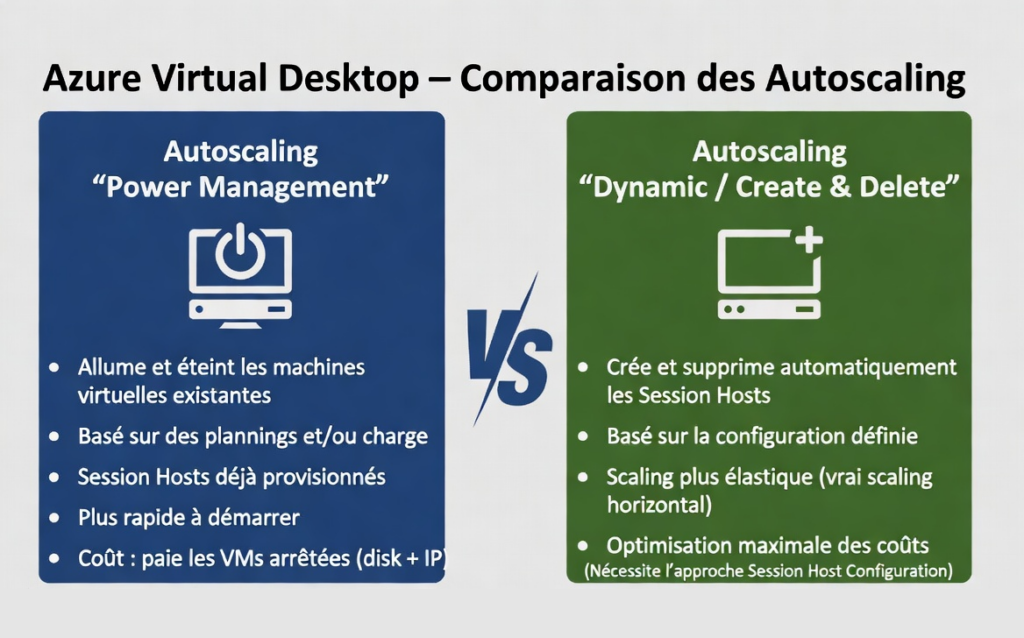
  • En gestion de l’énergie, le plan se contente d’allumer et d’éteindre des VM existantes :
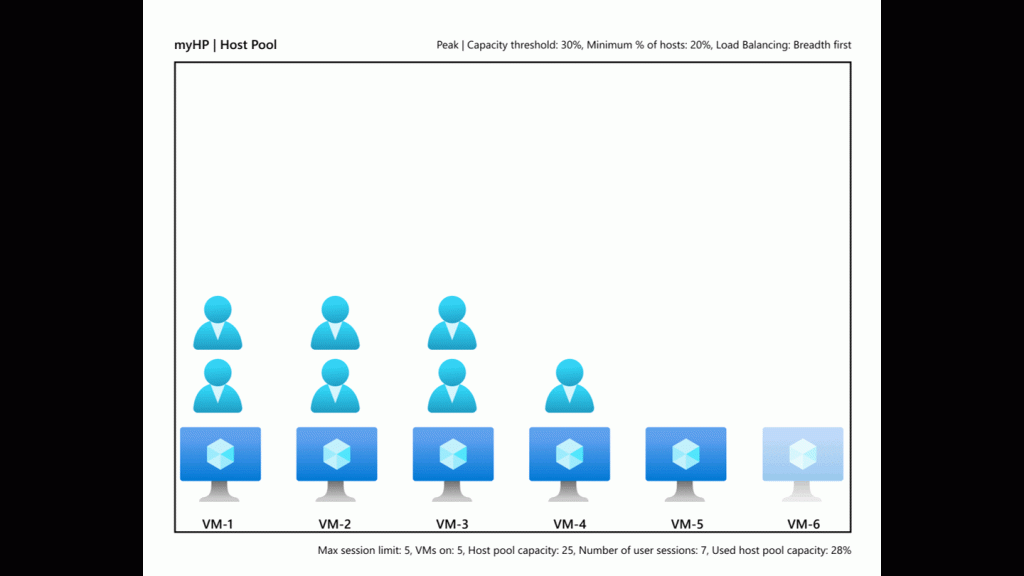
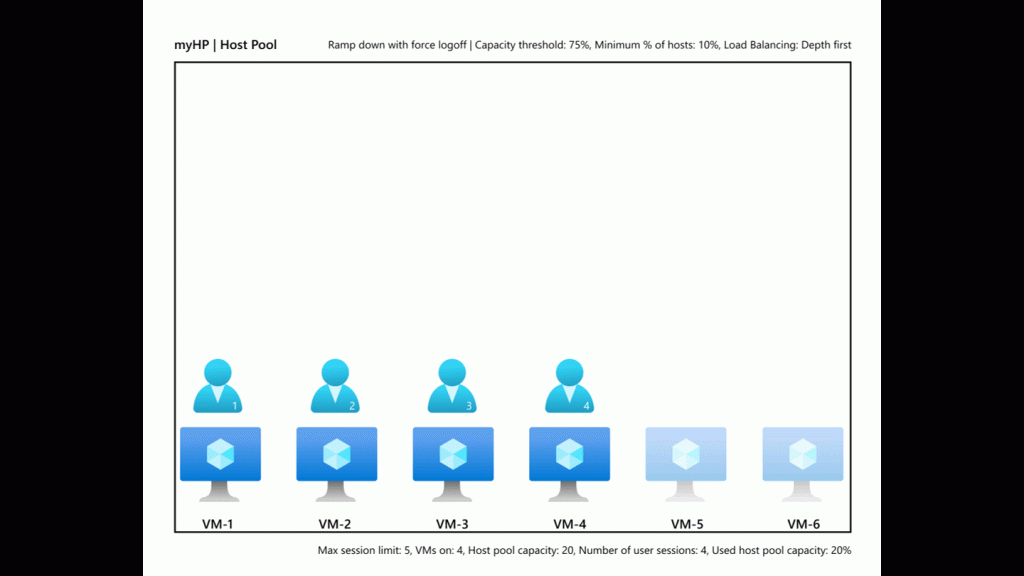
  • En mode dynamique, il crée et supprime réellement les machines virtuelles selon l’usage et la planification, en s’appuyant sur la mise à jour de l’hôte de session pour les recréer dans leur dernière version :

Les phases du plan, elles, ne changent pas : montée en charge, période de pointe, descente en charge et hors-période.

Vous y réglez les seuils de capacité, l’algorithme d’équilibrage, le nombre minimum et maximum de VM, et la déconnexion forcée éventuelle en descente de charge. L’intérêt du dynamique : quand la charge tombe, vous ne payez plus des VM éteintes qui traînent, elles disparaissent, puis se recréent à la demande :

Les mécanismes de fond, eux, restent les mêmes d’une méthode à l’autre.

La mise à l’échelle démarre/crée progressivement des machines virtuelles quand une certaine limite d’utilisateurs est atteinte :

Elle éteint/supprime les machines virtuelles tant qu’elles ne sont pas exploitées :

Elle peut forcer la déconnexion des utilisateurs, uniquement si vous l’avez activé en descente de charge :

Quelques garde-fous à garder en tête : la méthode dynamique vise les pools mutualisés (pas les environnements personnels), s’appuie sur un pool déjà configuré avec la mise à jour de l’hôte de session, et connaît des restrictions selon le type de jonction et l’hébergement.

Le déroulé complet, avec les tests de création et de suppression de VM en direct, est dans mon tuto : AVD et la mise à l’échelle dynamique.

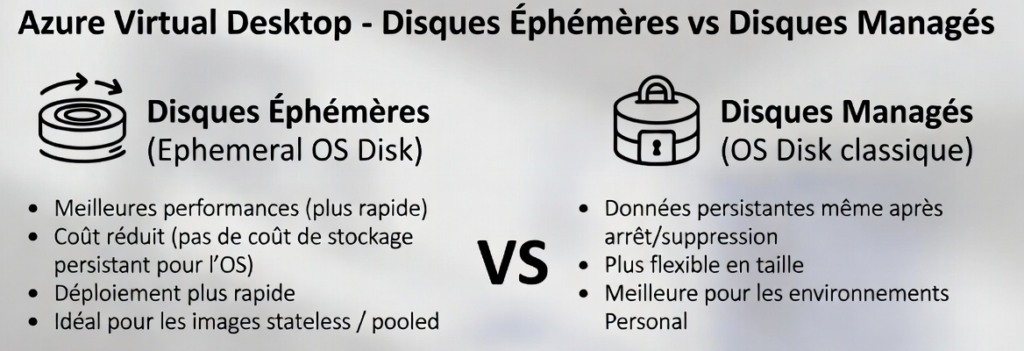
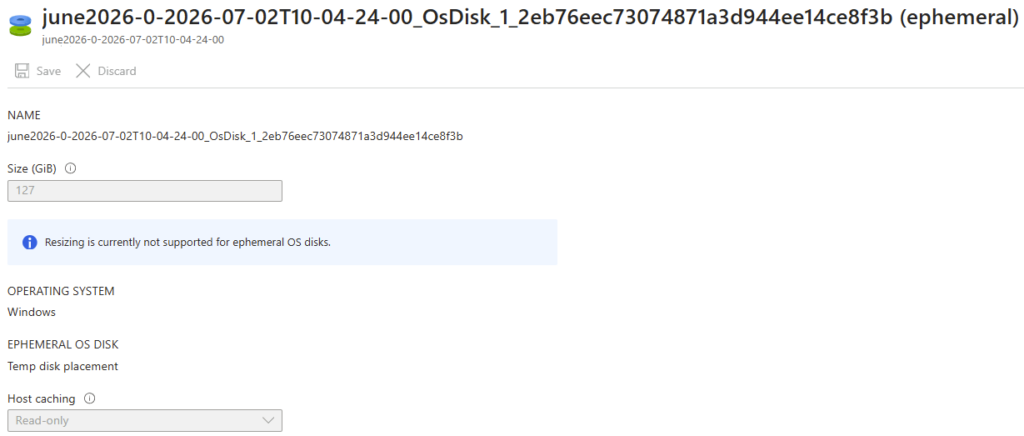
4. Les disques OS éphémères, enfin natifs

Troisième brique, les disques OS éphémères.

Le principe : le disque système vit sur le stockage local de l’hôte, pas sur du stockage distant managé :

Résultat, des lectures et écritures à plus faible latence, un provisionnement et une réinitialisation plus rapides :

Et un coût inclus dans celui de la taille de VM :

La contrepartie est assumée, ces disques ne conservent rien au-delà du cycle de vie de la machine :

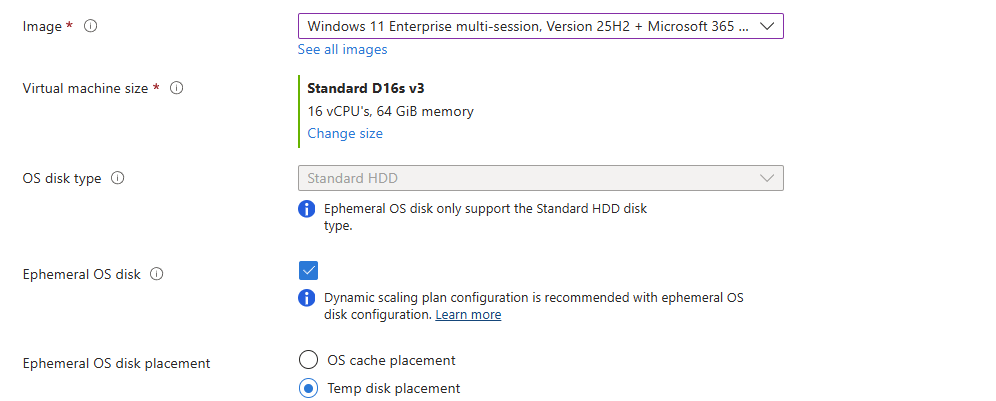
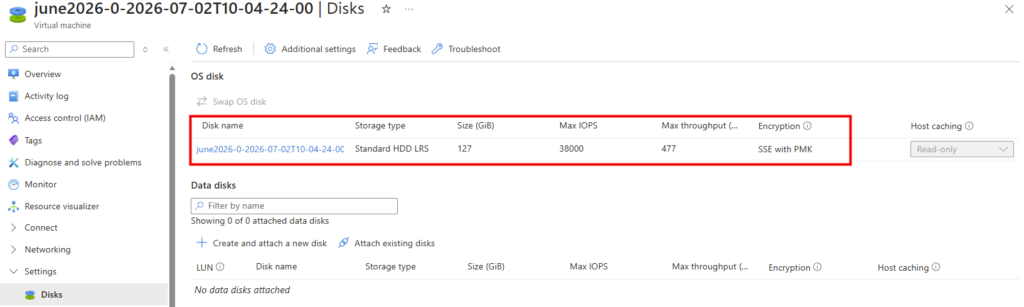
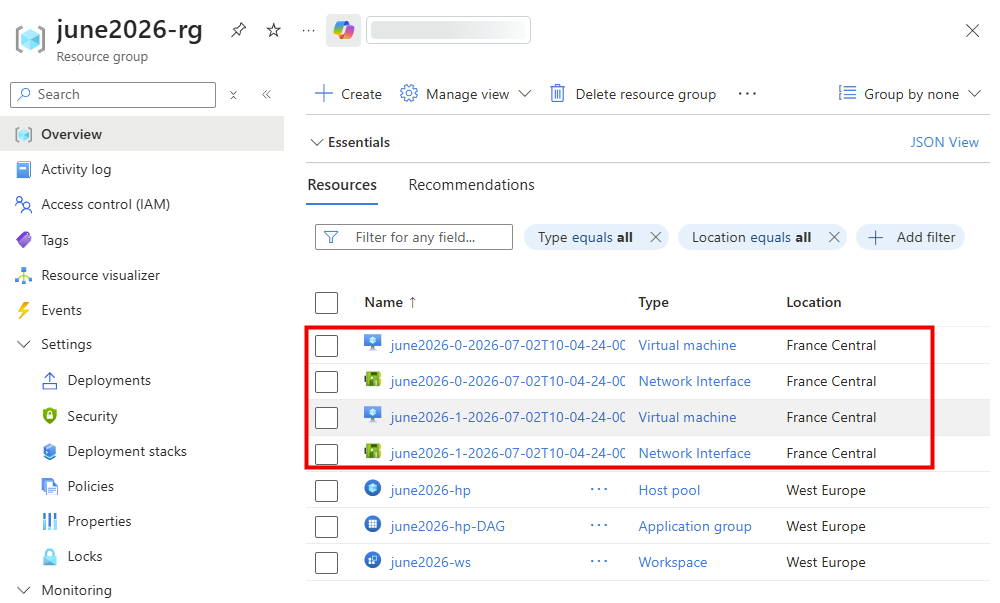
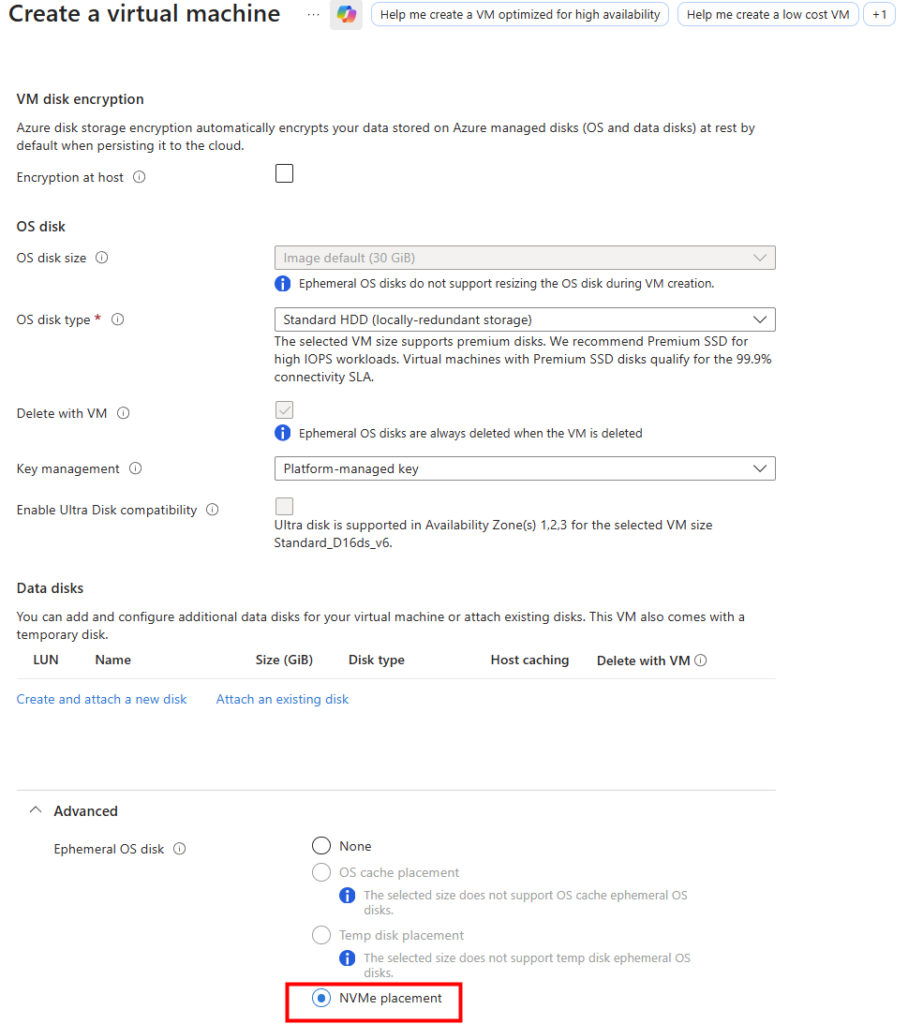
Le changement de la GA est là. En préversion, l’interface de création d’AVD ne permettait pas de choisir un disque éphémère, ce qui obligeait à un contournement, créer les VM à la main puis les rattacher au pool :

Microsoft annonce désormais les disques éphémères disponibles et optimisés pour Azure Virtual Desktop, et la configuration d’hôte de session inclut les informations du disque OS. La prise en charge devient donc officielle et intégrée, au lieu d’un montage manuel.

Pour bien saisir les différents disques éphémères sur Azure, l’excellente vidéo de John Savill reste la meilleure entrée en matière :

Les contraintes restent les mêmes, et il faut les connaître : pas de sauvegarde de la VM, pas de désallocation, et un redimensionnement qui fait perdre toute la donnée. Pour un pool AVD bâti sur une golden image et qui ne stocke pas de données utilisateur, ce ne sont pas des bloqueurs, plutôt des propriétés à assumer.

Mon comparatif de performances entre disque Premium SSD, cache et temporaire, tests DiskSpd à l’appui, est ici : Associez un disque éphémère à votre AVD. La référence Microsoft sur le sujet reste la page des disques OS éphémères.

5. Le vrai piège : l’identité managée devient incontournable

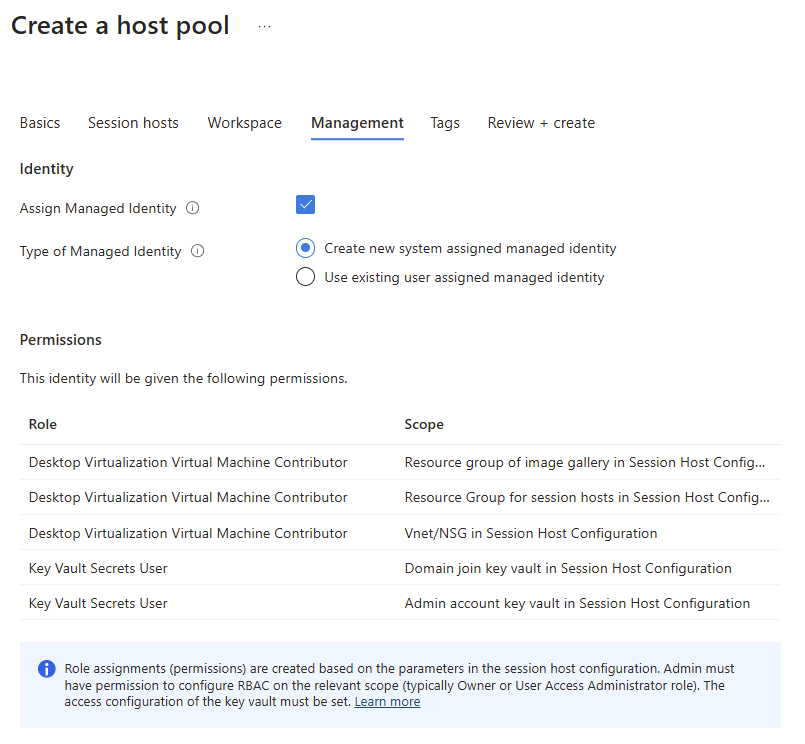
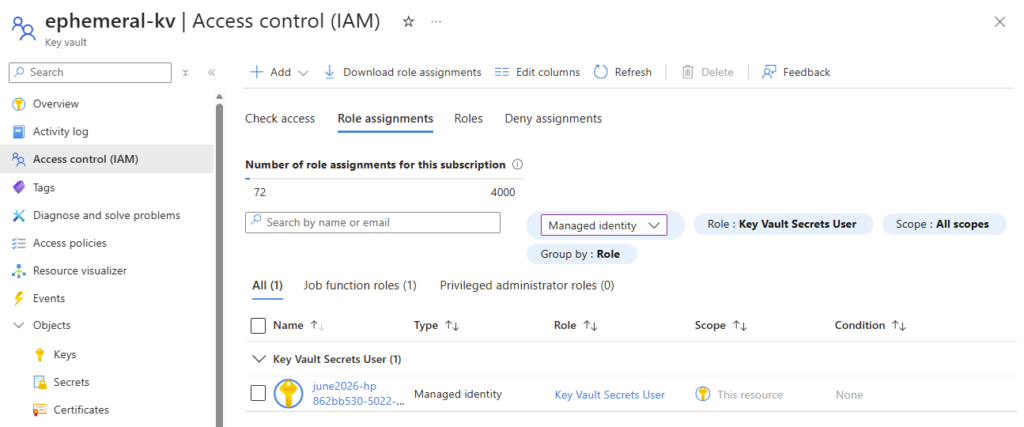
Si vous relisez mes anciens tutos, vous verrez que je faisais reposer les droits sur l’application de service Azure Virtual Desktop, avec des rôles RBAC assignés à la main sur le Key Vault et un rôle personnalisé pour la lecture de la configuration. Cette mécanique n’est plus la bonne. Microsoft a basculé vers l’identité managée, et ce n’est pas une simple recommandation :

Attention : l’identité managée est devenue nécessaire pour les pools qui utilisent une configuration d’hôte de session. Le calendrier annoncé par Microsoft est sans ambiguïté : depuis le 19 septembre 2025, un nouveau pool de ce type doit être créé avec une identité managée ; depuis le 15 octobre 2025, un pool existant ne peut plus mettre à jour sa configuration sans en ajouter une ; et depuis le 15 novembre 2025, il ne peut plus créer d’hôtes sans elle. Si vous suivez encore la méthode service principal de mes anciens articles, vous allez vous heurter à un mur.

La bonne nouvelle, c’est que l’identité managée simplifie le tableau. Elle supprime le besoin d’assigner des permissions à l’application de service Azure Virtual Desktop, attribue automatiquement les droits en fonction des paramètres de la configuration d’hôte de session, et apporte un contrôle plus fin par pool :

Elle débloque aussi deux cas concrets : l’accès à un Key Vault dont l’accès public est désactivé, réservé aux services Microsoft de confiance, et l’usage d’une image hébergée dans un autre abonnement du même tenant. La marche à suivre est décrite sur la page de configuration de l’identité managée.

Concrètement, ça donne quoi ?

Voilà, en une synthèse, trois briques de préversion réunies et remises à niveau pour la disponibilité générale : la configuration d’hôte de session pour standardiser et mettre à jour votre parc, la mise à l’échelle dynamique pour créer et supprimer les VM au fil de la charge, et les disques éphémères désormais intégrés proprement.

Les pièges à retenir :

  1. L’identité managée n’est plus optionnelle, oubliez la méthode service principal de mes anciens tutos.
  2. L’approche de gestion se choisit à la création du pool et ne se change plus après.
  3. Les disques éphémères ne persistent rien, parfait pour une golden image, à proscrire pour de la donnée utilisateur.
  4. Certaines pages de doc portent encore le label préversion, vérifiez l’état réel dans votre tenant avant la prod.

Pour le détail pas-à-pas de chaque brique, mes trois tutos d’origine restent la référence : l’orchestration, la mise à l’échelle dynamique et les disques éphémères. Foncez tester tout ça en lab, maintenant que la production est autorisée. Pour suivre les évolutions, gardez un oeil sur le What’s new d’Azure Virtual Desktop.

AVD/W365 : Redirections basées sur le contexte

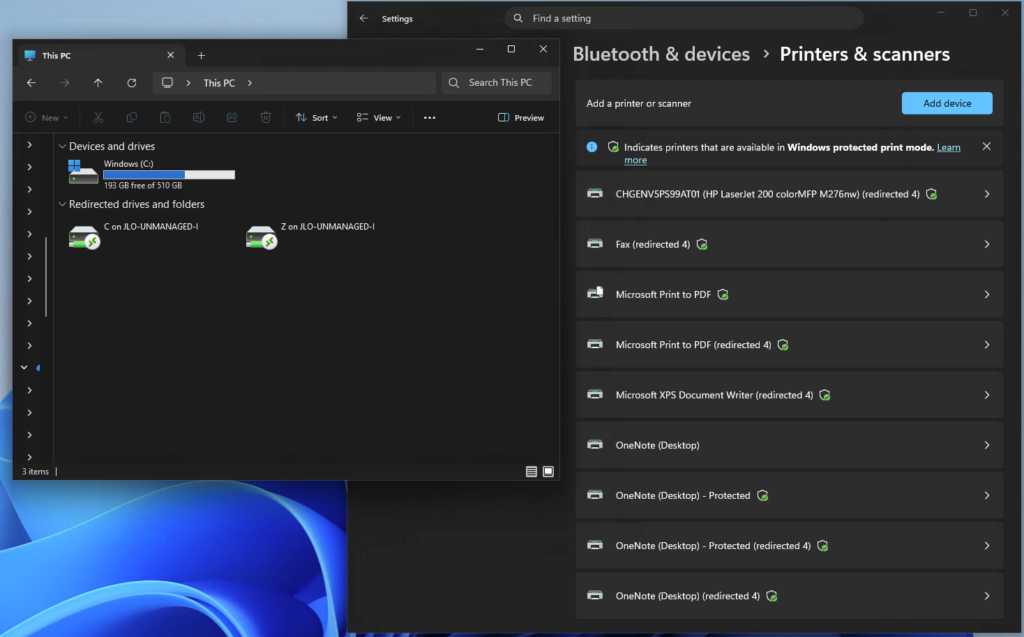
Que peut bien dire le titre de cet article ? Vous avez peut être déjà entendu parler des Context-based Redirections à droite à gauche, vous savez vaguement ce dont ça parle, mais vous n’avez jamais mis les mains dedans ? Cet article est fait pour vous. On va dérouler, écran après écran, jusqu’à voir une redirection (presse-papiers, lecteurs, imprimante, USB…) s’activer pour une machine conforme et se couper net pour une machine non conforme.

Pour rappel, jusqu’ici une politique de redirection sur AVD ou Windows 365 était binaire : si vous bloquiez le presse-papiers (ou les lecteurs, l’USB, l’imprimante), c’était bloqué pour tout le monde, sur tous les appareils : le portable corporate conforme comme le téléphone perso en BYOD. La seule parade, c’était de maintenir deux host pools séparés.

Avec les Context-based Redirections, on peut enfin faire varier la redirection au niveau de chaque connexion, selon la conformité de l’appareil, le réseau, ou le rôle de l’utilisateur. Un seul host pool, deux comportements. C’est du Zero Trust appliqué à la redirection.

Attention : au moment où j’écris ces lignes, la fonctionnalité est en Public Preview. À tester en lab, pas en prod. Et elle n’est supportée que via les clients Windows App (Windows, web, Android, iOS, macOS), le bon vieux mstsc ne participe pas au mécanisme.

Pour vous guider plus facilement dans cet article, voici des liens rapides :

1. C’est quoi, les Context-based Redirections ?

Concrètement, ça donne quoi ? C’est une capacité qui applique des politiques d’accès granulaires aux redirections client, en s’appuyant sur un contexte d’authentification Microsoft Entra. L’idée : la redirection n’est autorisée que si la session atteint le niveau de confiance exigé.

La redirection contextuelle permet aux organisations de contrôler le comportement de redirection en fonction des conditions d’utilisateur et de session.

À l’aide du contexte d’authentification, les administrateurs peuvent définir quand des fonctionnalités client spécifiques doivent être autorisées ou restreintes en fonction de facteurs tels que le rôle d’utilisateur, la conformité de l’appareil ou l’emplacement réseau.

Cela permet de s’assurer que les données sensibles sont accessibles uniquement lorsque la session répond au niveau de confiance requis.

Source : Context-based redirections (Preview) — Microsoft Learn

Le point que je veux marteler tout de suite, parce que je vais beaucoup parler du presse-papiers dans la démonstration : la fonctionnalité ne se limite pas au copier-coller. Microsoft documente quatre redirections pilotables par contexte d’authentification :

  • Clipboard : le presse-papiers (copier-coller texte, image, fichier… dans un sens ou dans l’autre).
  • Drive : les lecteurs locaux (fixes, amovibles, réseau) remontés dans la session distante.
  • Printer : la redirection d’imprimante.
  • USB : la redirection des périphériques USB.

Dans cet article, je teste le clipboard et les lecteurs, tout simplement parce que ce sont les deux redirections que j’avais déjà sous la main, restreintes via mes anciennes polices (j’y reviens juste en dessous). Mais le principe, l’enchaînement des trois couches, la logique d’évaluation à la connexion : tout est rigoureusement identique pour l’imprimante et l’USB. Si vous savez piloter le presse-papiers par contexte, vous savez piloter les quatre. Vous remplacez juste la redirection ciblée dans la dernière couche.

Pour info : la policy Remote Connection Experience expose chacune de ces redirections avec le même menu déroulant. Pour chaque ligne, vous choisissez « activé », « non configuré » ou « contexte d’authentification ». C’est ce dernier choix qui déclenche tout le mécanisme, et il se présente exactement de la même façon que vous soyez sur Clipboard, Drive, Printer ou USB.

2. Pourquoi maintenant ? Le durcissement par défaut depuis mi-2025

Petit détour utile pour comprendre pourquoi cette fonctionnalité tombe à pic. Depuis mi-2025, Microsoft a basculé d’une logique « tout ouvert, à vous de durcir » vers du secure by default : sur les nouvelles images Windows 365 et les nouveaux host pools AVD, les redirections (presse-papiers, lecteurs, USB, imprimantes) sont désactivées nativement. C’est aligné avec la Microsoft Secure Future Initiative (SFI).

J’ai déjà décortiqué ces deux sujets dans le détail, et je vous renvoie à mes articles précédents si vous voulez creuser le sujet :

  • Configurez le presse-papier dans AVD/W365 : le durcissement par défaut depuis le 18 juin 2025, la logique des deux couches (propriétés RDP côté client + polices GPO/Intune côté serveur), et le détail des niveaux SCClipLevel / CSClipLevel.
  • AVD : Restriction du Presse-papier : comment restreindre finement le copier-coller via Intune et les propriétés RDP, sens par sens et type de donnée par type de donnée.

Là où le bât blessait : cette restriction par défaut, bien qu’affinée, restait globale :

  • Au niveau des configurations RDP d’Azure Virtual Desktop :
  • Au niveau des polices de configuration Intune :

Une fois le presse-papiers (ou les autres) bloqué ou débloqué, il l’était pour toutes les connexions, sans distinction de l’appareil ou du réseau :

C’est exactement le mur que les Context-based Redirections font tomber : on garde la posture « fermé par défaut », mais on rouvre dynamiquement pour les connexions de confiance.

D’où l’enchaînement logique de cet article : on part d’un environnement où la redirection est restreinte, et on la rend conditionnelle :

3. Comment ça marche : l’architecture en 3 couches

C’est LE point à comprendre avant de cliquer partout. Le mécanisme repose sur trois couches qui s’enchaînent :

  1. Le contexte d’authentification : un simple « jeton » d’exigence que l’on définit dans Entra et que l’on « publie ».
  2. La policy d’accès conditionnel (CA) : elle cible ce contexte et impose une exigence (appareil conforme, réseau de confiance, MFA…). C’est elle qui décide si le claim c1 est émis ou non dans le token de session.
  3. La policy Remote Connection Experience (RCE) côté Windows 365 (ou la propriété RDP du host pool côté AVD), qui lie une redirection donnée (clipboard, drive, printer ou USB) au contexte.

La logique de bout en bout, à la connexion :

  • La redirection est liée à c1 → elle est OFF par défaut, et ne s’allume que si le claim c1 est présent dans le token de session.
  • Le claim c1 n’est présent que si le step-up d’authentification pour c1 réussit.
  • Ce step-up réussit si aucune CA ne le bloque, ou si une CA qui le cible est satisfaite.
Mon retour terrain : la CA ne sert qu’à poser des exigences sur l’émission du claim c1. S’il n’y a aucune CA qui cible c1, rien ne bloque → le claim passe → vous avez vos redirections (selon ce que la RCE autorise). Dès qu’une CA cible c1, il faut la satisfaire ; si vous êtes bloqué par elle, le claim n’est jamais émis → redirection coupée. C’est aussi simple que ça, mais ça m’a pris un paquet de tests pour le formuler clairement.

4. Pré-requis

BriqueCe qu’il vous faut
Poste de travail virtuelWindows 365 Enterprise (Cloud PC) ou Azure Virtual Desktop
Identité & accès conditionnelMicrosoft Entra ID P1 (minimum) pour le Conditional Access
Gestion des stratégiesMicrosoft Intune (config + RCE policy + conformité)
Client de connexionWindows App (Windows / web / Android / iOS / macOS). Pas mstsc.
Image / agentCloud PC sur image récente prenant en charge la preview
Pré-requis à valider selon votre déploiement (W365 ou AVD).

5. Étape 0 : Débrayer les restrictions par défaut

Le piège classique, et il est sournois : sur les images récentes de Cloud PC (et les nouveaux pools d’hôtes AVD), les redirections client sont désactivées par défaut :

C’est précisément le durcissement dont je parlais à la section 2. Si vous laissez ça en l’état, vous allez croire que votre conf context-based « bloque bien »… alors qu’en réalité c’est juste le défaut restrictif qui parle. Et surtout : la policy la plus restrictive l’emporte. Tant qu’une stratégie restreint la redirection « en dur », le mécanisme context-based ne pourra jamais l’autoriser.

Si vous utilisez une image de galerie récente pour tester votre PC cloud ou si vous avez des stratégies existantes dans votre environnement qui affectent les redirections, modifiez-les avant le test, car la stratégie la plus restrictive l’emporte.

Par conséquent, vous devez définir les redirections que vous souhaitez tester pour qu’elles soient « non configurées » ou « activées » pour que la redirection basée sur le contexte fonctionne correctement.

Source : Context-based redirections (Preview) — Microsoft Learn

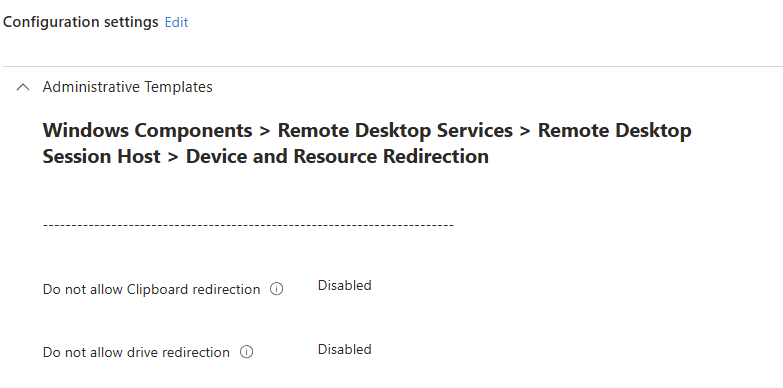
La parade : créer (ou réutiliser) une policy Settings catalog dans Intune qui remet les redirections que l’on veut tester sur Disabled au sens « Do not allow… = Disabled » :

Autrement dit, on désactive la désactivation, donc on autorise. 😅

Dans mon lab, je m’appuie justement sur le groupe et les polices que j’avais montés pour mes articles précédents sur le presse-papiers : c’est mon point de départ « fermé », que je vais rouvrir conditionnellement.

Pas à pas, dans Intune :

  1. Intune → DevicesManage devicesConfigurationCreateNew Policy.
  2. Plateforme : Windows 10 and later ; type de profil : Settings catalogCreate.
  3. Basics : donnez un nom parlant et une description.
  4. Configuration settings+ Add settings.
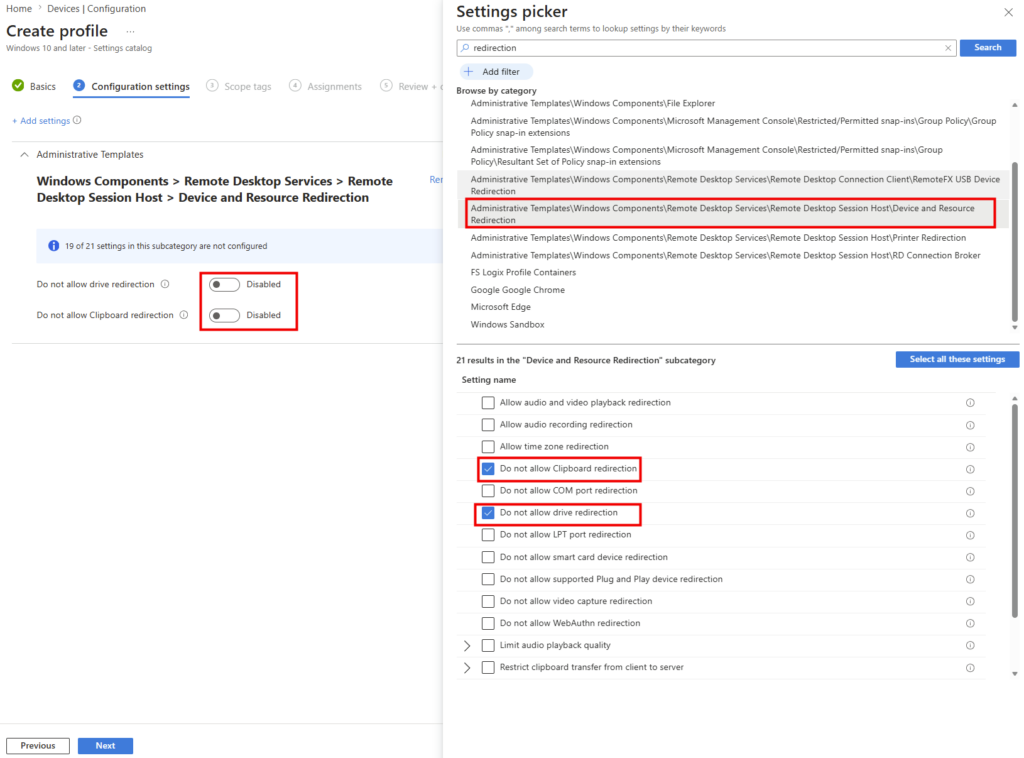
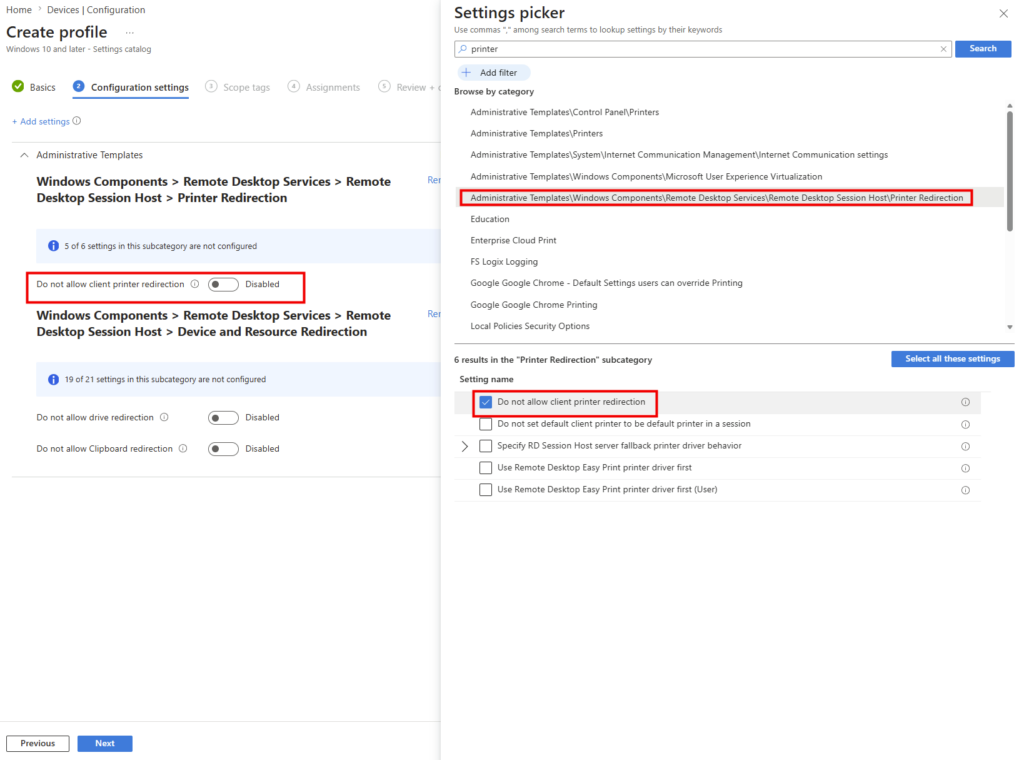
  • Pour le presse-papiers, les lecteurs et l’USB : recherchez Device and Resource Redirection, sélectionnez la catégorie, puis cochez les réglages à piloter :
  • Pour l’imprimante : recherchez Printer Redirection (catégorie distincte) et cochez les réglages voulus :
  1. Basculez chaque réglage « Do not allow… » sur Disabled. On ne veut aucune interdiction « en dur » sur les redirections qu’on va confier au contexte
  2. Scope tags (facultatif) → Next
  3. Assignments : ciblez le groupe qui doit recevoir la policy → Next
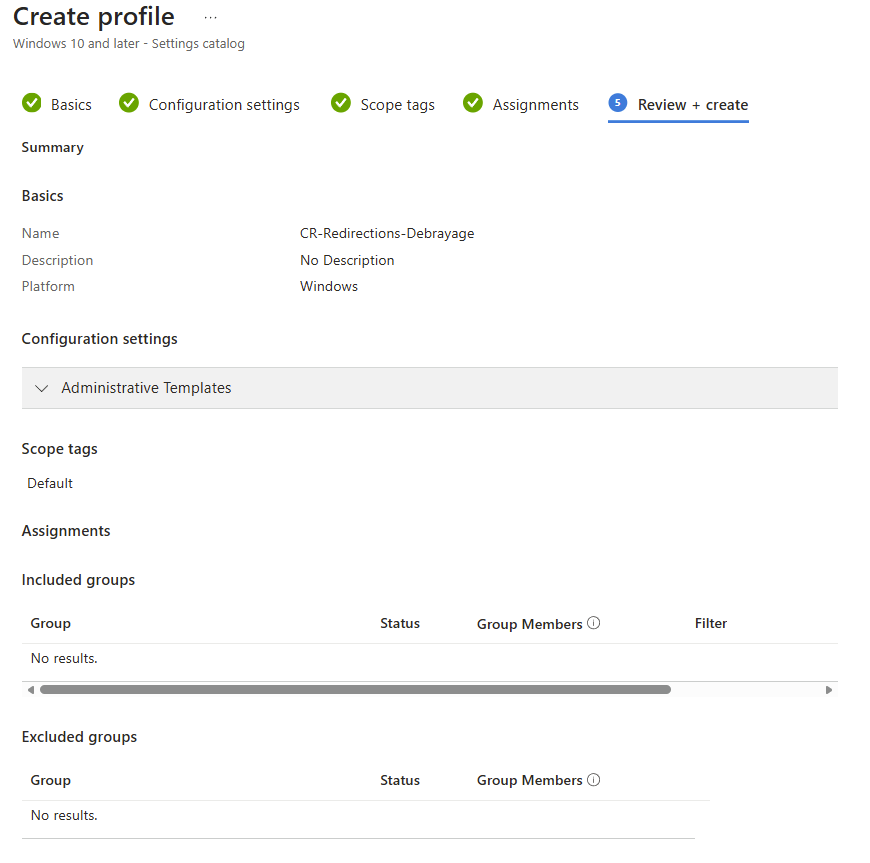
  4. Review + createCreate

Une fois la configuration poussée sur le poste, cela nous donne la configuration de registre suivante :

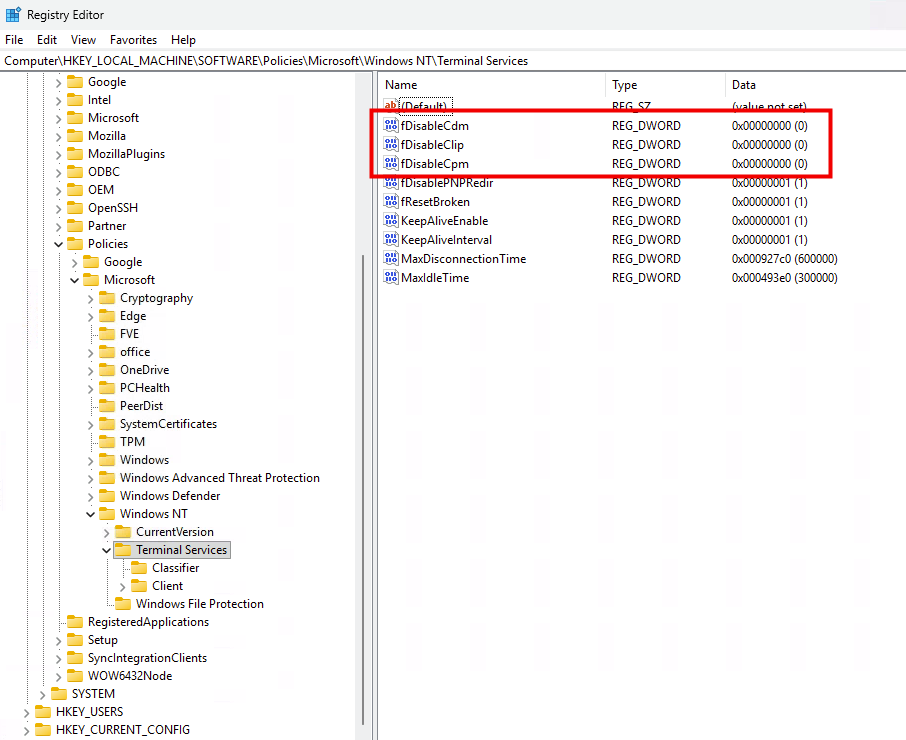
Pour info : sous le capot, ces réglages pilotent les valeurs de registre RDP côté session (par ex. fDisableClip pour le presse-papiers, fDisableCdm pour les lecteurs). « Débrayé à 0 » = redirection autorisée. Si vous voulez le détail de ces clés, des deux couches client/serveur et des niveaux SCClipLevel / CSClipLevel, tout est dans mon article Configurez le presse-papier dans AVD/W365.

6. Étape 1 : Créer le contexte d’authentification (c1)

Première vraie brique du mécanisme. Le contexte d’authentification, c’est ce « jeton d’exigence » qu’on va ensuite cibler depuis la CA et lier depuis la RCE. Pas à pas :

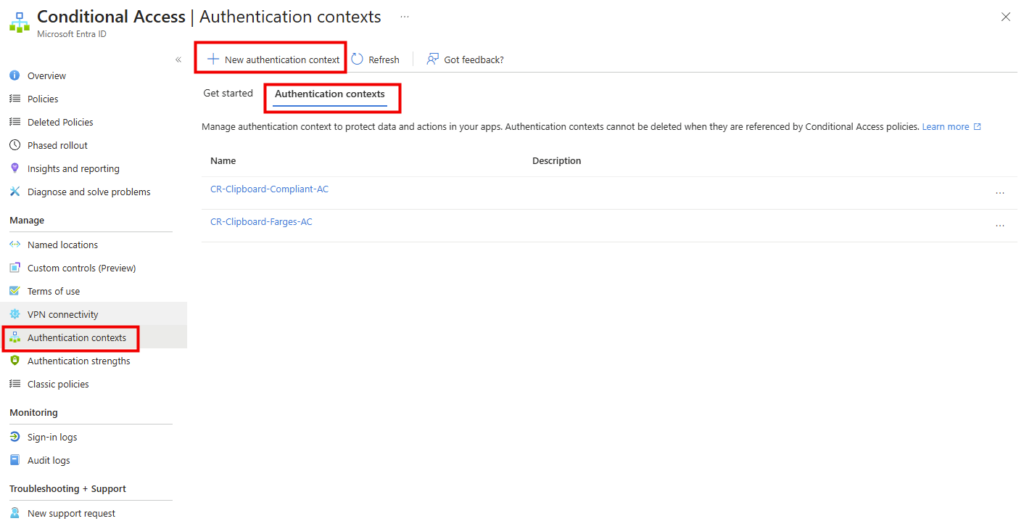
  1. Entra (ou Intune → Devices) → Conditional AccessAuthentication contexts
  2. New authentication context
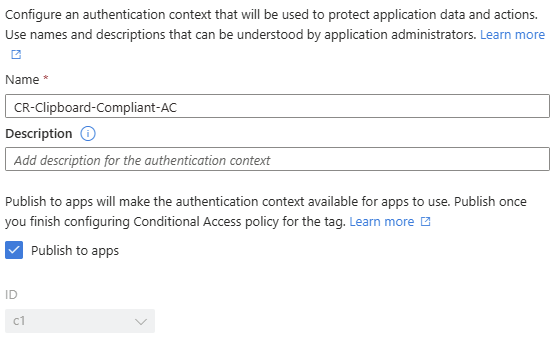
  3. Donnez un nom et une description explicites
  4. Cochez impérativement Publish to apps, puis choisissez une valeur dans le menu ID (ici c1)
  5. Sauvegardez
Attention : si Publish to apps n’est pas coché, vous pourrez bien référencer c1 dans la RCE policy, mais il ne sera jamais sollicité à la connexion. Résultat : la CA reste en « Not Applied » et rien ne se déclenche. C’est l’oubli n°1.

7. Étape 2 : La police d’accès conditionnel (les 3 cas)

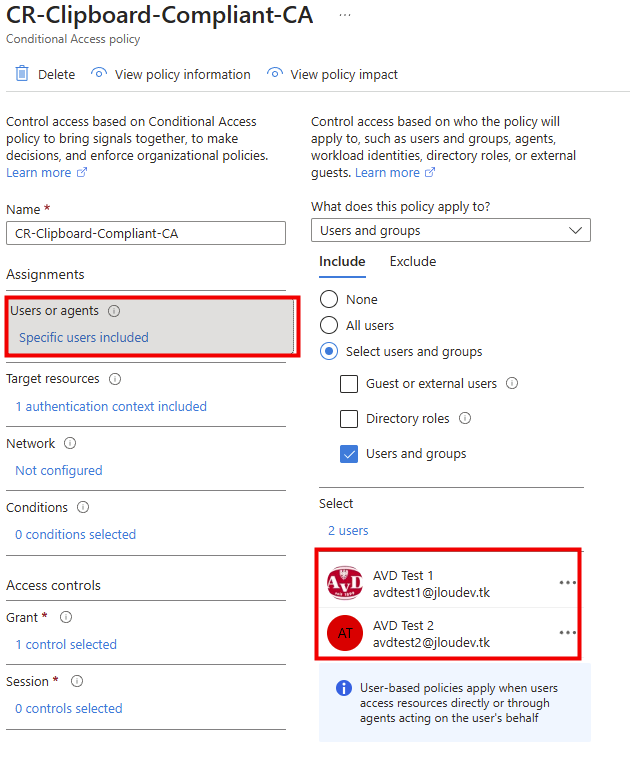
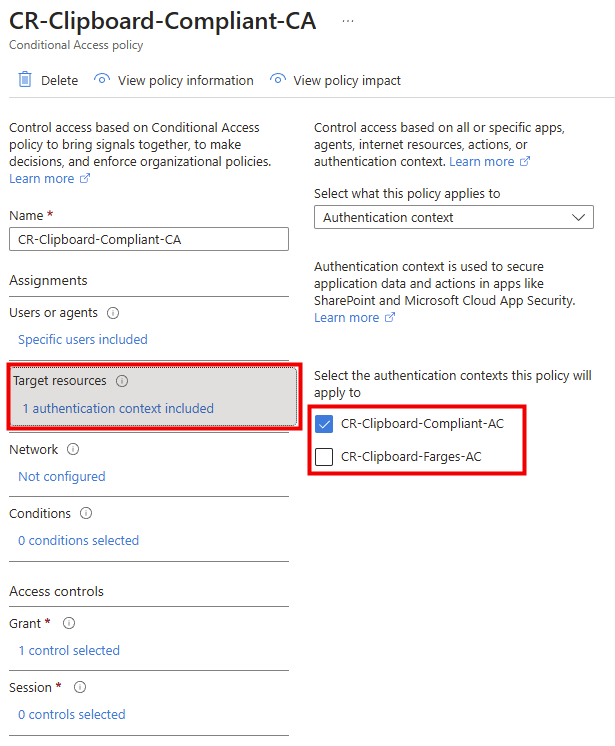
C’est ici que se joue la « condition de confiance ». Le squelette est toujours le même : la CA cible le contexte d’authentification c1 (dans Target resources, pas dans les conditions !), et c’est le Grant (ou l’exclusion) qui décide. Je vous donne trois cas de figure que j’ai testés.
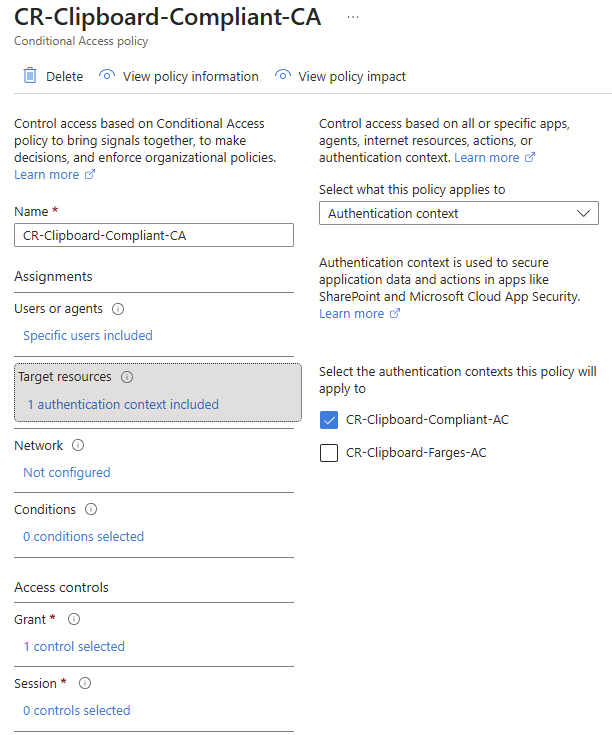
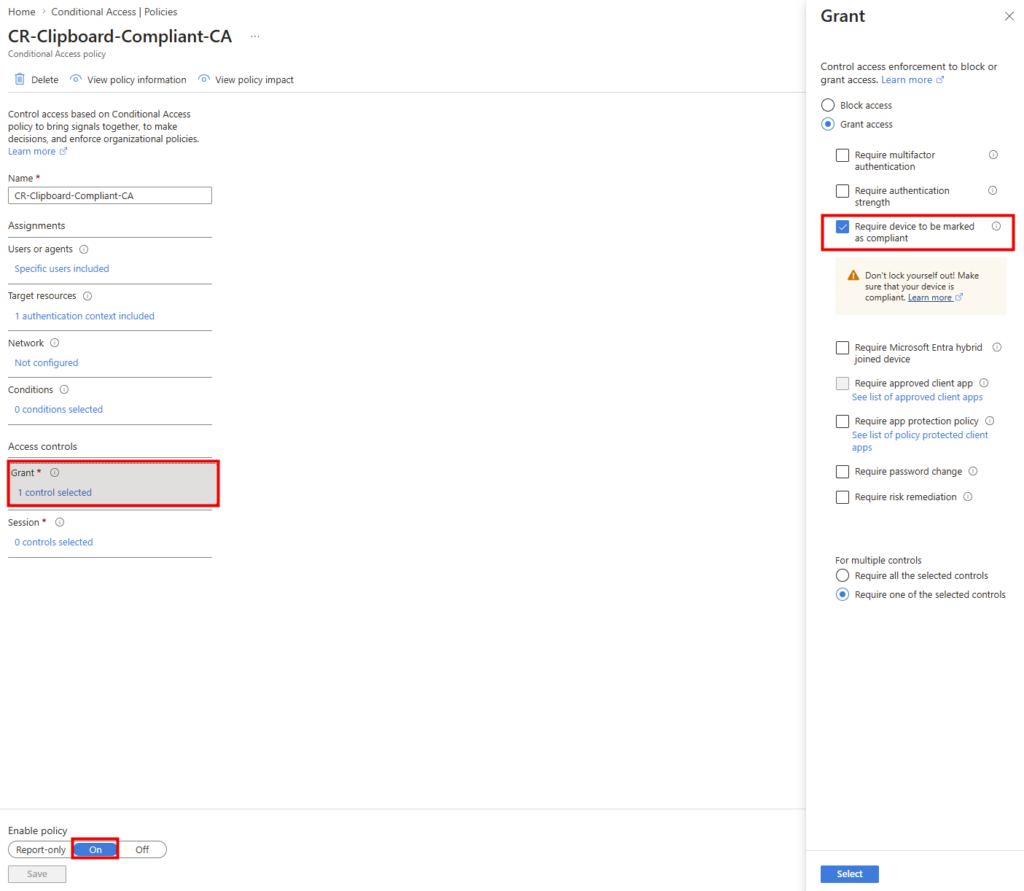
Cas n°1 : Exiger un appareil conforme compliant

Le scénario BYOD par excellence : redirection autorisée depuis une machine gérée et conforme, coupée depuis une machine perso non gérée.

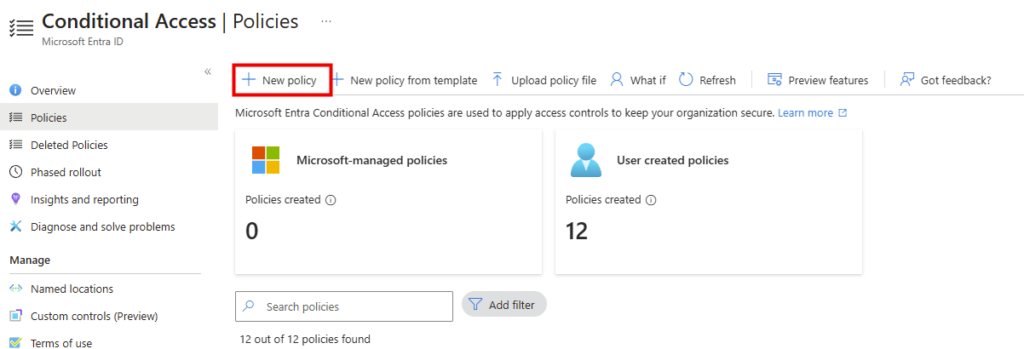
  • Conditional Access → PoliciesNew Policy :
  • Donnez un nom, puis des utilisateurs : All users sous Include (ou votre groupe de test) :
  • Target resources → menu Select what this policy applies toAuthentication context → cochez c1 :
  • GrantGrant access → cochez Require device to be marked as compliantSelect.
  • Enable policy = OnCreate.

Cas n°2 : Restreindre par adresse IP (Named location)
Ici on veut : redirection autorisée uniquement depuis un réseau de confiance (votre plage IP publique), coupée ailleurs.

Le point clé à intégrer : une location, c’est une CONDITION, pas un grant. On ne peut pas dire « autorise si IP de confiance ». La bonne logique est inversée : « Bloque c1 partout, SAUF depuis l’IP de confiance ».

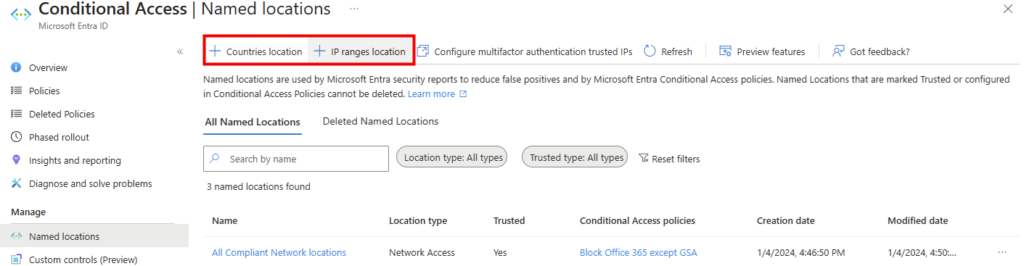
D’abord, créez la Named location :

  • Conditional Access → Named locations+ New location (IP ranges)
  • Nommez-la et saisissez votre plage IP publique en CIDR (ex. 203.0.113.42/32)
  • Cochez Mark as trusted location si proposé → Create

Ensuite, la CA :

  1. Users : All users (ou groupe de test)
  2. Target resourcesAuthentication contextc1
  3. ConditionsLocations : Include = Any location ; Exclude = Loc-Confiance
  4. GrantBlock accessSelect
  5. Enable policy = OnCreate
Attention : le Conditional Access voit l’IP publique de sortie du client. Derrière un NAT ou un proxy d’entreprise, c’est l’IP du NAT qu’il faut déclarer, pas celle du poste. Et si votre IP est dynamique (box FAI), le test peut « sauter » quand elle change. Élargissez la plage plutôt qu’un /32 figé.

Cas n°3 : Combiner conformité & adresse IP

Pourquoi pas les deux ? Pour exiger à la fois un appareil conforme et un réseau de confiance, deux approches :

  • Une seule CA : ciblez c1, Grant = Require device to be marked as compliant, ET ajoutez la condition Locations (Include = la location de confiance) pour ne l’évaluer que sur ce réseau. Hors réseau de confiance, prévoyez une seconde CA de blocage.
  • Deux CA qui ciblent c1 : une exige le compliant, l’autre bloque hors réseau de confiance. Comme toutes les CA ciblant c1 doivent passer, le claim n’est émis que si appareil conforme et sur réseau de confiance.
Mon retour terrain : quand plusieurs CA ciblent c1, elles se cumulent (« most restrictive wins » côté claim). Pour un test propre d’un seul cas, mettez les autres CA ciblant c1 sur Off le temps de l’essai, sinon vous ne saurez plus laquelle bloque.

8. Étape 3 : La police Remote Connection Experience (et la variante AVD)

C’est la couche qui lie une redirection au contexte c1. Côté Windows 365, ça passe par une policy Remote Connection Experience (preview). C’est aussi ici que vous décidez quelle(s) redirection(s) parmi les quatre (Clipboard, Drive, Printer, USB) vous confiez au contexte :

  • Intune → DevicesManage Windows 365 Cloud PCsCloud PC Settings
  • CreateRemote Connection Experience (preview) :
  • Basics : nom et description de la police :
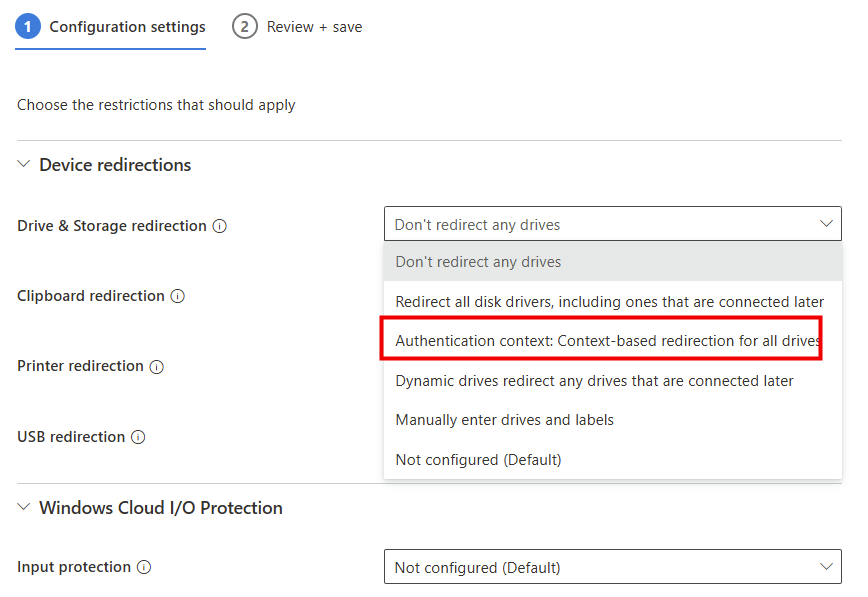
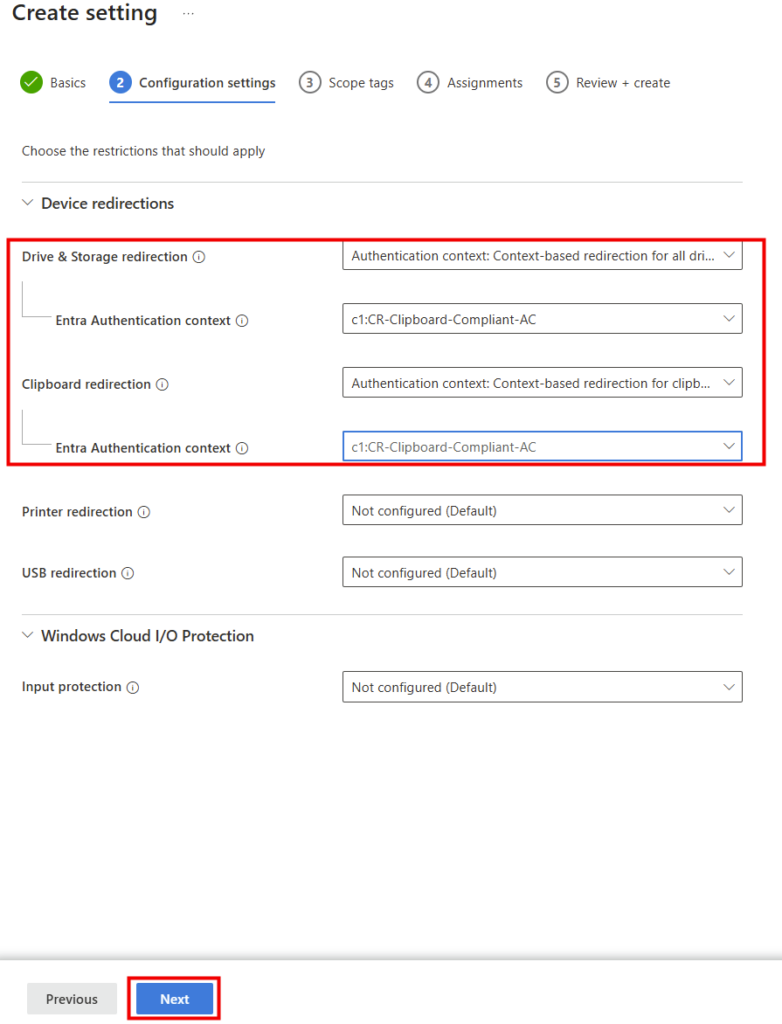
  • Dans Configuration settings → Device redirections, repérez la redirection à piloter (Clipboard, Drive, Printer ou USB) et choisissez Authentication context: Context-based redirection :
  • Dans le champ Entra Authentication context qui apparaît, sélectionnez c1.
  • Laissez les redirections non voulues sur Not configured.
  • Scope tags (facultatif) → Next :
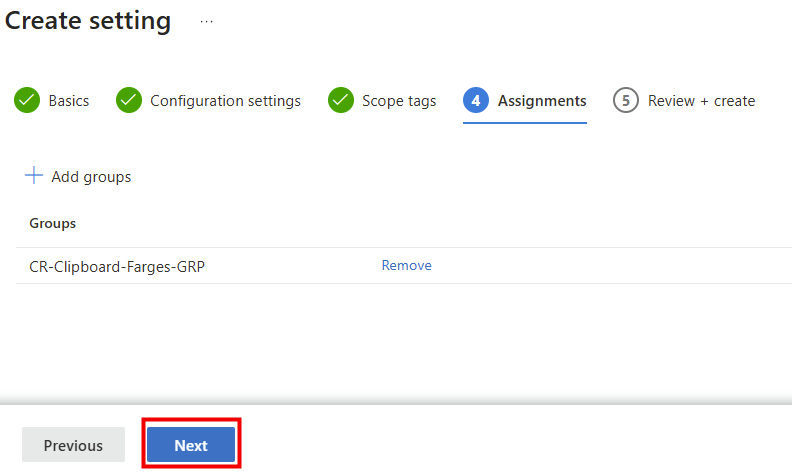
  • AssignmentsAdd groups → sélectionnez un groupe de DEVICES (les Cloud PC), surtout pas un groupe d’utilisateurs → Next :
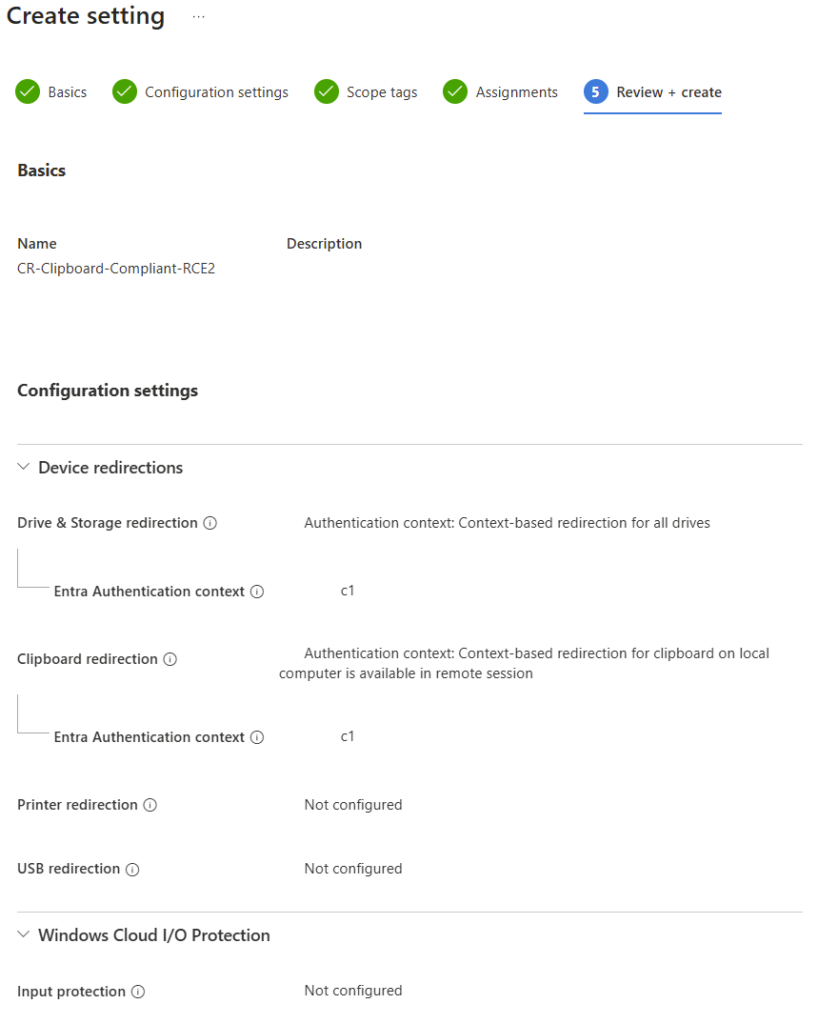
  • Review + createCreate :

Veillez à affecter cette stratégie d’expérience de connexion à distance Windows 365 à des groupes d’appareils (PC cloud), et non à des groupes d’utilisateurs.

La redirection basée sur le contexte étant appliquée au niveau de l’appareil, l’attribution de la stratégie aux utilisateurs n’applique pas le comportement de redirection attendu.

Source : Context-based redirections (Preview) — Microsoft Learn

Et sur AVD ?

Pas de RCE policy : la liaison se fait dans les propriétés RDP du host pool. Dans l’onglet Device redirection, au lieu d’un toggle activé/désactivé, vous choisissez « Dynamically configure using authentication context » et sélectionnez le contexte. La logique d’évaluation à la connexion est la même qu’en Windows 365.

9. Pièges & retour terrain

Le piège qui m’a rendu fou : la persistance du token Windows App : Windows App garde un token de session en cache. Tant que ce token vit, le résultat du step-up c1 (présent ou absent) est figé dedans. Vous pouvez changer la CA et la RCE mille fois, la session en cours ne réévalue rien. Il faut un token frais : vraie déconnexion/reconnexion. Ne perdez pas trois heures comme moi à modifier des policies : reconnectez-vous avec une session neuve.
  • Client non supporté : avec mstsc / Bureau à distance legacy, c1 n’est jamais demandé. Passez par Windows App.
  • Assignation RCE sur des users : la RCE/context-based s’applique au device. Assignée à un groupe d’utilisateurs, elle ne fait rien. Groupe de devices (Cloud PC) obligatoire.
  • « Publish to apps » oublié sur le contexte d’authentification → c1 jamais sollicité → CA « Not Applied ».
  • Restrictions par défaut non débrayées → « most restrictive wins » → la redirection reste coupée quoi que vous fassiez.
  • Direction du clipboard : le binding porte sur une direction précise (ex. « clipboard local disponible dans la session distante » = copie sur votre PC → colle DANS le Cloud PC). Testez bien la direction que vous avez liée à c1.
  • Propagation lente : comptez quelques minutes côté CA, et au premier déploiement la RCE peut nécessiter un redémarrage du Cloud PC avant d’être prise en compte.

10. Conclusion

Voilà, comment en 4 étapes, on est passé d’un Cloud PC tout neuf à une redirection dynamique qui s’adapte à la confiance de la connexion. Concrètement, ça donne quoi ? Un seul host pool / une seule conf, et la redirection (presse-papiers, lecteurs, mais aussi imprimante et USB sur exactement le même modèle) qui s’ouvre pour les machines conformes (ou sur le bon réseau) et qui se ferme pour le reste.

Le rêve du BYOD sans compromis. J’ai testé le clipboard et les lecteurs, mais gardez bien en tête que les quatre redirections se pilotent à l’identique : c’est la même mécanique de bout en bout.

Foncez tester en lab, c’est clairement l’une des évolutions sécurité les plus utiles de l’année sur AVD / Windows 365. Einfin pour aller plus loin : quelques lectures qui complètent bien le sujet, et que je vous recommande :

Nerdio simplifie FSLogix

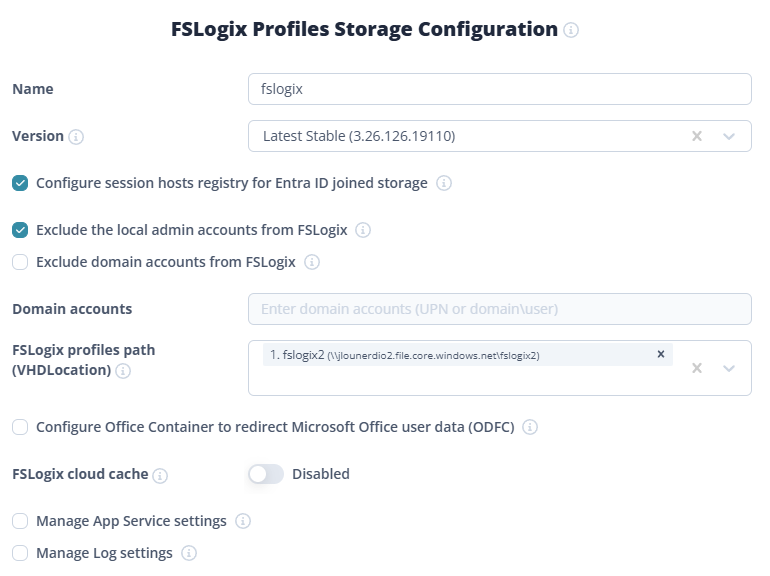
Vous avez déployé Nerdio Manager for Enterprise (peut-être en suivant mon article précédent), vous avez coché en passant « FSLogix Profiles Storage Configuration » dans le wizard, mais vous n’avez jamais vraiment creusé ce que Nerdio fabrique derrière ? Cette suite logique est pour vous. On va dérouler, étape par étape, ce que Nerdio fait à votre place sur FSLogix et surtout ce que vous auriez à faire à la main sans lui. Parce que FSLogix, c’est probablement la brique d’AVD qui génère le plus de tickets support, et ça vaut la peine de comprendre pourquoi Nerdio fait baisser ce volume.

Pour vous guider plus facilement dans cet article, voici des liens rapides :

1. Pourquoi FSLogix à la main, c’est pénible

Avant d’entrer dans Nerdio, faisons l’inventaire de ce qu’il faut faire pour avoir un FSLogix qui tourne proprement sur un host pool AVD Entra-only. La liste, que vous pouvez retrouver dans cet article, se décompose dans cet ordre :

  1. Provisionner un storage account
  2. Activer l’authentification Entra Kerberos
  3. Grant admin consent
  4. Exclure cette app des policies Conditional Access MFA
  5. Créer le file share
  6. Distribuer les rôles RBAC
  7. Régler les ACL NTFS
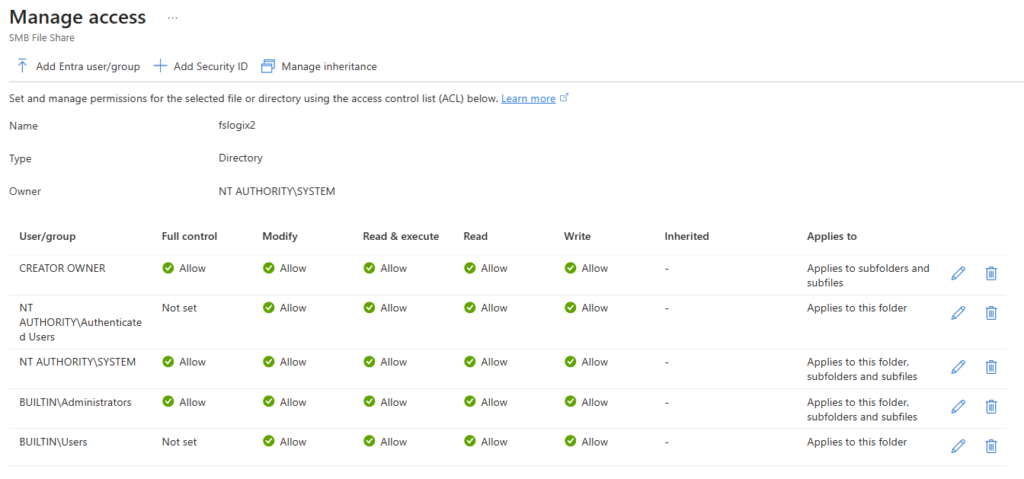
  8. Pousser les clés registry FSLogix
  9. Maintenir tout ça dans le temps
Mon retour terrain : à la main, comptez une bonne demi-journée pour un déploiement propre, plus le temps de débuggage des permissions NTFS qui vient quasi systématiquement. L’étape 7 (ACL NTFS) est celle qui génère le plus de tickets support sur tout AVD. Une fausse manip d’héritage et vous y passez la journée d’anniversaire de votre fils.

Maintenant, voyons ce que Nerdio peut faire pour vous.

2. Le wizard Create Azure Files Share

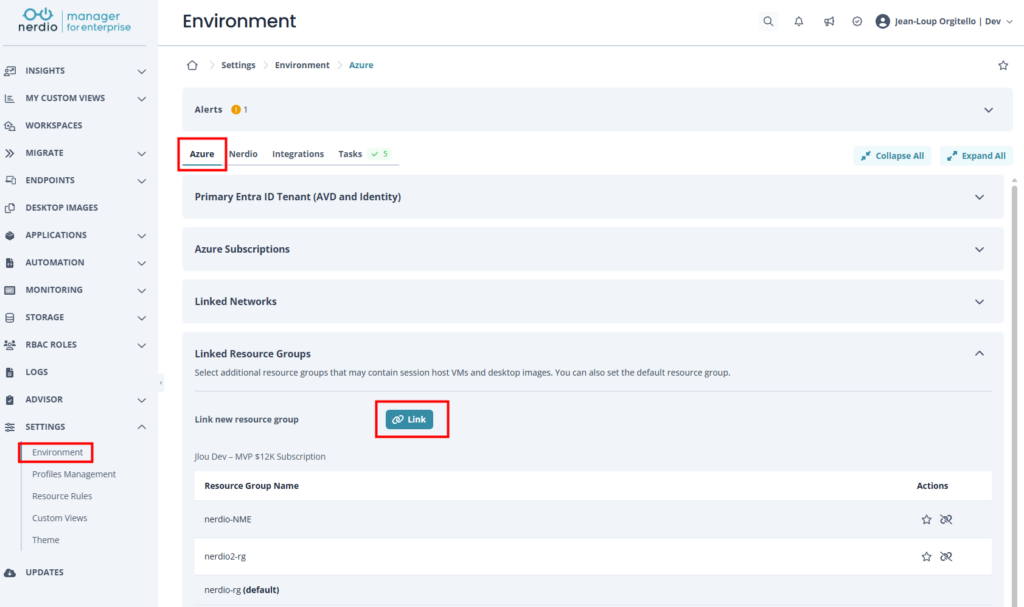
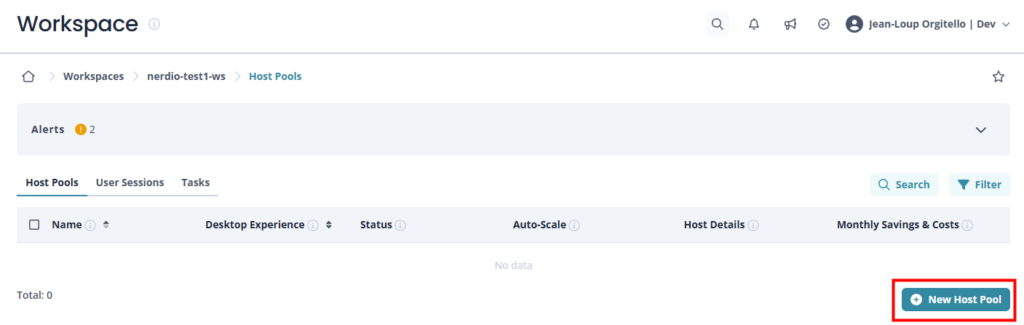
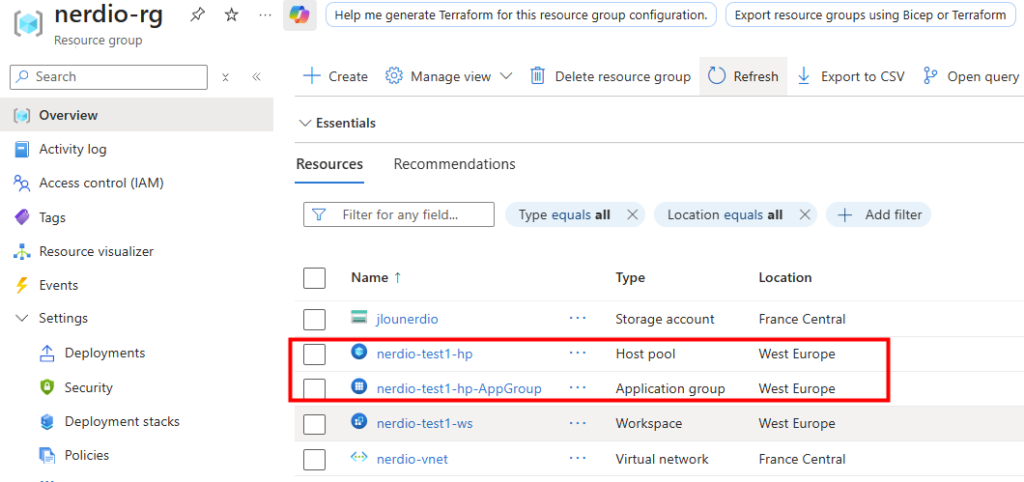
Avant toute chose, je vous conseille de créer le groupe de ressources sur le portail Azure, puis de lier ce dernier dans votre console Nerdio :

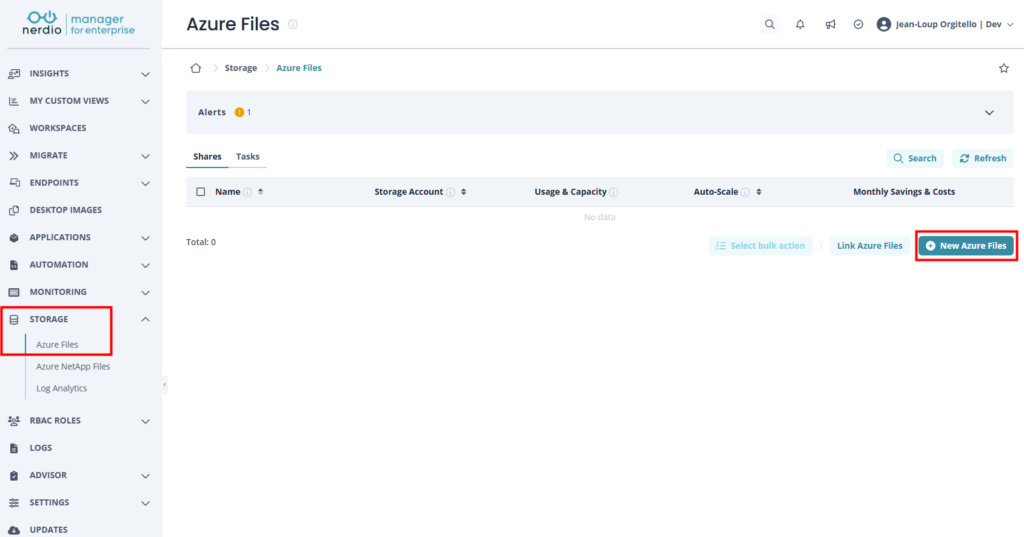
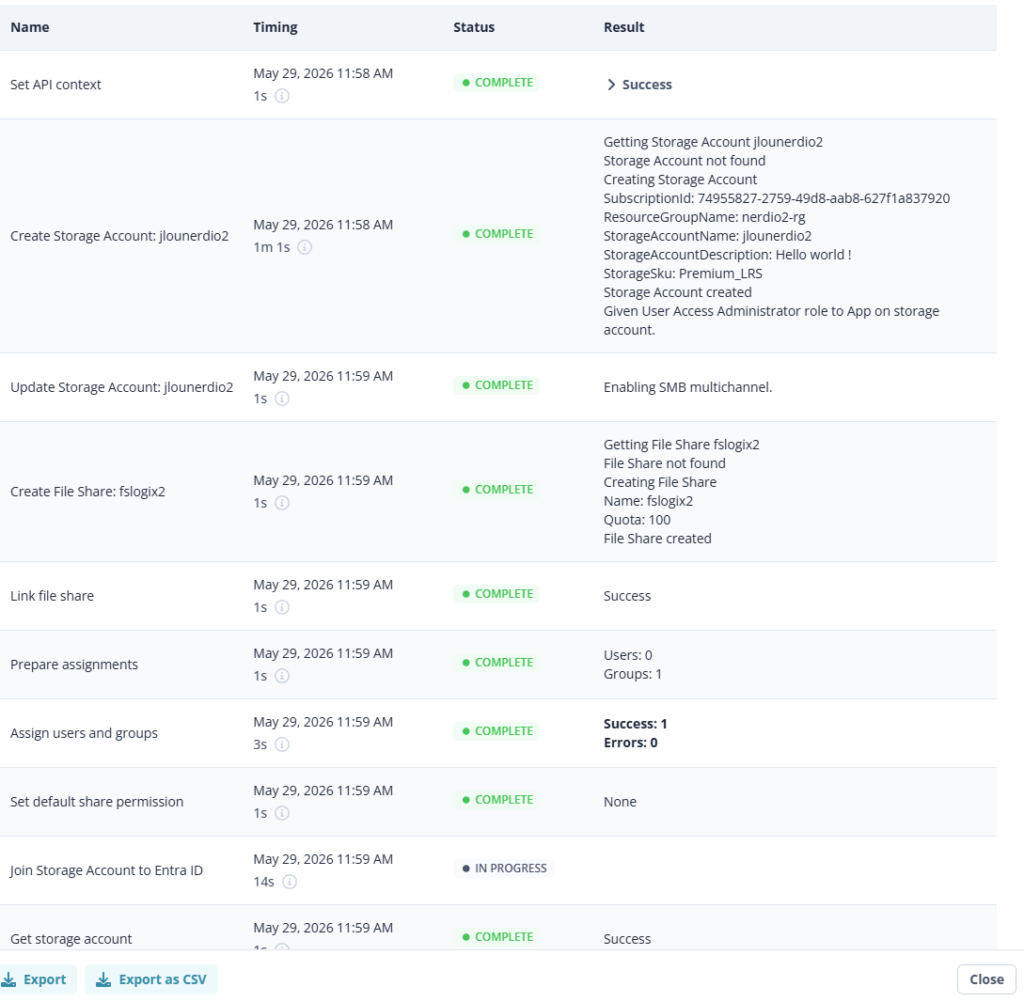
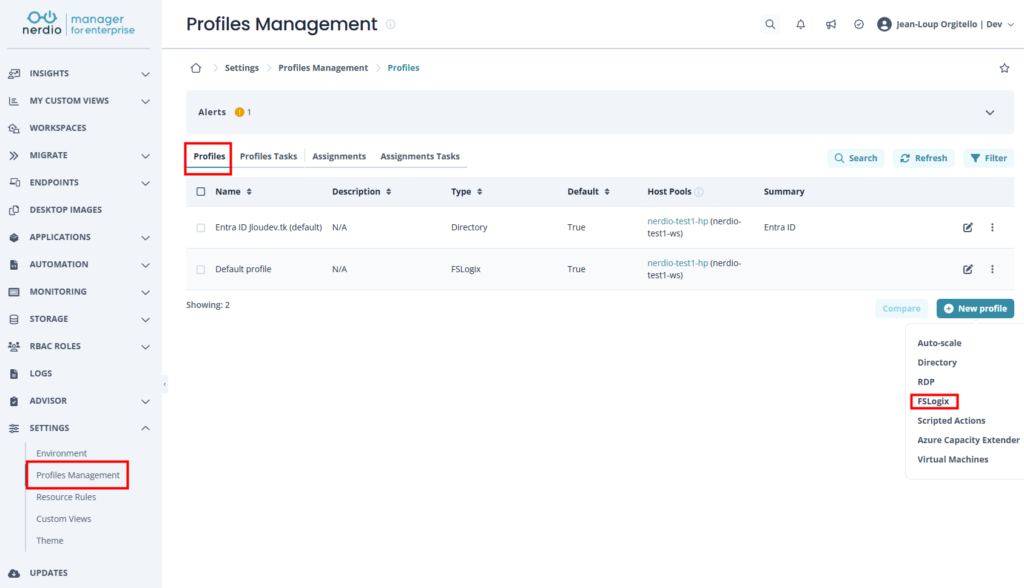
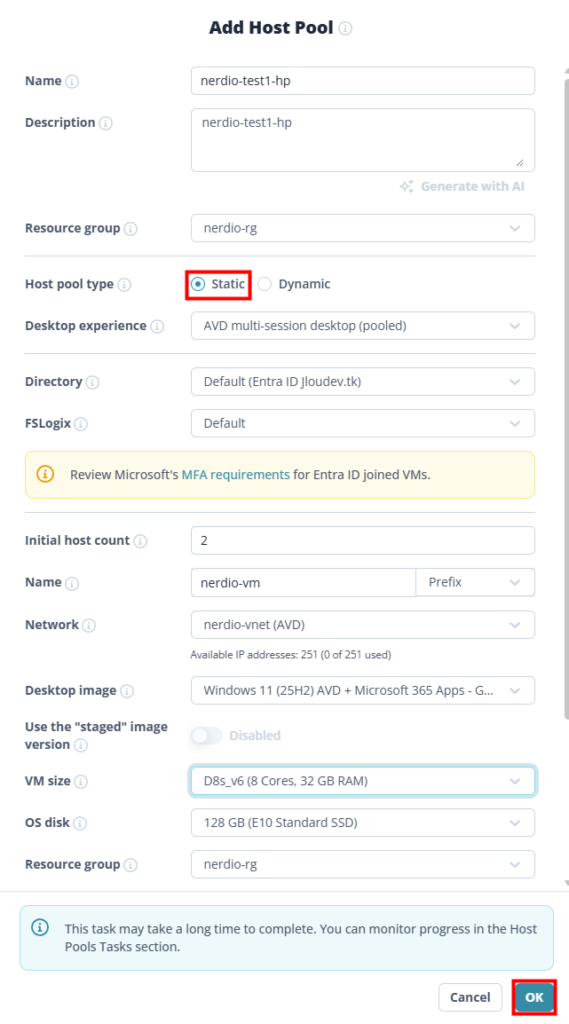
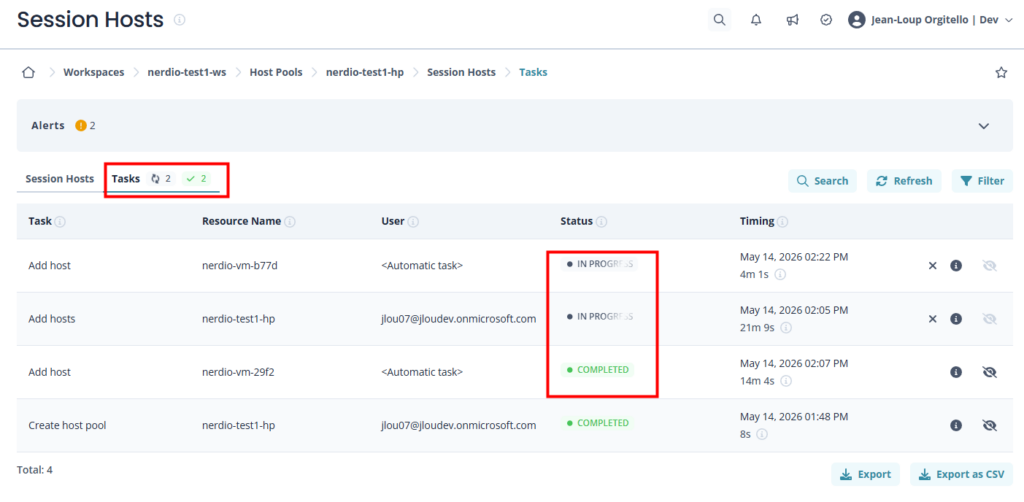
Dans Nerdio, direction Settings → FSLogix Profiles → Add Azure Files Share. Vous avez le choix entre pointer un storage account existant ou laisser Nerdio créer le share complet, du SA jusqu’aux ACL NTFS. Et oui, ça inclut le scénario Entra ID joined, c’est ce qu’on va dérouler ensemble :

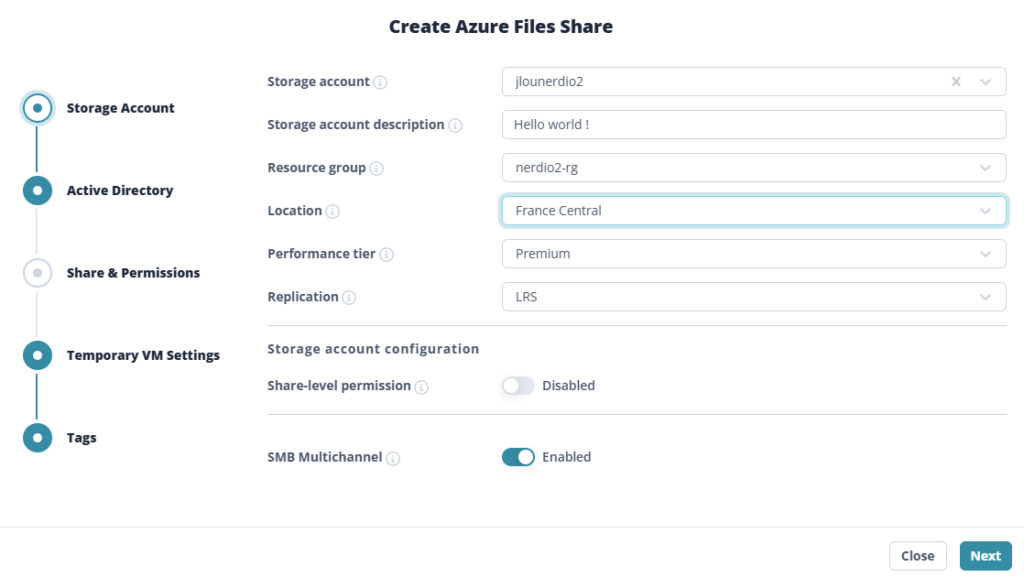
Le wizard se passe en seulement 5 étapes :

Étape 1 : Storage Account

Nom du SA, resource group, région, SKU (Standard ou Premium Files), réplication. Rien d’extraordinaire, mais tout se passe dans une seule fenêtre Nerdio plutôt que de naviguer dans quatre blades Azure différentes.

Étape 2 : Active Directory ou Entra ID

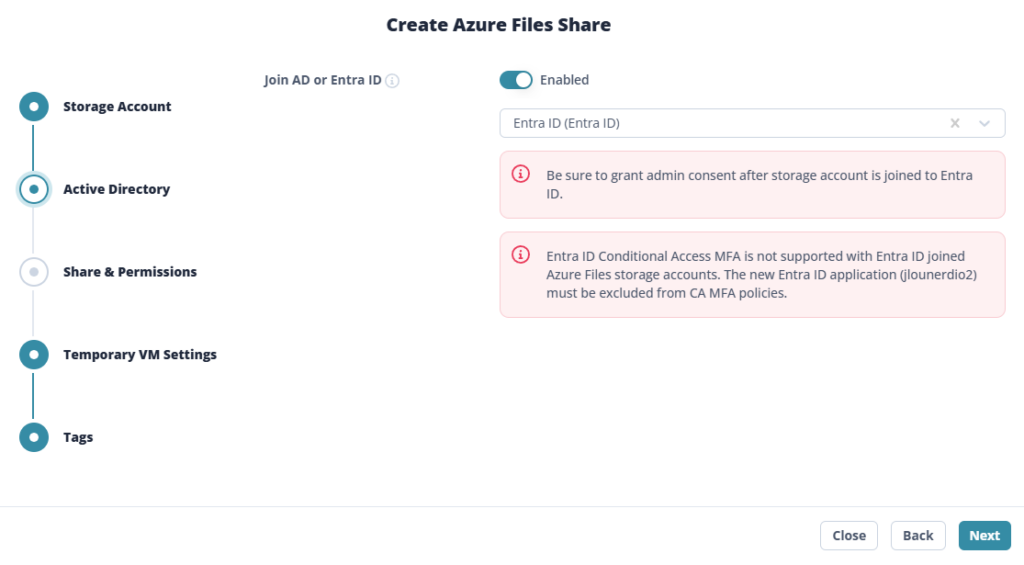
L’étape clé. Vous activez le toggle Join AD or Entra ID, puis vous choisissez Entra ID dans la liste déroulante. Et là, Nerdio vous met deux warnings honnêtes que vous devez lire avant de cliquer Next :

Attention : Nerdio vous prévient sur deux points avant de valider :

⚠️ Be sure to grant admin consent after storage account is joined to Entra ID.
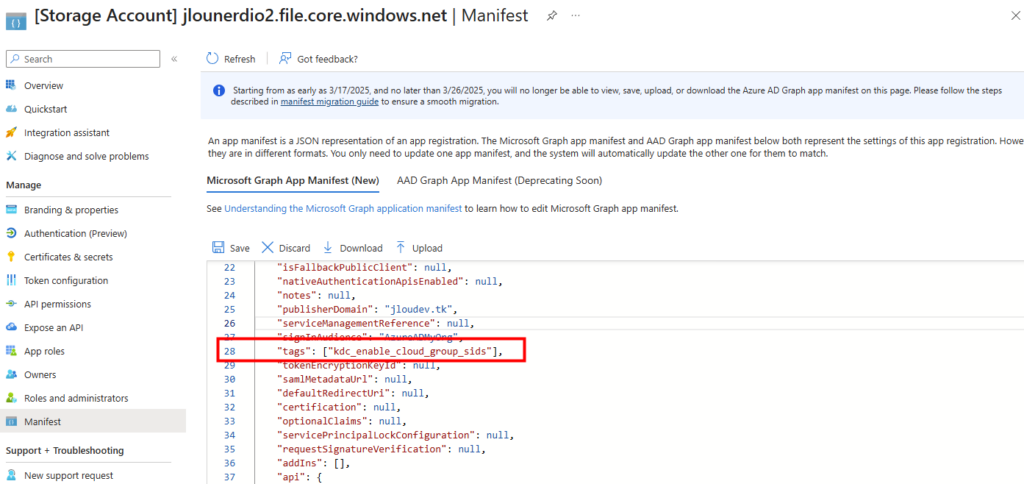
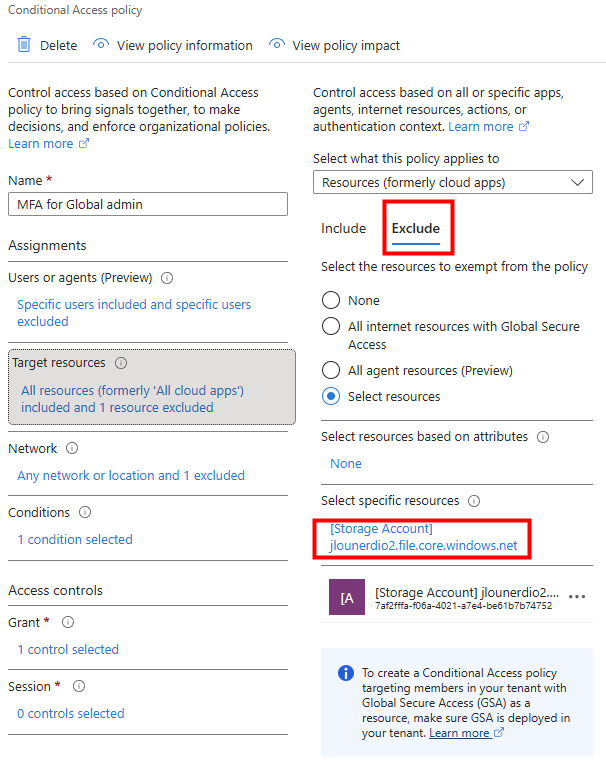
⚠️ Entra ID Conditional Access MFA is not supported with Entra ID joined Azure Files storage accounts. The new Entra ID application must be excluded from CA MFA policies.

Ce sont les deux seules manips qu’il vous restera à faire à la fin. Nerdio s’occupe du reste : création de l’app registration, configuration Entra Kerberos sur le storage, le tout en une seule passe.

Étape 3 : Share & Permissions

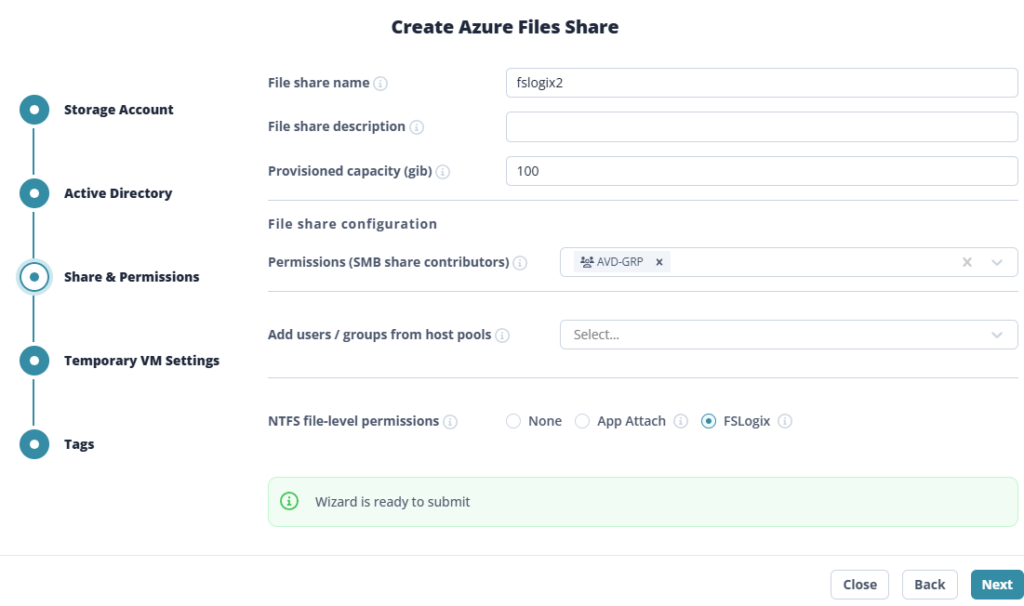
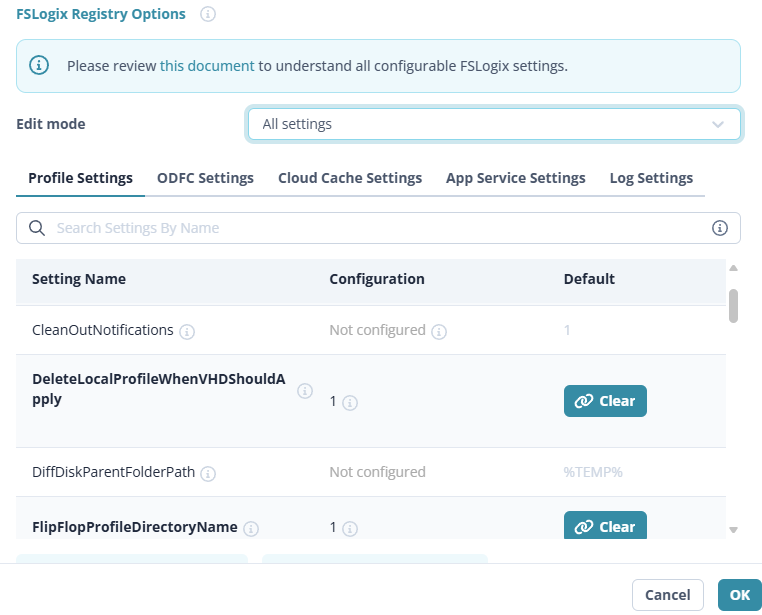
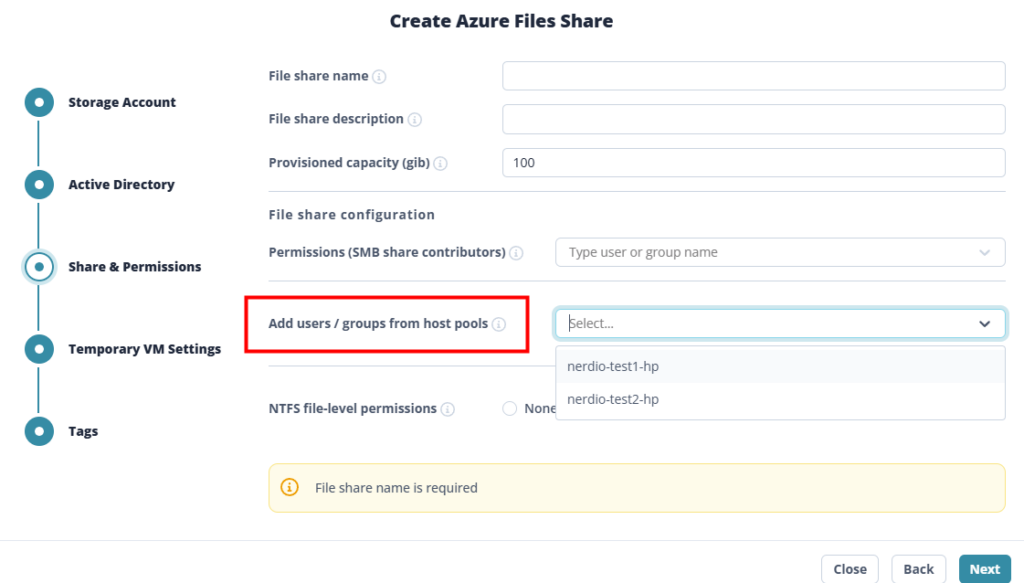
Vous donnez un nom au share, sa capacité (entre 100 GB et 100 TB), et vous attribuez les rôles RBAC SMB Share Contributor aux groupes Entra ID concernés. Mais surtout, et c’est là le gros gain, vous avez un dropdown NTFS Permission Preset avec une option FSLogix.

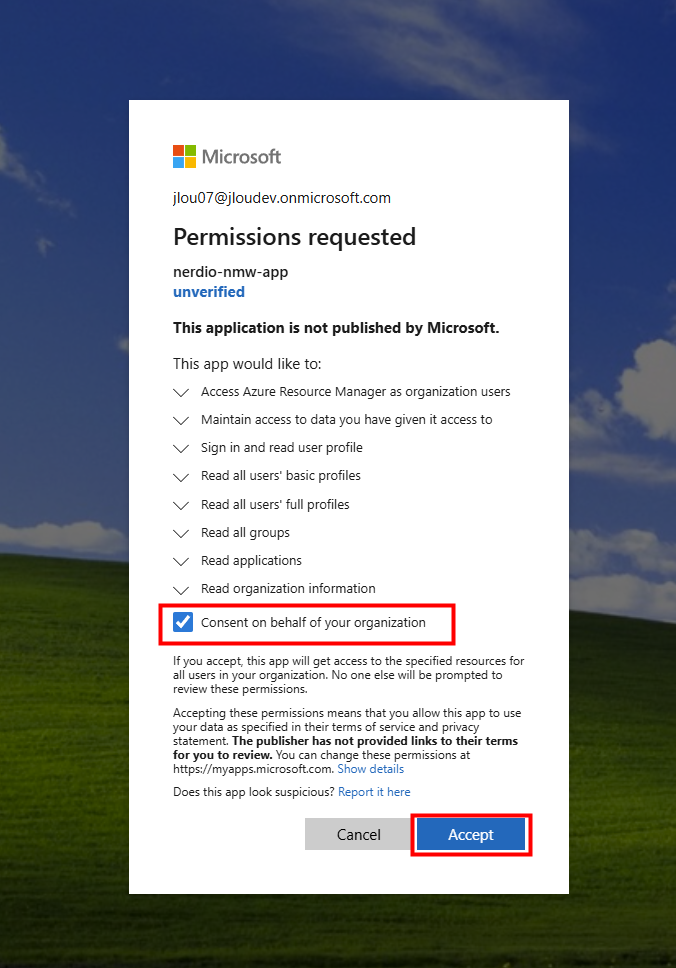
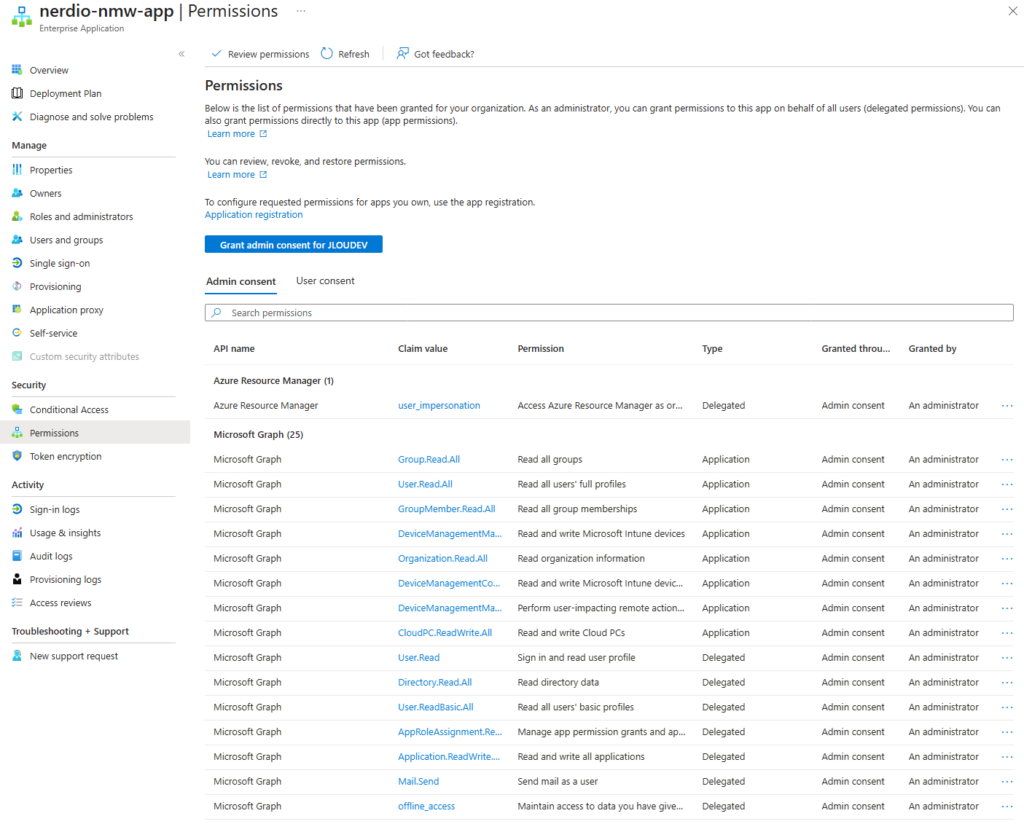
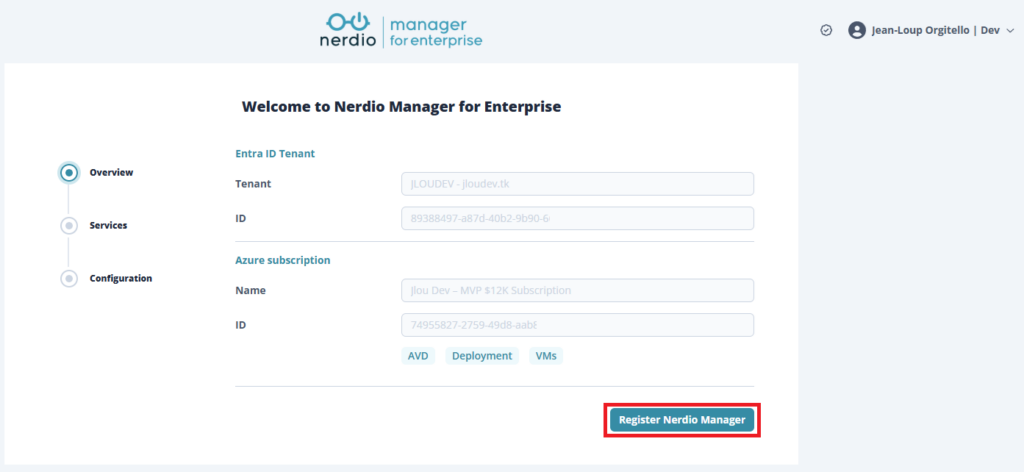
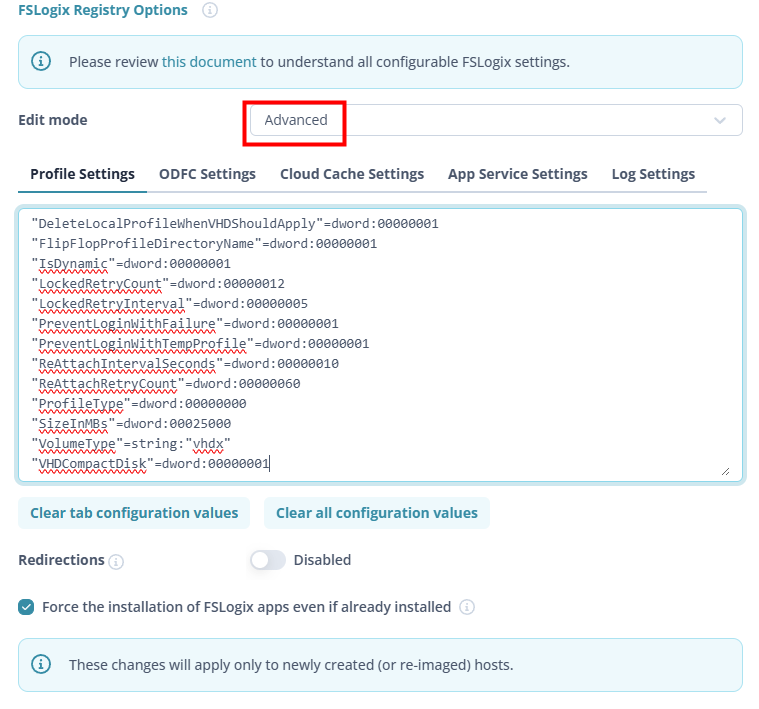
Ce preset, c’est exactement la combinaison Authenticated Users / CREATOR OWNER / Administrators de la section 1, avec les bons héritages.

Bonus sécurité : la case Limit access to specific host pools vous permet de restreindre ce share à un ou plusieurs host pools précis. Pratique si vous avez plusieurs environnements (prod, dev, RH, finance…) et que vous voulez éviter qu’un host pool puisse écrire dans le profil d’un autre.

Étape 4 : Temporary VM Settings

Pour appliquer les ACL NTFS et finaliser le join, Nerdio doit mount le share quelque part. Il monte donc une VM temporaire dans votre vNet le temps de la config, puis la supprime automatiquement.

Vous renseignez ici la taille de VM (le défaut B2s suffit), le subnet et éventuellement l’image. C’est cette VM qui va faire le icacls du preset FSLogix sur le share, donc gardez bien le subnet AVD ou un subnet qui peut joindre le storage.

Étape 5 : Tags

Classique. Submit.

Le déploiement commence alors, et toutes les étapes sont indiquées dans le log :

  • Sur le portail Azure, on retrouve la machine virtuelle temporaire créée pour l’occasion :
  • Une fois le traitement terminé, toutes les étapes sont bien détaillées dans le log :
  • Le statut du compte de stockage est également visible dans le portail Azure :
  • Et la configuration de la gestion identitaire Entra Kerberos est faite :
  • Dans Entra, l’app registration est bien créée :
  • Les ACL de base sont bien appliquées (un durcissement des héritages NTFS reste possible si votre politique de sécurité l’exige) :
  • À l’issue de l’opération, la machine virtuelle temporaire se détruit automatiquement :

À la fin du traitement, trois actions restent à votre charge :

  • Allez dans Entra ID → Enterprise Applications, ouvrez la nouvelle app qui porte le nom de votre storage account, et cliquez sur Grant admin consent for [tenant].
  • Ajoutez également la prise en charge des groupes dans le manifeste de l’app :
  • Si vous avez des Conditional Access policies MFA, ajoutez cette app dans la liste d’exclusion :

C’est tout. Comparez avec la liste de la section 1 : on est passé de 9 étapes à 3 manips de 30 secondes.

3. Les FSLogix Profiles : templates réutilisables

Voilà la deuxième brique qui change la vie : les FSLogix Profiles au sens Nerdio du terme, à ne pas confondre avec les profils utilisateurs FSLogix !

Dans Settings → FSLogix, vous créez un profil, c’est-à-dire un template de configuration FSLogix, que vous pourrez ensuite appliquer à n’importe quel host pool.

Concrètement :

  1. Nom du profil : par exemple « Standard AVD Users » ou « Power Users with bigger profiles ».
  2. Excluded users group : un groupe Entra ID dont les membres ne seront PAS soumis à FSLogix. Best practice : y mettre vos admins. Comme ça, si FSLogix casse, vos admins peuvent toujours se logger en profil local et venir réparer.
  3. Profile path : un dropdown qui vous propose tous les shares que vous avez créés à l’étape précédente. Vous n’avez plus à retaper le path UNC à la main.
  4. Office Container (ODFC) : checkbox pour activer le container Office séparé. Honnêtement, dans la grande majorité des cas AVD vous n’en avez pas besoin (j’y reviens en section 5).
  5. Cloud Cache : à laisser de côté sauf scénario multi-région avec DR actif-actif.

Toujours sur l’écran de configuration FSLogix, vous tombez sur la vraie matrice des réglages FSLogix. Et là, Nerdio fait deux choses qui valent la mention.

  • Les eye icons. Chaque setting a une petite icône œil que vous pouvez survoler pour avoir la description complète de la clé registry correspondante. Plus besoin d’aller chercher dans la doc Microsoft à chaque fois. C’est bête mais c’est ce qui transforme FSLogix d’un truc obscur en quelque chose de réellement administrable.
  • Les valeurs par défaut « Not configured ». Tant que vous ne touchez pas, Nerdio ne pousse rien sur cette clé : la valeur par défaut FSLogix est utilisée. Vous ne tunez que ce que vous voulez vraiment changer, ce qui rend votre conf lisible.

Les best practices que je pousse personnellement (et qui sont presque toutes pré-suggérées par Nerdio) :

RéglageValeurPourquoi
DeleteLocalProfileWhenVHDShouldApplyEnabledSur un environnement neuf, ça évite l’accumulation de profils locaux qui se baladent à côté des VHDX. À ne PAS activer si vous migrez depuis une infra existante avec des profils locaux à préserver.
FlipFlopProfileDirectoryNameEnabledMet le username AVANT le SID dans le nom du folder. Indispensable pour s’y retrouver quand vous cherchez le profil d’un user dans le share.
VolumeTypeVHDXDisque dynamique, grandit au fil du temps. Sur Standard Files, c’est ce qui vous évite de réserver 30 Go par user dès le premier login.
IsDynamicEnabledIdem, le VHDX commence à quelques Mo et grandit en fonction de l’usage réel.
LockedRetryCount / LockedRetryIntervalDéfauts, à augmenter si réseau capricieuxSi le VHD est temporairement locké (réseau qui tousse, session précédente qui ne s’est pas fermée proprement), FSLogix réessaye au lieu de filer un profil temp.
PreventLoginWithFailureEnabledSi FSLogix n’arrive pas à monter le profil, l’utilisateur est BLOQUÉ au login plutôt que de se retrouver sur un profil temporaire. Préférable : un user qui appelle le support > un user qui bosse 4 h sur un profil qui sera jeté au logoff.
PreventLoginWithTempProfileEnabledMême logique, ceinture et bretelles.
ProfileType0Mount sur un seul host à la fois. Le multi-mount (type 3) est une plaie à débugger, à n’activer que si vous avez vraiment besoin.
SizeInMBs30000 (30 GB)Plafond raisonnable. Tracez les profils qui s’en approchent dans le monitoring (section 7).
Compression au logoffEnabledÀ chaque logoff, FSLogix compacte le VHDX. Vous économisez pas mal de stockage à long terme.

Et pour les puristes : le mode Advanced vous laisse taper directement les clés FSLogix par nom et valeur si vous voulez configurer quelque chose qui n’est pas exposé dans l’UI. Nerdio ne vous enferme pas :

"DeleteLocalProfileWhenVHDShouldApply"=dword:00000001
"FlipFlopProfileDirectoryName"=dword:00000001
"IsDynamic"=dword:00000001
"LockedRetryCount"=dword:00000012
"LockedRetryInterval"=dword:00000005
"PreventLoginWithFailure"=dword:00000001
"PreventLoginWithTempProfile"=dword:00000001
"ReAttachIntervalSeconds"=dword:00000010
"ReAttachRetryCount"=dword:00000060
"ProfileType"=dword:00000000
"SizeInMBs"=dword:00025000
"VolumeType"=string:"vhdx"
"VHDCompactDisk"=dword:00000001

Une fois le profil créé, vous cliquez sur les trois points → Set as default :

À partir de là, chaque nouveau host pool que vous créez héritera de cette config FSLogix automatiquement. Et bien sûr, vous pouvez override par host pool si vous avez besoin d’une config différente quelque part.

C’est ça le vrai gain par rapport à une approche GPO : ce que vous configurez une fois s’applique partout, sans recréer une GPO ni modifier votre image golden.

4. La config qui descend toute seule sur les session hosts

À la création (ou à la mise à jour) d’un host pool, Nerdio injecte la conf FSLogix via ses Scripted Actions au boot des session hosts :

Comme c’est magnifique, et tellement simple :

Les machines virtuelles sont bien visibles dans le pool d’hôtes :

Concrètement :

  • Pas besoin de GPO
  • Ça marche sur des hosts Entra-only ou joints à un domaine AD
  • Ça s’applique aussi bien sur les hosts existants que sur les nouveaux (auto-scale, re-image)

Si vous allez voir le registre d’un session host après le déploiement :

  • La version de FSLogix correspond à celle demandée :
  • Vous retrouverez bien tout sous HKLM\SOFTWARE\FSLogix\Profiles, mais cette fois sans que vous ayez touché à un seul reg add ni à une GPO :

Et bien sûr, le profil VHDX se crée au premier démarrage de l’utilisateur :

Mon retour terrain : si vous changez la config dans le FSLogix Profile Nerdio, vous pouvez redéployer la conf sur tous les hosts d’un host pool en un clic, sans rebuilder l’image. Nerdio relance simplement le Scripted Action sur chaque host. C’est l’inverse du modèle « je rebuild mon image dorée à chaque tuning FSLogix » qu’on voyait avec les GPO.

5. Exclusions, redirections.xml, ODFC, Cloud Cache

Exclusions registry. Toujours dans le FSLogix Profile, vous avez un onglet Profile Exclusions où vous gérez la liste des dossiers et fichiers que FSLogix doit ignorer (typiquement les caches Teams, les logs, les téléchargements). C’est l’équivalent de la clé HKLM\SOFTWARE\FSLogix\Profiles\Exclude List, mais éditable depuis une UI au lieu d’un import de fichier .reg.

Redirections.xml. Pareil, Nerdio gère l’upload et la synchronisation du redirections.xml sur le share. Vous le modifiez dans Nerdio, il est poussé automatiquement au prochain mount des profils.

Office Container (ODFC). Comme dit en section 3, dans la majorité des cas AVD vous n’en avez pas besoin. La doc Microsoft elle-même recommande de NE PAS mélanger Profile Container et ODFC sauf cas particulier (par exemple OneDrive en mode Files On-Demand avec beaucoup de fichiers). Si vous l’activez, comptez doubler la complexité de troubleshooting.

Cloud Cache. Outil puissant pour faire du multi-storage avec basculement automatique, mais à réserver aux scénarios DR actif-actif ou multi-région avec une vraie contrainte de continuité de service. Sur un host pool en région unique, Cloud Cache n’apporte rien que le Profile Container standard ne fasse déjà.

6. Multi-storage et scoping par host pool

Pour les déploiements qui grossissent, deux features valent le coup d’être mentionnées.

Plusieurs locations FSLogix. Vous pouvez déclarer plusieurs shares dans Nerdio (même un Azure NetApp Files si vous en avez un) et les pointer depuis différents FSLogix Profiles. Pratique pour séparer prod et dev, ou pour des shares dédiés par département.

Scoping par host pool. Souvenez-vous de la case Limit access to specific host pools à l’étape Share & Permissions (section 2). Couplée aux FSLogix Profiles par host pool, ça vous permet d’avoir une isolation stricte : un host pool « Finance » ne peut pas écrire dans le share « RH », et inversement. Tout ça géré dans la même UI, sans pondre des RBAC complexes à la main.

7. Monitoring et cleanup des profils orphelins

Plusieurs features moins glamour, mais qui paient leur licence Nerdio sur le long terme.

  • Monitoring des tailles de profil : Nerdio remonte pour chaque session active la taille du VHDX du user. Vous voyez tout de suite les profils qui gonflent (typiquement les boîtes OST Outlook, les caches Teams mal nettoyés). Vous pouvez tirer des alertes là-dessus.
  • Auto-Scale du file share : Manage Auto-Scale for FSLogix permet d’automatiser le dimensionnement des ressources et la gestion des profils utilisateurs afin d’assurer performance et optimisation des coûts sans intervention manuelle, de la même façon que mon article sur la méthode scriptée dans Azure :
  • Cleanup des profils orphelins : Nerdio propose une Scripted Action prête à l’emploi qui scanne votre share FSLogix, compare la liste des folders aux users existants dans Entra ID, et supprime les VHDX des users qui n’existent plus (départs, comptes supprimés). Vous la planifiez en récurrent (une fois par mois par exemple) et vous oubliez.

À la main : il faut écrire le script PowerShell, le planifier (Automation Account, Function App, ou serveur dédié), le maintenir quand l’API Graph change. Avec Nerdio : checkbox + planification.

8. Verdict

Si vous gérez un seul host pool sur une infra stable, FSLogix à la main reste tenable et vous payez l’effort une fois, vous oubliez. Mais dès que vous avez :

  • Plusieurs host pools avec des configs FSLogix différentes,
  • Des changements de conf réguliers (ajout d’exclusions, redirections, tuning),
  • Du multi-département avec isolation des profils,

… Nerdio paye sa licence rien que sur la partie FSLogix. La création du share avec preset NTFS, le push de la conf au boot, le monitoring et le cleanup, c’est plusieurs jours de travail PowerShell que vous n’avez plus à faire ni à maintenir.

Voilà, en 8 sections vous avez fait le tour de ce que Nerdio fait pour vous sur FSLogix. Concrètement, ça donne quoi ? Vos tickets support « profil temporaire » devraient chuter de manière significative. Ce qui, dans la vie d’un admin AVD, n’a pas de prix.

Foncez tester en lab : le wizard Create Azure Files Share en mode Entra-joined, c’est cinq minutes à dérouler, et vous verrez tout de suite la différence avec le manuel. Prochain article de la série : on attaquera l’auto-scaling avec Nerdio, l’autre grande raison de payer cette licence (et la moins évidente à découvrir tout seul).

Autoscalez le stockage FSLogix

Un dimanche soir, votre stockage FSLogix sature, et personne ne le voit. Lundi matin, vos 200 utilisateurs AVD n’arrivent plus à se connecter car leur profil ne se charge plus. Que faire en ce moment d’urgence ? Vous découvrez en urgence que provisionner un share Azure avec « 8 To au cas où » , ça vous coûte un bras et demi. Ce mauvais rêve vous parle ou vous empêche de dormir ? Cet article est fait pour vous.

On va très rapidement remonter l’histoire d’Azure Files, comprendre pourquoi Provisioned v2 (GA depuis 2025) change la donne pour les workloads FSLogix, et surtout déployer ensemble, depuis Azure Cloud Shell, en moins de 5 minutes, une solution open-source qui fait grossir automatiquement le quota quand l’usage approche la saturation, avec des notifications mail à la clé.

Pour vous guider plus facilement dans cet article, voici des liens rapides :

1. Petit rappel : Azure Files, d’où on vient

Plusieurs articles ont déjà été écrits sur le sujet du stockage dans Azure :

Mais pour rappel, jusqu’ici Azure Files se déclinait essentiellement en deux familles :

  • Standard (HDD) en pay-as-you-go : pas cher, performances modestes, facturation peu prédictible (capacité utilisée + transactions).
  • Premium (SSD) en provisioned : les IOPS et le throughput étaient dérivés mécaniquement de la capacité provisionnée. Vous vouliez 50 000 IOPS ? Vous provisionniez des To de capacité, que vous les remplissiez ou non.
AttributeSSD approvisionné v1HDD, paiement à l’utilisation
La taille minimale de stockage100 Gio (approvisionné)0 octets
Taille de stockage maximale100 Tio100 Tio
Nombre maximal de fichiersUnlimitedUnlimited
Nombre maximal d’E/S par seconde (données)102 400 IOPS (dépendant de l’approvisionnement)20 000 IOPS
Débit maximal10 340 Mio /s (dépendant de l’approvisionnement)Jusqu’aux limites du compte de stockage
Microsoft Learn

Bursting v1 approvisionné :

Capacité (Gio)IOPS de référenceIOPS en rafaleLister les créditsDébit (Mio/s)
1003 100Jusqu’à 10 00024 840 000110
5003 500Jusqu’à 10 00023 400 000150
1 0244 024Jusqu’à 10 00021 513 600203
5 1208 120Jusqu’à 15 36026 064 000613
10 24013 240Jusqu’à 30 72062 928 0001 125
33 79236 792Jusqu’à 102 400227 548 8003 480
51 20054 200Jusqu’à 102 400164 880 0005 220
102 400102 400Jusqu’à 102 400010 340
Microsoft Learn

Ce dernier point a été le casse-tête FSLogix pendant des années. Sur un share AVD, vous n’avez pas spécialement besoin de 5 To de capacité, mais vous avez besoin de pouvoir encaisser une sign-in storm à 8 h le matin.

Sur du Premium V1, pour atteindre les IOPS nécessaires, vous étiez obligé de surprovisionner la capacité. Vous payiez alors de l’espace que vous n’utilisiez pas, contrairement au HDD pay-as-you-go.

Et si vous étiez tenté par le HDD pay-as-you-go pour dormir tranquille : à la place d’un long discours, voici une image qui a dû faire mal à de nombreux administrateurs d’AVD :

Mon retour terrain : sur la quasi-totalité des projets AVD que j’ai vus, le calcul de sizing FSLogix se faisait « en IOPS » et la capacité était une conséquence. Résultat : des shares à 2-4 To remplis à 30 %, payés plein pot.

2. L’arrivée de Provisioned v2

Provisioned v2 est GA depuis 2025, dans toutes les régions publiques Azure et toutes les régions Azure US Government. La grande nouveauté : on provisionne trois axes indépendants.

Le modèle v2 provisionné pour Azure Files associe la prévisibilité du coût total de possession à la flexibilité, vous permettant ainsi de créer un partage de fichiers qui répond précisément à vos exigences en matière de stockage et de performances.

Lorsque vous créez un partage de fichiers v2 approvisionné, vous spécifiez la quantité de stockage, d’IOPS et de débit dont votre partage de fichiers a besoin.

Source : Understand Azure Files billing — Microsoft Learn

Concrètement, vous payez trois choses séparément, même si certaines limites existent :

  • La capacité provisionnée (GiB)
  • Les IOPS provisionnés
  • Le throughput provisionné (MiB/s)

Et deux SKUs sont disponibles en v2 avec des redondances spécifiques :

  • Premium V2 (SSD) : LRS ou ZRS
  • Standard V2 (HDD) : LRS, ZRS, GRS ou GZRS

Voici d’ailleurs les limites officielles à connaître :

DimensionPremium V2 (SSD)Standard V2 (HDD)
Capacité min32 GiB32 GiB
Capacité max256 TiB256 TiB
IOPS min3 000500
IOPS max102 40050 000
Throughput min100 MiB/s60 MiB/s
Throughput max10 340 MiB/s5 120 MiB/s
Unité de provisioning1 GiB1 GiB
Microsoft Learn

Deux subtilités utiles à connaître :

  • Cooldown 24 h sur la descente : on peut augmenter le quota n’importe quand, mais on ne peut le diminuer qu’après 24 h sans changement.
  • Burst IOPS credit-based : sur SSD, le burst max est MIN(MAX(3 × ProvisionedIOPS, 10 000), 102 400). Pratique pour absorber les pics ponctuels sans surprovisionner.

Bursting v2 approvisionné :

IOPS provisionnéesLimite d’IOPS en rafale SSDCrédits de rafale SSDLimite de l’IOPS en mode bursting de disque de l’HDDCrédits de bursting de disque de l’HDD
500Jusqu’à 5 00016 200 000
1 000Jusqu’à 5 00014,400,000
3 000Jusqu’à 10 00025,200,000Jusqu’à 9 00021 600 000
5 000Jusqu’à 15 00036 000 000Jusqu’à 15 00036 000 000
10 000Jusqu’à 30 00072 000 000Jusqu’à 30 00072 000 000
25 000Jusqu’à 75 000180,000,000Jusqu’à 50 00090 000 000
50 000Jusqu’à 102 400188,640,000Jusqu’à 50 0000
75 000Jusqu’à 102 40098,640,000
102 400Jusqu’à 102 4000
Microsoft Learn

3. FSLogix : ce que Microsoft recommande vraiment

Côté FSLogix, la doc Microsoft Learn pose deux chiffres très concrets, par utilisateur :

Profil de chargeIOPS par utilisateur
Steady state (utilisation normale en cours de journée)10
Sign-in / Sign-out (ouverture ou fermeture de session)50

L’exemple de ce tableau est celui d’un utilisateur unique, mais il peut être utilisé pour estimer les besoins relatifs au nombre total d’utilisateurs dans votre environnement. Par exemple, vous avez besoin d’environ 1 000 IOPS pour 100 utilisateurs et environ 5 000 IOPS lors de la connexion et de la déconnexion.

Source : Container storage options — FSLogix — Microsoft Learn

Projetons ça sur quelques tailles d’environnement classiques :

UsersIOPS steady (×10)IOPS pic sign-in (×50)
505002 500
2002 00010 000
5005 00025 000
1 00010 00050 000

Côté capacité, Microsoft ne fixe pas de chiffre dur officiel par utilisateur, ça dépend des applis, d’Outlook (qui crée souvent les plus gros .OST), de OneDrive Known Folder Move, etc.

Sur la majorité des environnements AVD que j’ai croisés, on tourne entre 5 et 30 GiB par profil, avec une grosse variance. C’est exactement le genre de variable difficile à prévoir à l’avance, et c’est pour ça que l’auto-grow prend tout son sens.

Attention : les 10 / 50 IOPS sont des moyennes Microsoft. Sur une population à fort usage Office + Teams + OneDrive sync, on monte assez vite. Mesurez sur votre prod plutôt que de partir tête baissée sur la table.

4. Le piège du « pay-per-provisioned »

C’est le point qui change avec le Provisioned v2, qu’il soit SSD ou HDD. Microsoft le dit noir sur blanc :

Vous payez en fonction de ce que vous approvisionnez, quel que soit le montant que vous utilisez réellement.

Source : Understand Azure Files billing — Microsoft Learn

Concrètement : vous provisionnez 8 To « au cas où » → vous payez 8 To, qu’ils soient remplis à 5 % ou à 95 %. Plus du tout le modèle Standard pay-as-you-go d’antan où vous ne payiez que le stockage consommé.

Deux stratégies s’offrent à vous :

  1. Surprovisionner dès le départ pour ne jamais être surpris → vous payez de la capacité dormante pendant des mois.
  2. Provisionner serré (avec un peu de marge) puis grossir à la demande, dès que l’usage s’approche d’un seuil → vous payez ce dont vous avez besoin au moment où vous en avez besoin.

L’option 2 demande de l’automatisation. C’est exactement ce que fait la solution qui suit.

5. La solution : auto-grow runbook open-source

J’ai packagé tout ça sur GitHub : jlou07/azure-files-autogrow. Le repo contient trois fichiers :

  • main.bicep : déploie un Automation Account avec Managed Identity, les modules PowerShell 7.2 (Az.Accounts + Az.Storage), un runbook vide, une schedule, et toute la stack Azure Communication Services pour les emails.
  • Grow-FslogixShare.ps1 : le runbook qui lit la capacité utilisée du share, compare au seuil, agrandit le quota, et envoie un email récapitulatif.
  • deploy-cloudshell.sh : script interactif qui vous pose les questions et orchestre tout depuis Azure Cloud Shell.

Le runbook est grow-only par design : il ne diminue jamais le quota et c’est volontaire : un utilisateur qui charge un gros profil un jour et le supprime le lendemain ne doit pas déclencher une décroissance.

Et de toute façon, Azure impose 24 h de cooldown avant toute baisse, donc autant ne pas s’embêter.

Pré-requis

SubscriptionVous devez être Contributor sur un Resource Group de la sub.
Storage accountKind FileStorage avec SKU PremiumV2_* ou StandardV2_* déjà existant, avec un file share déjà créé.
Email de notifN’importe quelle adresse (interne, externe, gmail, …). Optionnelle : si vous la laissez vide, les notifs sont désactivées et la stack ACS n’est pas déployée.
OutilsAzure Cloud Shell (Bash).
Mon retour terrain : j’ai fait le choix d’Azure Communication Services pour les emails, plutôt que Microsoft Graph. Avantage énorme : un simple rôle Contributor scopé sur la ressource ACS suffit. Pas de consentement admin tenant, pas de Mail.Send au niveau du tenant, pas de mailbox à provisionner. La solution est déployable par n’importe quel admin Azure qui a un Resource Group à sa main.

6. Déploiement pas-à-pas depuis Cloud Shell

Étape 0 — Ouvrir Cloud Shell et récupérer les fichiers

Mais juste avant, j’ai déployé un Azure File Share de 50 Go sur mon environnement de test :

Allez sur shell.azure.com ou cliquez ici :

Choisissez Bash, puis :

curl -O https://raw.githubusercontent.com/jlou07/azure-files-autogrow/main/main.bicep
curl -O https://raw.githubusercontent.com/jlou07/azure-files-autogrow/main/Grow-FslogixShare.ps1
curl -O https://raw.githubusercontent.com/jlou07/azure-files-autogrow/main/deploy-cloudshell.sh
chmod +x deploy-cloudshell.sh

Étape 1 — Lancer le script

./deploy-cloudshell.sh

Le script vous pose une série de questions, dans l’ordre :

  • La subscription cible (par défaut celle qui est active dans Cloud Shell)
  • Le Resource Group où déployer l’Automation Account (créé s’il n’existe pas)
  • La région (ex. francecentral, westeurope)
  • Le RG, le nom et le nom du share du storage cible (celui qui contient le file share v2 à monitorer)
  • Le seuil de déclenchement en % (défaut 80)
  • Le growth factor (défaut 1.25, soit +25 % à chaque grossissement)
  • Le quota max en GiB (défaut 4 096)
  • La fréquence de check (PT15M, PT30M, PT1H (défaut 30 min))
  • L’email de notification (vide = pas d’emails, et la stack ACS n’est pas déployée)
  • La data location ACS (défaut Europe)

Étape 2 — Le script déroule

Une fois que vous confirmez, le script enchaîne :

  1. Crée le RG si besoin.
  2. Déploie le Bicep (Automation Account + modules + runbook vide + schedule + ACS + Email Service + Managed Domain + role assignment Contributor sur ACS).
  3. Grant Storage Account Contributor sur le storage cible à l’identité managée de l’Automation Account.
  4. Upload le contenu du Grow-FslogixShare.ps1 dans le runbook.
  5. Publie le runbook.
  6. Lie la schedule au runbook avec les bons paramètres (jobSchedule).

Voici toutes les ressources Azure présentes dans mon environnement :

Étape 3 — Vérifier dans le portail Azure

  • Automation Account → Modules : Az.Accounts et Az.Storage en statut Available (~10-15 min après le déploiement, c’est de l’import asynchrone) :
  • Runbooks → Grow-FslogixShare : statut Published :
  • Schedules → AutoGrowSchedule : enabled, avec un lien vers le job Grow-FslogixShare :
  • Storage account cible → IAM : l’identité managée de l’AA a bien le rôle Storage Account Contributor :
  • Ressource ACS → IAM : l’identité managée a Contributor :

Nous allons maintenant tester l’action d’agrandissement, le blocage au cap, et le système de notifications par email.

7. Le moment de vérité : on déclenche un grow

Dès la mise en place de la solution, un premier job doit se lancer :

Le détail de toutes les actions est visible dans le log du job :

Pour forcer un run immédiat sans attendre la prochaine occurrence dans Azure Cloud Shell :

az automation runbook start \
  -g <aa-rg> \
  --automation-account-name <aa-name> \
  --name Grow-FslogixShare \
  --parameters \
      SubscriptionId=<sub-id> \
      ResourceGroupName=<storage-rg> \
      StorageAccountName=<storage-name> \
      FileShareName=<share-name> \
      ThresholdPercent=80 \
      GrowthFactor=1.25 \
      MaxQuotaGiB=4096 \
      NotificationEmail=alerts@mondomaine.com \
      AcsEndpoint=https://<acs-name>.europe.communication.azure.com \
      AcsSenderAddress=DoNotReply@<guid>.azurecomm.net

Les jobs manuels ou automatiques sont visibles ici :

Si vous voulez juste tester l’envoi d’email sans toucher au quota, le runbook supporte un switch -WhatIf qui simule la décision sans appliquer.

Au besoin, vous pouvez modifier la configuration planifiée en en créant une nouvelle ici :

Quand l’usage du share franchit le seuil (par défaut 80 %), comme ici :

Le runbook calcule le nouveau quota (ceil(quota_actuel × 1.25), capé à MaxQuotaGiB), appelle Update-AzRmStorageShare :

La taille du partage de fichier augmente bien de 25 % :

Et enfin il envoie un email récap :

Mais, si le share atteint le cap dur (MaxQuotaGiB), le runbook arrête de le faire grossir :

Et il envoie aussi un email d’alerte en importance haute :

Attention : le premier email envoyé depuis le domaine ACS managé (DoNotReply@<guid>.azurecomm.net) peut tomber en spam. Whitelistez *.azurecomm.net côté destinataire, ou mieux branchez un custom domain vérifié dans le portail ACS (10 minutes d’enregistrements DNS).

Et comme attendu, le service veille en continu :

8. Estimation de coûts (ordres de grandeur)

Les prix Azure Files V2 varient selon la région et la redondance, et Microsoft les ajuste régulièrement.

Les chiffres qui suivent sont des ordres de grandeur pour un déploiement de 256 Go en Europe de l’Ouest, sur un workload FSLogix sur les quatre types de stockage :

Voici d’ailleurs plusieurs hypothèses de sizing FSLogix :

  • ~ 15 GiB par profil utilisateur (mid-range, typique AVD avec Office + OneDrive sync léger)
  • IOPS pic sign-in : 50 IOPS / user (recommandation Microsoft)
  • Throughput : ce que recommande Azure par défaut pour la capacité provisionnée
UsersCapacité viséeIOPS visés (pic)Stratégie « provisioned sec » à la mainStratégie « auto-grow »
50~ 750 GiB2 500Surprovisionner à 1 TiB pour avoir de la margeDémarrer à 256 GiB, grossir au fil de l’eau jusqu’à ~ 800 GiB
200~ 3 TiB10 000Provisionner d’office 4 TiBDémarrer à 1 TiB, monter par paliers de +25 %
500~ 7,5 TiB25 000Provisionner d’office 8 TiBDémarrer à 2 TiB, monter au besoin
1 000~ 15 TiB50 000Provisionner d’office 16 TiBDémarrer à 4 TiB, monter au besoin

Sur les ratios de remplissage que je vois en prod (souvent 40-60 % sur les premiers 6 mois), la stratégie auto-grow économise typiquement 30 à 50 % sur la ligne « capacité provisionnée » du share, le temps que la base utilisateurs se stabilise. L’IOPS reste à provisionner pour le pic, ou à profiter des bursts :

Coût ajouté par la solution elle-même :

  • Automation Account : les 500 premières minutes de runtime par mois sont incluses. Un check toutes les 30 minutes consomme quelques secondes par run, soit largement sous le seuil gratuit.
  • Azure Communication Services Email : facturation à l’email envoyé. Sur le volume d’un déploiement comme le nôtre (typiquement quelques dizaines d’emails par mois), c’est négligeable.

Bref : le coût de l’orchestration est ridicule face à ce que la stratégie permet d’économiser sur la capacité du share.

9. Pièges & vigilance

Attention : les modules PowerShell sont importés en asynchrone. Pendant les 10-15 minutes qui suivent le déploiement, un job qui se déclenche peut échouer avec « Could not find module Az.Accounts ». C’est normal, ça se résout tout seul. Évitez juste de tester immédiatement après le déploiement.
Attention : le Managed Domain ACS a besoin d’une à deux minutes pour être complètement provisionné après le déploiement. Le tout premier envoi d’email peut échouer ; il suffit de relancer.
Attention : le sender par défaut est DoNotReply@<guid>.azurecomm.net. Pour un envoi propre depuis alerts@mondomaine.com, il faut ajouter un custom domain vérifié dans le portail ACS (quelques enregistrements DNS, 10 minutes) puis mettre à jour AcsSenderAddress sur le jobSchedule.
Mon retour terrain : le runbook est grow-only, ne descend jamais le quota. Et tant mieux : Azure impose 24 h de cooldown avant toute baisse, et refuse toute baisse sous l’usage courant. Si vous voulez vraiment réduire, faites-le à la main après avoir mesuré sur un mois entier.

Conclusion

Voilà, en quelques minutes de Cloud Shell, vous avez :

  • Un Automation Account avec identité managée
  • Un runbook qui surveille votre share FSLogix v2 et adapte le quota automatiquement.
  • Une stack Azure Communication Services dédiée qui envoie les emails

Concrètement, ça donne quoi ? Vous ne surprovisionnez plus à l’aveugle. Vous démarrez serré, et la capacité suit l’usage réel, avec un email récap à chaque changement, et un garde-fou final si jamais ça part en vrille.

Foncez tester, le repo est en MIT, vous pouvez le forker, l’adapter à vos seuils, brancher Logic Apps ou un Teams Webhook à la place de l’email si c’est votre flow. github.com/jlou07/azure-files-autogrow.

Encore hésitant à passer votre stockage FSLogix en v2 ? Regardez cette vidéo :

Et si vous voulez creuser le calcul de sizing FSLogix plus en détail, dites-le moi en commentaire, il y a matière à un article dédié sur la mesure d’IOPS réelle vs la table Microsoft.

Nerdio en 2026

Vous avez entendu parler de Nerdio à droite à gauche, vous savez vaguement que ça « simplifie AVD », mais vous n’avez jamais mis les mains dedans ? Cet article est fait pour vous. On part d’une souscription Azure quasi vide et on va dérouler, capture après capture, tout ce qu’il faut faire pour aboutir à un utilisateur qui clique sur Windows App et qui ouvre un bureau AVD propre, avec son profil FSLogix qui suit.

À chaque étape je montre en parallèle ce qui apparaît côté portail Azure, parce que c’est très bien Nerdio, mais il faut comprendre ce qu’il fabrique réellement dans votre subscription. Avant de plonger dans le tuto, deux vidéos pour planter le décor :

  • La première fait le tour rapide des deux produits Nerdio :
    • Nerdio Manager for Entreprise
    • Nerdio Manager for MSP
  • La seconde montre un déploiement en moins de 5 minutes :

Pour vous guider plus facilement dans cet article, voici des liens rapides :

1. Les prérequis

Avant de cliquer sur quoi que ce soit dans le Marketplace Azure, vous devez avoir plusieurs briques en place. Si elles ne sont pas là, vous allez avoir des erreurs classiques du genre « no subnet available » ou « FSLogix path unreachable » pendant la configuration de Nerdio. Autant les poser proprement avant.

Premier prérequis : un Virtual Network. Le vNet doit être joignable depuis votre Active Directory (ou être Entra ID joined comme chez moi), et c’est là-dedans que les session hosts vont atterrir :

Deuxième prérequis : un NAT gateway, associé à vos subnets AVD et Windows 365. La NAT gateway est la solution la plus simple, bien qu’il en existe d’autres (voir mon article) :

Troisième prérequis : un compte de stockage pour FSLogix :

Attention : sur un environnement Entra ID joined, l’authentification au file share FSLogix passe par Entra Kerberos. Pensez à activer cette option côté storage account et à attribuer les rôles RBAC Storage File Data SMB Share Contributor aux utilisateurs AVD. Sinon, vous aurez l’écran « Please wait for the FSLogix Apps Services » pendant 30 secondes puis un profil temporaire : le piège classique.

2. Déployer Nerdio Manager for Enterprise depuis le Marketplace

Direction le Marketplace Azure, on tape nerdio et on tombe sur plusieurs offres. Celle qui nous intéresse dans cet article est Nerdio Manager for Enterprise (à ne pas confondre avec Nerdio Manager for MSP qui est pour les prestataires multi-tenants) :

Sur la fiche produit, on voit que le pricing est en « BYOL via Microsoft Enterprise Contract », vous payez Nerdio sur votre facture Azure (Marketplace), pas via une licence séparée.

On clique sur Create :

L’écran Create NME Plan est un assistant Azure classique :

  • Premier onglet, Basics : on choisit la subscription, on crée un nouveau Resource Group dédié, et on sélectionne la région :
Attention : le compte avec lequel vous lancez le déploiement doit être Global Administrator sur Entra ID ET Owner sur la subscription. C’est rappelé dans l’écran Basics. Si vous êtes juste Contributor, ça va planter au consent.
  • Onglet Resource Names : on définit un préfixe et on laisse les noms par défaut. À ce stade vous voyez déjà la liste de ce qui va être déployé :
  • Onglet Private Endpoints : en prod vous activerez les private endpoints pour blinder la sécurité (l’App Service et le SQL deviennent inaccessibles depuis Internet). Pour notre lab dev/test on laisse décoché :
  • Onglet Tags : standard, vous appliquez vos tags habituels :

Et enfin Review + create. Vous validez les conditions Marketplace, vous vérifiez l’adresse mail (qui sera utilisée par Nerdio pour vous joindre support / facturation), et vous cliquez Create.

Le déploiement prend entre 5 et 15 minutes selon la région et la charge Azure du moment :

Dans l’onglet Outputs, vous récupérez l’URL de votre App Service Nerdio :

3. Initialiser le Nerdio Manager

On ouvre l’URL de l’App Service.

Premier accueil : Nerdio vous demande de lancer un script PowerShell qui va finir la plomberie (permissions, secrets, certificat dans Key Vault, app registration Entra ID) :

Cliquez sur Copy pour récupérer la commande PowerShell, puis ouvrez le Cloud Shell directement depuis l’icône en haut du portail Azure :

Vous collez la commande, vous appuyez sur Entrée et vous laissez tourner :

À la fin vous devez voir un Deployment completed successfully :

Pendant l’exécution, Entra ID vous demande de donner le consent admin pour l’app Nerdio. Cochez « Consent on behalf of your organization » et cliquez Accepter :

Si vous voulez vérifier, allez sur la page Enterprise Application nerdio-nmw-app dans Entra ID, onglet Permissions. Vous devez voir une liste impressionnante de permissions Microsoft Graph :

C’est cette app registration qui va piloter votre tenant à la place de Nerdio.

4. Premier login et registration

Une fois le script PowerShell terminé, on retourne sur l’URL Nerdio et on rafraîchit la page. Cette fois on a l’écran d’accueil avec votre tenant Entra ID et votre subscription pré-remplis. On clique sur Register Nerdio Manager.

Petit formulaire de registration côté Nerdio (Company, Name, Email, Phone) :

On clique sur Next :

5. Configuration initiale (services, vNet, AD, FSLogix)

Étape Services : Nerdio vous demande quels services vous voulez manager. Dans mon lab j’ai tout coché : Azure Virtual Desktop, Windows 365 (Cloud PCs) et Intune (Physical endpoints) :

Étape Configuration : Nerdio vous demande trois choses, dans cet ordre : un vNet, un Directory (Entra ID, AD DS, ou Entra Domain Services), et un emplacement FSLogix. On clique sur le bouton Configure à côté de Features and scope pour commencer par paramétrer Intune :

Sur la fenêtre Configure Intune, vous choisissez ce que Nerdio a le droit de faire sur Intune : Manage / Read-only / N/A pour chaque feature (devices, group membership, scripts, conditional access, app policies, etc.) :

Ensuite on revient et on configure le VNet, puis on le link au subnet AVD :

Puis Directory : C’est ce profil qui dira aux session hosts de se joindre automatiquement et de s’enrôler dans Intune au boot :

Enfin FSLogix Profiles Storage Configuration. On pointe le path UNC du share, et on coche absolument « Configure session hosts registry for Entra ID joined storage » :

Attention : pour le FSLogix sur stockage Entra ID joined, en plus de cocher la case dans Nerdio, il faut que le storage account ait été configuré avec Identity-based access côté Azure (rappel du prérequis 1) et que vos utilisateurs AVD aient le rôle RBAC Storage File Data SMB Share Contributor. C’est l’erreur n°1 sur les déploiements Entra-only.

Une fois les trois choses configurées, vous voyez l’écran de Configuration avec les trois boutons remplis (vNet sélectionné, Directory Entra ID, FSLogix location renseigné), on clique sur Done.

La console Nerdio charge alors la configuration pendant plusieurs minutes :

6. Le Grant Admin Consent final

Nerdio détecte qu’il a besoin de permissions supplémentaires pour fonctionner sur l’étendue que vous venez de définir (vNet, FSLogix, Intune).

Une popup Grant Consent apparaît, avec un warning : « The list of required permissions can take some time to fully populate. You may need to grant permissions multiple times. »

Cliquez sur le lien pour ouvrir la fenêtre de consent Entra ID.

Vous validez la longue liste de permissions et vous cliquez Accept. Vous obtenez alors l’écran « Admin Consent granted » :

Côté portail Azure, vous pouvez vérifier sur l’Enterprise App nerdio-nmw-app que les permissions Microsoft Graph sont maintenant à 29 (au lieu de 25 avant) :

De retour dans Nerdio, on coche « I have granted admin consent » et on clique OK.

Mon retour terrain : il m’est arrivé de devoir passer le consent deux fois sur cet écran. La première fois Nerdio détecte des permissions manquantes après quelques secondes et redemande. Ne paniquez pas, c’est normal, le warning vous prévient.

7. Tour des ressources Azure créées par Nerdio

Voilà, vous arrivez sur le dashboard Workspaces de Nerdio. Il est vide pour le moment, on va y revenir :

Maintenant, allez voir côté portail Azure, vous devriez voir les services Azure suivants :

  • App Service / App Service Plan + Application Insights
  • 2 Automation Account
  • Data Collection Endpoint + Data Collection Rule + 2 Log Analytics Workspaces
  • Key Vault
  • Runbook
  • Smart detector alert rule
  • SQL database + SQL server
  • Storage Account

Et dans l’IAM de votre vNet, vous voyez maintenant l’app registration nerdio-nmw-app avec trois rôles : Reader et Backup Reader hérités au niveau subscription, et Network Contributor sur le vNet lui-même :

8. Downgrade dev/test pour faire baisser la facture

16 ressources Azure pour faire tourner une simple app web de management, ça pique un peu, surtout quand on découvre que Nerdio déploie par défaut :

  • App Service Plan en B3 (~150 €/mois)
  • SQL Database en S1 (~22 €/mois).

Total déploiement par défaut : autour de 248 $/mois rien que pour la console Nerdio elle-même, sans compter vos session hosts.

Nerdio le sait, et pour les environnements dev/test ou POC, ils documentent officiellement un downgrade qui fait tomber la facture à environ 60 $/mois.

Concrètement, vous allez sur la SQL Database, onglet Compute + storage, et vous basculez en Basic (For less demanding workloads) à 5 DTUs et 2 GB de data, coût estimé : 6,11 $/mois :

Puis sur l’App Service Plan, vous faites un Scale up et vous descendez de B3 vers B1 (Basic). Coût estimé : ~8,40 €/mois.

Attention : ce downgrade est officiellement supporté uniquement pour dev/test et POC. En production, gardez le B3 + S1 sinon vous allez avoir des perfs dégradées sur l’auto-scaling, les scripted actions et les opérations bulk. La KB Nerdio est claire là-dessus.

9. Créer un Workspace

On revient dans Nerdio.

Première chose à faire : aller dans Settings > Environment > Linked Resource Groups et vérifier qu’on a bien linké le RG dans lequel on veut déployer les session hosts :

Maintenant, direction Workspaces. C’est encore vide, on clique sur New Workspace.

Pour rappel, un Workspace AVD c’est juste un conteneur logique qui va regrouper vos host pools. Côté Microsoft, c’est l’objet Microsoft.DesktopVirtualization/workspaces :

Côté Azure, vous voyez maintenant apparaître la ressource de type Workspace. Nerdio a bien créé l’objet AVD pour vous :

10. Créer un Host Pool

Sur la ligne du workspace, on clique sur les trois points et on choisit Host pools :

On clique New Host Pool :

La fenêtre Add Host Pool est dense, voici mes choix pour le lab :

  • Host pool type : Static (pas d’auto-scale dynamique pour ce test)
  • Desktop experience : AVD multi-session desktop (pooled)
  • Directory : Default
  • FSLogix : Default
  • Initial host count : 2 pour valider le load balancing
  • Name (VM prefix) : nerdio-vm
  • Network : nerdio-vnet (AVD)
  • Desktop image : Windows 11 25H2 AVD + Microsoft 365 Apps (image Marketplace gallery)
  • VM size : D8s_v6 (8 cores, 32 GB RAM)
  • OS disk : 128 GB E10 Standard SSD

Nerdio prévient que la tâche est longue (entre 20 et 40 minutes pour 2 hosts), on clique OK et c’est parti. Vous pouvez suivre l’avancement dans l’onglet Tasks.

Côté Azure pendant que ça tourne, on voit déjà apparaître deux nouvelles ressources : Host pool et Application group, c’est l’objet qui va recevoir les assignations utilisateurs :

Dans l’onglet Tasks de Nerdio, on voit le déroulé : un Create host pool, puis Add hosts en parallèle pour les 2 VMs (qui prennent ~12 à 15 minutes chacune) :

Côté Azure on voit les 2 VMs apparaître avec leurs NICs respectifs, attachés au subnet AVD :

Une fois toutes les Tasks COMPLETED, on est bon :

Dans la vue Session Hosts, les deux VMs sont là, marquées Entra Joined, avec leur IP dans le subnet :

Côté Azure, sur le host pool, vous voyez le dashboard Overview : Total machines 2, Can connect 2, Can’t connect 0. Tout est vert :

11. Configurer le Host Pool (RDP, SSO Entra ID, time limits)

Le host pool tourne, mais il faut le configurer un peu avant de laisser les utilisateurs se connecter : périphériques redirigés, single sign-on Entra ID, time limits. Sur la ligne du host pool, trois points > Settings.

Onglet RDP Settings : c’est ici qu’on définit ce qui est redirigé entre le client et la session AVD. J’active Redirect microphone, Redirect speaker, Redirect cameras, Redirect clipboard, Redirect printers :

Toujours dans RDP Settings, en passant en Custom RDP configuration, je cherche la propriété enablerdsaadauth et je la mets à 1. C’est la propriété qui autorise le single sign-on Entra ID côté RDP ;:

Onglet Session Time Limits : j’active la fonctionnalité, je mets Disconnect IDLE sessions after à 1 jour et Log off DISCONNECTED sessions after à 1 heure :

Côté Azure, sur le host pool dans le portail, onglet RDP Properties, vous pouvez vérifier que Microsoft Entra single sign-on est bien sur « Connections will use Microsoft Entra authentication to provide single sign-on » :

Attention : pour que le SSO Entra ID fonctionne complètement, il faut trois choses alignées : (1) enablerdsaadauth=1 dans les RDP properties, (2) le SSO activé sur le host pool côté Azure, (3) les utilisateurs en MFA conforme aux exigences Conditional Access. C’est documenté ici : Configure single sign-on with Microsoft Entra authentication.

12. Assigner les utilisateurs

Sur la ligne du host pool, trois points > Users and groups.

Lors de l’ajout des utilisateurs, Nerdio nous propose de le faire automatiquement :

Côté Azure, sur l’Application Group, onglet Assignments, vous voyez vos utilisateurs apparaître :

Et dans l’IAM, en filtrant sur un utilisateur (avdtest4 par exemple), vous voyez bien le rôle Virtual Machine User Login qui a été attribué automatiquement par Nerdio :

Mon retour terrain : beaucoup de gens oublient ce rôle et passent 30 minutes à se demander pourquoi leur utilisateur voit le host pool dans Windows App mais ne peut pas se connecter (erreur « Your account is configured to prevent you from using this device »). C’est ici que ça se règle, et Nerdio vous le propose automatiquement : c’est exactement la valeur ajoutée du produit.

13. Tester la connexion utilisateur

Le moment de vérité.

On se connecte avec un compte de test sur Windows App (ou windows.cloud.microsoft). Dans la vue Devices, on voit notre workspace et le host pool :

Clic sur la tuile :

Premier signe qui rassure : l’écran « Please wait for the FSLogix Apps Services ». Ça veut dire que FSLogix est en train de monter le profil VHDX depuis le file share Entra Kerberos :

Et voilà : bureau Windows 11 25H2, session AVD multi-session, prête à l’emploi :

14. Vérifier le résultat côté Nerdio et FSLogix

On retourne sur le file share dans le portail Azure.

Et là, magie : un répertoire vient d’être créé par FSLogix, contenant le VHDX du profil utilisateur :

Et côté Nerdio, sur la vue User Sessions, on voit la session active. Vous pouvez log off, disconnect ou send message à l’utilisateur depuis là :

Conclusion

Voilà, en une douzaine d’étapes vous êtes passé d’un vNet vide à un environnement AVD multi-session Entra-joined avec FSLogix profiles, SSO Entra ID, et vos utilisateurs assignés, le tout piloté depuis une console unique.

Concrètement, ça donne quoi ?

Là où Microsoft vous fait jongler entre 5 blades du portail (Workspaces, Host pools, Application groups, RDP properties, IAM), Nerdio centralise tout dans une seule UI cohérente. Il vous propose automatiquement les bons réglages, comme le rôle Virtual Machine User Login qu’on aurait pu oublier.

Les 3 pièges à retenir si vous reproduisez en lab :

  1. Le Grant Consent peut nécessiter deux passages, soyez patient.
  2. Pour FSLogix sur un storage Entra ID joined, n’oubliez pas la case « Configure session hosts registry for Entra ID joined storage » et les rôles RBAC sur le file share.
  3. Pour le SSO Entra ID, les trois conditions doivent être réunies : enablerdsaadauth=1 + SSO côté host pool + utilisateurs MFA-compliant.

Et n’oubliez pas le downgrade dev/test (SQL Basic + App Service B1) si vous laissez tourner l’environnement à long terme : ~190 $/mois économisés rien que sur les composants Nerdio.

Foncez tester en lab, c’est gratuit pendant 30 jours en trial Nerdio !

Et si vous galérez sur une étape, dites-le-moi en commentaire, je referai un article plus poussé sur la partie scaling et auto-scale, qui est vraiment là où Nerdio fait la différence.

Azure Virtual Desktop Hybride

Pendant longtemps, faire de l’AVD ailleurs que dans Azure, c’était soit du AVD on Azure Local, soit… rien. Pour ceux qui n’avaient pas encore investi dans le HCI mais qui avaient déjà du Hyper-V, du VMware ou du Nutanix qui tournait depuis dix ans en datacenter, l’équation était la même : reverse-proxy + RDS + bricolage maison. Microsoft vient enfin d’ouvrir la porte avec Azure Virtual Desktop Hybrid, en Public Preview depuis le 4 mai 2026.

Cette préversion est le fruit d’un travail continu de la part de Microsoft avant même l’annonce officielle de la fonctionnalité lors du Microsoft Ignite de 2025 à San Francisco.

Today, we’re excited to announce Azure Virtual Desktop for hybrid environments, a new capability for bringing the power of cloud-native desktop virtualization to existing on-premises infrastructure. With this update, on-premises Arc-Enabled Servers can be configured as AVD session hosts. This expands Azure Virtual Desktop’s hybrid capabilities beyond Azure Local to Microsoft Hyper-V, Nutanix AHV, VMware vSphere, physical Windows Servers, or anywhere Arc-Enabled Servers can be deployed on-premises.

Microsoft Tech Coommunity

Et la philosophie de fonctionnement est élégante : Azure Arc enrôle vos VMs on-prem, une extension AVD les transforme en session hosts, et le service AVD continue de vivre dans le cloud comme d’habitude. Bref, pas de nouvelle stack à apprendre, juste une nouvelle case à cocher.

Pour vous guider plus facilement dans cet article, voici des liens rapides :

Quelle est la nouveauté ?

Comme annoncé en introduction, Microsoft a publié le 4 mai 2026 la préversion publique d’Azure Virtual Desktop Hybrid. Le principe est simple : on prend une VM Windows qui tourne déjà chez vous (sur Hyper-V, VMware, Nutanix ou même un serveur physique), on l’enrôle dans Azure Arc, on lui pose une extension AVD, et hop, elle devient un session host AVD à part entière. L’utilisateur se connecte via la Windows App, exactement comme s’il attaquait un host pool 100 % Azure.

With Azure Virtual Desktop Hybrid, customers can run Azure Virtual Desktop session hosts on-premises using their existing hardware and preferred hypervisor connected through Microsoft Azure Arc. The Azure Virtual Desktop service remains in Azure, while session hosts can be deployed anywhere on-premises Azure Arc-enabled servers are supported. Users can access their desktops through the familiar Windows App.

This matters because it gives customers a phased, lower-risk path to cloud adoption:

  • Modernize legacy VDI environments at their own pace, preserving investments in datacenters, hardware, and operational tools.
  • Adopt cloud-managed desktops incrementallywith a clear path to migrate session hosts to Azure when the time is right.
  • Keep existing partner integrationsfor virtual machine management and provisioning.

Microsoft Tech Community

Pour rappel, jusqu’ici, faire tourner AVD ailleurs que dans Azure imposait soit AVD on Azure Local (anciennement Azure Stack HCI). Cela exigeait d’investir dans une stack HCI Microsoft – soit de partir sur du bon vieux RDS on-prem, en sacrifiant tout l’écosystème AVD (FSLogix moderne, app groups, Insights, Windows App).

Avec AVD Hybrid, ce dilemme s’efface : la documentation Microsoft Learn confirme que les VMs on-prem se comportent comme de vrais session hosts AVD pilotés depuis le portail Azure.

C’est un vrai changement de philosophie : historiquement, AVD c’était « tu déplaces ta VDI dans Azure, et après on en reparle ». Aujourd’hui, c’est « tu gardes ton hyperviseur, on apporte juste le control plane AVD chez toi ».

Ça ouvre AVD à toute une population qui en avait été tenue à l’écart pour des raisons de souveraineté, de coûts d’egress ou tout simplement parce qu’ils avaient déjà payé leur datacenter.

Est-ce la même chose qu’AVD sur Azure Local ?

C’est le même esprit, mais pas la même mécanique. AVD on Azure Local exige une infrastructure HCI Microsoft certifiée, avec ses nœuds, ses switches, son cluster, son réseau SDN. AVD Hybrid, lui, ne demande qu’une chose : une VM Windows qui peut joindre Azure Arc. Le reste, c’est votre hyperviseur qui le gère, peu importe lequel.

Autrement dit :

  • Pas besoin de hardware certifié Azure Local
  • Pas besoin de cluster spécifique – une simple VM Windows suffit
  • Le control plane AVD reste dans Azure (le service est rendu par Microsoft, comme pour AVD classique)
  • Les session hosts vivent chez vous, et c’est Azure Arc qui sert de pont

Si vous avez déjà déployé des serveurs Azure Arc-Enabled (par exemple pour bénéficier d’Azure Policy, Defender for Cloud ou Update Manager sur du on-prem), vous êtes déjà à 80 % du chemin. Il ne reste plus qu’à poser l’extension AVD et à brancher le session host sur un host pool.

Quels hyperviseurs sont supportés ?

La réponse de Microsoft est volontairement large : tout endroit où Azure Arc peut s’installer. Concrètement, c’est confirmé pour :

  • Microsoft Hyper-V (Windows Server, Hyper-V Server)
  • VMware vSphere (ESXi 7.x / 8.x)
  • Nutanix AHV
  • Serveurs Windows physiques (oui, vous pouvez transformer un poste rack en session host)

C’est ce que dit explicitement l’annonce officielle :

On-premises Arc-Enabled Servers can be configured as AVD session hosts. This expands Azure Virtual Desktop’s hybrid capabilities beyond Azure Local to Microsoft Hyper-V, Nutanix AHV, VMware vSphere, physical Windows Servers, or anywhere Arc-Enabled Servers can be deployed on-premises.

Microsoft Tech Community

Côté partenaires de lancement, Microsoft a explicitement nommé Nerdio, ControlUp, LoginVSI et Nutanix comme étant déjà alignés avec la Preview. Si vous utilisez Nerdio Manager for Enterprise, la fonctionnalité est intégrée dès aujourd’hui.

Quels OS et quelles licences sont éligibles ?

C’est le tableau qu’il faut imprimer et coller à côté de l’écran. Voici la matrice officielle issue de la documentation Microsoft Learn :

OSDéploiement supportéLicences éligibles
Windows Server 2016 / 2019 / 2022 / 2025VMs et serveurs physiquesRDS CAL avec Software Assurance, ou RDS User Licenses en souscription
Windows 11 / Windows 10 Enterprise mono-sessionVMs uniquement (pas de PC physique)M365 E3/E5/A3/A5/F3, M365 Business Premium, Windows Enterprise E3/E5, Windows Education A3/A5, Windows VDA per user
Windows 11 / 10 Enterprise multi-sessionNon supporté hors Azuren/a

Le piège classique pour ceux qui font de l’AVD depuis longtemps : Windows 11 Enterprise multi-session n’est PAS supporté en hybride. Cette SKU reste exclusive à Azure. Si vous voulez du multi-utilisateur sur du on-prem, il faudra repasser sur du Windows Server avec le rôle Remote Desktop Session Host. C’est cohérent avec la philosophie multi-session, qui est historiquement liée à un avantage Azure-only.

Concernant la fameuse licence « Windows Cloud Hybrid » annoncée pour la GA : elle n’est PAS exigée pendant la Public Preview. Vous pouvez tester avec vos licences existantes. À la GA, Microsoft annoncera les conditions tarifaires définitives.

Entra Join ou jointure de domaine ?

Tous les modes sont supportés, et c’est une très bonne nouvelle. Mes propres tests le confirment :

  • Microsoft Entra Join pur : la VM s’enregistre directement dans le tenant. Idéal pour les machines Windows 11 mono-session, surtout dans une logique zéro-trust. Pas besoin de contrôleur de domaine joignable depuis la VM.
  • Active Directory (jointure de domaine traditionnelle) : fonctionne parfaitement, surtout pour des Windows Server qui ont besoin de Kerberos pour attaquer des serveurs de fichiers SMB on-prem ou des bases SQL avec authentification intégrée.
  • Active Directory + Microsoft Entra Connect (jointure de domaine traditionnelle, synchronisée vers Entra) :

Mon retour terrain :

Pour Windows 11 mono-session, l'Entra Join pur est plus rapide à mettre en place et évite tout le pataquès du DC à rendre joignable depuis le réseau de l'hyperviseur. 

Pour Windows Server, j'ai gardé le domain-join classique, parce que dans les vrais projets, le serveur de fichiers SMB est très souvent encore en AD on-prem et qu'on veut éviter de mixer les modèles. Les deux cas marchent du premier coup, je le détaillerai plus loin dans les cas pratiques.

Quels sont les prérequis à respecter ?

Avant de se lancer, il faut cocher quelques cases. Voici le récap :

PrérequisDétail
SouscriptionUne souscription Azure active
Resource providersMicrosoft.HybridCompute, Microsoft.HybridConnectivity, Microsoft.GuestConfiguration, Microsoft.DesktopVirtualization
RBACAzure Connected Machine Onboarding + Desktop Virtualization Contributor
IdentitéMicrosoft Entra ID (Entra Join ou AD synchronisé)
RéseauSortie TCP 443 vers Azure Arc + endpoints AVD
OSWindows Server 2016+ ou Windows 11/10 Enterprise mono-session
HyperviseurHyper-V, VMware, Nutanix AHV, ou serveur physique
Host poolValidation host pool obligatoire pendant la Preview

Le piège classique : oublier le resource provider Microsoft.HybridConnectivity, qui est nécessaire pour la connectivité SSH/RDP via Arc. Si vous l’oubliez, l’enrôlement Arc passe, mais certaines opérations downstream peuvent silencieusement échouer. Croyez-en quelqu’un qui a passé une bonne demi-heure à se demander pourquoi 🙃.

Qu’est-ce qu’un « validation host pool » ?

Un validation host pool est un host pool AVD marqué comme environnement de validation (case à cocher dans le portail). Microsoft le réserve aux features en preview, et c’est actuellement le seul mode supporté pour AVD Hybrid pendant la Public Preview. La documentation est explicite :

Azure Virtual Desktop Hybrid is currently in Public Preview and is only supported with validation host pools. If you deploy a production host pool then you will need to redeploy once Windows Cloud Hybrid is Generally Available.

Microsoft Learn

Ne mettez pas en prod votre validation host pool. Servez-vous-en pour piloter, valider votre architecture, former l’équipe, mais prévoyez le redéploiement quand la GA sortira.

Quelles fonctions ne sont PAS supportées en Preview ?

Comme toute préversion qui se respecte, il y a des trous dans la raquette. Microsoft liste explicitement :

  • Power management dans le portail Azure (start/stop/deallocate sur les VMs)
  • Auto-Scale
  • Start VM on Connect
  • Session Host Configuration

C’est logique : ces fonctions reposent toutes sur le control plane Azure pour piloter les VMs (les démarrer, les arrêter, les redimensionner). Or, en hybride, c’est votre hyperviseur qui contrôle l’alimentation et le lifecycle des VMs. Microsoft ne peut pas démarrer une VM Hyper-V chez vous… à moins de passer par des extensions Arc dédiées, ce qui n’est pas encore en place.

Attention : l’absence d’Auto-Scale signifie que vous devez prévoir vous-même la scalabilité (provisioning manuel ou via votre orchestrateur d’hyperviseur). Pour des populations de plusieurs centaines d’utilisateurs, ce sera vite un bloqueur si vous comptiez sur AVD pour faire ça à votre place.

Combien ça coûte pendant la Preview ?

Pendant la Public Preview, vous payez :

  • Vos licences Windows / RDS CAL / M365 (rien de neuf, ce sont les mêmes qu’avant)
  • L’enrôlement Azure Arc (gratuit pour les serveurs Arc-Enabled de base, payant pour certaines features Defender / Update Manager / Policy avancées)
  • Le service AVD lui-même (pas de coût supplémentaire spécifique au mode hybride à ce stade)

À la GA, une licence Windows Cloud Hybrid sera très probablement requise pour les session hosts hybrides. Microsoft n’a pas encore communiqué les tarifs définitifs, mais le pattern habituel sur les « extensions cloud d’AVD » laisse penser à un modèle per user / month aligné sur les RDS User License Souscriptions.

Étape 0 : rappel des prérequis

Avant tout test, assurez-vous que :

  • Vous avez une souscription Azure active
  • Votre VM on-prem (Hyper-V, VMware, Nutanix…) est installée, à jour, et joignable en TCP 443 sortant vers Internet
  • Votre identité (Entra Join ou jointure AD) est déjà configurée avant l’enrôlement Arc
  • Que vous disposiez du rôle Azure Connected Machine Onboarding pour créer et gérer les ressources Azure Arc :
  • Que vous disposiez du rôle Contributeur à la virtualisation des postes de travail pour la gestion des pools d’hôtes Azure Virtual Desktop.

Étape 1 : enregistrer les resource providers

Sur la souscription cible, ouvrez Subscriptions > [votre sub] > Resource providers, puis vérifiez ou enregistrez si nécessaire :

  • Microsoft.HybridCompute
  • Microsoft.HybridConnectivity
  • Microsoft.GuestConfiguration
  • Microsoft.DesktopVirtualization

Vous pouvez aussi le faire en PowerShell :

'Microsoft.HybridCompute','Microsoft.HybridConnectivity','Microsoft.GuestConfiguration','Microsoft.DesktopVirtualization' | ForEach-Object { Register-AzResourceProvider -ProviderNamespace $_ }

Étape 2 : valider la readiness AVD

C’est l’étape clé documentée par Microsoft. L’objectif : confirmer que votre pool d’hôtes AVD de test peut être utilisé pour le test :

  1. Ouvrez le portail Azure.
  2. Cherchez Azure Virtual Desktop dans la barre.
  3. Allez dans Host pools > Create.
  4. Dans l’onglet Basics, cochez « Validation environment: Yes »
Attention : ne confondez pas validateavd (l’onglet sur la doc Microsoft, qui parle bien d’AVD) avec validatearc. Ce sont deux choses différentes : validateavd est ce qu’on cherche ici. La validation côté Arc (vérifier les resource providers, les rôles RBAC) se fait en parallèle.

Si vous ne disposez pas encore d’un pool d’hôtes AVD, veuillez le créer dans l’étape 3.

Étape 3 : créer le validation host pool, le workspace et l’application group

Si le pool d’hôtes AVD n’est pas encore créé dans votre environnement Azure, commencez par la base via l’assistant de création du host pool AVD :

  • Basics : nom (par exemple HP-AVDHybrid-Lab), région du metadata (dans mon cas Europe), type Pooled ou Personal selon votre besoin, et validation environment: Yes.
  • Virtual machines : choisir « No, I’ll add VMs later ». Les VMs seront ajoutées via l’enrôlement Arc + extension AVD, pas par le wizard Azure.
  • Workspace : créez-en un nouveau (par exemple WS-AVDHybrid-Lab) ou attachez-en un existant.
  • Tags et Review + create : validez.

Si cela n’est pas déjà le cas non plus, créez ensuite un application group (Desktop ou RemoteApp) et liez-le au workspace. C’est ce qui sera publié à l’utilisateur :

Étape 4 : onboarder la VM on-prem dans Azure Arc

Sur la VM on-prem, on va installer l’agent Azure Connected Machine, qui est le pont entre votre datacenter et Azure :

  1. Dans le portail Azure, allez dans Azure Arc > Machines > Add.
  2. Choisissez « Add a single server » (pour le lab) ou « Add multiple servers » (pour générer une clé partagée).
  3. Renseignez la souscription, le group de ressources, la région.
  4. Téléchargez le script d’onboarding PowerShell généré automatiquement.
  5. Exécutez-le en administrateur sur la VM on-prem.

Le script télécharge l’agent (AzureConnectedMachineAgent.msi), l’installe, puis lance azcmagent connect avec les paramètres de votre tenant.

Au bout de 2 à 5 minutes, la VM apparaît dans Azure Arc > Machines avec un statut Connected.

Attention : la VM doit être déjà jointe à votre identité cible (Entra Join OU jointure de domaine) avant l’enrôlement Arc. Si vous changez de modèle d’identité après coup, il faut désinstaller l’agent Arc et tout recommencer. Ne sautez pas cette étape.

Étape 5 : installer l’extension AVD Azure Arc et enregistrer le session host

C’est ici que les deux mondes se rejoignent, et c’est l’étape qui m’a le plus surpris. Contrairement à ce qu’on pourrait croire, l’enregistrement du session host hybride ne se fait pas via le bouton « + Add » du host pool dans le portail.

Il faut exécuter manuellement un script PowerShell, qui va poser l’extension Microsoft.AzureVirtualDesktop.CloudDeviceExtension sur le compte Arc de la machine. C’est cette extension et non l’agent AVD classique qui réalise l’enregistrement.

Pré-requis : il faut avoir installé soit l’extension Azure CLI desktopvirtualization, soit le module PowerShell Az.DesktopVirtualization. Microsoft documente le détail dans Use the Azure CLI and Azure PowerShell with Azure Virtual Desktop. Personnellement, j’ai utilisé PowerShell, donc voici la séquence que j’ai jouée.

D’abord, installez les modules suivants :

Install-Module -Name Az.DesktopVirtualization
Install-Module -Name Az.ConnectedMachine

Ensuite, connectez-vous à Azure et basculer explicitement sur la bonne souscription :

Connect-AzAccount
Set-AzContext -Subscription '<SubscriptionId>'
Attention : si vous oubliez le Set-AzContext et que votre compte est rattaché à plusieurs souscriptions, le New-AzConnectedMachineExtension ira chercher la VM Arc dans la mauvaise souscription et vous tombera sur une erreur « machine not found » très peu parlante. Toujours vérifier avec Get-AzContext avant d’enchaîner.

Générez une clé d’enregistrement du pool d’hôtes AVD via ce script PowerShell :

$HostPoolRG = "AVD_HostPool_RG"
$HostPoolName = "avd-hybrid-hp3"

$expiresUtc = (Get-Date).ToUniversalTime().AddHours(24).ToString("yyyy-MM-ddTHH:mm:ss.fffffffZ")
$regInfo    = New-AzWvdRegistrationInfo -ResourceGroupName $HostPoolRG -HostPoolName $HostPoolName -ExpirationTime $expiresUtc
$token      = $regInfo.Token

Enfin, lancez l’extension AVD sur la machine Arc :

# Settings
$settings          = @{ isCloudDevice = $false }
$protectedSettings = @{ registrationToken = $token }
$ResourceGroupName = "Arc_Servers_RG"
$MachineName = "WIN-8C8AQIS3DUL"
$Region = "westeurope"

# Install extension
New-AzConnectedMachineExtension `
    -Name 'Microsoft.AzureVirtualDesktop.CloudDeviceExtension' `
    -ResourceGroupName $ResourceGroupName `
    -MachineName $MachineName `
    -Location $Region `
    -Publisher 'Microsoft.AzureVirtualDesktop' `
    -ExtensionType 'CloudDeviceExtension' `
    -Setting $settings `
    -ProtectedSetting $protectedSettings

Quelques précisions utiles :

  • $token = la registration key générée a une durée de vie limitée (max 27 jours), donc générez-la juste avant de jouer le script
  • ResourceGroupName et MachineName = ceux de la ressource Arc dans Azure (pas le hostname Windows brut, mais le nom sous lequel la VM apparaît dans Azure Arc > Machines)
  • Location = la région Azure du resource group de la machine Arc (francecentral, westeurope, etc.), pas la « localisation physique » de votre datacenter
  • isCloudDevice = $false est essentiel : c’est ce flag qui dit à l’extension qu’on est en mode hybride, et pas sur une VM Azure native
  • La registration key passe en protectedSettings, elle n’apparaîtra donc pas en clair dans la définition de l’extension

L’extension met 3 à 5 minutes à se déployer :

En coulisses, elle installe les composants AVD nécessaires (équivalent de l’agent et du bootloader sur les VMs Azure natives) et enregistre la machine auprès du host pool grâce au token.

Au bout de quelques minutes, la VM apparaît dans la liste Session hosts du host pool, avec un statut Available. Du point de vue d’AVD, c’est une VM « comme les autres » et c’est tout l’intérêt de la mécanique d’Azure Arc.

Comme pour les machines AVD hébergées dans Azure, des contrôles réguliers sont appliquées afin de vérifier leur disponibilité :

Un échec dans les contrôles AVD rendra la machine indisponible pour recevoir de nouvelles sessions utilisateurs :

Étape 6 : assigner les utilisateurs AVD

Dernière ligne droite :

  1. Ouvrez votre application group (Desktop ou RemoteApp).
  2. Allez dans Assignments et ajoutez les utilisateurs ou groupes Microsoft Entra qui doivent pouvoir se connecter.

Étape 7 : test de connexion AVD

  1. Côté utilisateur : ouvrez la Windows App (web ou client lourd) et connectez-vous avec le compte Entra ID assigné.
  2. Le desktop publié par votre validation host pool hybride apparaît. Cliquez, c’est parti.

Et voilà : vous êtes connecté à un Windows qui tourne chez vous, mais piloté par AVD dans le cloud. Première fois que je l’ai vu marcher, ça m’a clairement fait sourire 😅

Cas n°1 : Hyper-V + Windows Server domain-joined

Premier cas testé dans mon lab : une VM Windows Server 2022 qui tourne sur un nœud Hyper-V standalone, jointe à mon AD on-prem (lui-même synchronisé vers Entra ID via Microsoft Entra Connect).

  • OS : Windows Server 2022 Standard
  • Hyperviseur : Hyper-V (Windows Server 2022)
  • Identité : jointure de domaine AD on-prem + sync Entra Connect
  • Licence : Windows Server + RDS CAL

Déroulé : enrôlement Arc nickel en 3 minutes, extension AVD posée en 5 minutes, session host visible Available dans le host pool. Connexion via la Windows App avec un user du domaine sync vers Entra : OK, RDP qui négocie en 2 secondes, le bureau s’affiche. Aucun ajustement particulier nécessaire. C’est le scénario le plus « facile » car on retrouve une cinématique classique RDS, juste branchée sur AVD.

Mon retour : c’est le scénario à privilégier pour migrer un parc RDS existant. Vous gardez votre AD, vos GPO, vos profils, votre serveur de fichiers SMB, et vous échangez juste votre broker / gateway / web access RDS contre AVD. Le gain est majeur : vous récupérez la Windows App, FSLogix moderne, l’intégration Entra ID, les Insights, sans toucher à votre infra serveur.

Cas n°2 : Hyper-V + Windows 11 mono-session Entra-joined

Deuxième cas, plus moderne et plus zéro-trust : une VM Windows 11 Enterprise mono-session qui tourne aussi sur Hyper-V, mais cette fois sans aucune jointure AD, uniquement Microsoft Entra Join.

  • OS : Windows 11 Enterprise 24H2 (mono-session)
  • Hyperviseur : Hyper-V
  • Identité : Microsoft Entra Join pur (pas d’AD)
  • Licence : Microsoft 365 Business Premium

Déroulé : avant tout, j’ai pris soin de faire l’Entra Join AVANT l’enrôlement Arc (via Settings > Accounts > Access work or school). Une fois la VM jointe au tenant, l’agent Arc s’installe normalement, l’extension AVD se pose, et le session host apparaît dans le host pool. Connexion via la Windows App avec un user Entra : OK, single sign-on transparent grâce à Entra Join.

Mon retour : c’est le scénario qui me plaît le plus pour des nouveaux projets. Pas de DC à exposer au réseau de l’hyperviseur, pas de Kerberos, pas de GPO – juste Entra ID, les policies Intune, et c’est tout. Pour des cabinets, des équipes projet, des labs, ou tout ce qui n’a pas besoin de Kerberos vers du legacy, c’est la voie royale. Pour rappel : Windows 11 multi-session reste interdit en hybride, donc pour cette population, c’est mono-session ou rien.

Cas n°3 : VMware vSphere + Windows Server

Troisième cas, et celui qui intéressera beaucoup d’entreprises encore très VMware-centric : une VM Windows Server 2025 sur VMware vSphere 8, jointe au domaine.

  • OS : Windows Server 2025 Standard
  • Hyperviseur : VMware vSphere 8 (ESXi 8.0 U2)
  • Identité : jointure de domaine AD on-prem
  • Licence : Windows Server + RDS CAL

Déroulé : identique au cas n°1, à 100 %. C’est exactement ça qui est bluffant. Du point de vue d’Azure Arc et d’AVD, qu’il y ait du Hyper-V ou du vSphere en dessous ne change strictement rien. Tant que l’agent Connected Machine s’installe et que la VM peut sortir en TCP 443, c’est jeu. J’ai posé l’agent Arc, lancé l’extension AVD, le session host est apparu en Available, et un utilisateur du domaine s’est connecté via la Windows App sans broncher.

Mon retour : c’est le cas le plus politique. Pour beaucoup de DSI, « passer chez Microsoft » voulait jusqu’ici dire « abandonner VMware ». AVD Hybrid permet exactement l’inverse : garder vSphere, ne pas refaire toute son infra, et bénéficier quand même du control plane AVD moderne. Pour les organisations qui ont investi dans vSphere récemment (et il y en a beaucoup, surtout après les bouleversements de licensing VMware), c’est un message fort de Microsoft : pas besoin de tout casser pour profiter d’AVD.

Le résumé visuel de mes trois cas :

CasHyperviseurOSIdentitéRésultat
1Hyper-VWindows Server 2022AD domain-joinOK – idéal pour reprise RDS
2Hyper-VWindows 11 mono-sessionEntra Join purOK – idéal pour green-field zéro-trust
3VMware vSphere 8Windows Server 2025AD domain-joinOK – idéal pour parcs vSphere existants

Et la conclusion qui me semble importante : les trois cas suivent rigoureusement la même procédure. La doc Microsoft est tenue à la lettre, les scripts d’onboarding fonctionnent à l’identique, l’extension AVD se pose pareil. Aucune divergence d’OS ou d’hyperviseur n’a nécessité de bricolage particulier. C’est rare et c’est notable.

Les limitations et pièges à connaître

Parce qu’on est en Public Preview, il y a quelques verrues à garder en tête :

LimitationImpact
Validation host pool obligatoireTout passage en prod nécessitera un redéploiement à la GA
Windows 11 multi-session non supporté hors AzureMulti-utilisateur obligatoire = Windows Server
Auto-Scale absentProvisioning manuel ou via votre orchestrateur d’hyperviseur
Start VM on Connect absentLes session hosts doivent être déjà allumés côté hyperviseur
Power management Azure portal absentLe start/stop se fait dans votre console d’hyperviseur, pas Azure
Session Host Configuration absentPas de « build automatique » du session host depuis le portail
Identité à fixer AVANT ArcChanger d’identité après onboarding = désinstaller / réinstaller
Pas de date de GA annoncéeÀ tester en pilote, pas à passer en prod critique

Et comme toujours avec les previews Microsoft, la feature peut encore évoluer avant la GA (interface, intégrations supplémentaires, prise en charge du multi-session, modèle de licence Windows Cloud Hybrid). À surveiller de près.

Conclusion

C’est clairement l’une des évolutions que beaucoup de monde attendait, et pas juste les fans de la marque AVD (comme moi 😅). AVD Hybrid règle un vrai point bloquant : pour faire du AVD ailleurs que dans Azure, il fallait jusqu’ici passer par Azure Local et son hardware certifié, ce qui excluait de fait toutes les entreprises encore en VMware ou Nutanix. Avec cette préversion, Microsoft signe un geste d’ouverture rare : votre hyperviseur, peu importe lequel, peut héberger des session hosts AVD pilotés par Azure Arc.

Ce qui me plaît particulièrement : la cohérence de la procédure entre les trois cas que j’ai testés (Hyper-V Server domain-joined, Hyper-V Windows 11 Entra-joined, VMware vSphere domain-joined), la simplicité du branchement via Azure Arc (les admins qui pratiquent déjà Arc sur du Defender for Cloud ou de l’Update Manager seront en territoire connu), et le fait qu’on retrouve l’écosystème AVD complet (Windows App, Entra ID, FSLogix, Insights) plutôt qu’une version dégradée.

Ce qui mérite vigilance : le statut Public Preview qui impose des validation host pools, l’absence d’Auto-Scale qui peut bloquer pour les gros parcs, l’interdiction du multi-session hors Azure qui force à repenser certains designs, et le flou sur la licence Windows Cloud Hybrid qui arrivera à la GA. Je l’intègre dès maintenant dans mes projets PoC, mais avec un pilote propre avant toute généralisation.

En tout cas, si vous avez du Hyper-V, du VMware ou du Nutanix qui tourne en datacenter, foncez tester : Azure portal > Azure Virtual Desktop > Host pools > Create, cochez Validation environment: Yes, puis enrôlez vos VMs via Azure Arc et posez l’extension AVD.

La documentation officielle est claire et la procédure marche du premier coup. Et dites-moi dans les commentaires ce que vous en pensez, surtout si vous avez essayé sur un hyperviseur que je n’ai pas couvert (Proxmox ? KVM ? Hyper-V Azure Local ?), je suis curieux de vos retours !

Remote Display Analyzer

Dans les environnements de bureaux à distance modernes (Azure Virtual Desktop, Windows 365, Citrix …) l’expérience utilisateur dépend énormément du protocole d’affichage distant, du réseau, des ressources , … Quand tout fonctionne bien, personne ne s’en préoccupe. Mais dès qu’un utilisateur dit : « mon Cloud PC lag », « la vidéo est saccadée », « j’ai un délai quand je tape au clavier » … on entre immédiatement dans une zone grise. Bon courage pour comprendre la cause !

Un problème d’affichage distant peut venir de nombreux endroits : réseau, client, serveur, GPU, codec vidéo, politiques de compression et j’en passe.

C’est exactement pour cela que j’aime beaucoup un outil que j’utilise régulièrement lors de phases de troubleshooting : Remote Display Analyzer (RDA).

Cet outil permet de voir et tester en direct ce que fait réellement le protocole d’affichage distant :

Avant d’aller plus loin, je voulais remercier l’équipe RDA de m’avoir donné une licence pour réaliser mes tests.

Et pour vous guider plus facilement dans cet article très long, voici des liens rapides :

Qu’est‑ce que Remote Display Analyzer ?

Remote Display Analyzer (RDA) est un petit et très léger outil conçu pour analyser les protocoles d’affichage utilisés dans les environnements de virtualisation de poste de travail.

Il ne supporte pas que des environnements Microsoft, mais bon nombre de solutions présentes sur le marché, notamment :

  • Microsoft RDP
  • Azure Virtual Desktop
  • Windows 365
  • Citrix HDX
  • Omnissa / VMware Horizon Blast
  • Nutanix Frame

Combien coûte RDA ?

Remote Display Analyzer est décliné en plusieurs éditions afin de répondre à des besoins différents. En plus de l’édition Community, il existe une édition Personal ainsi qu’une édition Company, qui offrent des fonctionnalités avancées adaptées à des usages plus professionnels ou à grande échelle :

Il existe une version gratuite de RDA : l’édition Community permet d’accéder aux statistiques temps réel du protocole d’affichage, ce qui est largement suffisant pour de nombreux scénarios de diagnostic et de troubleshooting :

Voici un lien de téléchargement de la version gratuite de RDA. Enfin les deux autres versions payantes sont plus complètes, et remontent plus données :

Comment fonctionne RDA ?

Comme annoncé plus haut, Remote Display Analyzer ne nécessite aucune installation préalable. L’outil se présente sous la forme d’un simple exécutable qui peut être lancé directement à l’intérieur d’une session distante, sans configuration particulière.

Voici un lien vers ses fonctionnalités. Dès que RDA est lancé, il détecte automatiquement :

  • le protocole utilisé
  • le mode d’affichage actif
  • l’encodeur vidéo

Dans le cas d’Azure Virtual Desktop, Remote Display Analyzer permet également de vérifier si la session utilise RDP Shortpath.

  • RDP Shortpath est un mode de transport UDP qui permet d’améliorer les performances et de réduire la latence dans les sessions AVD.
  • Lorsque Shortpath est actif, le trafic RDP ne passe plus uniquement par le service de gateway Azure, mais peut établir un chemin direct entre le client et la machine virtuelle.

Remote Display Analyzer permet de vérifier immédiatement si la session utilise le transport TCP classique ou le mode UDP (RDP Shortpath) :

Il affiche également différentes métriques en temps réel, comme par exemple :

  • bande passante utilisée
  • latence réseau
  • nombre de frames
  • frames perdues
  • GPU

Il vous informe sur les statistiques portant sur les paquets envoyés et les contraintes potentielles sur ces derniers, mais également sur les FPS envoyés :

Enfin, il vous donne des informations utiles sur le GPU :

Dans les environnements Azure Virtual Desktop ou Windows 365 utilisant des machines virtuelles avec GPU (par exemple NV-series ou NVads), l’encodage vidéo peut être offloadé vers le GPU. Lorsque cette accélération est active :

  • la charge CPU diminue
  • l’encodage vidéo devient plus rapide
  • l’expérience utilisateur est plus fluide

Remote Display Analyzer permet de vérifier si l’encodeur vidéo GPU est réellement utilisé et d’observer en temps réel la latence de l’encodeur ainsi que le nombre de frames générées.

Cela permet notamment de vérifier que les politiques GPU sont correctement appliquées sur les session hosts AVD.

Comment interpréter les métriques de RDA ?

Certaines métriques sont particulièrement utiles pour comprendre l’expérience utilisateur.

  • FPS :
    • Un environnement fluide tourne généralement entre 25 FPS et 60 FPS
    • En dessous de 20 FPS, les utilisateurs commencent souvent à percevoir des saccades.
  • Latence round-trip :
    • < 40 ms → excellent
    • 40-80 ms → correct
    • 100 ms → visible
  • Video Encoder Latency
    • Une latence encodeur trop élevée peut indiquer : CPU saturé, GPU absent, codec mal configuré

Qu’est-ce que les « Skipped Frames » ?

Dans les protocoles d’affichage distants, toutes les images générées par l’application ne sont pas forcément envoyées au client.

Lorsque certaines ressources deviennent limitées, le protocole peut décider d’ignorer certaines images afin de maintenir une expérience utilisateur acceptable.

Remote Display Analyzer permet d’identifier trois types de frames ignorées :

Skipped frames – client

Cela signifie que le client ne peut pas décoder ou afficher les images assez rapidement. Les causes les plus fréquentes sont :

  • client peu puissant
  • GPU absent
  • décodage vidéo logiciel
  • écran haute résolution

Skipped frames – network

Dans ce cas, c’est le réseau qui devient le facteur limitant. Le protocole décide alors de réduire le flux graphique. Cela peut être causé par :

  • bande passante insuffisante
  • latence élevée
  • pertes de paquets
  • congestion réseau

Skipped frames – server

Ici le problème vient du serveur lui-même. Cela peut être dû à :

  • CPU saturé
  • GPU saturé
  • trop de sessions par host
  • encodage vidéo trop lourd

Quelques exemples de problèmes que RDA permet d’analyser :

Un premier cas fréquent concerne la latence élevée dans les sessions distantes. Les utilisateurs peuvent ressentir un délai entre l’action réalisée sur le clavier ou la souris et la réaction affichée à l’écran. Dans ce type de situation, Remote Display Analyzer permet de visualiser la latence réseau, le nombre de frames envoyées et les éventuelles frames perdues afin d’identifier si le problème vient du réseau, du serveur ou du client.

Dans l’exemple ci-dessous, RDA analyse une session Windows 11 dans Azure Virtual Desktop :

Comme la vidéo le montre, il peut être très instructif de simuler différents niveaux de latence réseau afin d’observer comment la session se comporte dans des conditions WAN plus difficiles. Remote Display Analyzer permet alors de suivre en temps réel l’impact de la latence sur la fluidité et la réactivité.

Un autre problème courant concerne les vidéos ou les animations qui deviennent saccadées. Les utilisateurs peuvent par exemple remarquer que Microsoft Teams, YouTube ou certaines applications graphiques ne sont pas fluides. Dans ce cas, l’outil permet d’analyser le nombre d’images par seconde, le codec vidéo utilisé ainsi que la bande passante réellement consommée par la session :

On rencontre également souvent des problèmes d’image floue ou de compression trop forte. Dans ces situations, le texte peut sembler légèrement dégradé ou certaines images peuvent apparaître très compressées. Remote Display Analyzer permet alors de tester différents niveaux de compression et différentes qualités d’image afin de trouver le bon compromis entre qualité visuelle et consommation réseau.

Enfin, certains environnements rencontrent des problèmes de charge CPU trop élevée sur les serveurs. Cela peut se produire lorsque l’encodage vidéo est effectué par le CPU plutôt que par le GPU. Dans ce type de scénario, RDA permet de vérifier si l’encodage GPU est réellement utilisé ou si le CPU est responsable du traitement graphique :

Peut-on modifier certains réglages graphiques avec RDA ?

Ce qui rend l’outil vraiment intéressant est une autre capacité. Remote Display Analyzer permet de modifier certains paramètres d’affichage en live pour les environnements Citrix. Cela permet de faire des tests très rapides pour comprendre l’impact réel d’une configuration. Par exemple :

  • codec vidéo
  • profondeur de couleur
  • compression
  • qualité d’image
  • frames par seconde

Comme le rappelle l’éditeur dans leur FAQ, RDA nécessite les droits administrateur pour pouvoir effectuer ces modifications.

Conclusion

Remote Display Analyzer est un outil extrêmement simple, mais particulièrement utile dans les environnements EUC.

Lorsqu’un utilisateur signale que son bureau distant est lent ou que la vidéo est saccadée, il est souvent difficile de savoir immédiatement si le problème vient du réseau, du client, du serveur ou du protocole lui-même.

Grâce à ses métriques en temps réel et à sa capacité à modifier certains paramètres graphiques à la volée, Remote Display Analyzer permet de mieux comprendre le comportement du protocole d’affichage distant.

Pour les administrateurs travaillant avec Azure Virtual Desktop, Windows 365, Citrix ou Horizon, c’est clairement un outil que je recommande d’avoir dans sa boîte à outils de troubleshooting.

Azure Virtual Desktop hybride + SSO

Azure Virtual Desktop est souvent présenté comme une solution offrant un Single Sign-On “natif”. Dès que l’on sort d’un environnement cloud-only pour entrer dans un contexte hybride, les mécanismes d’authentification deviennent toutefois plus complexes, et parfois déroutants. Entre Microsoft Entra ID, Active Directory, Kerberos, PRT, Seamless SSO et Cloud Kerberos Trust, il est facile de confondre des briques aux noms proches, mais qui n’interviennent ni au même moment ni au même niveau.

Dans un précédent article, j’avais détaillé la mise en place du SSO Azure Virtual Desktop dans un environnement cloud-only.

Dans cet article, j’ai volontairement changé de contexte pour travailler sur un environnement hybride. L’objectif de cet article est de répondre aux trois questions suivantes :

  • Clarifier les mécanismes d’authentification (PRT, Seamless SSO, Kerberos, etc.)
  • Montrer pas à pas pourquoi certaines étapes sont indispensables pour obtenir un SSO réellement transparent dans AVD.
  • A quoi sert le Seamless SSO disponible dans Entra Connect Sync ?

Avant d’aborder la configuration et les tests, il est utile de poser le cadre : comprendre quels mécanismes d’authentification sont utilisés, à quel moment, et pourquoi certains fonctionnent seuls alors que d’autres doivent être combinés.

Cette FAQ a pour objectif de lever les confusions les plus fréquentes autour des tokens, du Kerberos, et du Single Sign-On dans un environnement Microsoft Entra hybride.

Quels sont les tokens utilisés par Microsoft Entra ID ?

Microsoft Entra ID utilise plusieurs types de tokens, chacun ayant un rôle précis :

  • Primary Refresh Token (PRT)
    • Jeton long terme
    • Spécifique à l’appareil
    • Sert à demander d’autres tokens
    • Utilisé par Windows (WAM – Web Account Manager)
  • Access Token
    • Jeton court terme
    • Présenté aux applications (API, Office, AVD…)
    • Contient les claims utilisateur
  • Refresh Token
    • Permet de renouveler un Access Token
    • Généralement géré automatiquement par le système

Qu’est-ce que le Primary Refresh Token (PRT) ?

Dans le monde de Microsoft, le PRT est un jeton émis par Microsoft Entra ID lorsqu’un appareil est Microsoft Entra Joined ou Microsoft Entra Hybrid Joined.

Un jeton d’actualisation principal (PRT) est un artefact clé de l’authentification Microsoft Entra dans les versions prises en charge de Windows, iOS/macOS, Android et Linux. Un PRT est un artefact sécurisé spécialement émis aux répartiteurs de jetons microsoft pour activer l’authentification unique (SSO) sur les applications utilisées sur ces appareils.

Microsoft Learn

Le PRT est stocké localement sur la machine et sert de jeton racine pour :

  • obtenir des tokens d’accès OAuth 2.0
  • s’authentifier automatiquement aux services cloud Microsoft
  • éviter toute ressaisie de mot de passe pour les applications modernes

Concrètement, le PRT permet :

  • l’ouverture automatique de session dans Edge
  • l’authentification transparente à Office, Teams, OneDrive
  • l’utilisation de Windows App / Azure Virtual Desktop web

Point important : le PRT n’est pas Kerberos et ne permet pas, à lui seul, d’ouvrir une session Windows sur une machine Active Directory.

Pourquoi le PRT ne suffit-il pas pour Azure Virtual Desktop en mode Hybride ?

Dans un environnement Azure Virtual Desktop en mode Hybride, il y a deux niveaux d’authentification distincts :

  1. Accès au service AVD (broker / portail)
    → Authentification Microsoft Entra ID
    → Le PRT suffit
  2. Ouverture de la session Windows sur le session host
    → Authentification Active Directory
    → Un TGT Kerberos est obligatoire

Dans un environnement Microsoft Entra Hybrid Joined, le PRT est présent, mais le TGT Kerberos n’est pas automatiquement délivré par Entra.

Cela permet de comprendre pourquoi une seconde authentification Active Directory est fréquemment observée dans de nombreux environnements AVD, après une première authentification Entra.

Qu’est-ce qu’un TGT Kerberos Active Directory ?

Le Ticket Granting Ticket (TGT) est un jeton Kerberos délivré par un contrôleur de domaine Active Directory.

Il est obtenu :

  • lors de l’ouverture de session Windows
  • après une authentification réussie auprès de l’AD

Le TGT permet ensuite :

  • d’accéder aux ressources Active Directory
  • d’obtenir des tickets de service (CIFS, LDAP, HTTP, etc.)
  • d’ouvrir une session Windows locale ou distante

Sans TGT Kerberos, l’ouverture d’une session Active Directory n’est pas possible.

Qu’est-ce que Microsoft Entra Kerberos (Cloud Kerberos Trust) ?

Microsoft Entra Kerberos est le mécanisme qui permet à Microsoft Entra ID de :

  • générer un TGT Kerberos Active Directory
  • à partir d’une authentification cloud
  • sans nécessiter ADFS

Techniquement :

  • un objet Kerberos spécial est créé dans l’Active Directory
  • les clés sont synchronisées avec Microsoft Entra ID
  • Entra devient capable d’émettre un TGT valide pour l’AD

C’est l’élément nécessaire pour obtenir un SSO complet dans AVD en environnement hybride.

Pourquoi la jointure hybride améliore l’expérience SSO ?

Avec Microsoft Entra Hybrid Join :

  • l’appareil est reconnu par Entra
  • un PRT est délivré
  • les applications cloud utilisent un SSO moderne

En ajoutant Microsoft Entra Kerberos :

  • Entra peut aussi délivrer un TGT AD
  • Windows peut ouvrir la session sans redemande de mot de passe

On comprend alors que la combinaison du PRT et d’un TGT Kerberos est nécessaire pour obtenir un SSO transparent dans Azure Virtual Desktop.

À quoi sert la case “Single sign-on” dans Entra Connect ?

La case Single sign-on dans Microsoft Entra Connect active ce qu’on appelle Seamless SSO.

Seamless SSO repose sur :

  • Kerberos
  • le compte AD AZUREADSSOACC
  • le site autologon.microsoftazuread-sso.com

Son objectif est volontairement limité :

  • éviter la saisie du mot de passe AD
  • lors d’une authentification navigateur vers Entra ID
  • sur une machine AD-only

Il est important de distinguer Seamless SSO des autres mécanismes :

  • ne crée PAS de PRT
  • ne remplace PAS Microsoft Entra Kerberos
  • ne supprime PAS tous les écrans de login

Pour se donner une meilleure idée de cette fonctionnalité SSO spécifique, nous la testerons dans la dernière étape de cet article.

Mais commençons d’abord par tester la mise en place du single sign-on complet pour un environnement AVD de mode hybride, dont les procédures officielles sont disponibles ici et :

Etape 0 – Configuration de base :

Dans mon environnement de test, j’ai déjà configuré certains composants.

  • Un environnement Active Directory
  • Microsoft Entra Connect configuré avec
    • Password Hash Synchronization (PHS)
    • sans Single sign-on,
    • avec Hybrid Joined pour les machines Windows 10/11
    • Synchronisation de l’OU des utilisateurs AVD
    • Synchronisation de l’OU des machines hôtes AVD
  • Un environnement Azure Virtual Desktop avec deux machines virtuelles jointes à AD :

Notre environnement AVD en mode hybride est en place, commençons par un premier test.

Etape I – Test sans configuration SSO :

Avant d’aller plus loin, j’effectue déjà un premier test de connexion d’un utilisateur AVD depuis le portail web :

Une authentification AD est demandée lors de l’ouverture de la session Windows, c’est un comportement normal à ce stade car rien n’est configuré :

La commande dsregcmd /status sert à afficher l’état d’enregistrement de l’appareil auprès d’Entra ID et, concernant le PRT (Primary Refresh Token), elle fournit des informations de diagnostic sur sa présence et son état :

  • AzureAdPrt : YES / NO : Indique si un PRT est présent sur la machine pour l’utilisateur
  • AzureAdPrtUpdateTime : Date/heure du dernier rafraîchissement du PRT
  • AzureAdPrtExpiryTime : Date/heure d’expiration du PRT
  • AzureAdPrtAuthority : Autorité qui a émis le token (généralement login.microsoftonline.com).

Concernant la partie des tickets, voici ce que l’on peut aussi en déduire :

  • OnPremTgt : NO : cela indique si la session utilisateur courante ne possède pas Ticket Granting Ticket Kerberos émis par un contrôleur de domaine AD.
  • CloudTgt : YES : indique la présence d’un TGT Kerberos cloud, émis par Entra ID.

Comme on peut le constater, le PRT émis via Entra fonctionne bien pour les services Cloud, mais l’ouverture de session et l’accès à certaines ressources gérées par l’AD pourraient être restreints dans la situation actuelle.

Commençons étape par étape les changements pour arriver à une configuration complète.

Etape II – Configuration SSO du pool d’hotes AVD :

Sur le portail Azure, comme l’indique la documentation Microsoft, j’effectue la configuration SSO du host pool Azure Virtual Desktop afin d’activer “Microsoft Entra authentication for single sign-on” :

J’effectue un nouveau test avec mon utilisateur :

À ce stade, une authentification AD est encore demandée lors de l’ouverture de la session Windows :

Etape III – Création d’un objet serveur Kerberos :

Sur le serveur AD, comme l’indique la documentation Microsoft, je commence par installer le module AzureADHybridAuthenticationManagement :

# First, ensure TLS 1.2 for PowerShell gallery access.
[Net.ServicePointManager]::SecurityProtocol = [Net.ServicePointManager]::SecurityProtocol -bor [Net.SecurityProtocolType]::Tls12

# Install the AzureADHybridAuthenticationManagement PowerShell module.
Install-Module -Name AzureADHybridAuthenticationManagement -AllowClobber

Pour créer l’objet Kerberos Server nécessaire au Cloud Kerberos Trust, j’ai choisi l’exemple 4 de la documentation Microsoft :

  • Cet exemple exploite l’authentification moderne basée sur le User Principal Name (UPN) sans exiger de mot de passe AD explicite.
  • Il s’intègre parfaitement dans un environnement hybride sécurisé avec MFA et politiques d’accès conditionnel
  • Il évite les écueils des méthodes utilisant NTLM ou des identifiants AD en clair.
# Specify the on-premises Active Directory domain. A new Microsoft Entra ID
# Kerberos Server object will be created in this Active Directory domain.
$domain = $env:USERDNSDOMAIN

# Enter a UPN of a Hybrid Identity Administrator
$userPrincipalName = "administrator@contoso.onmicrosoft.com"

# Create the new Microsoft Entra ID Kerberos Server object in Active Directory
# and then publish it to Azure Active Directory.
# Open an interactive sign-in prompt with given username to access the Microsoft Entra ID.
Set-AzureADKerberosServer -Domain $domain -UserPrincipalName $userPrincipalName

Je lance donc le script à la suite du précédent, en prenant soin de remplacer l’UPN par un administrateur général ou hybride :

Je vérifie le serveur Microsoft Entra Kerberos nouvellement créé à l’aide de la commande suivante :

# When prompted to provide domain credentials use the userprincipalname format for the username instead of domain\username
Get-AzureADKerberosServer -Domain $domain -UserPrincipalName $userPrincipalName -DomainCredential (get-credential)

Enfin je constate la présence krbtgt_AzureAD utilisé par les DC pour signer les TGT Kerberos. Il s’agit d’une séparation cryptographique claire avec krbtgt dans le cadre de Kerberos émis depuis Entra :

J’effectue un nouveau test avec mon utilisateur :

Une fois le Cloud Kerberos Trust et l’authentification RDP Microsoft Entra activés, la seconde authentification Active Directory disparaît et est remplacée par un simple message de consentement Allow Remote Desktop connection :

Entra veut un consentement explicite de l’utilisateur. Ce message ne correspond pas à une authentification supplémentaire, mais à une demande de confiance entre l’utilisateur et le session host :

Si l’utilisateur clique sur Oui, ce consentement sera conservé 30 jours et ne pourra pas mémoriser plus de 15 hôtes.

L’Étape suivante consiste donc à supprimer définitivement le popup en déclarant les session hosts comme appareils de confiance dans Microsoft Entra ID.

Etape IV – Activation de l’authentification Microsoft Entra pour RDP :

Commençons par autoriser Microsoft Entra dans l’authentification pour Windows sur le tenant. Pour cela, j’utilise Azure Cloud Shell depuis le portail Azure :

J’importe les deux modules Microsoft Graph suivants, puis je me connecte avec le compte au permissions appropriées :

Import-Module Microsoft.Graph.Authentication
Import-Module Microsoft.Graph.Applications

Connect-MgGraph -Scopes "Application.Read.All","Application-RemoteDesktopConfig.ReadWrite.All"

Je récupère l’ID d’objet pour le principal du service de connexion au Windows Cloud :

$WCLspId = (Get-MgServicePrincipal -Filter "AppId eq '270efc09-cd0d-444b-a71f-39af4910ec45'").Id

Je modifie la propriété isRemoteDesktopProtocolEnabled sur True :

If ((Get-MgServicePrincipalRemoteDesktopSecurityConfiguration -ServicePrincipalId $WCLspId) -ne $true) {
    Update-MgServicePrincipalRemoteDesktopSecurityConfiguration -ServicePrincipalId $WCLspId -IsRemoteDesktopProtocolEnabled
}

Je vérifie que la propriété isRemoteDesktopProtocolEnabled est correctement définie :

Get-MgServicePrincipalRemoteDesktopSecurityConfiguration -ServicePrincipalId $WCLspId

Afin de masquer la boîte de dialogue en configurant la liste des hôtes AVD approuvés, je créé un groupe dans Entra ID contenant les hôtes de sessions :

J’utilise une requête dynamique pour ajouter automatiquement mes prochains hôtes dans le groupe :

Enfin, toujours dans la même session d’Azure Cloud Shell, j’ajoute l’ID de groupe à une propriété sur le principal du service SSO Windows Cloud Login.

$tdg = New-Object -TypeName Microsoft.Graph.PowerShell.Models.MicrosoftGraphTargetDeviceGroup
$tdg.Id = "<Group object ID>"
$tdg.DisplayName = "<Group display name>"
New-MgServicePrincipalRemoteDesktopSecurityConfigurationTargetDeviceGroup -ServicePrincipalId $WCLspId -BodyParameter $tdg

Enfin, je vérifie la bonne assignation du groupe :

J’effectue un nouveau test avec mon utilisateur :

Cette fois l’authentification passe sans encombre. Un TGT Kerberos AD DS (on-premises) est maintenant présent dans la session.

Cela permet d’observer que :

  • La machine est Hybrid Entra ID Joined
  • Le PRT est valide
  • Le Kerberos cloud fonctionne
  • Le Kerberos AD DS fonctionne
  • Les deux mondes coexistent simultanément dans la même session

Cette sortie correspond à un état hybride cohérent, où les mécanismes cloud et on-premises coexistent.

Pour finir, je vous propose de tester l’impact du Seamless SSO présent et configurable dans Entra Connect Sync.

Etape V – Activation du SSO d’Entra Connect Sync :

Pour cela, je décide de rajouter une troisième machine AVD :

Celle-ci est bien présente dans l’Active Directory :

Mais elle n’est pas présente dans Entra ID :

Pour ne pas perturber mes tests, je décide donc de bloquer la connexion aux deux autres VMs AVD :

J’effectue un test avec mon utilisateur :

Comme aucune configuration hybride n’est en place pour cette machine AVD, il n’y a pas de ticket TGT Kerberos émis par Entra ID, donc la seconde authentification AD est logique :

Une fois dans la session Windows, dsregcmd nous affiche les informations suivantes :

  • La machine est jointe uniquement à Active Directory on-premises
  • Elle n’est pas jointe à Entra ID
  • Elle n’est pas Hybrid Join
  • Aucun PRT
  • Aucun SSO cloud
  • Aucune authentification Entra ID
  • Une tentative d’Entra ID Join / Hybrid Join a eu lieu
    • Elle a échoué côté Entra ID
    • La machine AVD n’existe pas ou n’est pas reconnu dans le tenant

L’ouverture de la page d’authentification d’Office 365 dans Microsoft Edge me montre d’ailleurs aucune connexion SSO :

Je décide donc d’activer la fonctionnalité SSO dans Entra Connect Sync :

Une fois la configuration terminée, je constate la création de AZUREADSSOACC en tant que compte ordinateur créé dans Active Directory :

Ce dernier est créé automatiquement lors de l’activation de Seamless Single Sign-On (Seamless SSO) avec Entra ID. Le compte est utilisé par Entra ID pour :

  • établir une relation de confiance Kerberos avec l’AD on-prem
  • permettre le SSO sans saisie de mot de passe depuis des postes domain-joined vers Entra ID

J’effectue donc un nouveau test avec mon utilisateur :

Dans ce contexte, il est logique que l’authentification AD soit toujours demandée :

Une fois la session Windows ouverte, comme Seamless SSO fonctionne via l’adresse autologon.microsoftazuread-sso.com, je décide de la rajouter en tant qu’URL de l’Intranet local.

Pour cela, j’ouvre inetcpl.cpl :

Je clique sur Site dans Intranet local :

Je clique sur Avancée :

Je rajoute l’URL suivante :

https://autologon.microsoftazuread-sso.com

Toujours dans Intranet Local, je coche Connexion automatique avec le nom d’utilisateur et le mot de passe actuels :

Quelques minutes plus tard, j’ouvre Microsoft Edge et je constate l’authentification automatique de mon compte Cloud correspondant :

La présence du ticket HTTP/autologon.microsoftazuread-sso.com dans le cache Kerberos confirme que le mécanisme Seamless SSO est bien actif. Ce ticket, émis par le contrôleur de domaine à destination de Microsoft Entra ID, permet une authentification navigateur sans saisie de mot de passe.

klist

Il est important de noter que ce mécanisme n’est pas celui utilisé pour l’ouverture de session Windows dans Azure Virtual Desktop, qui repose sur un TGT Kerberos distinct délivré via Microsoft Entra Kerberos (krbtgt_AzureAD).

Conclusion

À travers ces différents tests et configurations, on constate que le Single Sign-On dans Azure Virtual Desktop hybride ne repose pas sur un mécanisme unique, mais sur une combinaison cohérente de plusieurs briques d’authentification.

Le PRT permet une authentification fluide aux services cloud, mais il ne suffit pas à lui seul pour ouvrir une session Windows dans un contexte Active Directory. C’est bien l’association du Hybrid Join, du Cloud Kerberos Trust et de l’authentification Microsoft Entra pour RDP qui permet d’aligner les mondes cloud et on-premises, et d’obtenir une expérience utilisateur réellement transparente dans AVD.

Comprendre ces mécanismes permet non seulement d’éviter des configurations incomplètes, mais aussi d’expliquer pourquoi certains scénarios fonctionnent “presque”, tout en continuant à demander une authentification supplémentaire.